30 秒看懂
Cameron Wolfe 解释为什么主观智能体评估容易受到噪声影响,并提出结合校准后的人类审查、离线评判器和生产环境 A/B 测试的框架。他讨论功效分析、重采样以及一个将评判结果与观众行为联系起来的 Netflix 项目。
- 1可验证性光谱创意工作可能没有确定性的通过或失败检查,需要依赖判断。
- 2人工评估专家定义标准,评审者通过检查分歧来校准。
- 3评判器与评分细则通用评判器使用质量指南;评分细则检查任务特定标准。
- 4元评估将自动判断与可靠的人工标注样本比较。
- 5呈现不确定性规划样本量并报告误差范围,同时考虑波动来源。
- 6生产环境测试扩大发布前后都使用受控 A/B 测试与监控。
要点建议
- 与领域专家定义质量标准,并用共同样本校准人工评审者。
- 将模型评判器和任务评分细则视为不完美的代理指标,再用人工标注数据验证。
- 规划样本量并报告不确定性,同时认识到统计方法不能消除系统偏差。
- 用 A/B 测试和生产监控检查离线改进是否影响真实使用。
- 把新的生产故障反馈到数据集和评审指南中。
按章节阅读整理后的全文
主观评估为什么有噪声
Wolfe 解释评估试验及可验证性光谱。
我是 Netflix 资深研究科学家 Cameron Wolfe。这场演讲概述如何评估创意写作等高度主观的任务;这些任务可能没有唯一且可直接验证的正确答案。
评估的一大难点是噪声。智能体的行为具有非确定性,重复运行可能产生不同轨迹和答案。当基准只包含有限数量的任务时,这种波动会让性能差异更难解释。
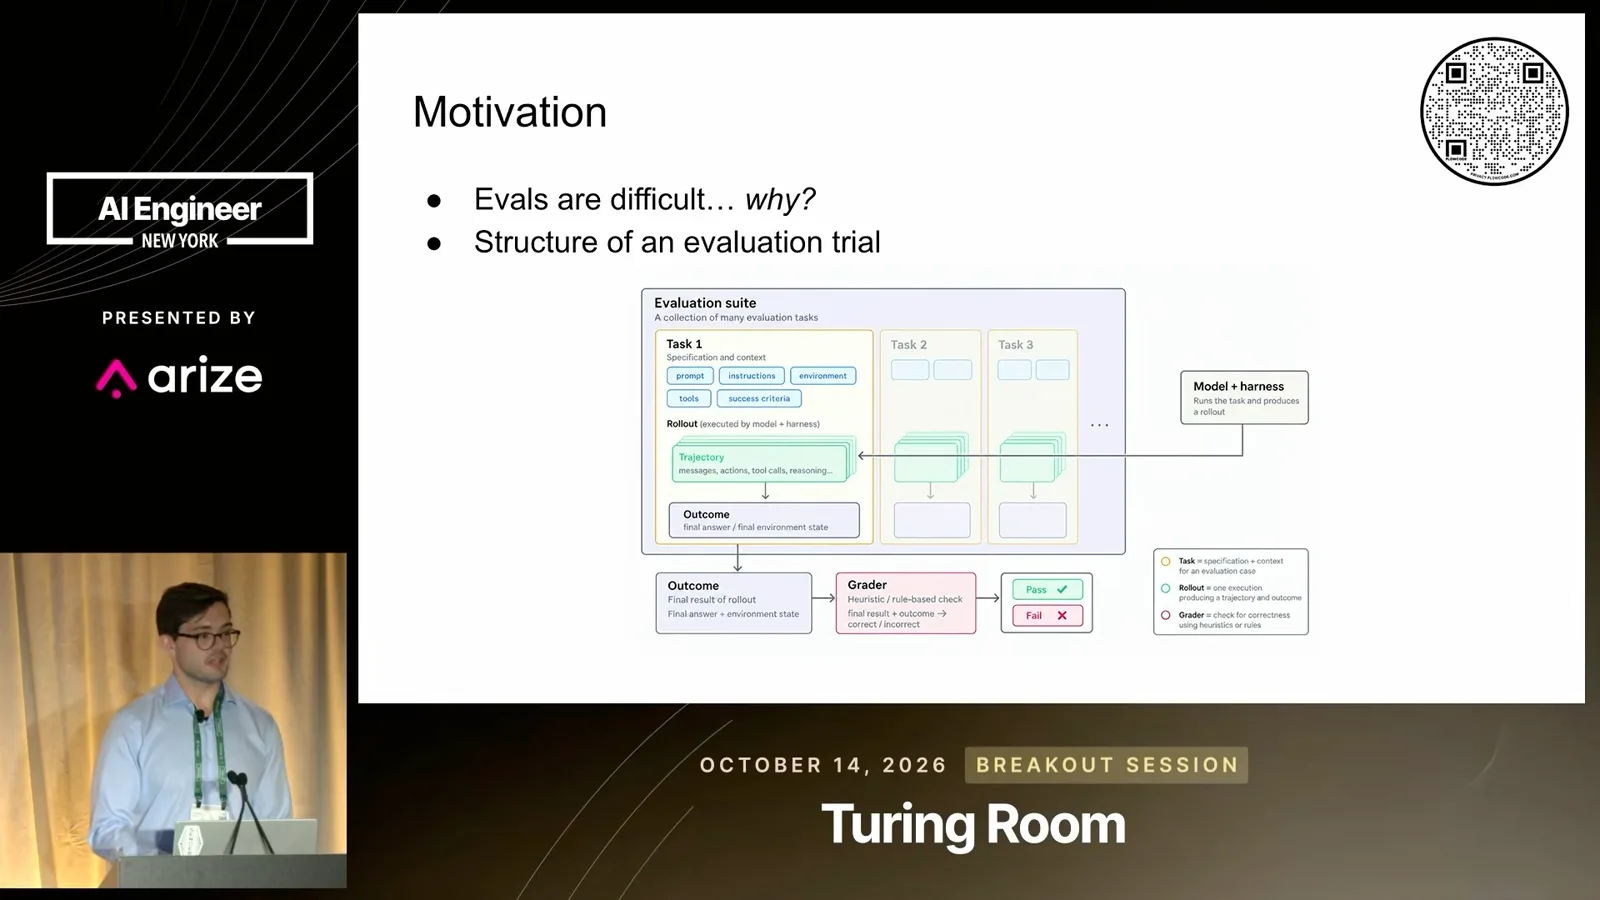
在简单的评估试验中,评估集提供任务,智能体产生执行轨迹与结果,评分器再给出评价。一些基准运行成本很高,限制了团队能够承担的任务数量或重复运行次数。
任务处于可验证性光谱上的不同位置。数学答案可能可以用确定性方法检查,而创意写作需要判断开放式品质。用模型评判器替换确定性评分器,又会增加一个潜在的波动来源。
我的框架结合人工评估、离线自动评估和生产环境监控。三者相互提供信息:人定义质量,自动代理指标加快迭代,生产环境则提供真实使用中的证据。
人工评估与抽样
他介绍指南、评审者校准和功效分析。
对于主观任务,先把人工评估作为参照。与领域专家共同确定少量标准、评分尺度和详细例子,使评审者对评估对象形成共同理解。
好的指南本身并不能保证一致。让多位评审者评价同一批例子,研究分歧、讨论模糊之处并修订指南。反复校准,直到一致性达到适合该任务的水平。
抽样同样重要。给定对波动、显著性水平和目标统计功效的假设,功效分析可以估计检测指定效应大小所需的样本量。它是规划工具,并不保证每个结论都正确。
评估集应反映真实生产任务、覆盖多样案例,并有足够难度区分不同模型。分析执行轨迹可以发现模型能解决什么、会漏掉什么;人工和模型辅助审查也可逐步改善数据质量。
离线评判器与评分细则
他解释自动代理指标,以及如何用人工判断检查它们。
让人审查每次模型变化很快会成为瓶颈。离线自动评估使用不完美的代理指标,通常是语言模型评判器或评分细则,使更多实验变得可行。
在我这里使用的区分中,LLM 评判器把高层质量指南应用于不同任务;评分细则则把特定任务拆成可分别检查的清单。两种方式都仍需对照预期质量标准进行验证。
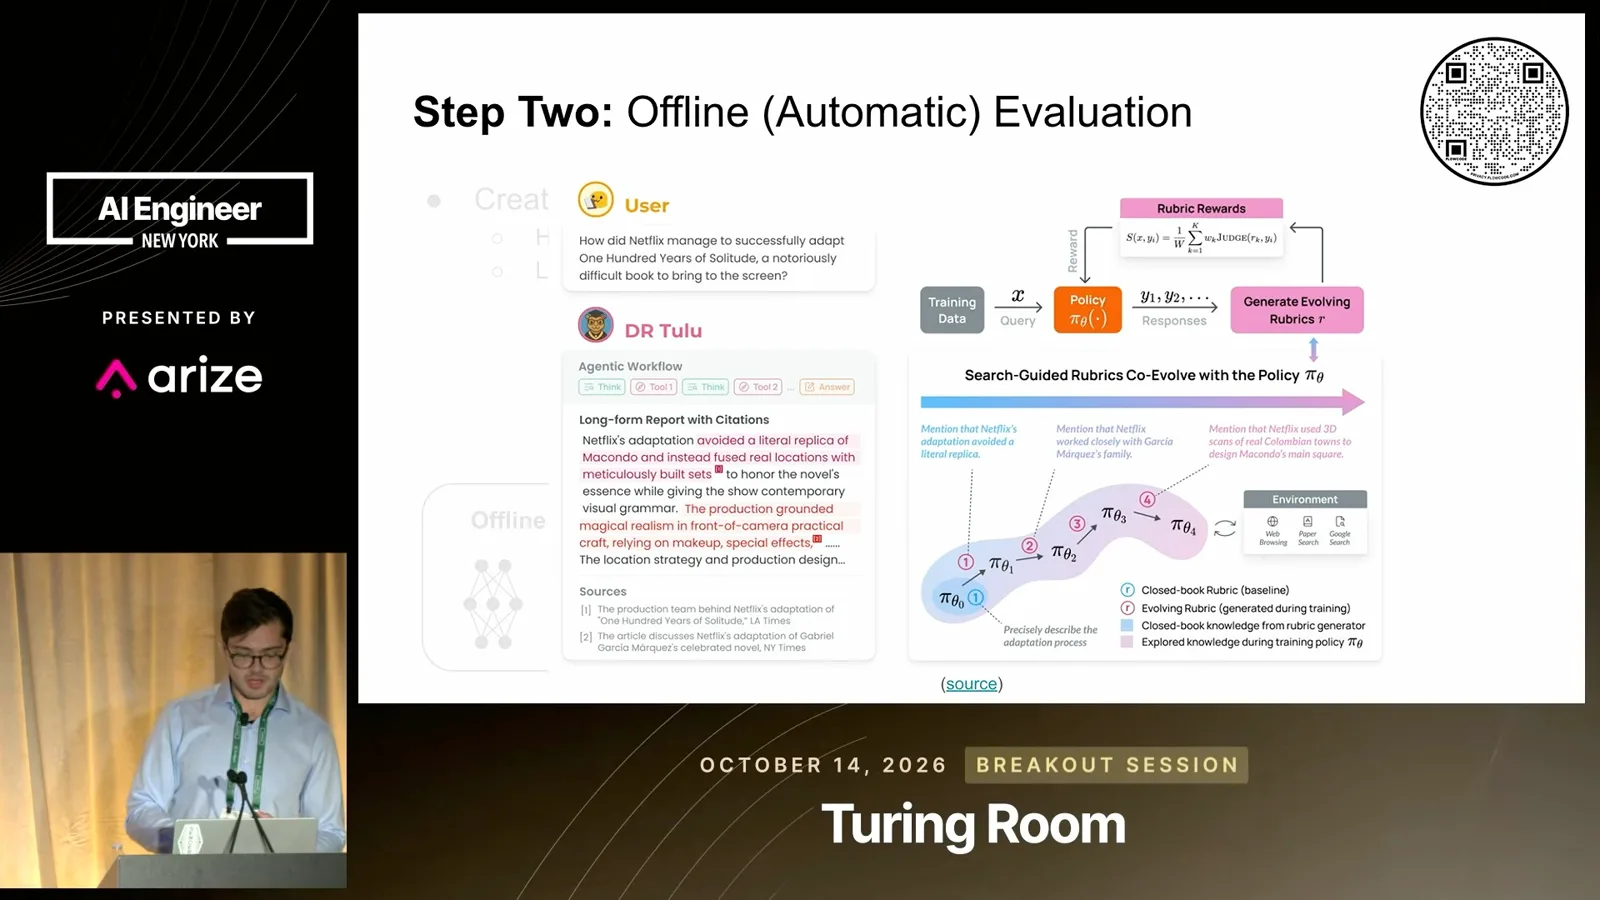
我展示了一个 Dr. Tulu 示例,涉及把一本书改编为 Netflix 作品。评分细则不只依赖整体印象,而是列出要检查的具体特征。明确标准有助于提高一致性,但不能消除判断或偏差。
元评估用于检查自动评判器是否与可信的人类标注“黄金”样本一致。团队可以根据任务查看相关性、分类准确率和特定分歧模式,而不是只依赖一个总分。
在我参与的一个 Netflix 项目中,我们将 LLM 评判器的输出与观众放弃观看等流媒体结果联系起来。我将其作为该项目相关的证据;演讲没有提供足够细节,不能把其中的因果主张推广到所有评判器或观看场景。
需要多高的一致性取决于任务。一个实际参照是人工评审者之间的一致性:将评判器与人的一致性,与人和人之间的水平比较,同时仍要检查重要错误。
统计与生产环境
演讲涵盖不确定性、A/B 测试和监控。
当被评模型和评判器都具有随机性时,需要明确处理不确定性。我建议规划样本量、报告误差范围,并在适当时使用重复采样或重采样。实验设计必须考虑其中的依赖关系与波动来源。
用自动评估探索许多变化,再将有希望的候选方案交回人工评审。统计区间有助于量化抽样不确定性,但不能消除系统偏差,也不能证明一个模型在所有场景都更好。
全面部署前,应监控生产环境信号。它们可以是点赞或点踩等显式评价,也可以是会话长度和放弃率等隐式指标。每个指标都是代理信号,其含义取决于产品和用户场景。
A/B 测试将候选方案与现有体验比较,也可作为受控的小范围发布。功效分析可以帮助规划时间和样本量;全面发布后,护栏和持续监控仍然重要。
改进评估闭环
生产故障反馈至指南和离线评估。
生产环境可能揭示离线数据集中缺失的新故障和使用方式。应将这些例子反馈到评估数据中,并随产品演化改进指南、重新校准评审者或评判器。
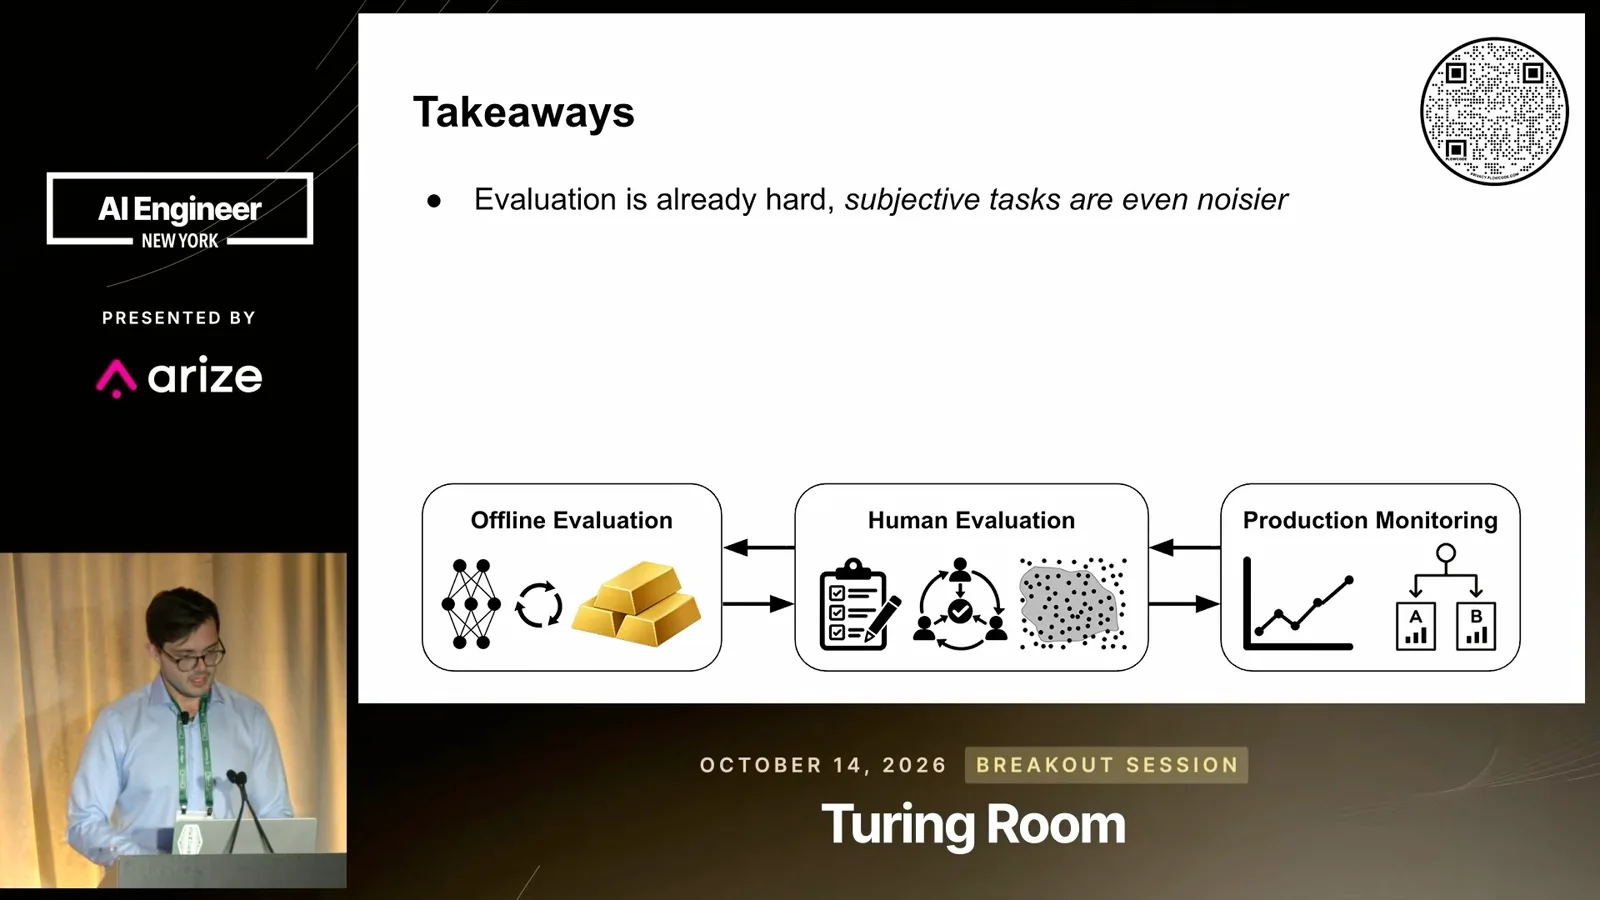
完整闭环是:用离线评估扩大探索范围,用人工评估获得更高保真的视角,再用 A/B 测试和监控检查真实行为。每个阶段都应对有噪声的结果保持审慎,并与分数一起说明不确定性。
同频道的其他文章
 23:05ZH
 AI Engineer· 2026年11月6日Ryo Lu:当我们什么都能做,还知道自己想做什么吗?Ryo Lu从 AI 生成的日记工具到爵士乐团,Ryo Lu 讨论如何在更强大的工具旁保有判断、生活和与他人合作的空间。
 14:58EN → 简体中文AI Engineer· 2026年11月6日Sparsh Jain:为 AI 智能体构建经验性记忆Sparsh Jain · CentralAgent AI通过形成、更新和检索经验的生命周期,以及持续评估循环,管理不断变化的上下文。
 17:27EN → 简体中文AI Engineer· 2026年11月6日Philipp Schmid:打造 AI 同事需要的七样东西Philipp Schmid · Google DeepMind从托管智能体、技能和凭证管理,到定时运行的投资组合审计演示。
 18:13EN → 简体中文AI Engineer· 2026年11月6日Sid Pednekar:AI 采用中稀缺的是判断力Sid Pednekar从选择高价值问题、建设共享能力,到把经验转化为组织学习的框架。
 14:04EN → 简体中文AI Engineer· 2026年11月6日Frank Long:围绕质量构建 AI 投资工作流Frank Long · CoatueCoatue 的 Frank Long 将投资拆解为信息、分析和决策步骤,主张为每一步选择代码、模型与人的合适组合。
 20:45EN → 简体中文AI Engineer· 2026年11月5日John Stecher 与 Scott Worland:构建能够随 AI 模型进步而改变的系统Scott Worland, John Stecher · Norm AIBlackstone 和 Norm AI 的技术负责人讨论数据战略、评估、生产控制,以及何时值得等待更好的模型。