30 秒看懂
Sparsh Jain 介绍团队处理智能体反复犯错的方法:在不同抽象层次保存有用经验,随环境变化更新,并检索相关上下文。他讨论了评估和清理循环,同时分享团队报告的案例与对自主协作的预测。
- 1更多上下文不总是更好Jain 表示,不加区分地存储记忆可能增加延迟和成本,同时降低表现。
- 2经验的三个层次案例、策略和技能保留不同程度的细节与通用性。
- 3记忆生命周期形成、更新和检索使经验在环境变化时保持有用。
- 4检索决定相关性如果选错上下文,存储的事实也可能无助于任务。
- 5清理与评估循环定期维护更新优先级,并测试拟议变更。
要点建议
- 如果相关信息难以检索,存储更多上下文可能增加成本并损害表现。
- 经验性记忆可以表示为案例、策略和可复用技能。
- 记忆需要形成、更新、选择性遗忘和检索。
- 保留被替换的历史判断有助于深入调查。
- 自动提出更新时,需要评估与防护。
按章节阅读整理后的全文
为什么智能体重复犯错
Jain 介绍反复纠正的问题,以及不断增加上下文的局限。
我是 CentralAgent AI 的 AI 负责人 Sparsh Jain。团队与智能体合作会积累经验,但智能体在新会话或与另一位同事合作时可能重复同样的错误。一位高管把反复纠正描述为实际问题:错误太多,不可能每次都靠人工修正。
最初的反应往往是把所有可用上下文和记忆都交给智能体。根据我们的经验,在企业规模下这样做可能适得其反:更多材料会增加成本、工作量和延迟,还可能使检索与表现变差。更多上下文不总是更好的上下文。
我们回头思考,人如何通过经验、错误和纠正不断进步。问题变成了:如何保存互动中有用的教训,而不只是存下更多事实。我把形成的架构称为经验性记忆。
经验性记忆及其生命周期
案例、策略和技能随着环境变化而形成和更新。
我区分短期工作记忆与长期记忆。长期记忆既包括事实,也包括经验——从智能体工作过程中发生的事情中提炼出的教训。我的团队称系统带来了显著改善,但演讲没有提供足够的实验细节,不能把这个数字直接推广。
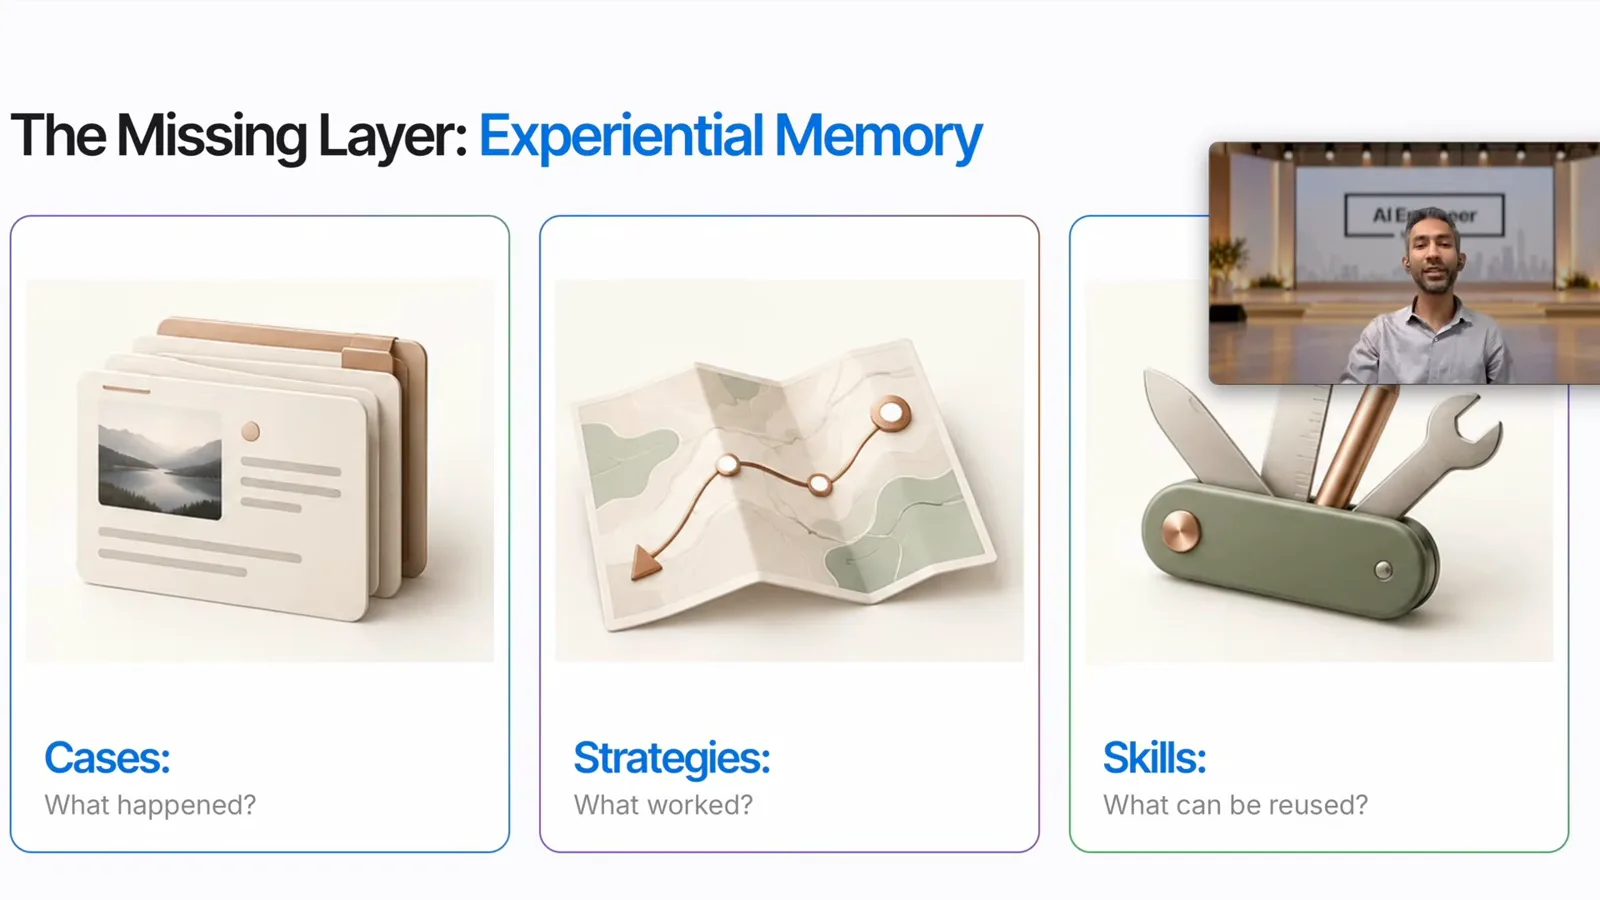
我们把经验分为案例、策略和技能。案例保留特定情境的细节;策略记录在某种情境下有效的方法;技能则是更通用、可供智能体复用的过程。它们代表不同的抽象层次,不能简单互换。
建立第一层记忆后,我们发现另一个挑战:数据、系统和环境都会变化。今天有用的笔记将来可能过时。因此,记忆基础设施需要持续演进,不能建好一次就放任不管。
我把记忆生命周期分为形成、更新和检索。形成阶段提取潜在经验;更新阶段加入新观察、修改旧笔记、停用过时内容,并提供遗忘不再有帮助的信息的机制。
只保存最新判断并不总是足够。我们保留已停用的笔记,记录判断如何变化:浅层查询可以使用有效笔记,深入调查时还可以查看旧历史。这样系统能够检查先前结论为何被替换。
我用一位记忆力异常强的人的故事说明遗忘为何可能有用。对智能体系统而言,能从这个类比得到的启示更有限:如果每条旧信息都平等争夺注意力,保留一切可能压垮处理过程,而不是改善决策。
验证与检索
方案加入模型辅助验证,并强调对情境敏感的检索。
加入记忆之后,维护工作仍有很多需要人工完成。我认为模型可以帮助验证拟议更新,让循环更加自主。这是一种设计主张,并不能证明模型验证总是正确,也不能证明永远不需要人类监督。
检索与存储同样重要。假设智能体知道你在两个城市都有家,而你要求它导航回家;如果它为当前位置检索到了错误的地址,即使事实本身正确也不够。形成和更新无法弥补持续不相关的检索结果。
在一个例子中,我的团队称复用先前收集的上下文,使某项任务从约 20 分钟降到约 2 分钟,也节省了工作量和 token。这是团队报告的案例,结果取决于任务和评估条件。
清理循环与团队学习
Jain 描述定期维护、评估,以及他对智能体协作的预测。
我们把下一部分称为“做梦循环”:一个定期清理和评估的循环,用来移除或降低过时信息的优先级、更新重点并重组记忆。睡眠只是描述这个循环作用的类比;实际实现是维护存储信息的过程。
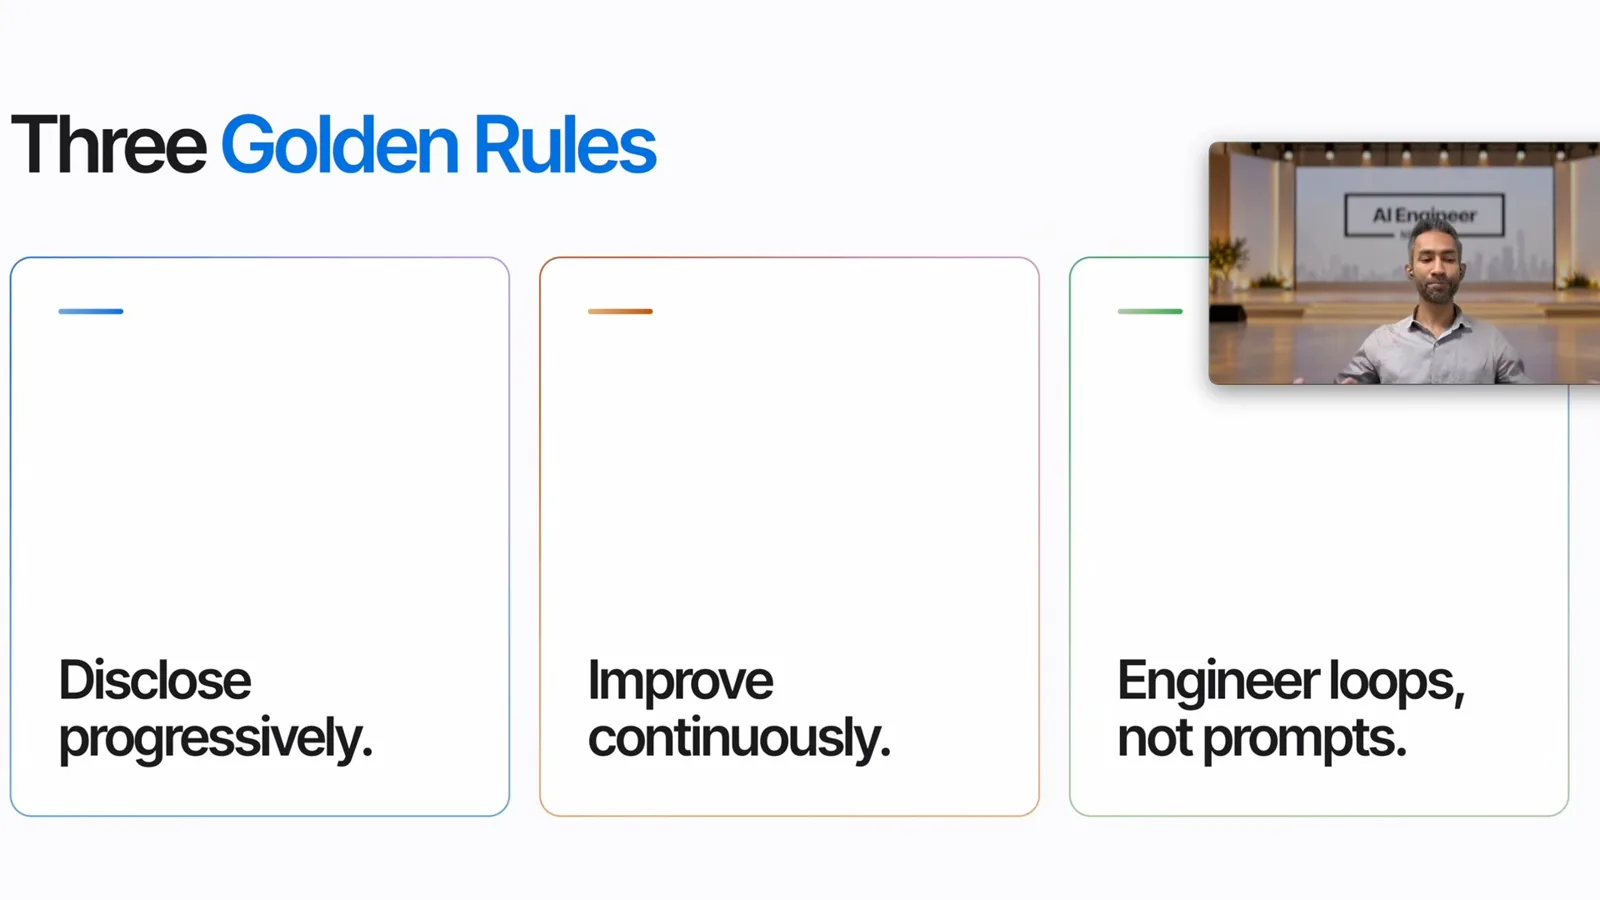
我的三条规则是:逐步提供上下文,而不是一次倾倒全部信息;随着条件变化持续改进系统;建立反馈循环,而不只依赖固定提示词。可观测性和评估贯穿记忆生命周期,使拟议变更在使用前能够被测试。
我预计,当不同用户的经验能够供同一个智能体使用时,团队会受益。我也预测人类与智能体之间会出现更自主的协作。十倍或百倍团队、指数级改善等说法是我的预测,并非已经普遍证明的结果。
我的结论是,要为智能体建立从纠正中学习的方法,避免它反复犯同样的错误。这需要选择性记忆、更新、检索、评估和防护共同发挥作用。
同频道的其他文章
 23:05ZH
 AI Engineer· 2026年11月6日Ryo Lu:当我们什么都能做,还知道自己想做什么吗?Ryo Lu从 AI 生成的日记工具到爵士乐团,Ryo Lu 讨论如何在更强大的工具旁保有判断、生活和与他人合作的空间。
 17:27EN → 简体中文AI Engineer· 2026年11月6日Philipp Schmid:打造 AI 同事需要的七样东西Philipp Schmid · Google DeepMind从托管智能体、技能和凭证管理,到定时运行的投资组合审计演示。
 18:13EN → 简体中文AI Engineer· 2026年11月6日Sid Pednekar:AI 采用中稀缺的是判断力Sid Pednekar从选择高价值问题、建设共享能力,到把经验转化为组织学习的框架。
 14:04EN → 简体中文AI Engineer· 2026年11月6日Frank Long:围绕质量构建 AI 投资工作流Frank Long · CoatueCoatue 的 Frank Long 将投资拆解为信息、分析和决策步骤,主张为每一步选择代码、模型与人的合适组合。
 17:52EN → 简体中文AI Engineer· 2026年11月5日Cameron Wolfe:如何评估答案主观的 AI 任务Cameron Wolfe · NetflixNetflix 的 Cameron Wolfe 介绍将人工审查、校准后的模型评判器和生产监控结合起来的评估闭环。
 20:45EN → 简体中文AI Engineer· 2026年11月5日John Stecher 与 Scott Worland:构建能够随 AI 模型进步而改变的系统Scott Worland, John Stecher · Norm AIBlackstone 和 Norm AI 的技术负责人讨论数据战略、评估、生产控制,以及何时值得等待更好的模型。