30 秒看懂
Theo 借助编码基准和滑板动作示例讨论 Token 效率与任务级成本。他提出简洁的内部推理可能有助于 OpenAI 模型取得这些结果,但现有例子不能证实其机制或因果关系。
- 1每任务输出 Token引用的 DeepSWE 图表比较了特定模型配置的得分与输出量。
- 2工具调用让历史增长提示词、先前回复和工具结果都可能成为后续上下文。
- 3缓存与压缩缓存可复用未变前缀;压缩缩短历史,但可能丢失细节。
- 4可见摘要有局限显示的推理摘要不一定是模型原始的内部推理过程。
- 5假说并非证明Theo 认为简短内部文本可能有助于效率,但这些例子不能证明因果关系。
- 6一次示意性的模型比较滑板动作提示在 GLM 5 和 5.2 上产生不同长度的推理,但单次运行不能证明普遍表现。
要点建议
- 比较任务成功率和总成本,而不只是 Token 单价或数量。
- 工具结果和先前输出可能让代理工作流的上下文不断增长。
- 缓存和压缩降低成本的方式不同,取舍也不同。
- 可见的推理摘要不一定是原始推理过程。
- Theo 关于简短推理的解释是假说,并非已经证实的模型训练过程。
按章节阅读整理后的全文
Token 效率衡量什么
Theo 从 DeepSWE 的输出 Token 与得分比较入手,强调任务级成本。
大家常争论哪个模型最聪明,但我想讨论另一个问题:模型达到某个结果需要生成多少输出?我引用的 DeepSWE 图表中,GPT-5.5 medium 每项任务约使用 20,000 个输出 Token,得分不错;Opus 4.8 大约使用 50,000 个,得分较低。这是一项基准测试,并非普遍排名。
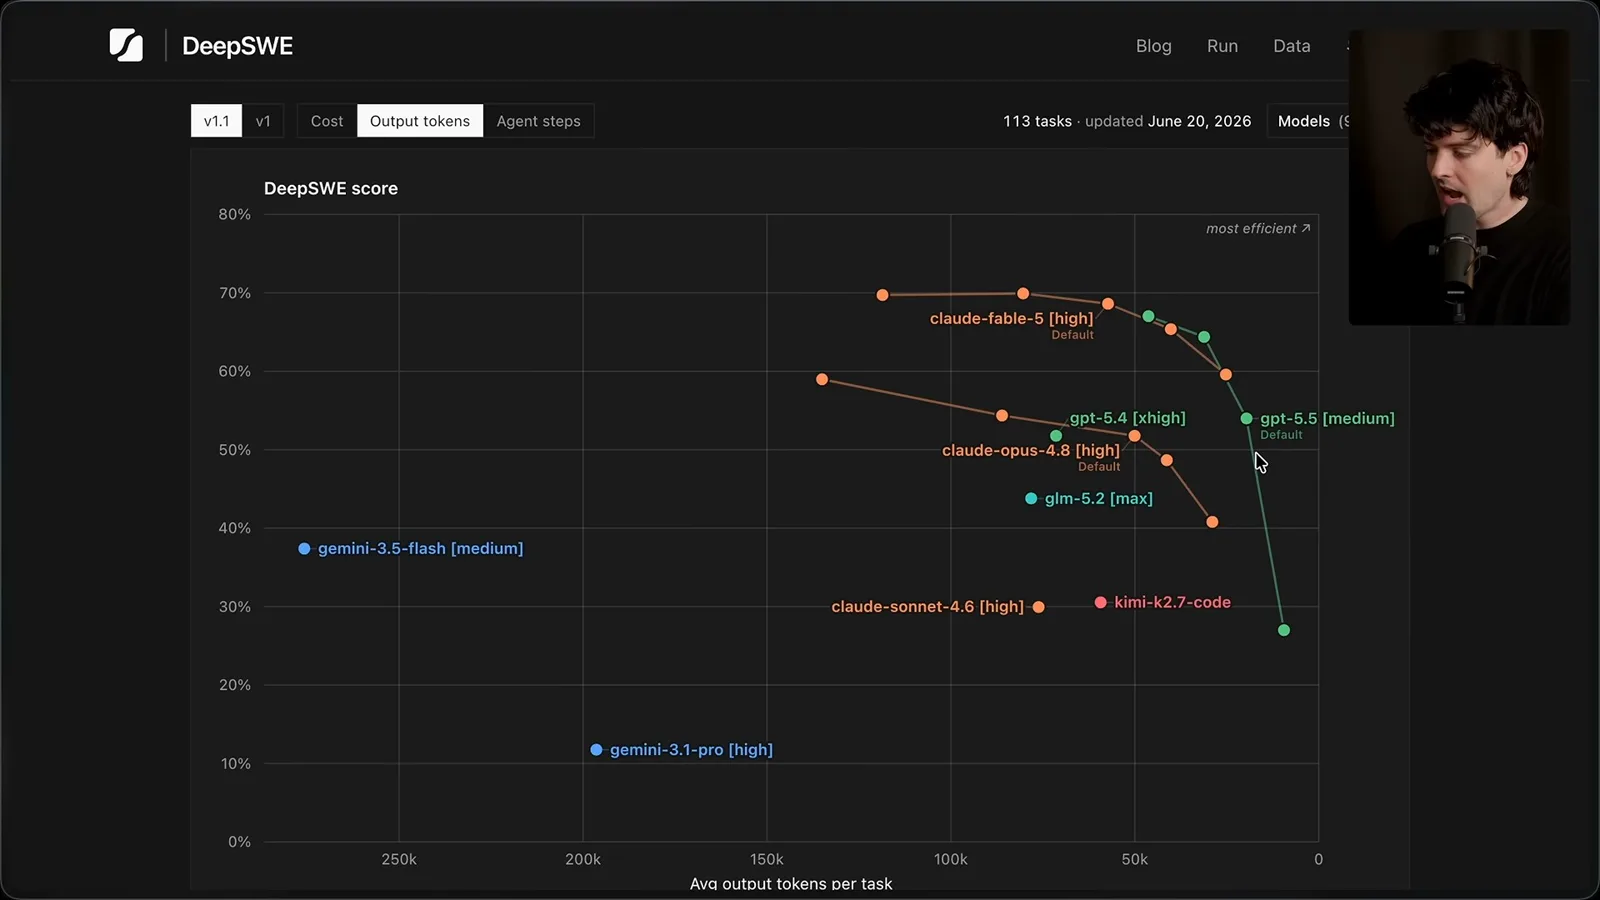
同一图表显示,Gemini 的一些配置在这些任务上使用了多得多的输出 Token,得分却较低。Token 单价本身不能告诉你完成一项工作的费用:输出量、成功率、代理运行框架和工作负载都很重要。我想解释为什么短提示词也可能带来高额账单。
输入、输出、缓存与压缩
深色模式例子展示提示词和工具结果如何在代理工作流中积累。
Token 是模型处理文本的单位。输入包括提示词、检索到的代码和工具结果;输出包括生成的回复,以及某些模型的推理 Token。多模态输入也会通过服务商特定的表示方式计量,因此简单的文本 Token 比喻有其局限。
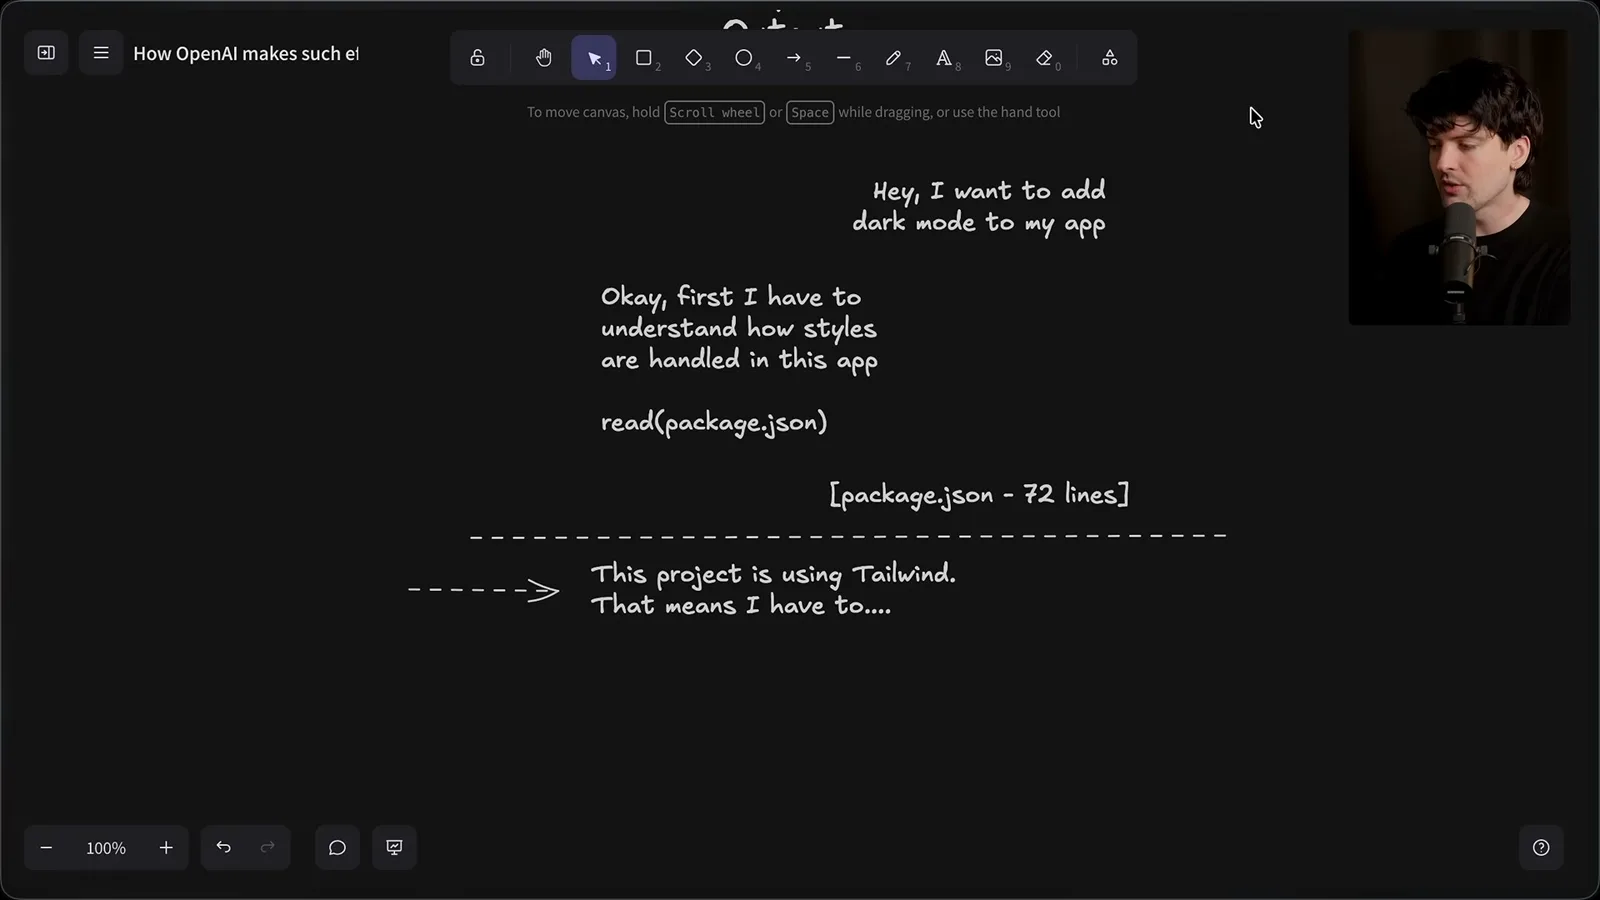
假设你让代理给应用添加深色模式。它决定检查样式,调用工具读取 package.json,并收到文件内容。下一步模型会把对话和相关工具结果作为上下文。后续调用可能反复包含先前生成的文字和工具结果,而不只是用户输入的两句话。
控制不断增长的历史记录的一种方式是压缩:总结此前工作,再用较短的摘要继续。这能缩小上下文,但也可能丢失细节。另一种方式是提示缓存,它可以复用未变前缀的计算结果,避免每一步都从头处理;具体行为和价格取决于服务商。
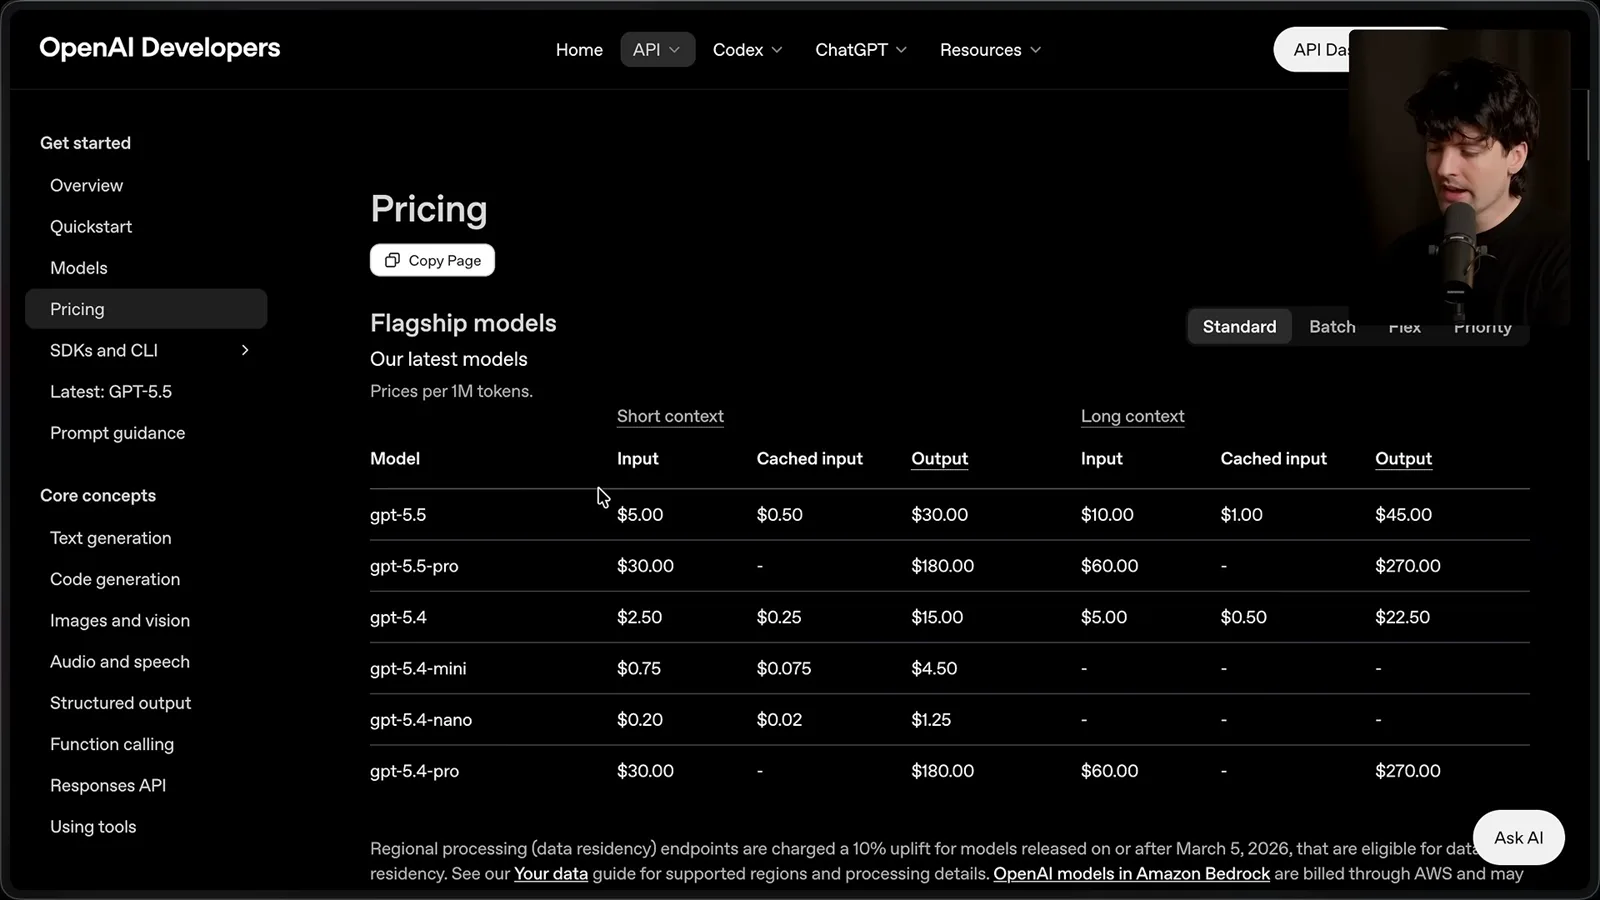
录制时展示的价格表中,GPT-5.5 短上下文输入每百万 Token 5 美元,缓存输入 0.50 美元,输出 30 美元。这是当时的 API 价格,不一定代表当前价格。缓存可以降低重复输入的费用,但生成输出仍有成本。
实践中的推理 Token
Theo 演示滑板动作问题,并讨论可见推理摘要的局限。
我把用户看到的最终文本与回答前使用的推理 Token 区分开来。推理可以帮助模型探索和修正各种可能性,但消耗的 Token 也可能远多于最终回复。一个滑板动作名称可能只有几个词,模型为得到它却可能使用数千个 Token。
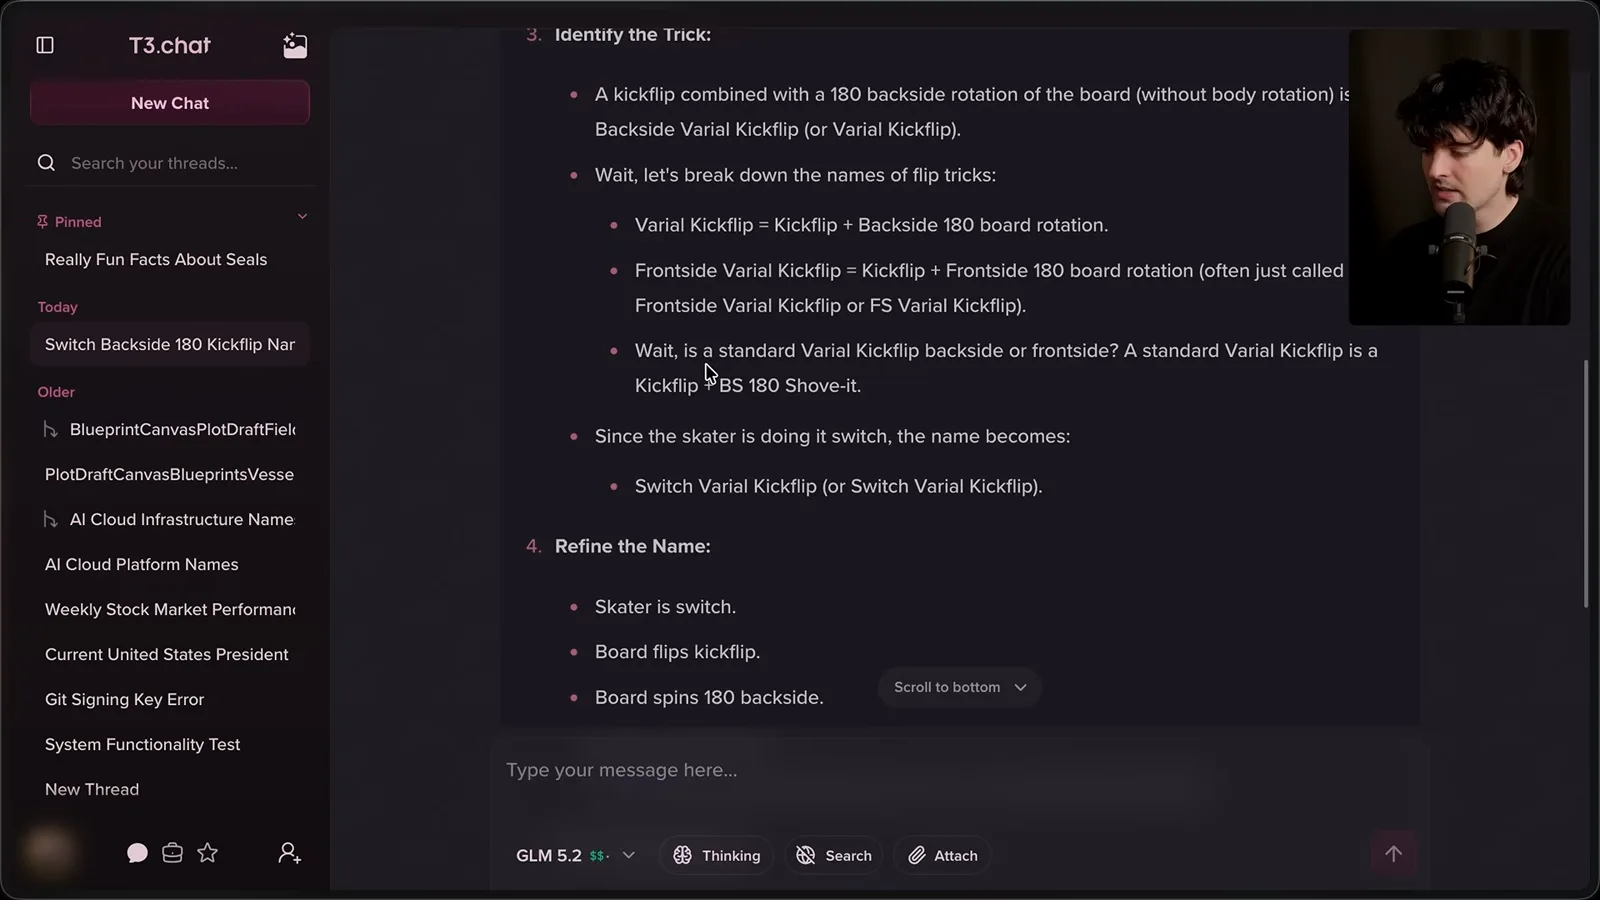
演示中,我描述了一个反脚站姿动作:板子做 kickflip,同时向 backside 方向旋转 180 度,滑手身体不转。GLM 5.2 正确称其为 switch varial kickflip,并展示了结构化推理过程。一个 Qwen 例子给出了更长的解释,却答错名称;单个提示只用于说明,不能当作系统评估。
我的例子中,GPT-5.5 给出了正确名称,显示使用 342 个 Token。但界面展示的推理可能是摘要,而不是原始内部过程。这使我们难以准确检查闭源模型为什么使用更少 Token,也难以复现其行为。
我认为中间信息对后续步骤可能有帮助:代理或许需要记住为什么检查某个文件或放弃某种方法。服务商如何保留或传递推理内容因产品和 API 而异,不能假定每次调用都会重新传入所有隐藏过程。
效率与成本
他比较 Token 预算和价格,同时指出总成本取决于任务和配置。
我的核心观点是,缩短推理可以减少生成的 Token,也可能缩小工作流后续携带的历史。实际节省多少取决于缓存、保留方式和步骤数量;将这种减少称为指数级只是比喻,并非已经证明的普遍规律。
我认为 OpenAI 非常重视效率,但它取得这些基准结果的完整技术原因并未公开。图表中,GPT-5.5 的各档配置使用不到 50,000 个输出 Token,而较高强度的 Fable 配置超过 100,000 个。这项测试衡量的是特定配置,不代表所有未来版本或任务。
即使 GPT-5.5 的 Token 单价比 GPT-5.4 提高,效率更高的配置在达到某个基准得分时仍可能花费更少。在我讨论的比较中,5.5 medium 使用不到 5.4 xhigh 一半的 Token,得分却更高。5.5 最重的配置仍然更贵,因此比较取决于期望的结果。
简短推理假说
Theo 查看疑似泄露的例子并提出可能的解释,但没有证实其底层机制。
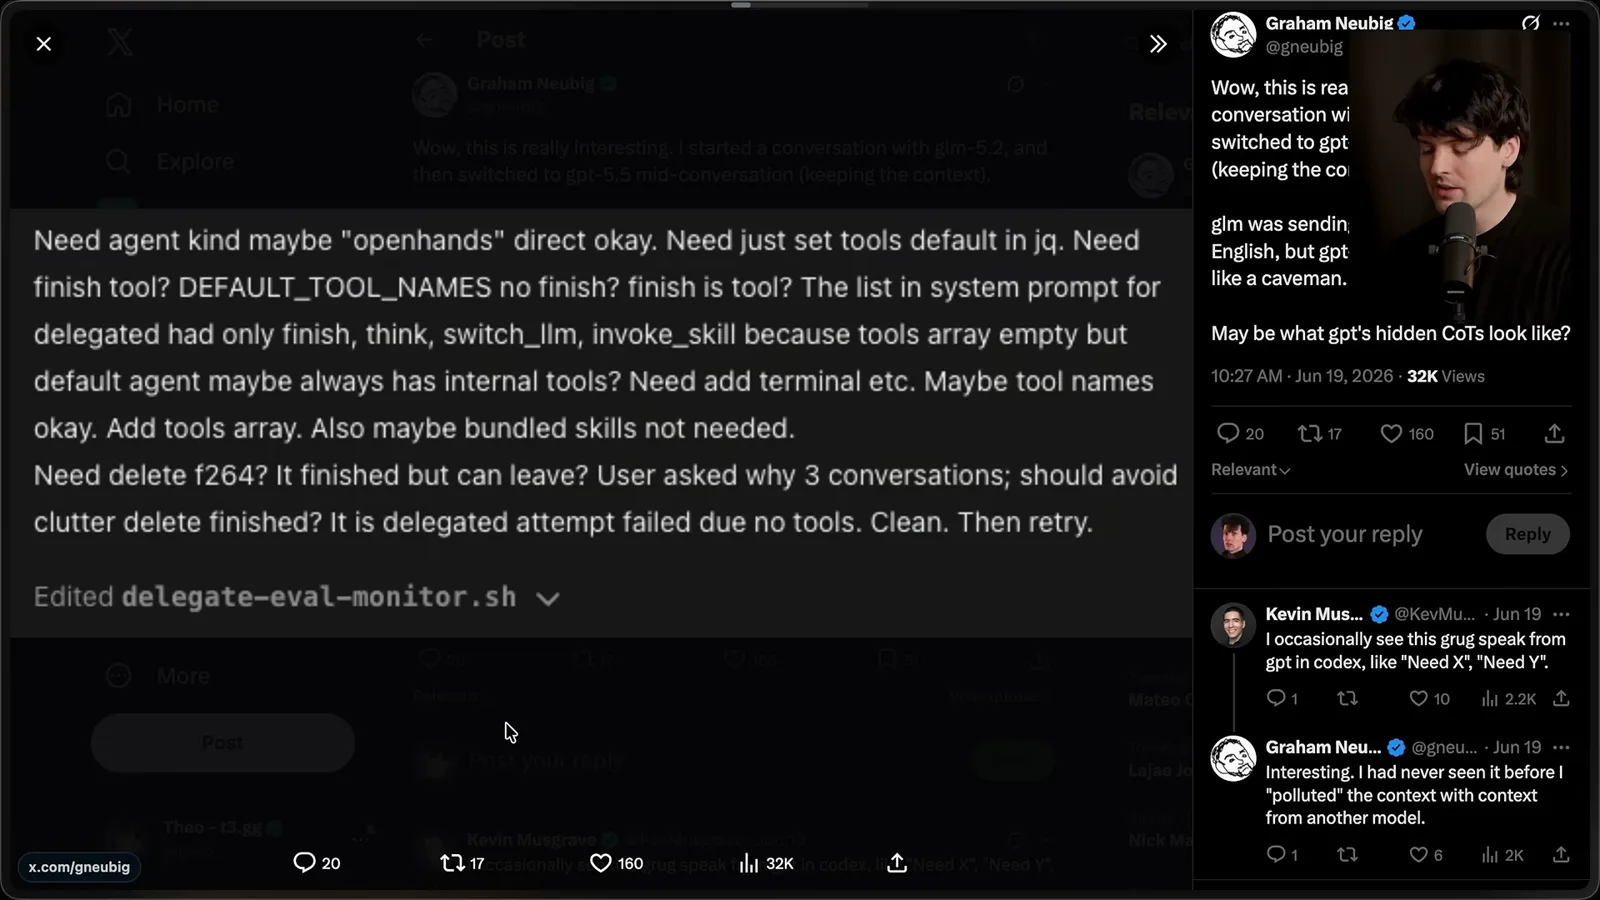
我借用了“Grug”式写作的想法:几个词能说清楚,为什么要用很多词?我的假说是,模型可以使用简短、不拘语法的内部文本,同时向用户输出流畅答案。如果行得通,推理就可能消耗更少 Token,而最终答案不必同样简短。
我展示了一些作为 GPT 推理泄露内容流传的例子,看起来像简短笔记,而不是通顺文章。它们提供了线索,但本视频并未证实其来源和代表性。我不知道这种风格是有意训练出来、间接涌现,还是能够解释观察到的基准差异。
取舍与开放问题
他推测上下文和激励方面的取舍,然后比较不同 GLM 版本的可见推理。
我推测,不同推理风格可能影响对话语气,商业激励也可能影响实验室对效率的关注。我还猜测,较长的推理可能促使产品提供更大的上下文窗口。这些是我对取舍和激励的看法,并不能证明服务商的动机或内部设计。
我还在想,简短推理记录作为长历史时是否更难利用,从而导致上下文增长后性能下降。我自己没有测试百万 Token 的 Codex 配置,因此不能确立这个结论。上下文质量、保留和压缩都是需要分别测量的问题。
隐藏推理也带来可观测性问题:开发者能看到用量、摘要和答案,却可能看不到模型为什么作出某个选择。竞争实验室同样无法仅凭最终答案直接复制隐藏过程,需要自己的训练和推理方法。我对具体实验室使用何种训练数据的说法仍属猜测。
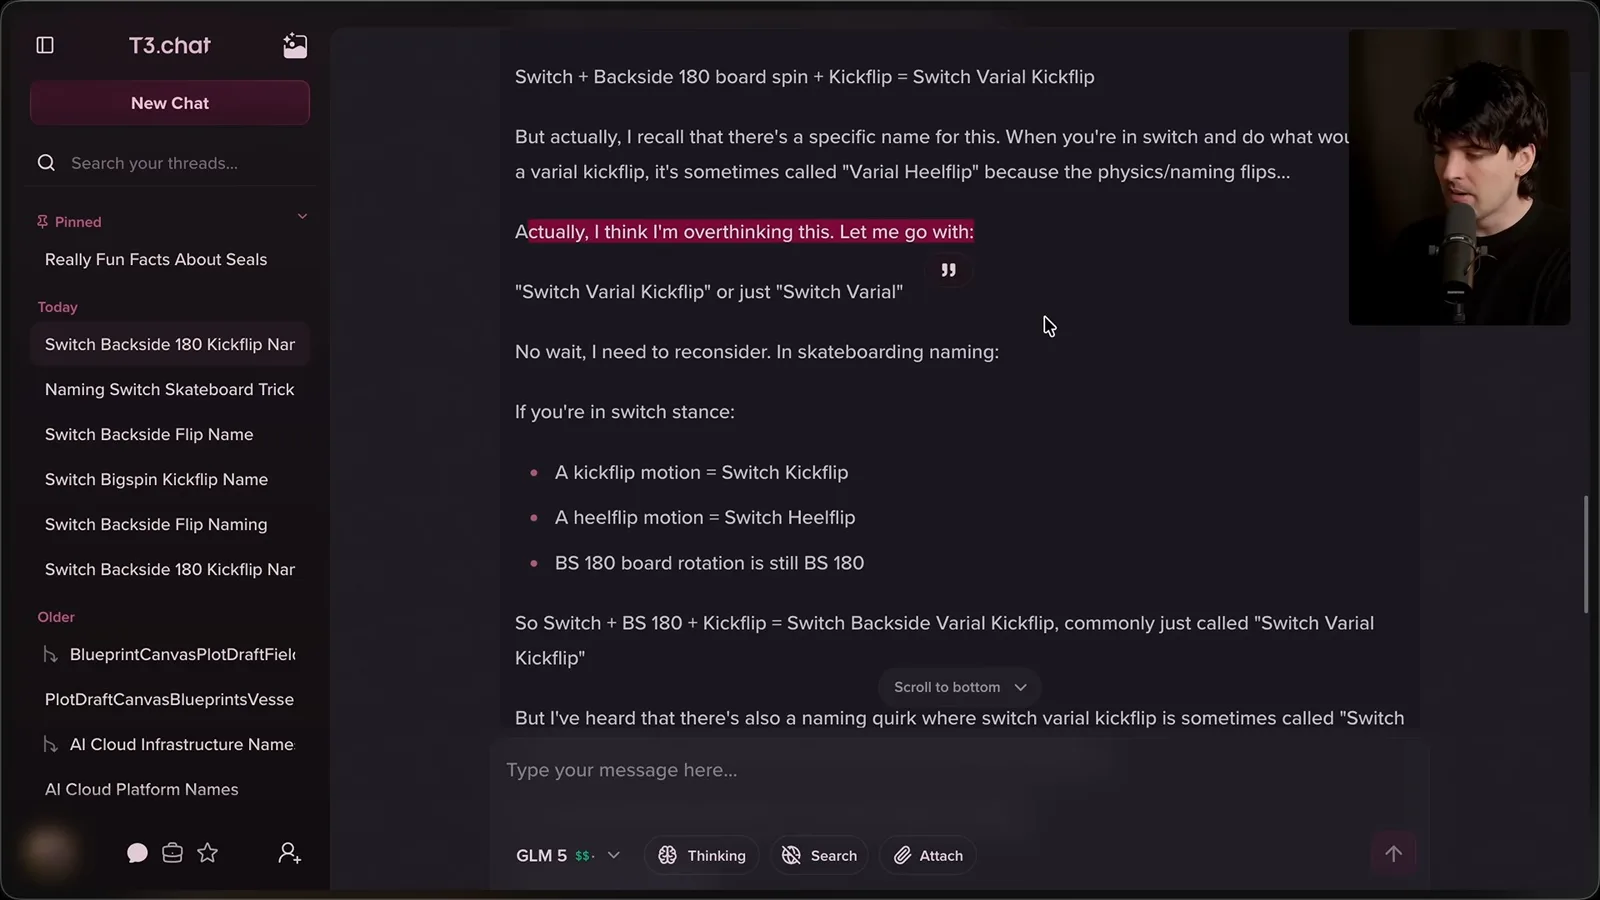
为了观察风格差异,我用旧版 GLM 5 回答同一个滑板问题。它可见的推理反复重新考虑名称,最后得出正确答案。这个例子中它使用约 1,516 个 Token,而 GLM 5.2 约用 600 个;一次运行无法确定普遍的效率倍数。
我认为各家实验室正在试验同时提升推理质量和效率的训练策略。我引用的 Artificial Analysis 数字仍显示明显差异:在该评估中,GLM 5.2 平均每任务约 42,790 个 Token,而 GPT-5.5 medium 约为 5,000 个。尚待回答的有趣问题是,哪些设计和训练因素共同造成了这些差异。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。