30 秒看懂
Theo 分享了提前使用 GPT-6.1 Sol 的经验。他认为该模型价格低,在范围明确的调查和代码审查中尤其细致,但在长时间自主实现和协作上仍偏好 Claude Opus 5.5。他的基准结果包含未完成的运行、被排除的任务和规模较小的个人测试;关于模型规模与服务商利润的说法只是推测。
- 1初步基准结果部分 Terminal-Bench 运行尚未结束,三项依赖 GPU 的任务也被排除。Theo 提醒读者不要将这些结果当作完整比较。
- 2价格与缓存读取他引用的发布价格为每百万输入 token 2 美元、每百万输出 token 10 美元,以及每百万缓存输入 token 0.10 美元。
- 3代码审计在他的 Orchestrator V2 比较中,Sol 的分数接近 Astra,而该测试的费用约为后者的一半。
- 43D 游戏演示生成的游戏在视觉上让他印象深刻,但界面设计、操控和帧率让他失望。
- 5实际审查他说,该模型在 T3 Code 的一个拉取请求中发现了其他审查遗漏的两个问题。
要点建议
- 在 Theo 的测试中,GPT-6.1 Sol 以较低成本完成了深入的范围明确的代码审查。
- 他的基准测试数字仍是初步结果,不能代表所有工作负载的表现。
- 对于反复读取上下文的代理任务,缓存输入价格可能显著影响成本。
- Theo 认为模型在长时间无人监督的实现和前端设计上,不如代码调查可靠。
- 分别使用不同模型实现和审查,帮助他发现了单一模型可能遗漏的问题。
按章节阅读整理后的全文
新模型与初步测试
Theo 披露自己提前获得了模型访问权限,并与近期发布的模型比较。他的基准运行尚未完成,应谨慎解读。
Anthropic 发布 Opus 5.5 后不久,OpenAI 推出了 GPT-6 Sol 和 Luna。它们都没让我觉得值得专门做一期视频。但我还提前用到了 GPT-6.1 Sol,发现它的能力和低价都出乎意料。OpenAI 要求我等到发布后再讨论;我没有收钱,公司也没有控制我的观点。
首先要提醒大家注意图表:我前两次运行 Terminal-Bench 时出了错,缺少 medium 运行,max 运行也未完成。对于尚未完成或此前失败的任务,我暂时用 x-high 的结果补上。数字还在变化;自己运行基准测试让我更怀疑整齐的排行榜。
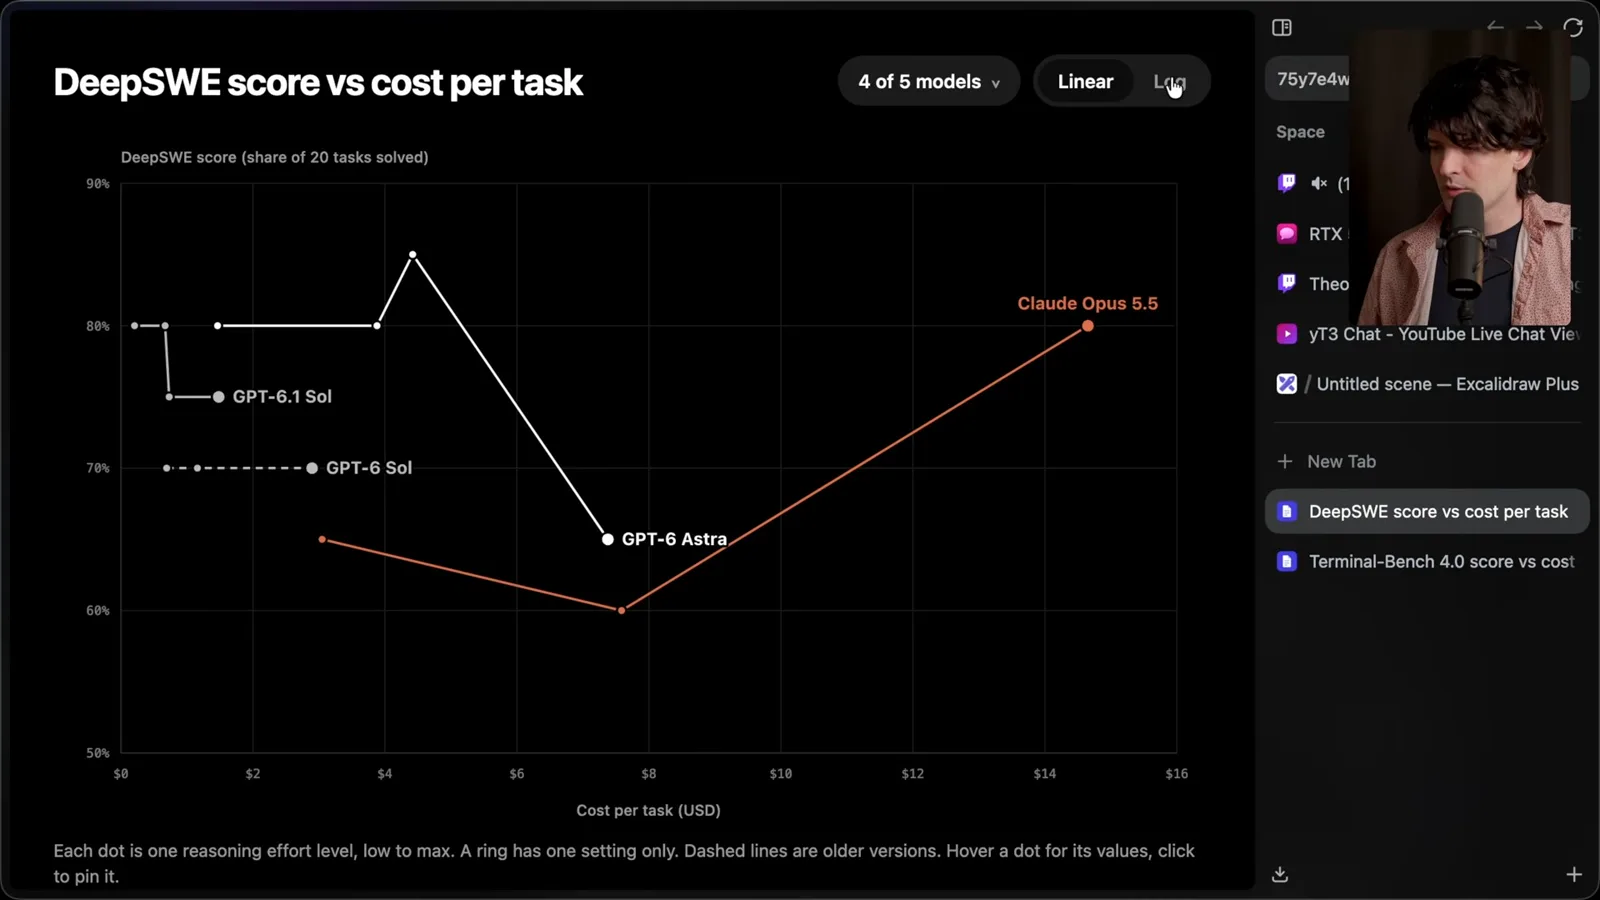
在我的 DeepSWE 比较中,Sol 在 low 档每个任务约花 0.21 美元,Astra low 约 1.46 美元,Opus 5.5 max 约 14.65 美元,后者与 Sol 显示的分数相同。约 70 倍的差距很醒目,但 DeepSWE 不能完美代表日常编程,这也只是特定配置下的一次比较。
价格、缓存和推测
他讨论订阅变化、发布时的 token 价格和缓存读取的重要性。他对模型规模与利润率的判断尚未得到证实。
两次发布相隔很短,让我怀疑 Sol 6.1 不只是一个小更新。它看起来比 Sol 6 更聪明,生成 token 的速度也更慢,我推测这可能意味着模型更大。但仅凭这些观察,无法确定它的架构或 OpenAI 的发布计划。
我还讨论了一篇关于 200 美元 Pro 订阅变化的帖子,并估计同一套餐换算成 API 价格后的用量价值可能下降。这只是我的计算,不是保证额度;限制因人而异,订阅也不是现金余额。
按我引用的发布价格,该模型每百万输入 token 收费 2 美元,每百万输出 token 收费 10 美元。每百万缓存输入 token 收费 0.10 美元,比普通输入低 95%。对于反复读取同一上下文的代理,缓存价格可能比标价更重要。
我推测这些价格和订阅调整反映了服务商的利润压力,也提到利润率很高的传闻。这些数字和定价原因都不是经证实的财务事实。任务实际成本取决于缓存输入、未缓存输入和输出各占多少。
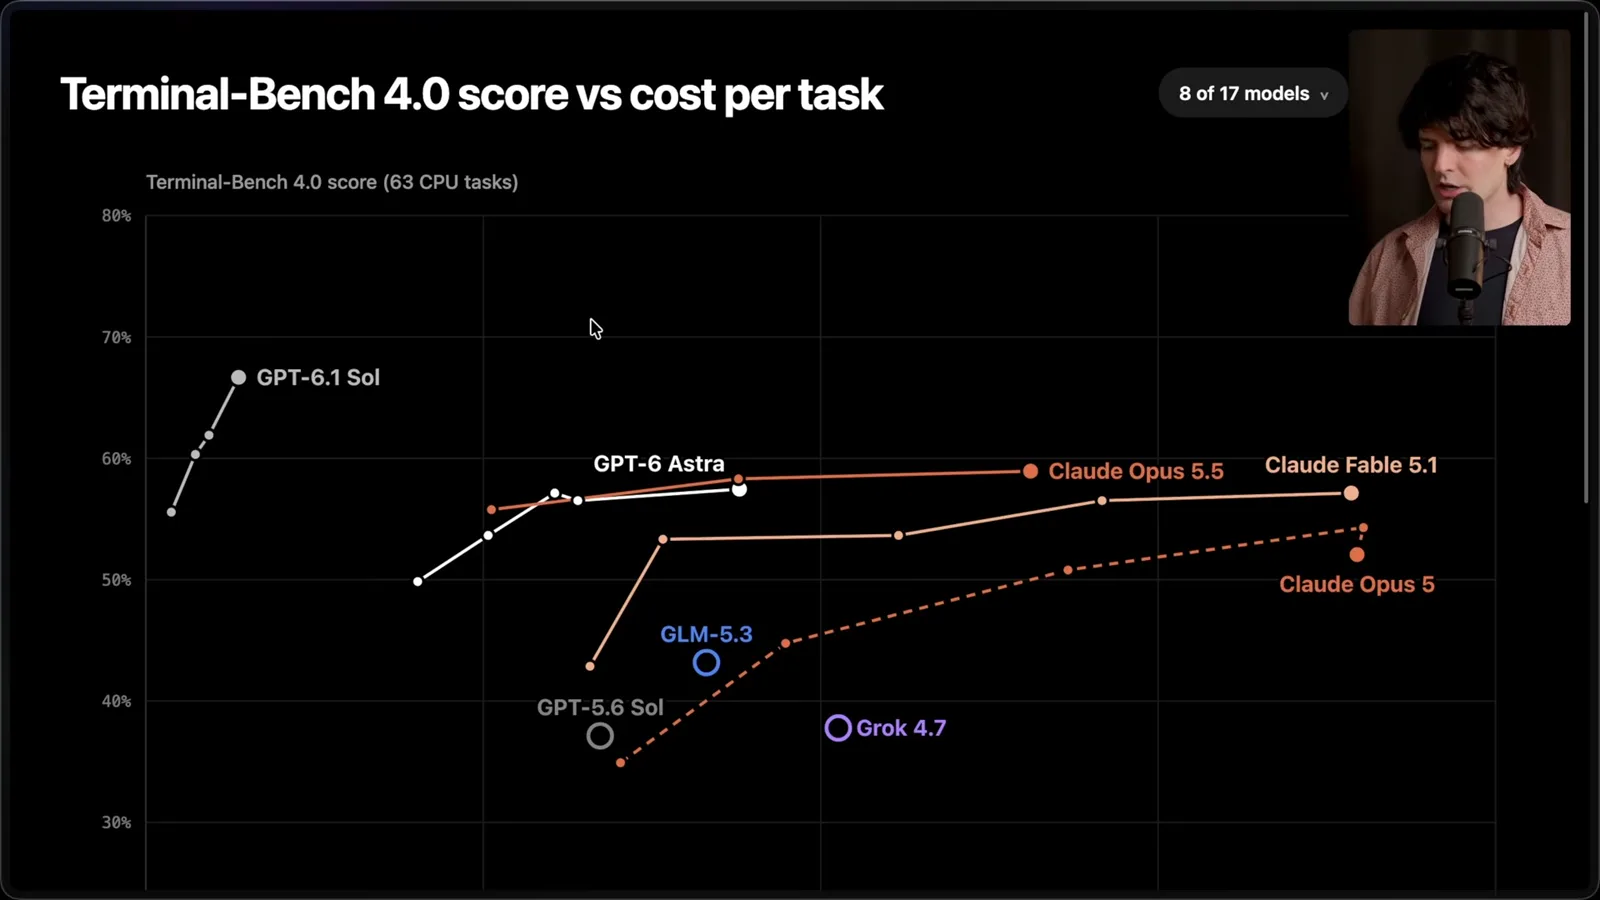
随着运行结束,Terminal-Bench 图表会更新。我是在自己网络中的机器上运行测试,并排除了三项需要 H100 的任务,因此这不是完整的基准套件。即使这里成绩出色,也应结合实际工作判断。
在我的运行中,最贵的 Sol 6.1 配置每个任务约花 1.38 美元,而我测试的最便宜的 Opus 5.5 配置约花 5.12 美元。这种成本差距值得我们进一步问:它能否胜任我此前交给 Opus 的实际工作?
稳定性与代码审查
他比较模型行为并展示个人审计结果,区分范围明确的调查和长时间无人监督的实现。
我对 Astra 的主要不满是表现不稳定:它有时能力极强,有时却突然犯很基础的错误。因此我把许多日常工作转到了 Claude 模型。以我的经验,Sol 6.1 没那么容易出现这种波动,但问题没有完全消失。
它表现最好时不如 Astra 的巅峰能力;在某些高难度任务上,我仍认为它略逊于 Opus 5.5。操作电脑方面它也不及 Astra,但对我的许多日常任务已经足够好。这是我的体验,不是可靠性的保证。
例如,我让它寻找未付发票,并为投资汇款准备浏览器页面和填写相关信息,留给我检查并发送。我说它发现了我可能遗漏的细节。金融操作后果重大;我的成功案例并不免除对收款方、金额和授权的检查。
其他提前测试者有人称它令人惊艳,也有人说它无聊。我认为模型能稳定工作时,无聊可以是一种赞美。在能力边缘,它仍可能表现古怪,因此我在某些任务上继续使用 Opus。
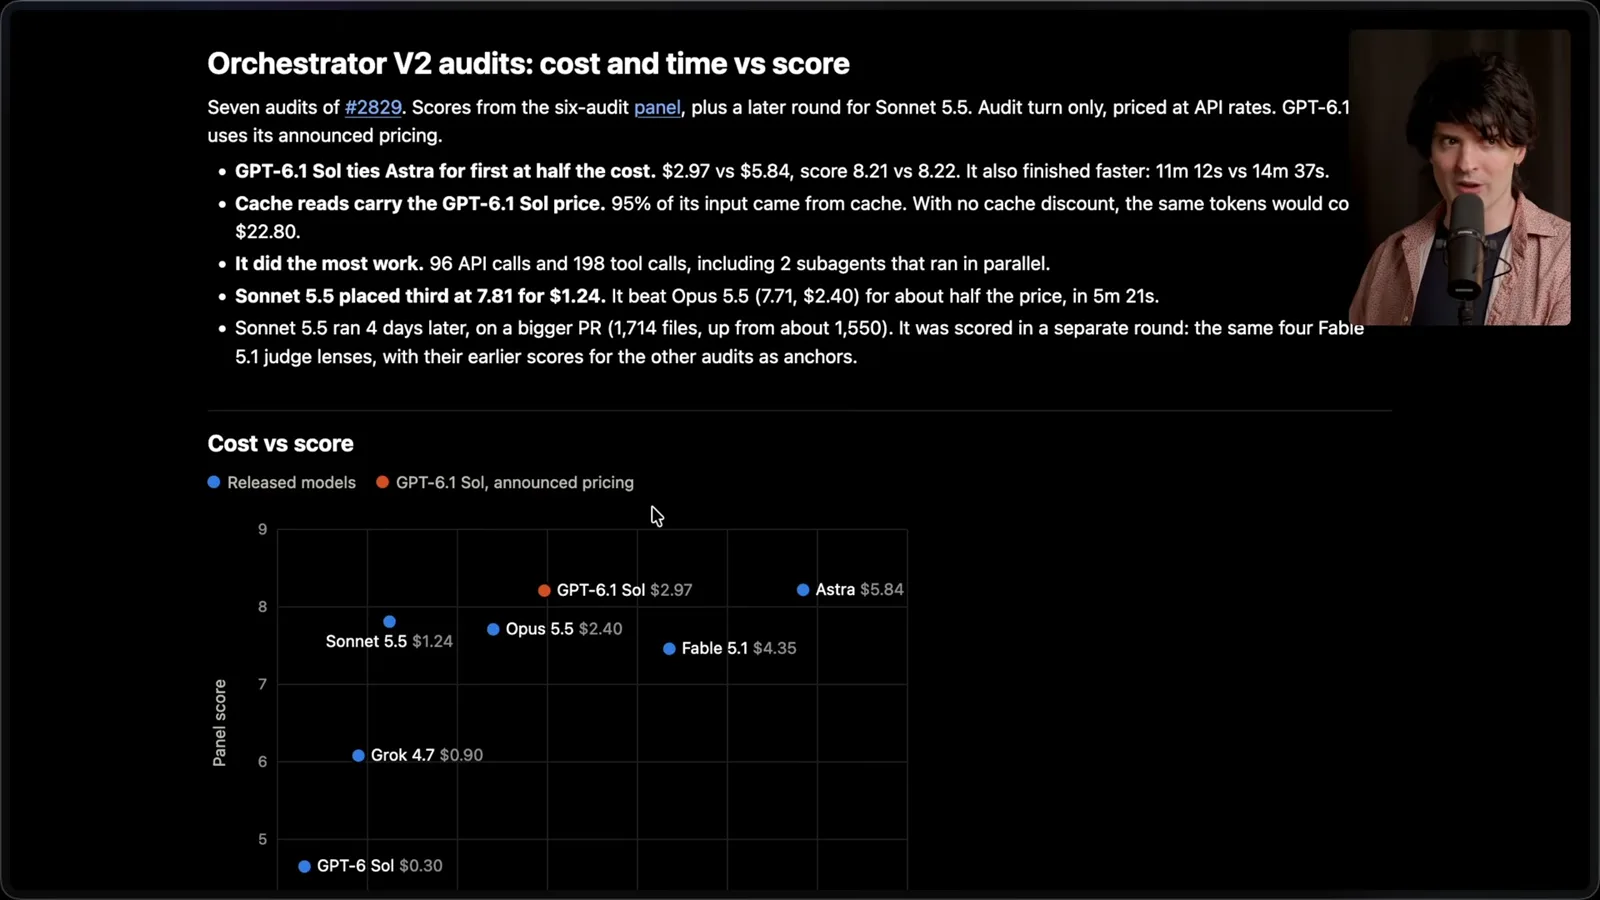
Sol 的一个强项是深入代码审查。在我的 Orchestrator V2 审计中,它的分数接近 Astra,成本分别为 2.97 美元和 5.84 美元。在这次测试里 Sonnet 和 Opus 更便宜,但我认为它们的分析没有那么深入。这是我的审计设置得出的分数,并非普遍保证。
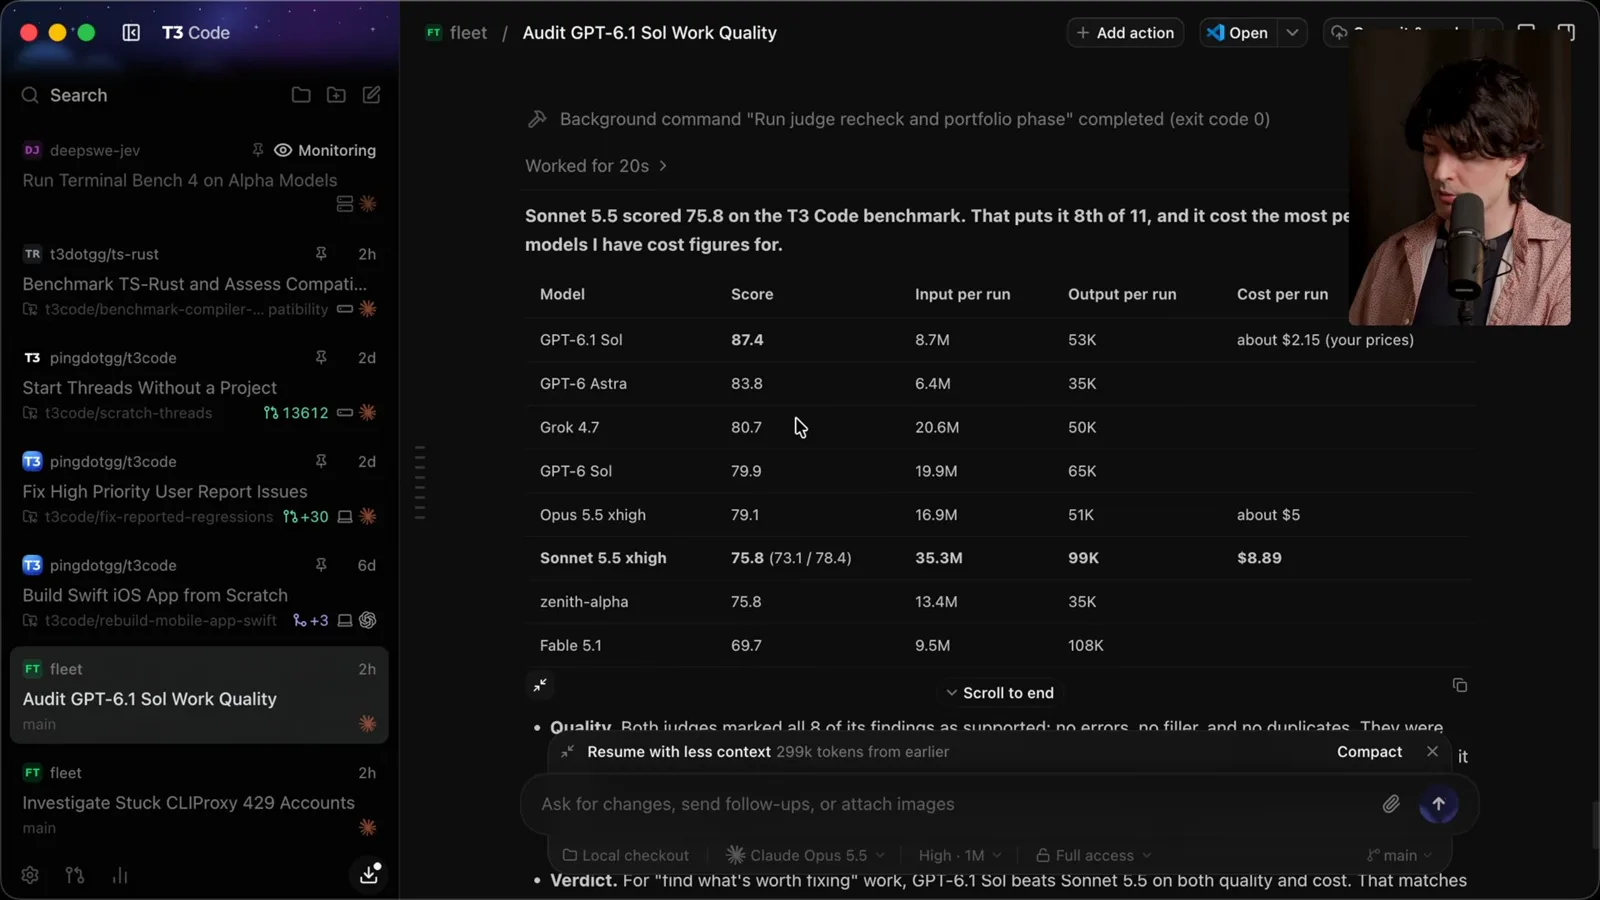
我还让模型寻找 T3 Code 代码库中可改进之处。我报告的 Sol 分数是 87.4,Astra 为 83.8,Grok 4.7 为 80.7。Sol 本次约花 2.15 美元;画面中 Opus 和 Sonnet 的对比成本约为 5 美元和 9 美元。这些都是单次任务结果。
我让 Opus 5.5 在不知道模型身份的情况下审查这些工作。它认为 Sol 擅长范围明确的调查和发现问题,但长时间无人监督的构建较弱。第一版代码存在真实 bug,审查工具发现了它们。这是模型对我提供的案例作出的评价,不是独立评测。
我的 TypeScript 转 Rust 项目体现了这种差异。Sol 6.1 花了很长时间和大量 token,却没有改进编译器;我说 Opus 重新开始后大约一天就让工作取得进展。不同尝试的起点和条件不同,所以这是案例,而非受控基准。
管理我的机器集群时,Sol 犯了一些错误;Opus 也有失误,Astra 在我注意到的这类错误上相对少一些。尽管如此,我预计自己会更多使用 Sol,因为它兼具较低成本和调查能力。
在公布实际价格之前,我问 Opus 认为这个模型应该怎么定价。它猜了更高的价格,得知实际价格后称发布定价激进。这个实验展示的是我的会话和模型生成的判断,不能证明价格会保持不变或上涨。
在分析过的会话里,代理估计重复的缓存读取约占输入的 96%。按所引用的价格,它算出费用约为 1550 美元;按它最初猜测的价格则约为 5700 美元。这个比例和节省金额针对我的工作负载;其他流量模式可能很不一样。
成本效率与模型路由
模型生成的成本分析和路由器比较展示了工作负载与缓存如何改变实际成本。结果来自他自己的测试。
另一次比较中,与我对比的 Sonnet 运行相比,Sol 完成了多轮工作,上下文增长更少,输入 token 也更少。上下文管理和输出长度对总成本的影响,可能与每个 token 的价格同样重要。
我还在 DeepSWE 上测试了 OpenRouter 的 Jev Router。在我的运行中,它约 60% 的请求发给 DeepSeek V4.1 Flash,每个任务约花 20 分钟,平均 104 步;Astra low 分别为 4.6 分钟和 19 步。我对结果感到失望,但这只反映该基准和配置。
在我的测试中,Sol low 的 DeepSWE 显示分数与路由器相同,价格约为后者的八分之一。它还以更短时间和更低成本达到 Opus max 显示的相同分数。不过我仍会根据工作类型选模型:小规模基准分数无法涵盖所有失败情形。
我预计会用 Opus 完成长时间的实现工作,再让 Sol 负责调查、根因分析和审查 Opus 的成果。组合模型可以利用不同强项,但仍需要验证和人工决策。
鱼缸游戏演示
生成的游戏有出色的 3D 素材,但 Theo 批评了界面、性能和操控。
再来看我的鱼缸游戏测试。Sol 生成了漂亮的 3D 鱼、植物和潜艇,但外围界面文案在我看来过多。与我用 Claude 生成的版本相比,画面细节更好,操控手感却更差,帧率也更低。
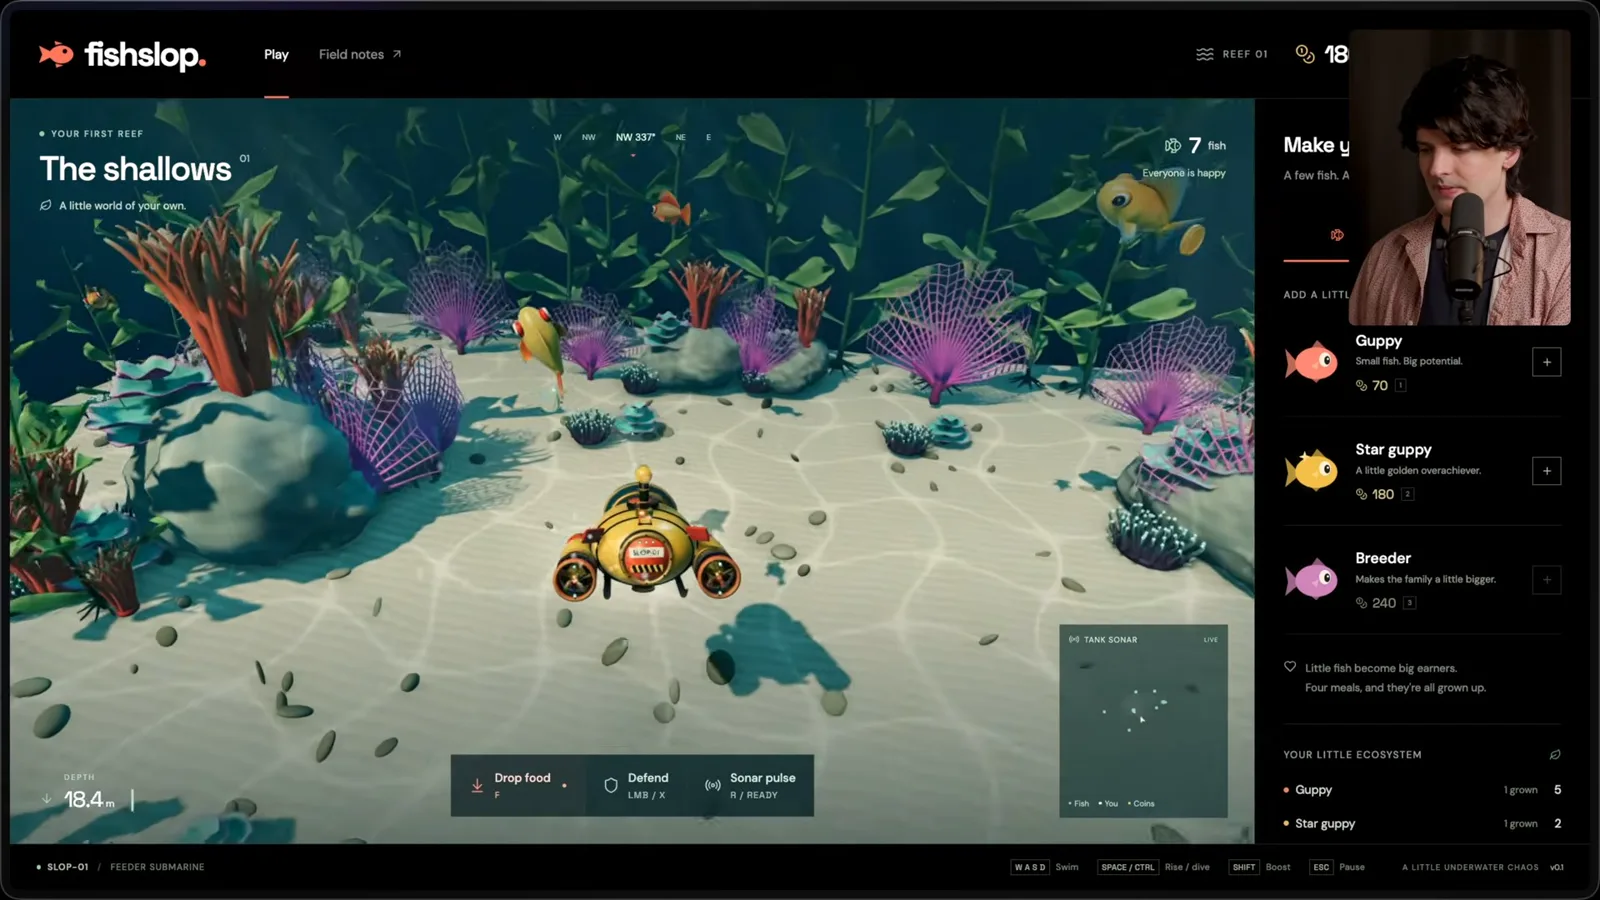
我不会把这个结果当作完成的前端或游戏机制。不过,它使用 Blender 制作 3D 素材的能力让我印象深刻;我估计生成游戏花了约 5 美元。我想试试让另一个模型保留画面,同时改进玩法。
在实际工作中组合模型
T3 Code 审查和 TypeScript 转 Rust 项目说明了他为什么偏好用不同模型分别实现和审查。他最后给出总体判断。
在提前测试期间,我不能把它生成的代码放进 T3 Code 或我的其他开源项目,所以主要用它处理内部项目和审计。一个真实的 T3 Code 拉取请求涉及 worktree 配置窗口:切换离开再回来时,窗口会消失。
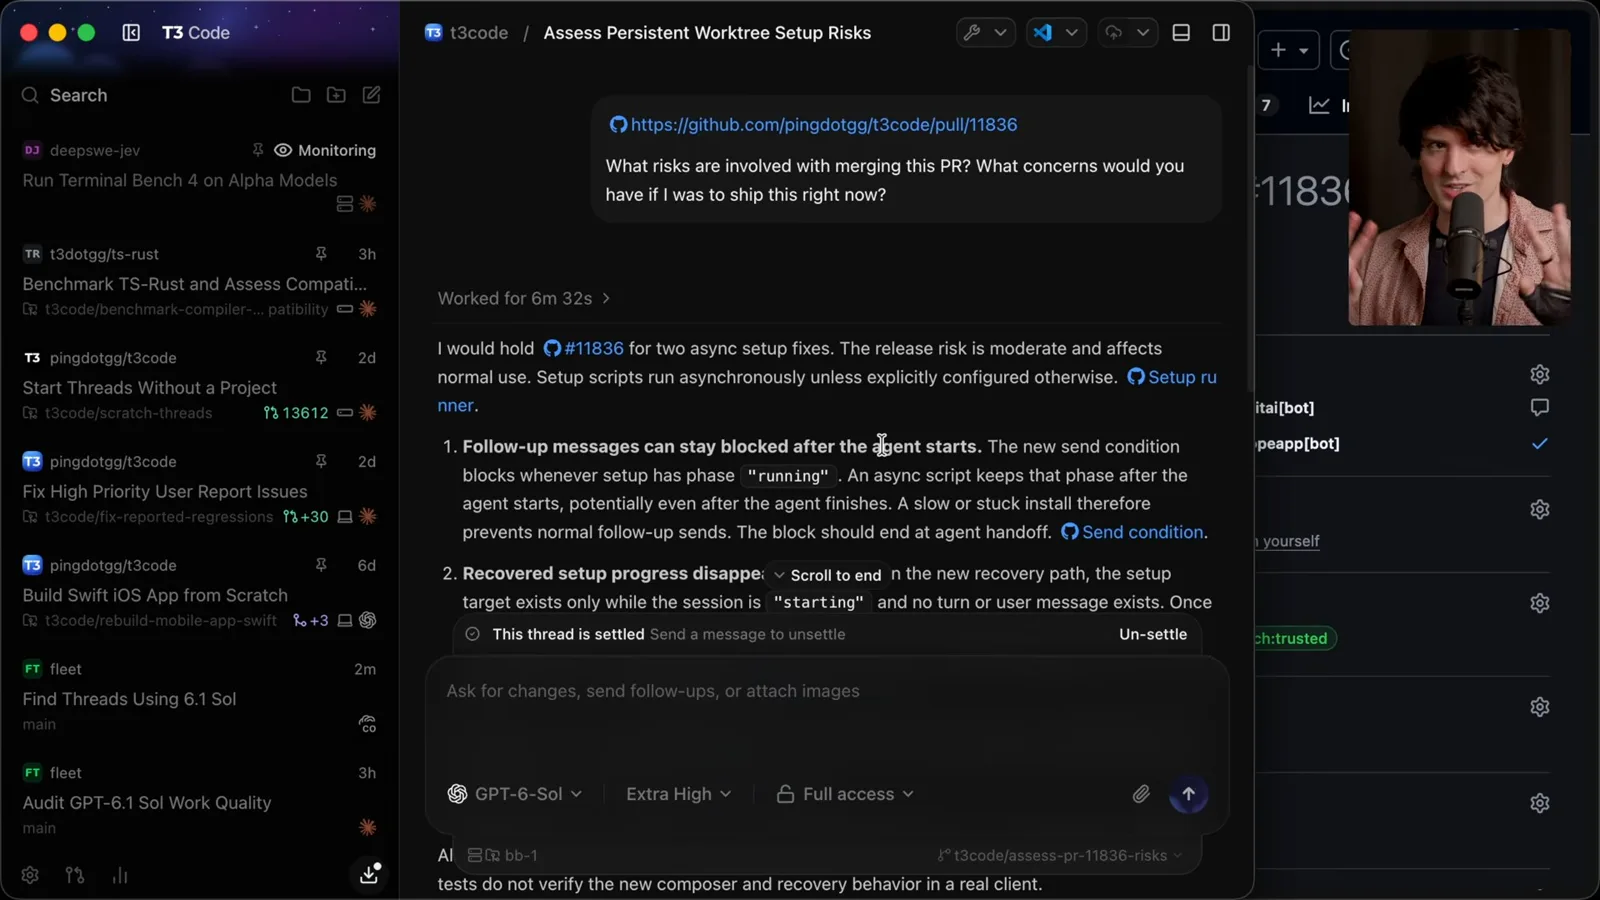
我说 Sol 找到了其他审查遗漏的两个问题:代理启动后,后续消息可能一直被阻塞;恢复的配置进度也可能过早消失。它结合了代码分析和电脑操作。我把发现转交给 Claude,反复审查修复,最终在处理这些问题后合并。
这就是我喜欢组合使用模型的原因:Sol 擅长钻研细节和审查;对我来说,Opus 更适合协作,也更擅长在不中途卡住的情况下继续实现。不能仅因为另一个模型审查过,就认定任何模型的输出正确。
在 TypeScript 转 Rust 项目中,我说 Opus 在不到一天内把我使用的指标从 83.7% 提高到 100%。Sol 随后审查时发现,约 180 万行代码中有 130 万行已不再使用:Opus 在另一个 crate 中重写了实现,却留下了旧内容。
我的结论是,Sol 可以成为范围明确的工作和审查任务的强力默认选择,即使我在大型实现中仍更喜欢与 Opus 协作。我计划用 Sol 调查代码并审查 Opus 的工作,同时保留 Claude 订阅。至于这次发布可能预示订阅补贴时代结束,那只是我的推测。
同频道的其他文章
 36:07EN → 简体中文
 Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。
 31:47EN → 简体中文Theo - t3․gg· 2026年10月18日Theo:向智能体请求结果,再构建它需要的工具Theo Browne · Ping Labs从工具耗时报告、排障手册到数据连接,看提示如何改变产品工程。