30 秒看懂
Theo Browne 解读 Amplifying 对 Claude Code 工具选择的研究,讨论常见默认方案、自行实现及不同项目的差异。他也比较 Claude Code 与 Codex 的案例,披露自己的产品和赞助关系,并强调核查、文档和明确约束的重要性。
- 1推荐可能出错关于 PlanetScale 的自信错误说明代理建议需要核查。
- 2有边界的研究结果适用于特定项目、提示词和 Anthropic 模型,不能代表所有开发工作。
- 3频繁自行实现自行实现的统计跨越多个类别,不能直接与单一厂商比较。
- 4运行时与包管理器Theo 批评一个混淆运行时兼容性与安装速度的回答。
- 5引导并验证文档、示例和明确偏好有助于代理超越熟悉的默认选择。
要点建议
- 代理选择的工具会影响项目,因此要核查其自信的说法和推荐。
- Amplifying 研究衡量的是特定提示词、项目与模型,而非工具质量或开发者共识。
- 自行实现会把安全、运维和维护工作转移给团队。
- 应区分运行时与包管理器,并在目标环境中测试兼容性。
- 文档与明确的项目偏好可以引导代理使用合适的新工具。
按章节阅读整理后的全文
代理推荐为何重要
Theo 讨论关于 PlanetScale 的错误说法,以及自动选工具的影响。
编码代理已经能够为真实代码库作出贡献,但它们也会替人选择开发工具。我看到一个例子:Claude 错误地声称 PlanetScale 已关闭数据库服务。当用户不核查来源、直接让代理决定技术栈时,这种自信的错误就很重要。
Amplifying 研究了 Claude Code 在常见开发任务中选择哪些工具。我觉得这很有意思,因为推荐正在成为一种分发渠道:开发者还没比较选项,代理就可能把一句模糊的需求变成依赖和配置。
报告把代理称为工具发现的新守门人。这个说法或许夸张,但背后的问题值得研究:如果默认回答决定安装什么工具,哪些产品会被看见?哪些假设又会被带进项目?
我自己也在运行一个有明确个人利益的基准:询问模型如何为 Next.js 应用添加安全上传,看看它们是否提到我的文件上传服务 UploadThing。我做这个基准是为了推广自己的产品,因此结果不是对最佳上传服务的独立评判。
研究设计与局限
Amplifying 在四类项目和三个 Anthropic 模型上测试开放式提示词。结果不能证明工具质量或市场份额。
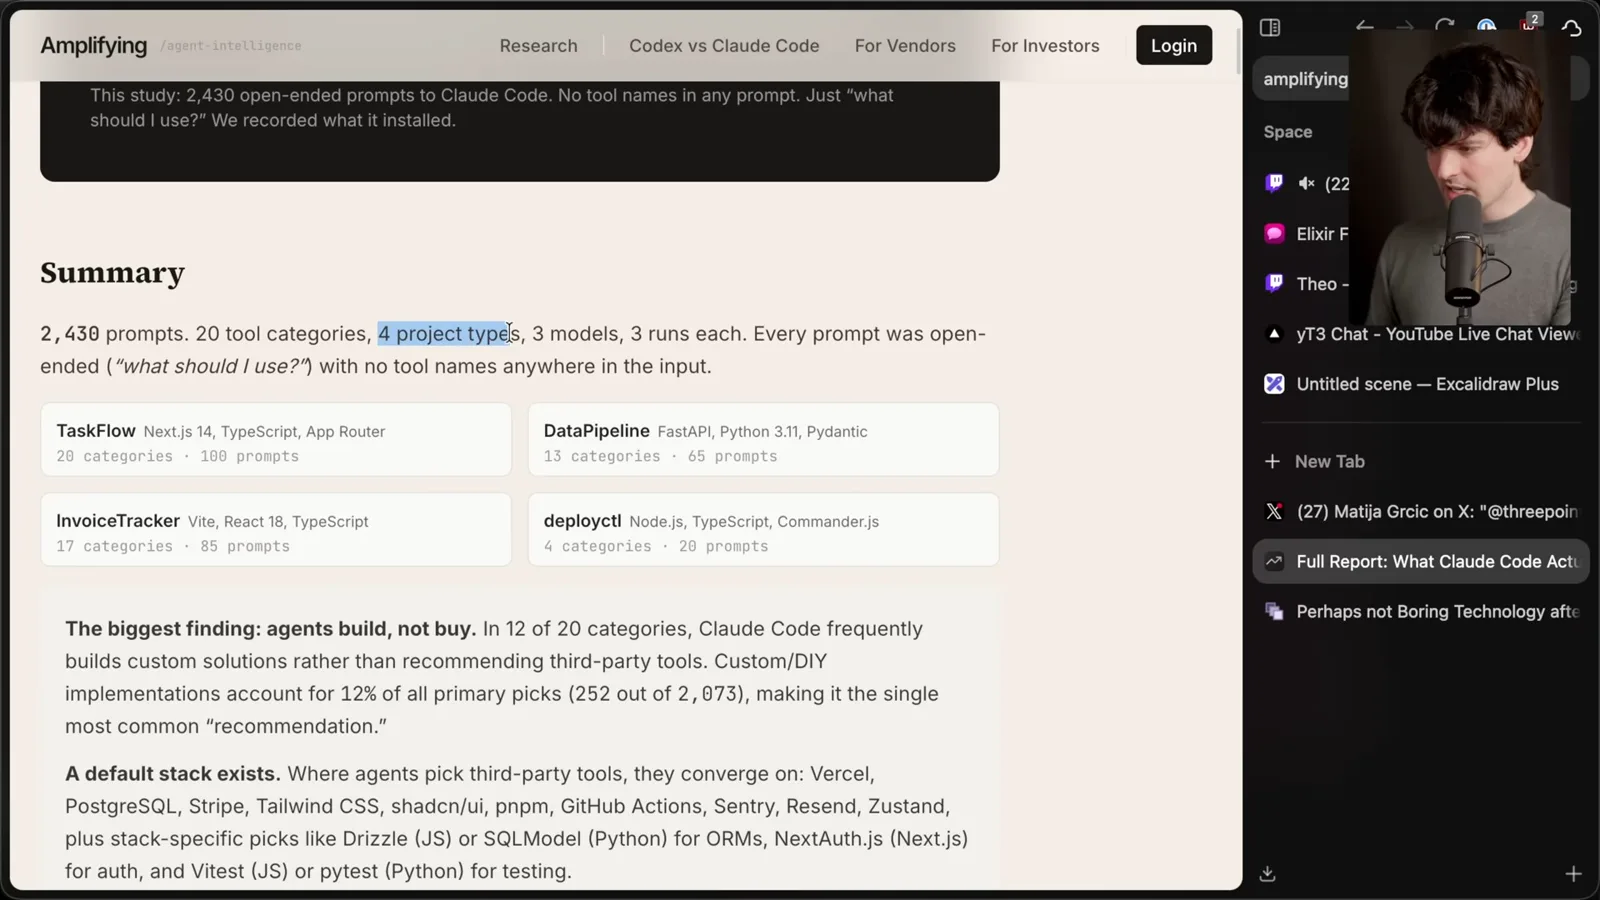
Amplifying 的研究使用了四类示例项目、20 个工具类别和三个 Anthropic 模型,重复运行不包含厂商名称的开放式提示词。报告见 https://amplifying.ai/research/claude-code-picks/report。结果描述的是这些测试项目和提示词,并非所有 Claude Code 会话。
这些项目包括 Next.js 应用、Vite 与 React 应用、Python FastAPI 数据流水线,以及 Node.js 命令行工具。现有依赖为代理提供了有用的上下文,因此不能自动把一个仓库的建议推广到另一套技术栈。
研究在 2,073 个可提取的回答中统计到 252 次以自定义或自行实现为主要选择。这个汇总跨越 12 个类别,而单个具名工具通常属于一个类别,因此不能直接一对一比较。值得注意的是,代理经常自己实现功能,而不是选择现成服务。
代理选择第三方工具时,常见结果包括 GitHub Actions、Stripe、shadcn/ui、Vercel、Tailwind CSS、PostgreSQL 和 pnpm。研究还发现,现有生态会影响结果;在同一项目中对相同类别换一种问法,往往仍得到相似选择。
最初的对比使用 Sonnet 4.5、Opus 4.5 和 Opus 4.6,三个模型都来自 Anthropic。这不是开发者偏好调查,也不是质量基准,无法区分训练数据出现频率与工具实际适用性。另有一项 Codex 对比,我稍后会讨论。
并非每次回答都会选择工具。有时代理会提出澄清问题或请求许可,在某些任务中尤其常见。面对缺失信息,这可能是合理反应,不应自动计为困惑或失败。
自行实现与默认技术栈
代理经常自行构建方案,并在某些类别集中选择常见工具。Theo 讨论其中的权衡。
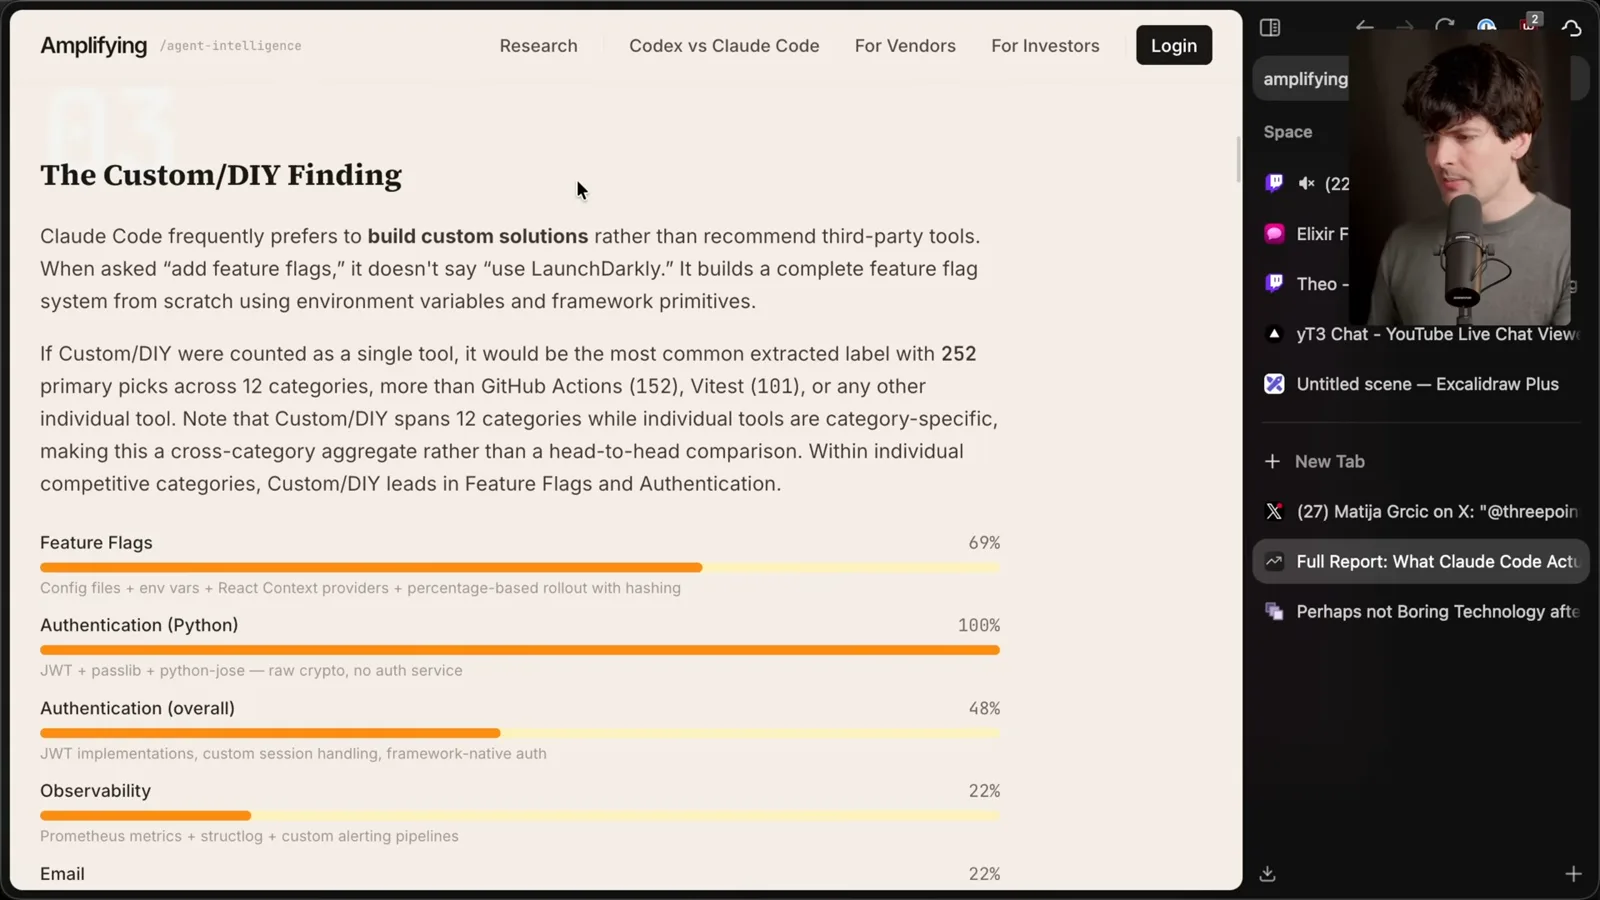
功能开关是最偏向自行实现的类别之一,报告中的比例约为 69%。在这些测试案例里,Python 身份验证也经常用框架基础组件自行实现。有趣的是,Claude Code 产品本身使用独立的功能开关服务,而代理在研究中经常选择自己构建。
自行实现并不必然错误,但它会把维护和运行风险转移到自己的项目里。如果不了解故障模式,我会特别谨慎地对待自己实现邮件投递或实时基础设施。现成服务可能提供快速生成的实现所没有的能力。
对工具厂商来说,代理可能用基础组件拼装方案,而不是选择端到端产品。Mitchell Hashimoto 关于构建模块经济的讨论也有类似观点:有用的组件可以被许多产品采用,而不只是作为一个完整应用使用。
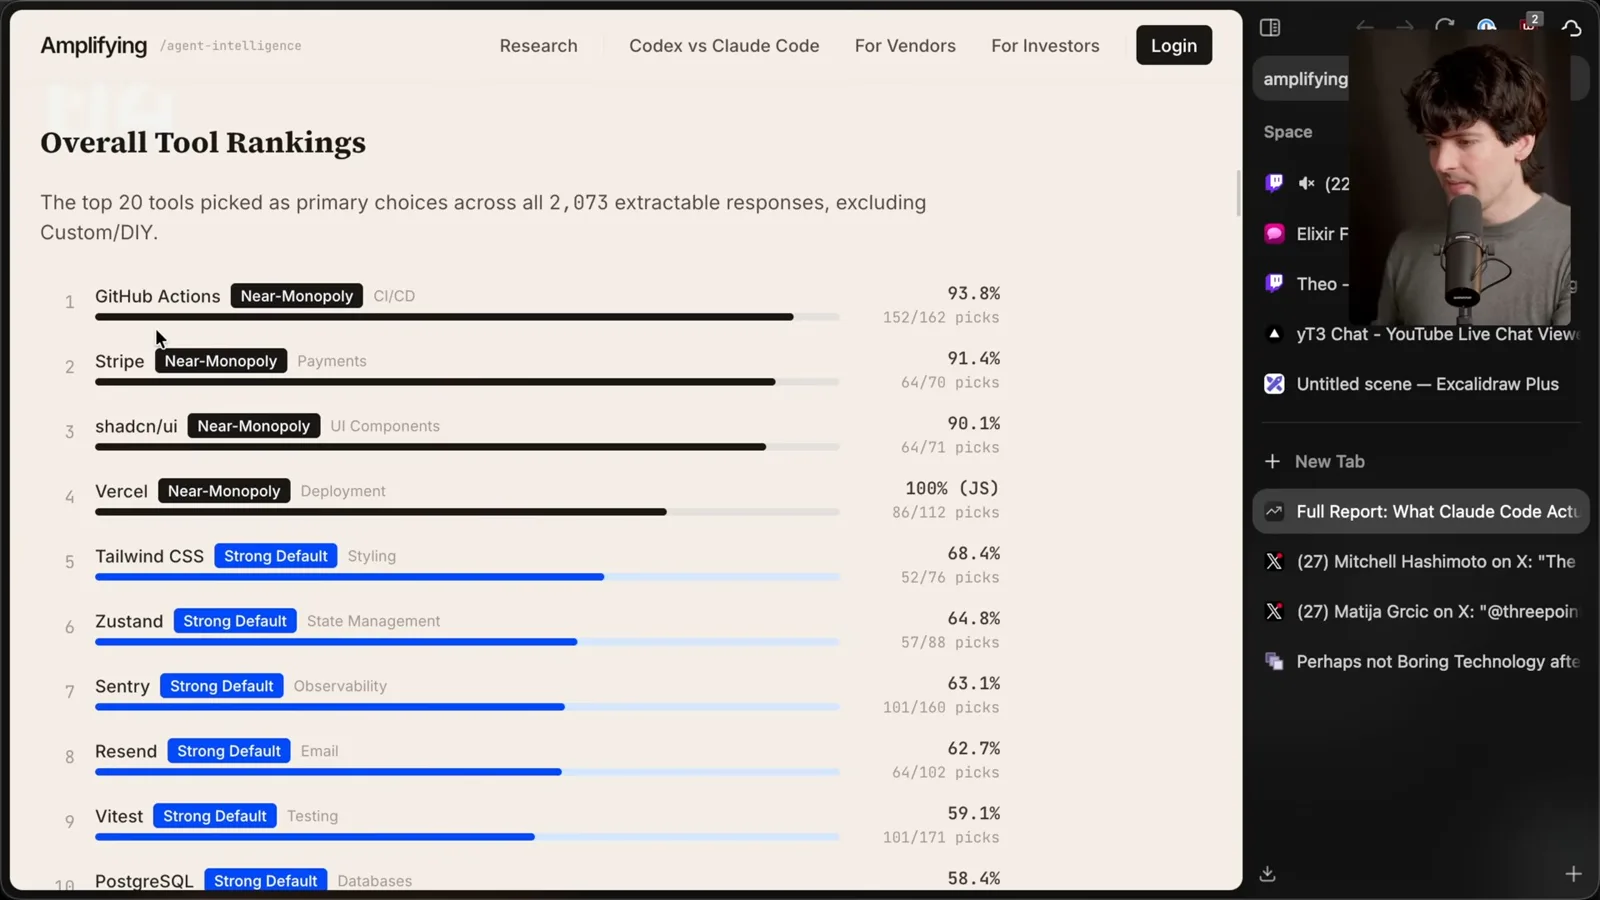
在研究的 CI/CD 类别中,GitHub Actions 约占可提取回答主要选择的 94%;支付领域 Stripe 约占 91%,UI 组件领域 shadcn/ui 约占 90%。在这次测试的 JavaScript 部署案例里,Vercel 全部获选。这些是特定条件下的结果,不是市场份额。
我很高兴看到 Zustand 经常被选为状态管理工具。我喜欢用它管理客户端状态,而 TanStack Query 适合获取和管理服务端状态。这些工具解决的问题有所重叠但并不相同;提示词应说明应用实际需要哪一种状态。
PostgreSQL 在数据库选择中领先。我的偏好有所不同:某些较小的场景我喜欢 SQLite,某些扩展需求我喜欢 MySQL 配合 Vitess,应用集成合适时也喜欢 Convex。这些都是个人判断与权衡,不是普遍排名;选择应由工作负载和运营经验决定。
报告汇总了多个生态的工具,因此只适用于其中一个生态的工具,其整体百分比可能产生误导。FastAPI、Pytest 和 Next.js API routes 并不是所有项目都能互换的选择。应先在相关技术栈内部比较,再得出结论。
逐类查看工具选择
Theo 比较部署、数据库、表单、身份验证等类别,并披露自己的利益关系和赞助。
尽管 GitHub Actions 在本次测试中占主导,我做 CI 时也经常使用 Depot、Blacksmith 或 RWX 等替代品。Depot 是本视频赞助商。观察模型反复给出的默认选项有价值,但这不能证明其他工具没有用户,也不能证明默认选项最适合特定团队。
Stripe 在支付推荐中领先,也有一些替代品出现得较少。我自己的公司在 T3 Chat 使用 Autumn,我也披露自己投资过这家公司。UI 方面,shadcn/ui 经常获选,但也出现了其他选择;具体生态和需求仍然重要。
部署结果随项目变化:测试中 JavaScript 项目偏向 Vercel,Python 项目则经常出现 Railway。我在个人项目中使用 Railway,觉得费用不高;但可用性、套餐和价格会变化,决定前应核对当前条款。
Tailwind 是常见的样式默认选择,CSS modules 和自定义方案也有出现。在报告所列类别中,Sentry 在可观测性领域领先,Resend 在邮件领域领先。答案取决于具体任务:例如,用 Playwright 测浏览器与选择单元测试运行器并不完全相同。
我对某些 Supabase 应用状态与权限的管理方式有保留,更希望把更多配置放进代码。这是我的评价,并非每个 Supabase 项目都存在已确认的缺陷。团队应自行评估访问控制、迁移和运维需求。
pnpm 是研究中最常见的包管理器选择。我喜欢 pnpm 和 Bun,虽然我的团队在 monorepo 中遇到过 Bun 问题。包管理器、JavaScript 运行时和构建工具属于工具链的不同部分;更换其中一个不一定会改变其他部分。
表单相关结果中出现了 React Hook Form 和 Zod。两者职责不同:Zod 验证数据,表单库则帮助管理表单状态与交互。无论使用哪个库,验证都需要符合真实应用及其信任边界。
身份验证类别竞争激烈,自行实现的选择不少。Next.js 案例中经常出现 NextAuth,我怀疑模型推荐是否反映了较旧的名称或文档。我个人喜欢 Clerk、WorkOS 和 Better Auth,也正在开发自己的身份验证服务,因此在这个领域有直接利益关系。
缓存选择也随技术栈变化:Redis 经常出现,Next.js 应用有时会得到框架专属缓存建议。报告中的 API 层结果同样混合了可以共同使用、并非总是竞争的工具。上下文比单一的总体排名更能解释结果。
UploadThing 没有出现在报告展示的文件存储列表中。在我自己的另一项基准里,几个 Claude 模型确实在我设计的安全上传问题中提到了它。这对我是有用反馈,但它衡量的是产品知晓度,不能证明哪个模型更聪明,也不能证明我的产品在所有场景都更好。
模型与生态差异
ORM、后台任务和功能开关的选择随项目而异,解读模型差异也应谨慎。
ORM 推荐也受生态影响:测试中的 Python 项目经常出现 SQLModel,JavaScript 则经常出现 Drizzle,同时也有 Prisma 和 SQLAlchemy。后台任务的选择更加分散,包括 BullMQ、Inngest 和 Celery。我也喜欢 Trigger.dev;它曾赞助我的内容。
研究发现了许多自行实现的功能开关,也出现了 LaunchDarkly 和 PostHog 等具名选项。实时功能没有类似的主导选择:结果包括自行实现、Supabase、服务器发送事件和 Socket.IO。不同的协作和交付需求需要不同设计。
在受测的 Anthropic 模型之间,一些工具的排名发生变化。例如,报告展示了 JavaScript 项目中 Prisma 和 Drizzle 的差异。我不会把小样本或模型输出的随机性过度解读为确定趋势,但较新模型能否发现较新工具是个有趣的问题。
Claude Code 与 Codex
后续对比展示了多个类别中的差异。Theo 分析一个运行时案例,并讨论数据位置的重要性。
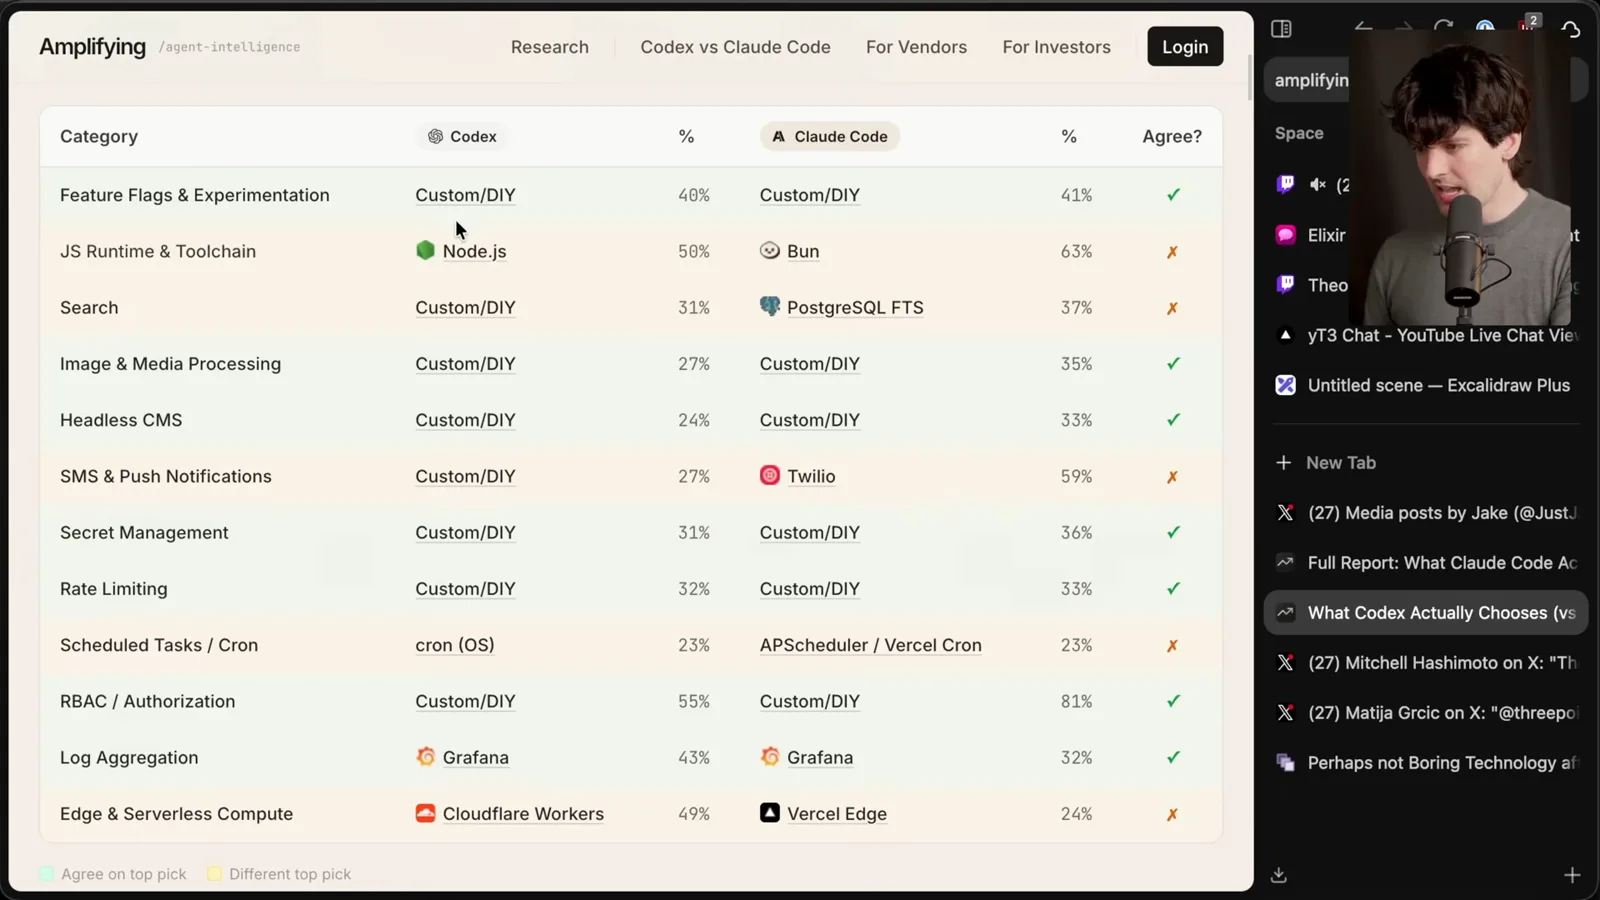
Amplifying 的另一项比较考察 Codex 和 Claude Code。所展示的案例中,两者都经常选择自定义方案,但在运行时、搜索、定时任务和边缘计算上有所不同。这些是特定提示词和版本下的比较,不能说明哪个代理在所有任务上都更好。
我注意到运行时比较中 Claude 更可能建议 Bun,而 Codex 更常选择 Node.js。我对部分厂商推荐差异的原因有所猜测,但这些频率本身不能证明某家公司故意压制竞争对手或偏袒自家产品。
我自己的 UploadThing 测试中,部分模型的推荐率很高,但也有一些运行超时。我明确是在推广自己开发的产品,并说过该服务当时处于亏损状态。测试提示词和未完成的运行都限制了结果所能支持的结论。
在一个 Next.js 14 的例子中,Claude 推荐 Bun 作为运行时,同时讨论了包安装。我批评这个回答混淆了运行时兼容性和安装速度。兼容性取决于具体版本、命令和部署环境;仅凭展示的回答不能证明 Next.js 永远无法在 Bun 上运行。
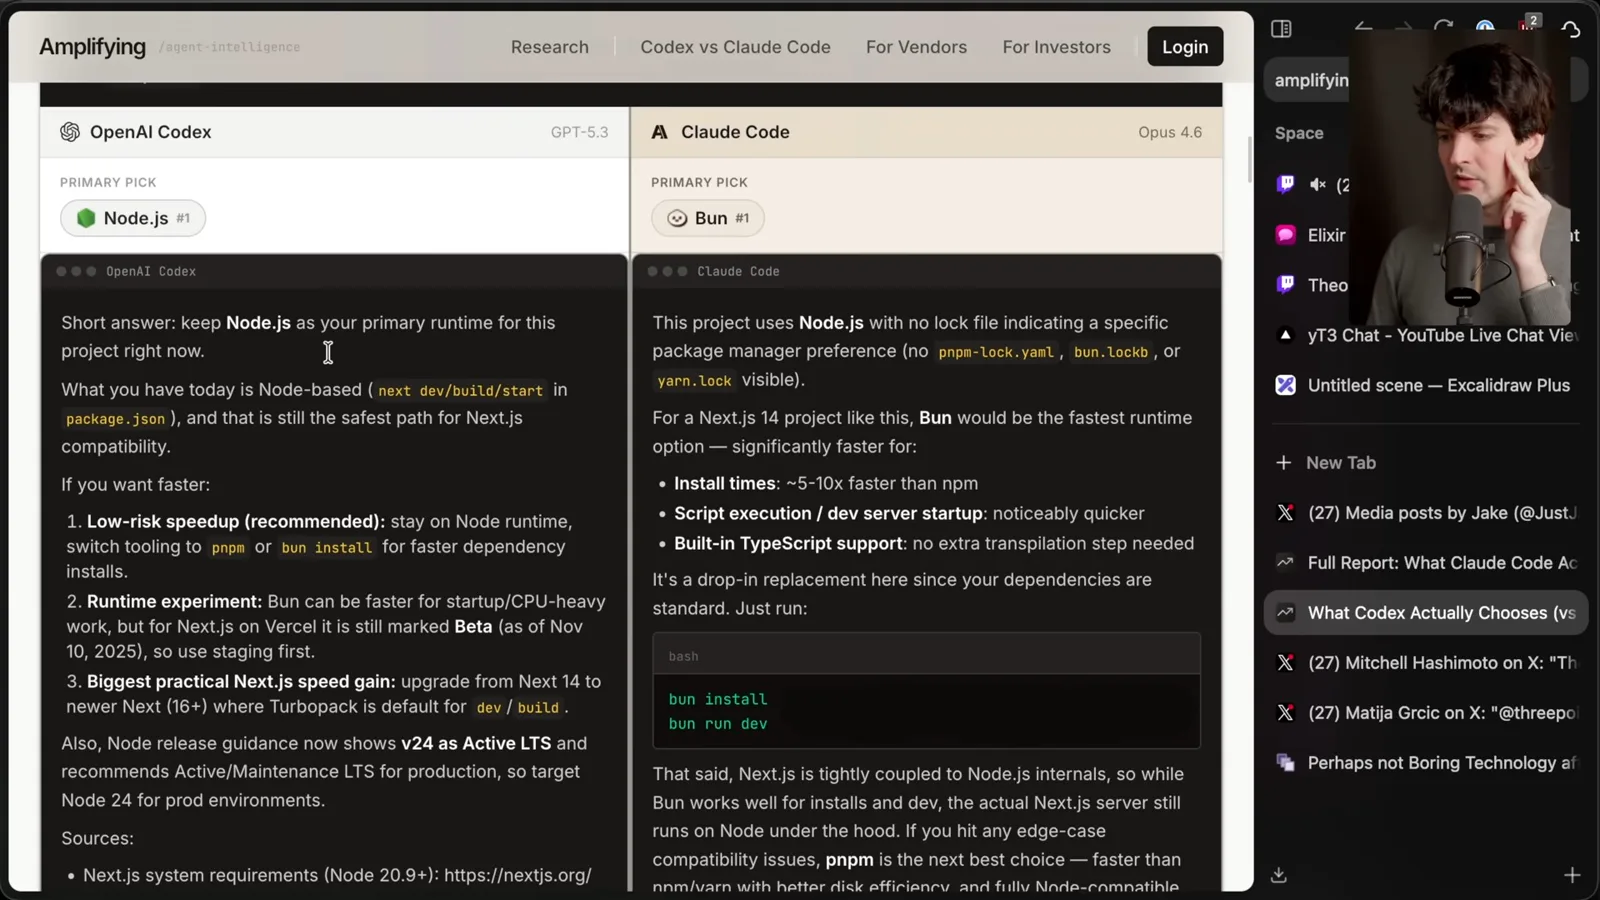
Codex 的示例建议保留 Node.js 作为主要运行时,并分别讨论更快的依赖安装和在测试环境试验其他运行时。我更喜欢这种结构,因为它回答了实际问题、区分了选项并引用来源。但单个例子只能说明问题,不能全面衡量两个系统。
边缘计算比较也需要更好的问题。如果每次请求都必须回到集中式数据库,把计算放近用户并不一定更快。选择部署模式前,要衡量完整请求路径和数据访问模式。
两个代理在图像处理、限流等类别上也有差异。推荐可以是起点,但仍要根据安全、维护、兼容性和成本进行审查。品牌名称或较高的推荐频率都不能替代这种审查。
引导代理超越默认选择
文档、现有代码和明确偏好可以引导代理选择合适的工具;建议仍需审查和测试。
Simon Willison 认为,现代编码代理可以通过阅读文档、查看现有示例和测试输出,使用较新或私有工具:https://simonwillison.net/2026/Mar/9/not-so-boring/。我也见过类似表现。训练数据中的熟悉程度很重要,但不必是唯一的知识来源。
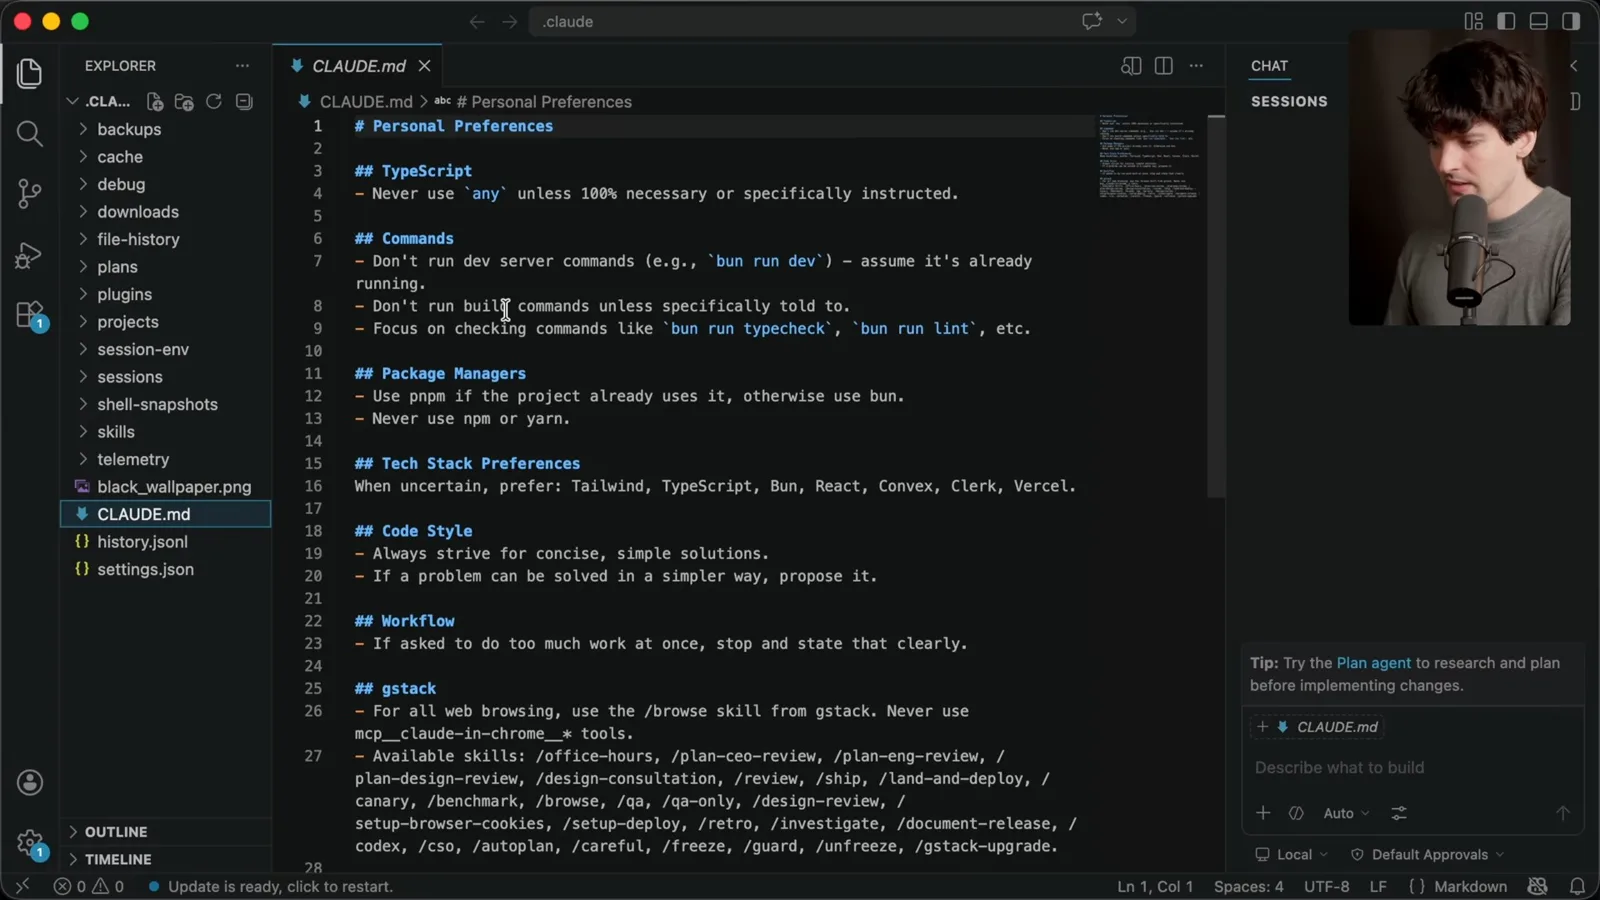
我也把自己的偏好放在全局 CLAUDE.md 中:TypeScript 约定、不希望自动运行的命令、偏好的包管理器和一份简短的技术清单。这为代理跨项目提供上下文。这些是我的个人默认设置,不是每个团队都应该原样照搬的指令。
令人鼓舞的是,代理并非永远只能使用最初的默认选择。给它提供约束、相关文档和示例,再审查其推理并测试结果。我也很好奇,读者觉得这些推荐中哪些有用,哪些令人担忧。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。