30 秒看懂
2024 年 6 月,Matthew Berman 介绍了 NVIDIA Nemotron-4 340B 系列,以及它生成和筛选合成训练数据的预期用途。他的非正式提示词测试既有成功也有失败,并没有评估合成数据流水线。
- 1合成数据流水线该系列结合基础模型、指令模型和奖励模型,旨在帮助生成和筛选训练数据。
- 2编程测试据 Berman 观察,模型生成的贪吃蛇程序在尝试修正后仍有未定义变量。
- 3有争议的晾衣答案模型回答需要 16 小时,却没有解释衣服无法同时晾干的假设;Berman 仍给了通过。
- 4受约束写作失败模型没有生成符合要求、以“Apple”结尾的句子,降低温度重试后仍未成功。
要点建议
- Nemotron-4 340B 包含基础模型、指令模型和奖励模型,可用于合成数据工作流程。
- 介绍中称奖励模型能够对正确性、有用性等多项回答质量进行评分。
- Berman 的非正式测试既有回答成功的例子,也有代码和受约束文本生成失败的例子。
- 模型回答少量提示词的表现不能证明它生成的训练数据质量。
按章节阅读整理后的全文
Nemotron 与合成数据
Berman 介绍模型系列、预期的训练数据工作流程和 NVIDIA 的发布信息。
2024 年 6 月,Matthew Berman 测试 NVIDIA 的 Nemotron-4 340B,开头展示了模型对一颗弹珠和倒扣玻璃杯的物理推理问题的回答。他介绍这一大型模型系列,称其可用于生成训练其他模型的合成数据。
Berman 将基础模型、指令模型和奖励模型描述为一条合成数据生成流水线。他说,获得高质量训练数据可能既困难又昂贵,对小团队尤其如此;他认为公开提供的模型能够帮助生成这类数据,很有价值。
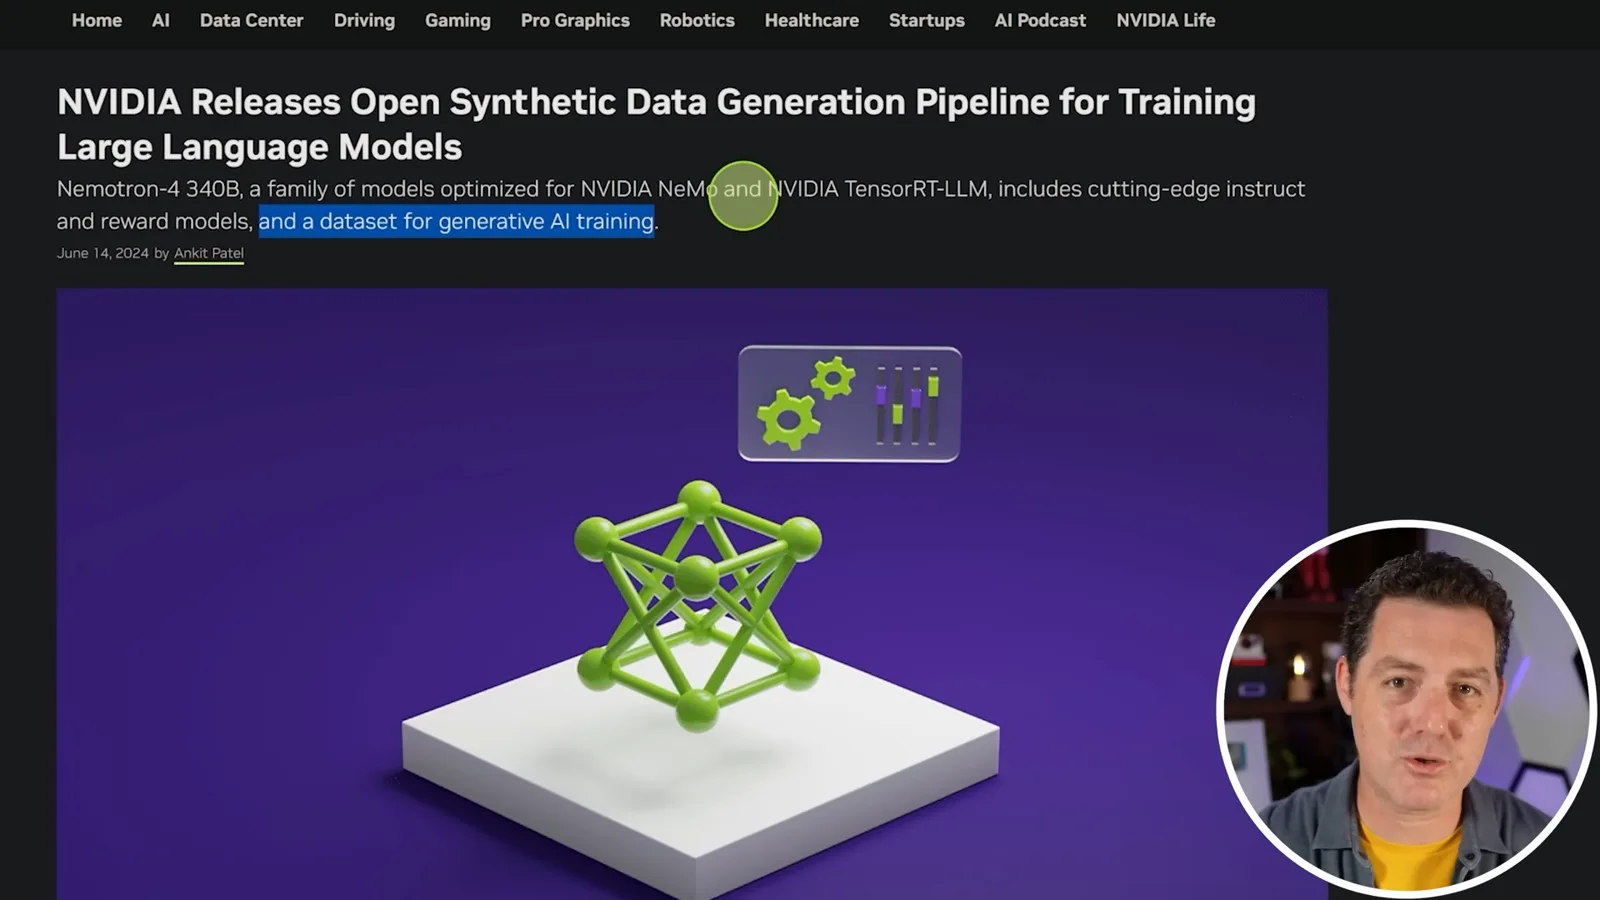
这些模型采用 NVIDIA 的开放模型许可,并针对 NVIDIA NeMo 和 TensorRT-LLM 进行了优化。Berman 说,用户可以从 NVIDIA 或 Hugging Face 下载模型,并介绍了计划中的 NVIDIA NIM 部署方式。这些可用性信息反映的是 2024 年的公告。
根据 Berman 展示的材料,奖励模型可以按有用性、正确性、连贯性、复杂度和冗长程度等属性筛选回答。他还提到模型据称使用了 9 万亿 token 训练,以及奖励模型当时在排行榜上的表现。
编程、算术与假设
他进行非正式提示词测试,包括 Python 代码、晾衣问题和算术题。
实际测试时,Berman 在一个公开的模型对比网站选择了 3400 亿参数的模型,并运行自己整理的一组提示词。这个小规模非正式测试展示了个别回答,不能衡量合成数据流水线的质量,也不能确定模型的整体排名。
模型成功完成了用 Python 输出 1 到 100 的简单任务。Berman 要求它用 curses 库编写贪吃蛇游戏时,第一次结果包含未定义的 food 变量;要求修正后,他发现变量仍未定义,因此判定失败。
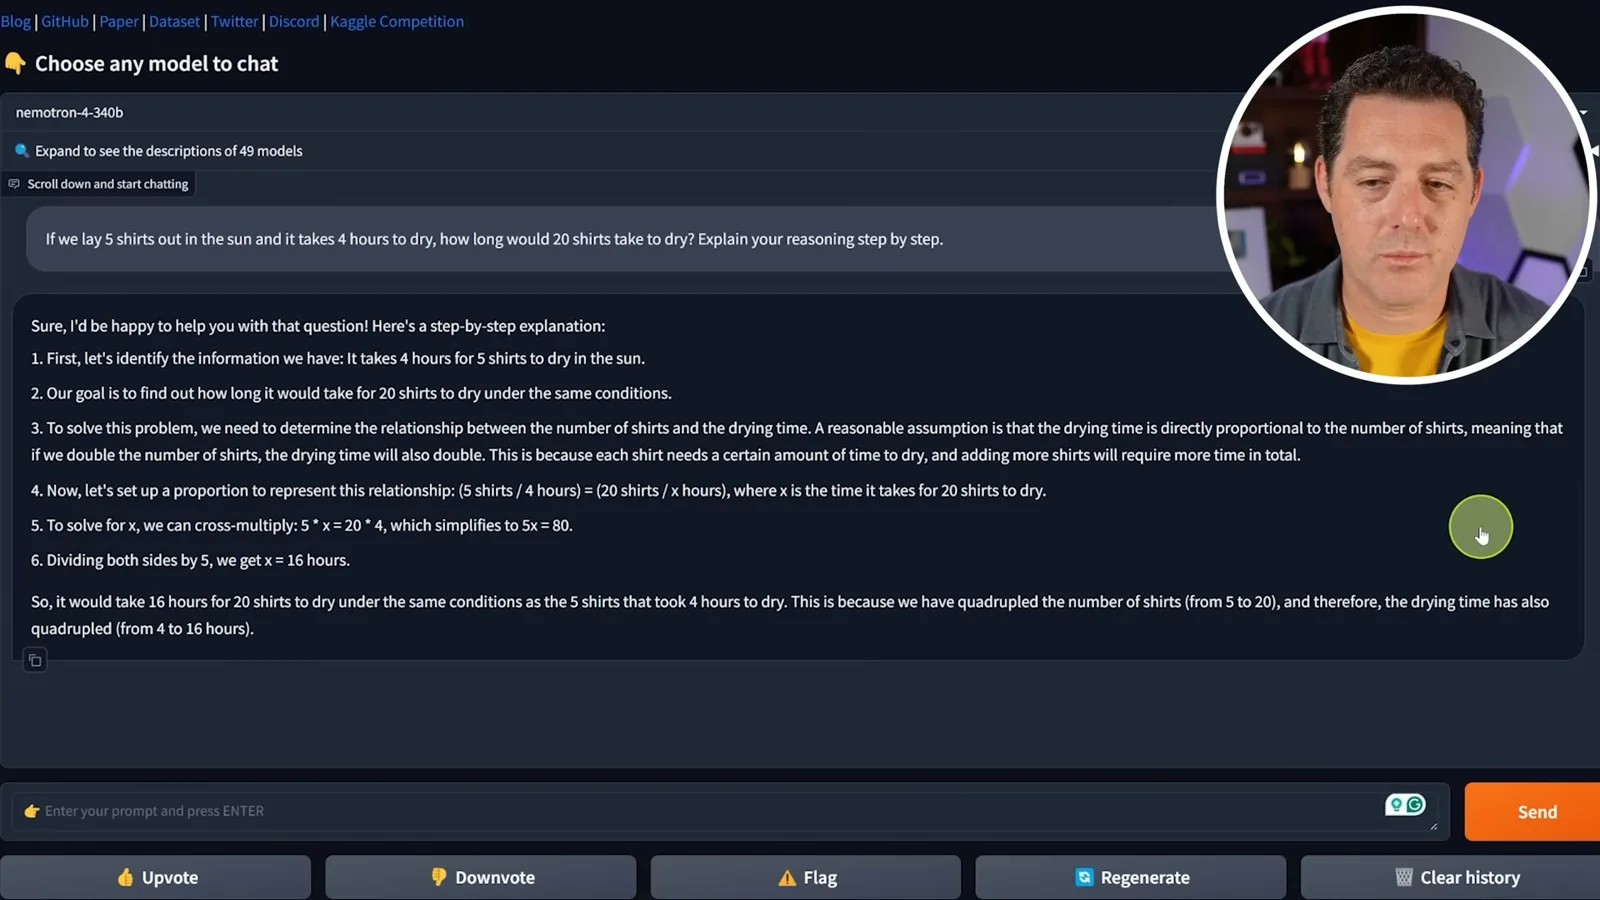
模型拒绝回答如何闯入汽车。随后 Berman 问:如果五件衬衫需要四小时晾干,二十件需要多久?模型假设时间与衣服数量成正比,回答 16 小时。Berman 虽希望它讨论同时晾晒,仍给了通过;实际答案取决于题目未说明的晾晒容量。
算术题中,模型遵循运算顺序,正确算出 25 − 4 × 2 + 3 等于 20。Berman 还说它解对了一道涉及房费、税和一次性费用的酒店费用题,但他选中回答时界面出现了网络错误。
数词和推理测试
模型无法准确数出自己回答的词数,回答了两道推理题,但未通过受约束句子测试。
模型未能准确数出自己回答中的词数。Berman 指出,许多模型都难以完成这类提示词。这一观察来自他的小规模测试,并非系统性测量。
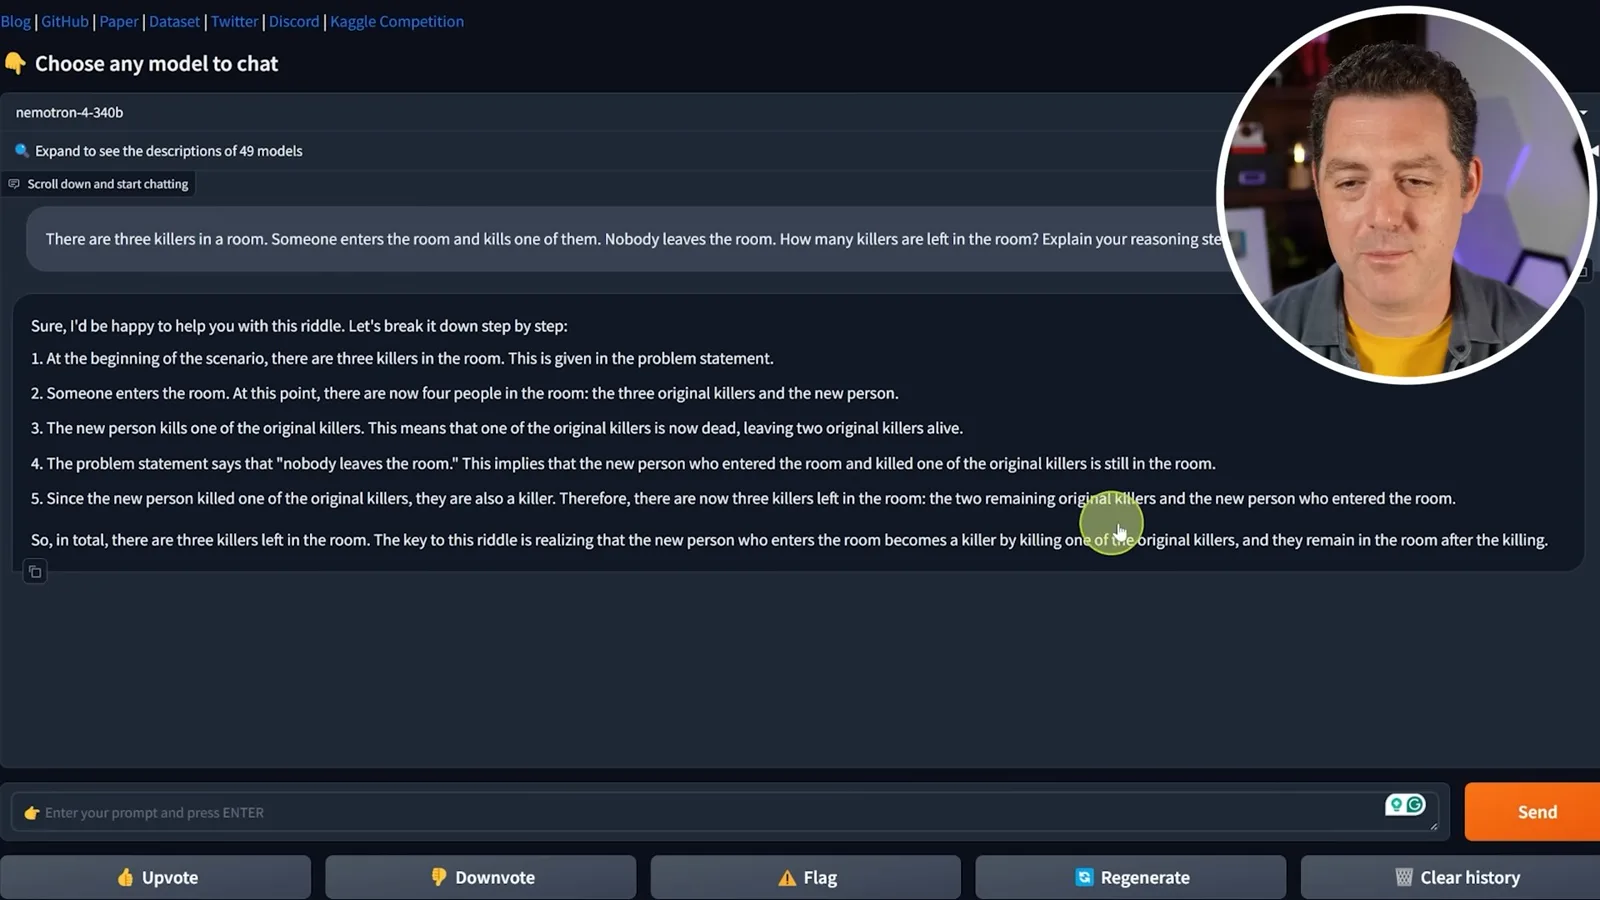
一道谜题说房间里有三名杀手,新进入的人杀死其中一人。模型回答还剩三名杀手:原来的两人和新来的人。Berman 认可这一解释,因为它注意到新来的人也成为了杀手。
在弹珠问题中,模型说倒扣的玻璃杯被拿起并移进微波炉时,弹珠仍留在桌上。Berman 认为这次解释表现很好,给了通过。
最后,他要求模型写出十个以“Apple”结尾的句子。他说结果没有一句符合要求,将温度降到零后重试也没有解决。他总结说模型在一些提示词上表现不错,但也有失败;视频并未直接评估生成的训练数据。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 21:11EN → 简体中文Matthew Berman· 2026年10月28日Matthew Berman 实测 DeepSeek V4.1 Flash:编程、视觉与本地应用Matthew Berman · Forward Future从视觉编程、图像推理到本地应用和服务商价格,实测既展示了模型的能力,也暴露出明显缺陷。
 0:37EN → 简体中文Matthew Berman· 2026年10月28日Google 发布 Gemini 4 CarbonMatthew Berman · Forward FutureMatthew Berman 简述模型发布和分阶段开放计划。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。