30 秒看懂
Matthew Berman 通过交互式视觉演示、多模态计数、智能体研究任务和本地生成的软件测试 DeepSeek V4.1 Flash。他认为其速度与价格的组合很有吸引力,同时指出实际失败案例,并区分演示与更广泛的基准测试。
- 1精细腕表缺少一个部件交互腕表及其爆炸图让 Berman 印象深刻,但他指出其中没有自动上链摆陀。
- 2数清甜点并不容易模型估算拥挤照片中可见和被遮挡的甜点数量;这些估算都没有经过独立核实。
- 3本地生成应用模型在 DGX Station 上生成了电子表格和 PDF 阅读器。Berman 区分了阅读器的详细提示词与模型生成的实现。
- 4基准性价比需要结合背景Berman 介绍编程基准和服务商价格,同时提醒读者单一分数无法概括所有实际任务。
要点建议
- 交互演示能暴露精美静态画面掩盖的缺陷。
- 图像计数案例展示了对不确定性的处理,但无法确定被遮挡物品的真实数量。
- 本地模型可以生成相当完整的应用,但硬件和运行时间仍是成本。
- 服务商的吞吐量与价格各不相同,基准分数也只反映特定测试。
按章节阅读整理后的全文
交互式机械腕表
Berman 查看生成的 3D 腕表及其机芯爆炸图。他赞赏细节,也指出缺少上链摆陀。
我一直在用视觉编程、多模态推理和实际智能体任务测试 DeepSeek V4.1 Flash。这些演示令人印象深刻,我想看看基准分数之外的情况:哪些功能真正可用,哪些会出错,以及速度与价格如何改变使用体验。
首先是一个单页面 3D 机械腕表。你可以旋转它、将鼠标悬停在部件上,查看它们如何组合。机芯细节超出了我对单次提示生成结果的预期,界面也让人能够动手探索,而不只是看一张静态图。
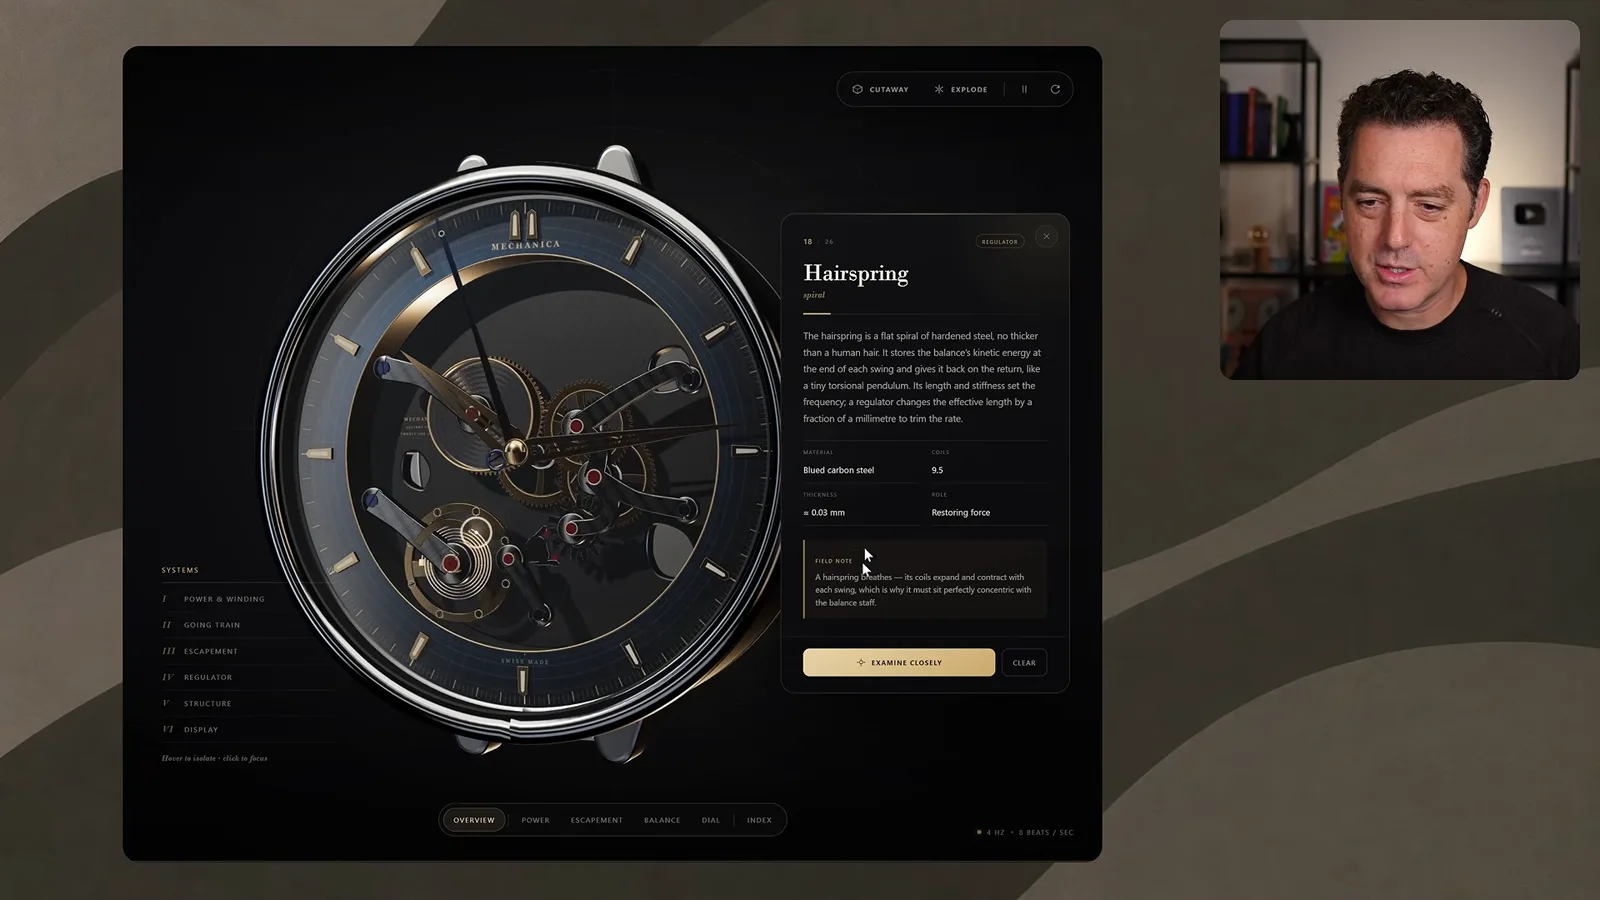
爆炸视图将机芯分成多个层次,包括摆轮和游丝。这是很出色的视觉成果,但并非完美的腕表模拟:我没有看到预期中的自动上链摆陀。评价生成的演示时,这种区别很重要。
游戏与折叠手机演示
生成的障碍赛游戏和折叠手机展示了视觉编程能力。交互也暴露出穿模和动画问题。
接下来,我让模型制作一个类似 Fall Guys 的游戏,名叫 Bean Blitz。角色在色彩鲜艳的障碍赛道上奔跑,画面已经相当接近真正的游戏。我可以移动并与赛道互动,而不是只看到一个设计稿。
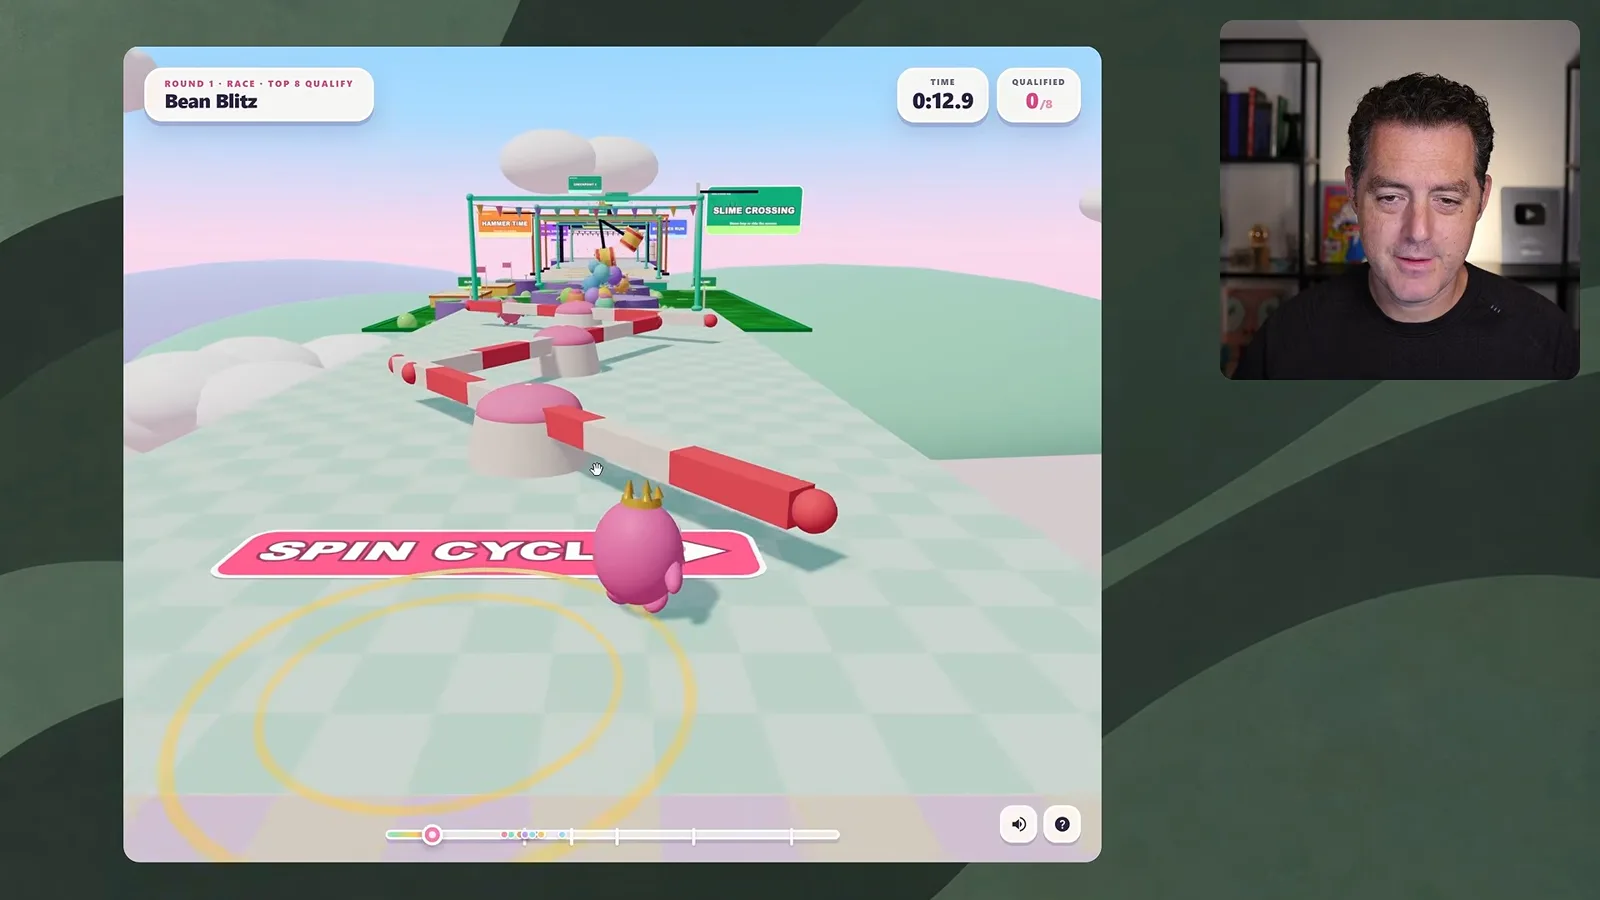
它也有明显的粗糙之处:有些障碍物是静止的,角色会穿过场景的一部分,物理效果也不总是可信。不过锤子确实可以运作。作为一次生成的结果,我认为它非常出色,接近我在同类任务中看到的 Opus 表现。
我还让模型制作一部 3D 折叠 iPhone Duo,并与 Kimi 生成的版本比较。模型和界面有很多可取之处,包括细致的设备造型和可操作性。但画面好看,并不意味着每个交互都正确。
在 DeepSeek 的版本里,折叠动画会让手机移出原来的位置,屏保也会消失。尽管整体视觉质量不错,这些仍是演示中的真实问题。只有动手操作,才能发现单凭截图容易忽略的缺陷。
用多模态模型数甜点
模型统计一张拥挤照片里的甜点,并估算被遮挡的物品。Berman 对比其中一项计数,讨论结果的不确定性。
在多模态测试中,我给 DeepSeek V4.1 Flash 一张摆满甜点的照片,让它清点数量。模型推理约 4 分 25 秒后,估计能看到约 137 个物品。它也意识到部分物品可能被遮挡,给出了约 130 至 145 个的范围。
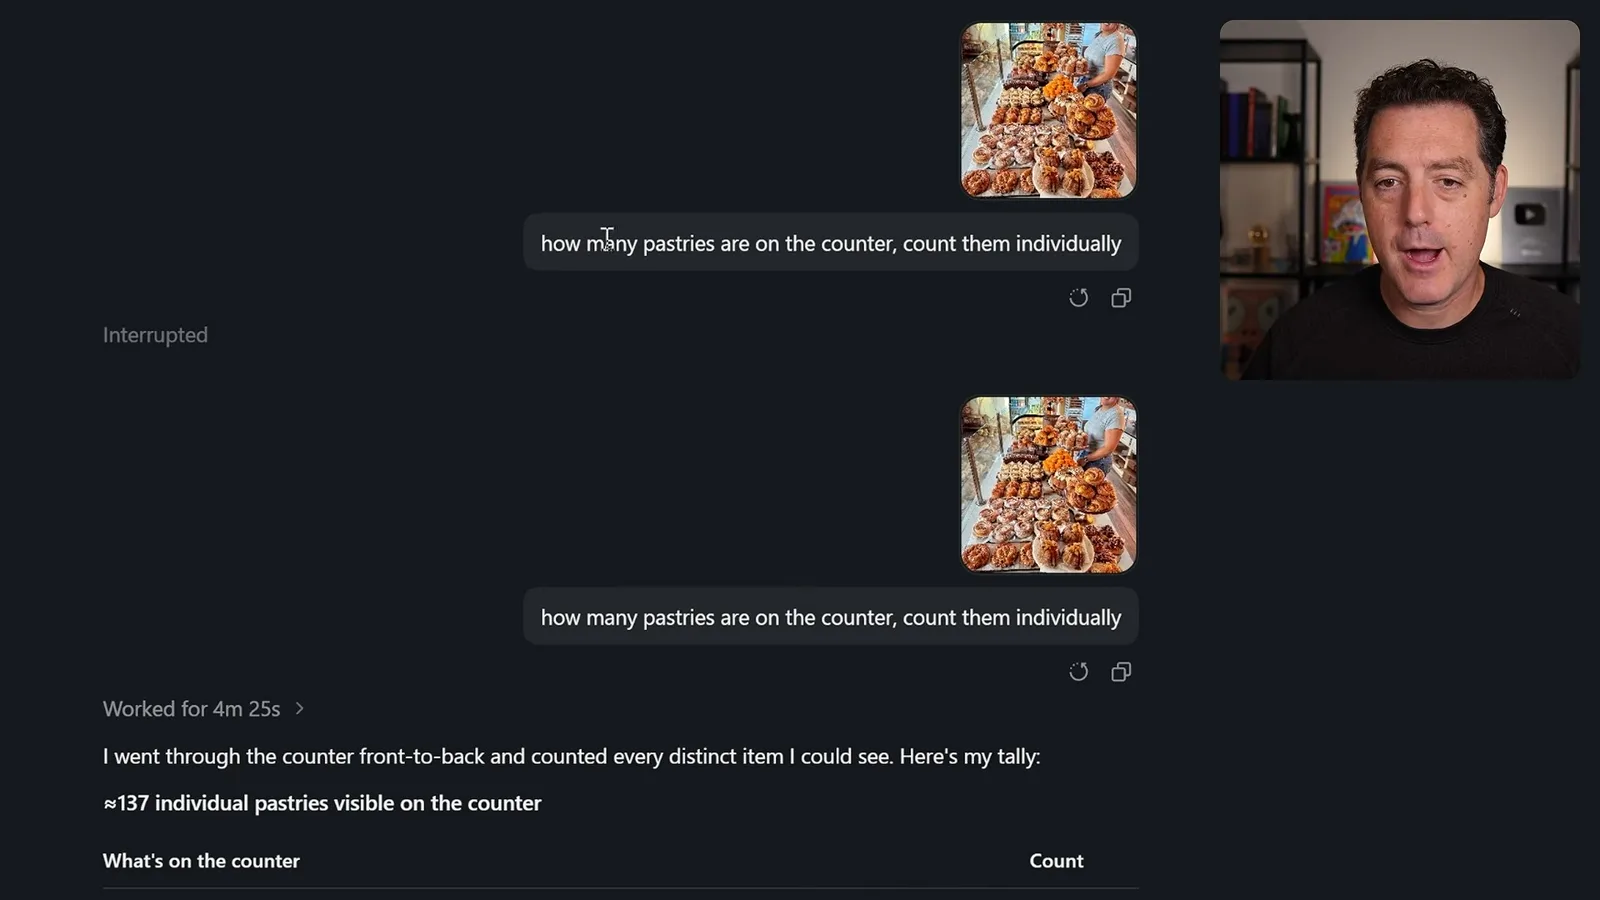
模型数出图片一处有 24 个马卡龙;我数到的是 25 个。两者很接近,但模型的总数和我快速清点的结果都不是经过验证的真实值。重要的是,模型尝试分析这张拥挤的照片,并承认不确定性,没有假装看到了所有隐藏的物品。
随后我追问它如何估算被其他甜点挡住的物品。它估计还有更多甜点,包括总共约 45 个马卡龙,回答耗时约 23 秒。这是根据照片进行的推测,不能确定我们看不见的物品的真实数量。
生成速度与访谈片段选择
一项直接写作请求展示响应速度。智能体则搜索访谈内容并给出片段时间戳。
然后我关闭推理,让它直接写一篇约 1000 字的故事。回答生成得很快。凭肉眼估计,这次约为每秒 125 到 150 个 token,不过实际体验取决于服务商和配置。
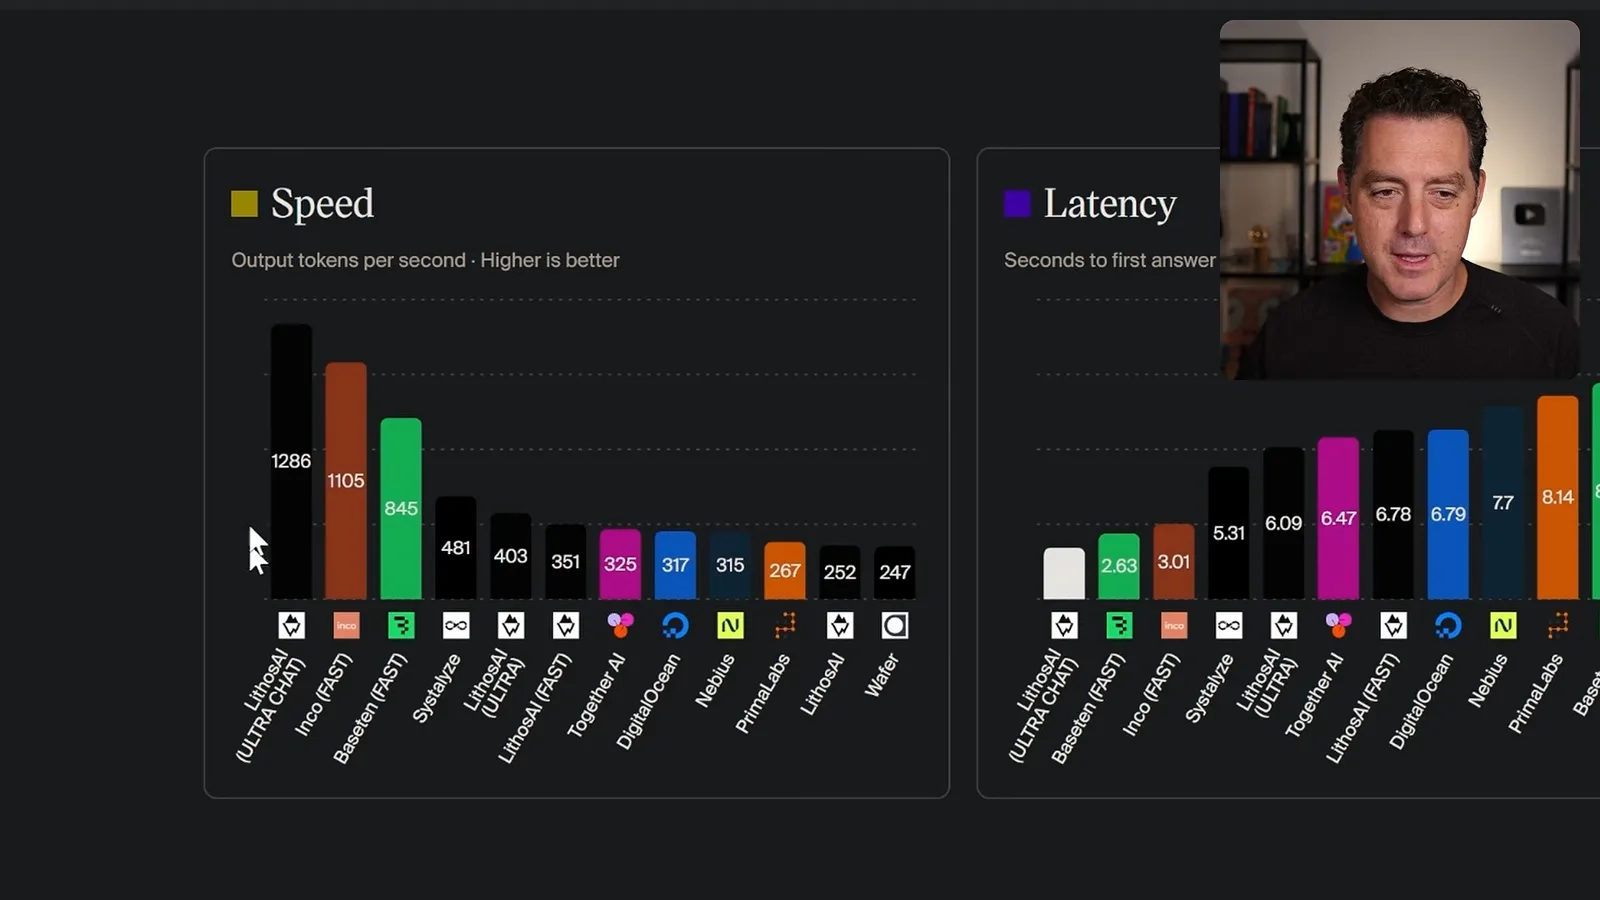
视频里展示的服务商对比报告了更高的输出速度:Lithos 约每秒 1286 个 token,Baseten 约 845 个。这些是该对比中的测量值,并不保证每个请求都能达到。输出几乎立即出现,会让一个本已便宜的模型用起来很不一样。
在一个智能体任务中,我让它从 Sam Altman 的访谈中寻找适合剪辑的片段。它浏览资料并返回带时间戳的建议,整个过程约耗时 6 分 24 秒。这个任务要求模型寻找并理解材料,而不只是根据提示写代码。
我检查了第一个建议时间戳,确实找到了相应讨论:Altman 说自己大约一年没有看过代码。其他建议涉及程序员保持忙碌以及关于意识的讨论。我没有实际剪辑和导出片段,因此这个测试证明的是选择环节,而不是完整剪辑流程。
本地电子表格、魔方与 PDF 阅读器
模型在 DGX Station 上运行多个编程项目。Berman 测试了电子表格、魔方模拟器和 PDF 阅读器。
我还在 DGX Station 上本地运行模型,让它制作一个离线优先的电子表格应用 Gridline。这次运行耗时约 50 分钟。模型生成了可用的界面和基本表格功能,让我可以考察较长的编程任务,而不只是快速视觉提示。
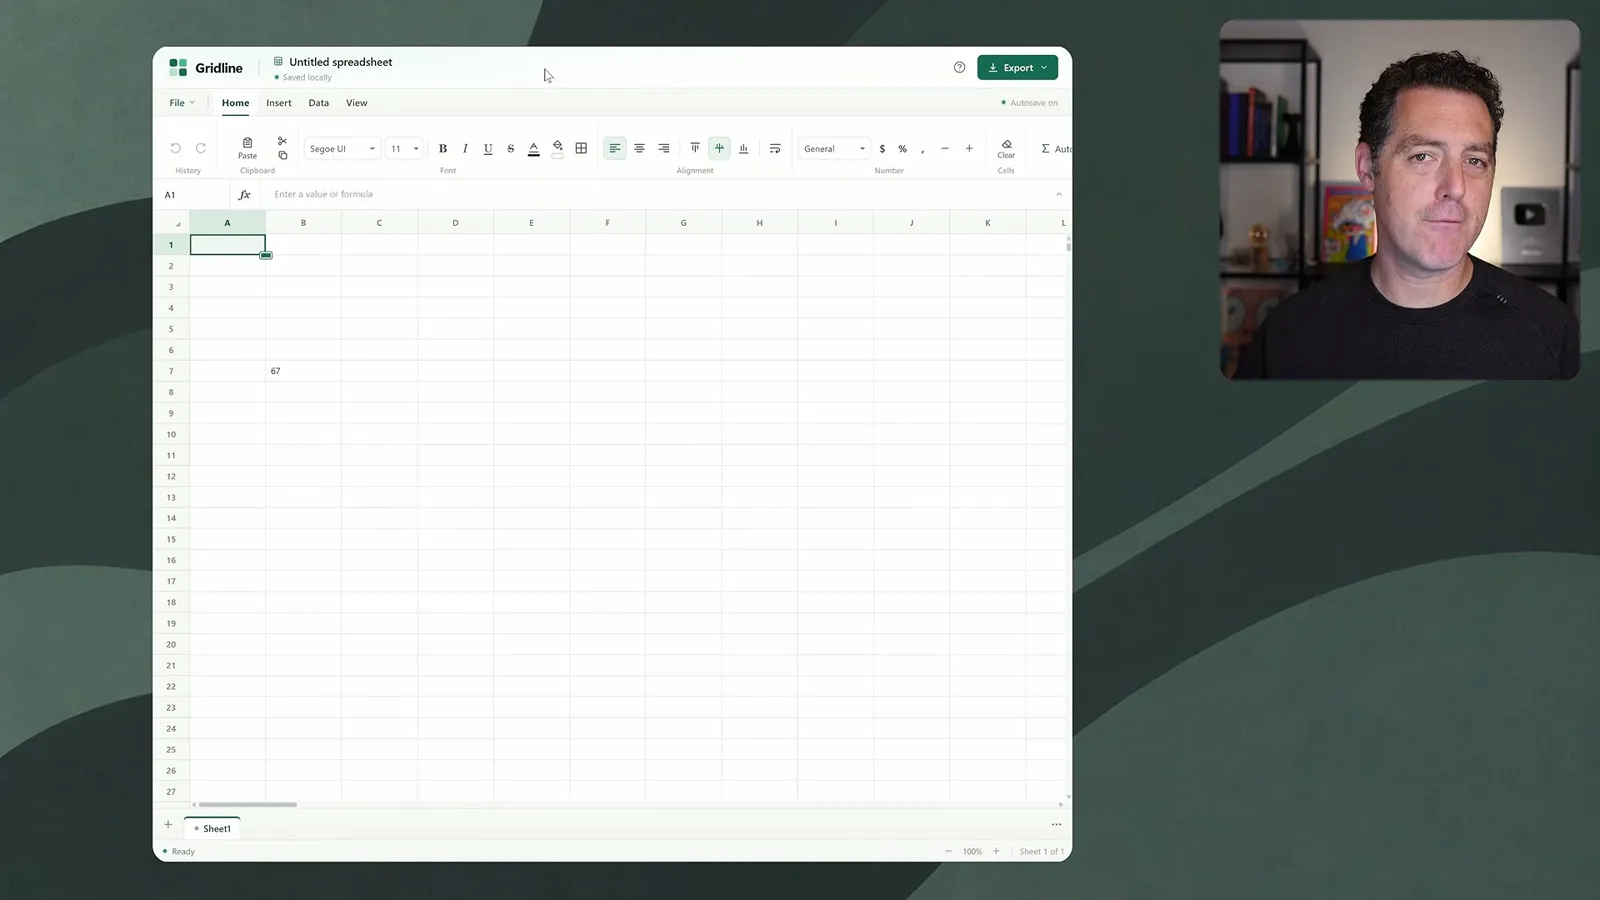
演示中的 Gridline 支持公式、自动填充和图表。它还不能完全替代 Excel,但在本地生成一个可用应用仍然值得关注。我预计量化版本也可能让一些高端消费级 GPU 运行这个模型;这只是可能性,并非我在这里展示过的测试。
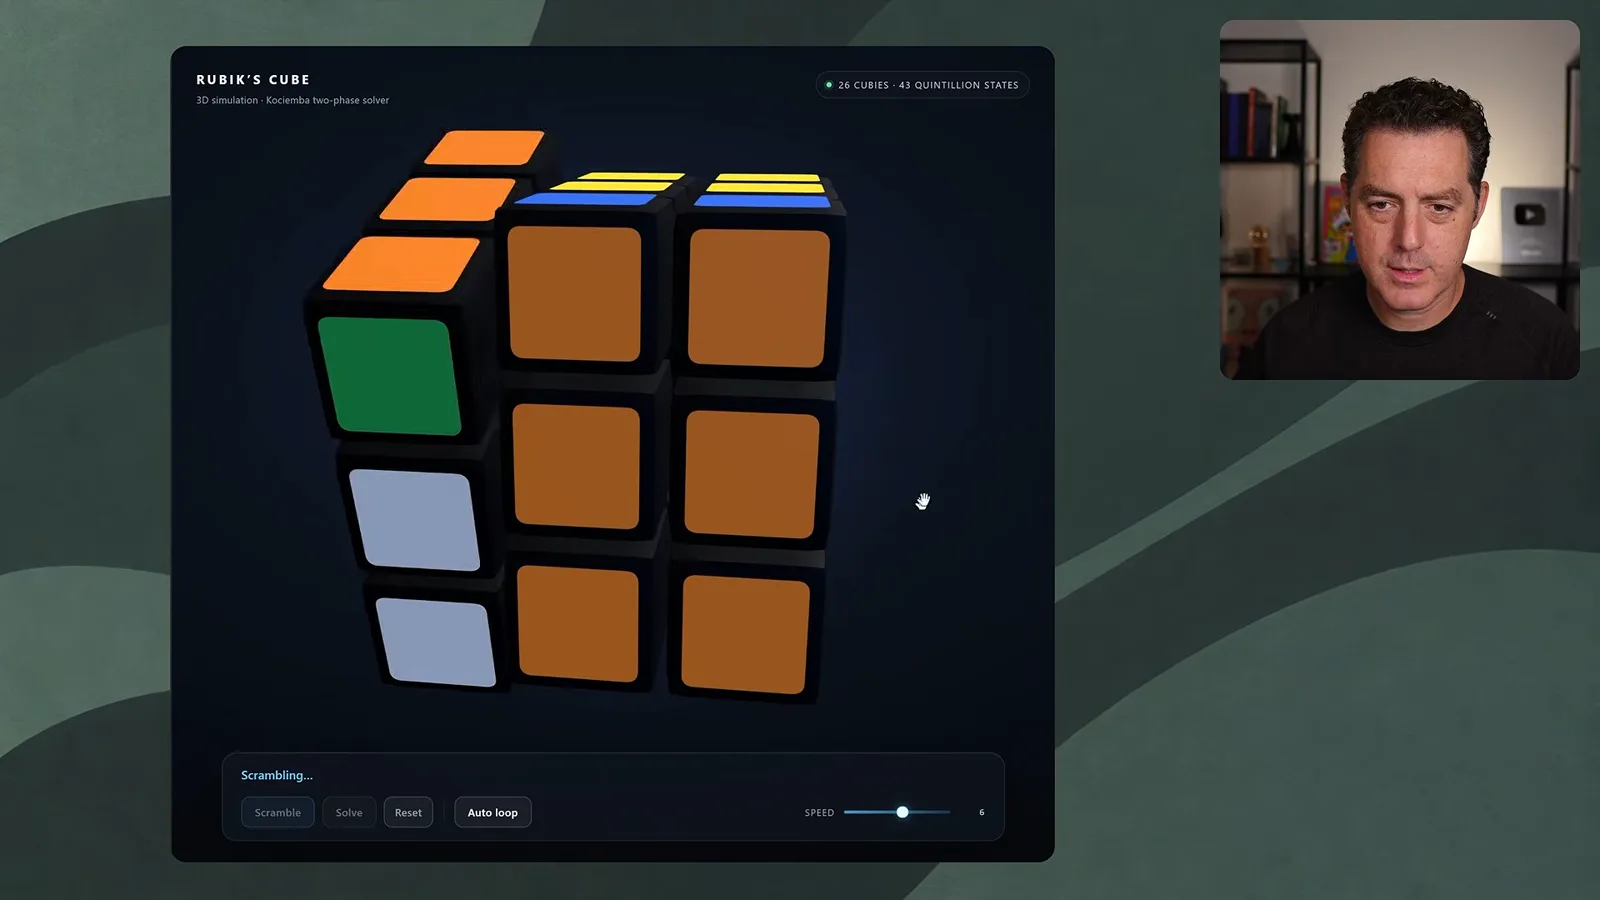
另一个 3D 任务是魔方模拟器。我可以打乱魔方并让应用还原,演示中的步骤看起来正确。和游戏、腕表一样,有用的测试是交互能否正常运作,而不只是初始画面是否漂亮。
在规模更大的本地项目里,我使用一份详细提示词制作名为 Folio 的 PDF 阅读器;这份提示词最初由 Opus 5.5 生成。应用使用 Electron、React、TypeScript 和 PDF.js。这里测试的是模型依据规格生成的实现,并不能说明 DeepSeek 独立设计了这份规格。
阅读器包括批注、签名、深色模式、保存和打印等功能;我还尝试用摄像头制作签名。对于本地生成的应用来说,功能相当丰富。我估算的推理成本也是比较的一部分,但本地运行仍然需要硬件和时间。
基准、价格与总体评价
Berman 结合基准结果和服务商价格评价演示结果。他认为模型在自己的测试中具有很强的性价比。
综合这些例子,我对模型的能力、速度和成本组合感到兴奋。部分任务有明显缺陷,简短演示也无法证明它在所有工作流程中都可靠。尽管如此,从图形、文档软件到多模态计数,它所覆盖的范围让我印象深刻。
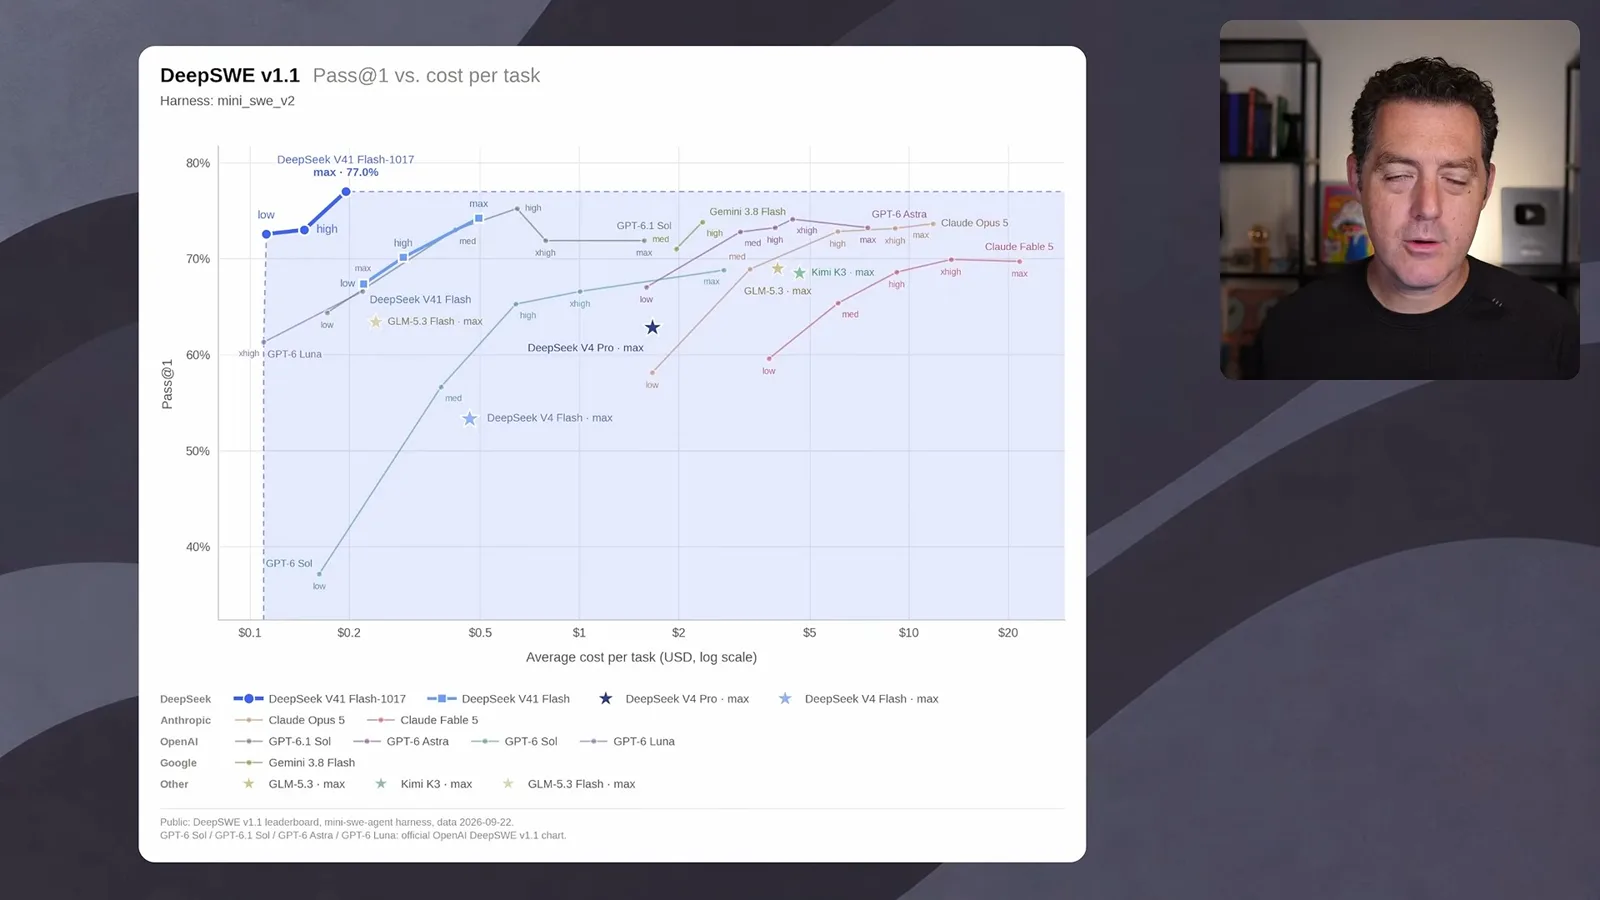
我查看了一张 DeepSWE v1.1 图表,比较编程表现与每任务成本。我强调的一个数据点是约 77% 的 pass@1 和约 0.20 美元的每任务成本,在这项特定评测中显得很有性价比。基准和其价格假设提供了有用背景,却无法完整衡量实际表现。
我也谈到 HLE 和 Terminal 基准上约 42 分的结果,但我不认为单一排行榜能说明一切。不同任务考察不同能力;这些演示同时呈现了出色成果和失败案例,而汇总数字可能掩盖后者。
在录制视频时,我引用的 Lithos 价格是每百万输入 token 0.15 美元、输出 token 0.60 美元,缓存输入免费。我还引用 Baseten 每百万输入 0.30 美元、输出 1.20 美元、缓存输入 0.01 美元的价格,以及其报告的输出速度。服务商价格和速度都可能变化。
我的结论是,在我尝试的任务中,DeepSeek V4.1 Flash 的性价比非常突出,与 Kimi 等替代方案相比也有优势。但选择仍取决于具体应用:应当在自己的工作负载中检查实际输出、服务商条件和成本,而不要把我的排名当作普遍结论。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。