30 秒看懂
在这段 2023 年 10 月的视频中,Matthew Berman 在租用的 Linux GPU 上演示视觉语言模型 LLaVA。他介绍控制器、模型工作进程和 Gradio 界面,然后尝试图片问答,并指出模型重复输出的问题。设置细节和云服务价格均来自录制时。
- 1为什么使用云端 GPUBerman 在自己的电脑上遇到 Linux 和 CUDA 依赖问题,因此租用 Linux 机器演示。
- 2配置实例他选择 RTX A6000,将临时存储增加到 100 GB,并开放 3000 端口;视频所报的小时价格来自 2023 年。
- 3三个进程控制器、模型工作进程和 Gradio 界面分别运行;工作进程首次启动时会下载模型文件。
- 4细胞图测试模型开始解释细胞插图上的标签,但随后重复列表,这是 Berman 观察到的局限。
要点建议
- 演示中的 LLaVA 由控制器、模型工作进程和 Gradio 网页界面共同运行。
- 模型下载需要较大存储空间,演示使用的 GPU 实例按小时收费。
- 视觉模型可以回答图片内容相关的问题,但也可能重复输出或犯错。
- 视频中的命令、硬件和价格只代表 2023 年演示时的情况。
按章节阅读整理后的全文
LLaVA 的用途
Berman 介绍视觉语言项目及其研究背景,并说明他遇到的机器要求。
Matthew Berman 介绍 LLaVA,这是一个可以回答图片相关问题的视觉语言模型。在这段 2023 年 10 月的演示中,他将其作为 ChatGPT Vision 的替代选择,并介绍自己如何在租用的 GPU 上安装。
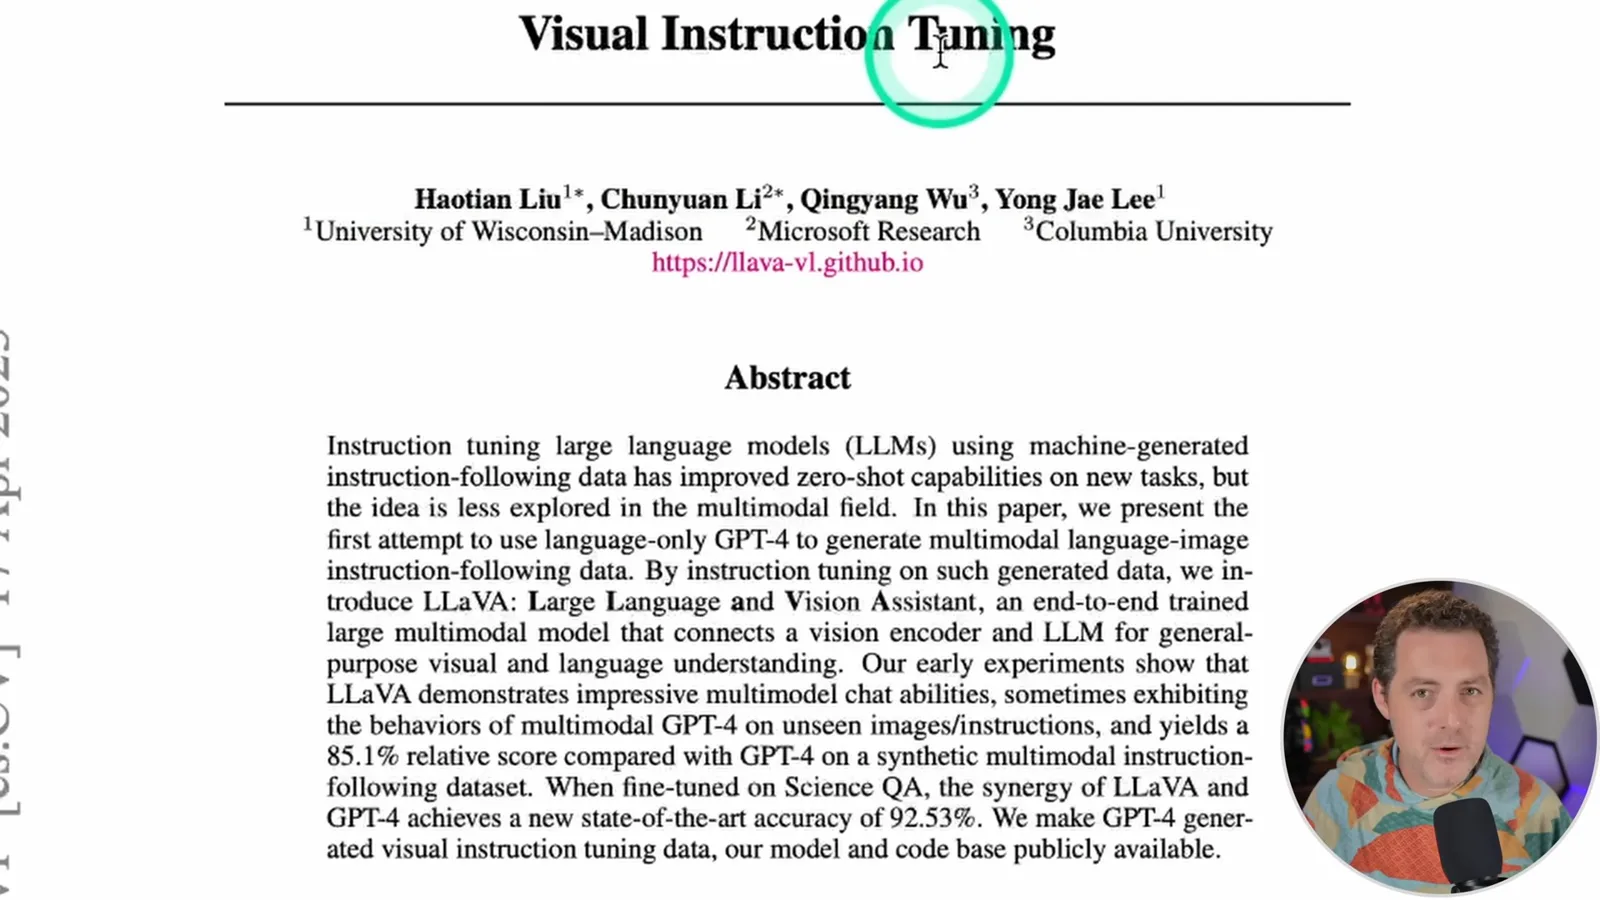
该项目建立在 Visual Instruction Tuning 论文和开源代码仓库的基础上。Berman 说,他演示的版本使用经过微调的 Llama 2 13B 模型。他展示一张细胞图,并说模型能够识别和解释其中标注的部分。
Berman 说,他在 Windows 上遇到依赖 Linux 的组件,在 Mac 上又遇到 CUDA 要求,因此选择 RunPod 的 Linux GPU 实例。他认为合适的 Linux 电脑可以在本地运行软件,Windows Subsystem for Linux 也可能可行,但他没有演示。
配置和安装
演示设置 RunPod GPU 实例、克隆代码仓库并安装依赖。
在 2023 年的录制中,他选择了标价每小时 0.79 美元的 RTX A6000 实例,并指出更小的 GPU 可能也够用。他把临时容器存储从 20 GB 增加到 100 GB,以容纳模型下载,并开放 3000 端口。项目代码免费,但云实例需要付费。
部署后,他打开网页终端,克隆 LLaVA 代码仓库并进入目录。他升级 pip、安装 PyTorch 和项目依赖。完整命令可以参考视频简介中链接的说明。
启动服务
Berman 启动控制器、模型工作进程和 Gradio 网页服务器,然后打开界面。
他在 10000 端口启动控制器,然后打开第二个终端启动模型工作进程。首次运行时工作进程会下载模型;他估计模型需要超过 20 GB 的存储空间。这两个进程都需要保持运行。
下载时,终端在进度信息旁反复显示错误级别的日志。Berman 说,他在这次演示中可以忽略那些特定信息,但这并不意味着所有错误都可以忽略。随后工作进程加载检查点分片并开始提供模型服务。
他在第三个终端中配置 Gradio 服务使用 3000 端口,并指定控制器地址来启动网页服务器。在 RunPod 中打开暴露的端口后,就能看到包含模型选择器和图片上传功能的 LLaVA 界面。
图片测试与局限
两个图片示例展示界面如何回答问题。细胞图的回答出现重复,Berman 还介绍了网页演示和模板。
第一个例子询问图片有什么不同寻常。模型描述一个站在行驶汽车后部熨衣服的人。Berman 把它作为图像理解能力的演示,而不是系统性评测。
他重申 RunPod 机器需要付费,而合适的本地 Linux 环境可以避免这笔租赁费用。他说,自己尝试时没有成功运行 Mac 分支或 Apple silicon 相关说明。
另一个测试中,Berman 上传一张带标签的细胞插图,要求模型解释其中的术语。模型开始描述细胞并定义各部分,尽管图片本身只有标签。他也发现了一个问题:回答进入循环,不断重复列表。
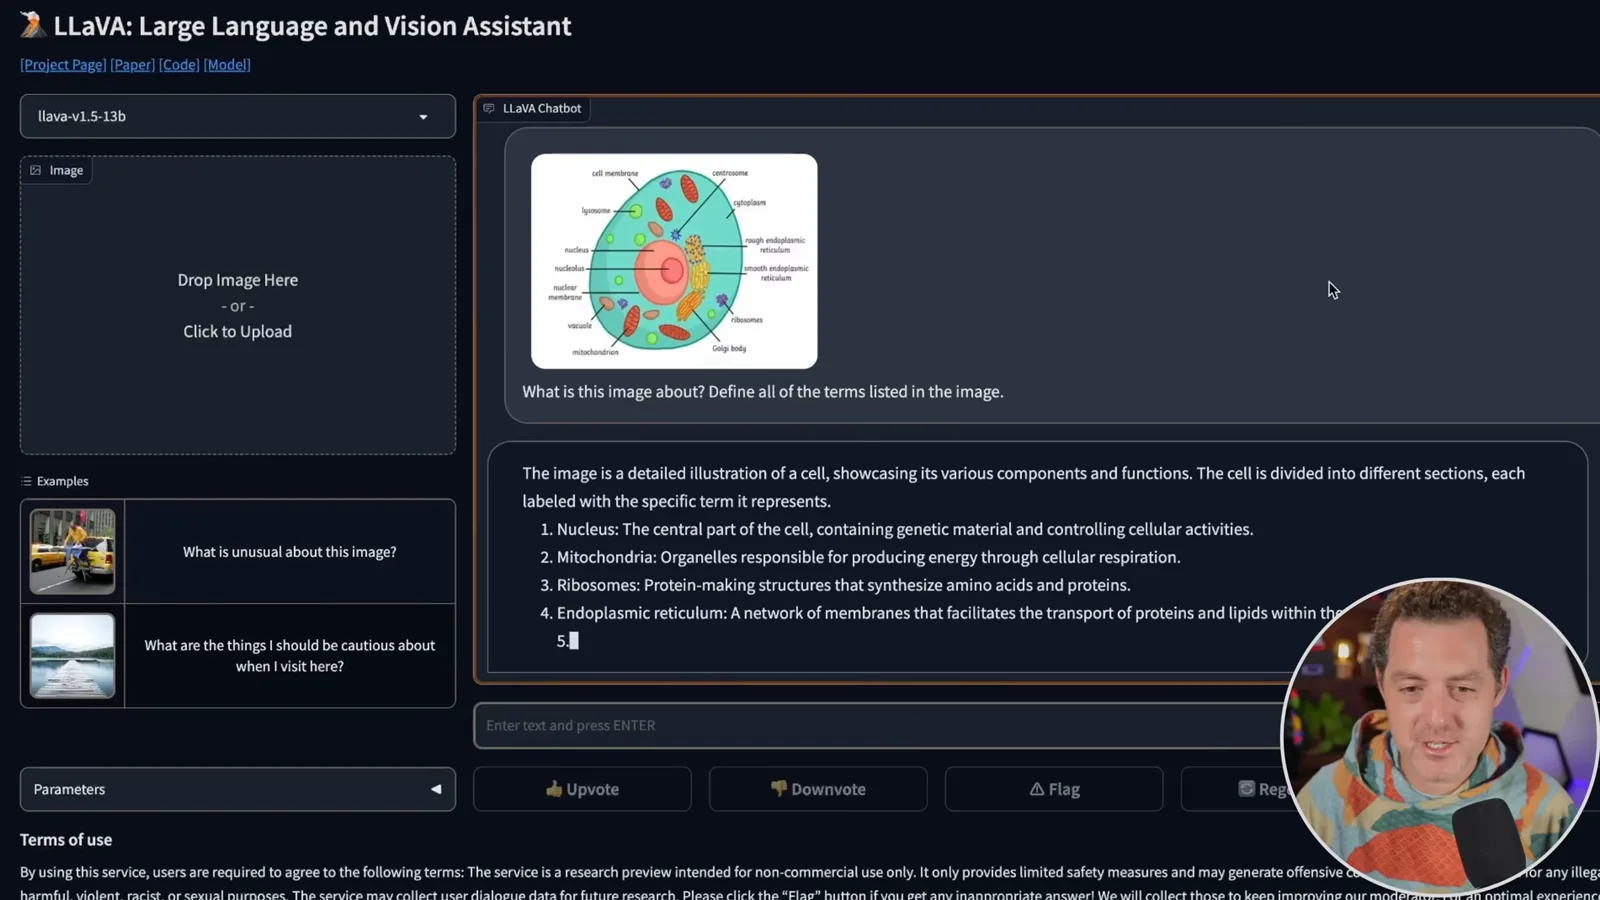
这段视频没有探索模型能力的全部边界。Berman 给不想安装的观众推荐了简介中链接的网页演示。录制结束后,一位贡献者还制作了 RunPod 一键模板,链接也放在简介里。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 21:11EN → 简体中文Matthew Berman· 2026年10月28日Matthew Berman 实测 DeepSeek V4.1 Flash:编程、视觉与本地应用Matthew Berman · Forward Future从视觉编程、图像推理到本地应用和服务商价格,实测既展示了模型的能力,也暴露出明显缺陷。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。