30 秒看懂
Matthew Berman 追踪 Sam Altman 的草莓照片引发的网络猜测,并在 Chatbot Arena 测试匿名模型。他比较了模型对小数大小、杀手谜题和杯中弹珠问题的回答。xAI 后来确认 sus-column-r 是早期版 Grok-2,但这一披露无法确定另一个 anonymous-chatbot 的身份。
- 1草莓照片引发猜测一张花园照片和 Arena 上的匿名模型引发了 OpenAI 即将发布新产品的预测。录制时这些说法尚未得到证实。
- 2理性看待数学进展AlphaProof 和 AlphaGeometry 2 解出 2024 年奥赛六道题中的四道,得到 42 分中的 28 分;这并不意味着普遍的数学推理问题已经解决。
- 3一个神秘模型后来揭晓Sus-column-r 正确比较了 9.11 和 9.9。8 月 13 日,xAI 确认它是早期版 Grok-2。
- 4测试杀手谜题展示出的 sus-column-r 和 GPT-4 答案按照通常的理解,都算出了三名活着的杀手。
- 5一道物理推理题在弹珠场景中,另一个 anonymous-chatbot 把弹珠放在微波炉里;有人分享的 sus-column-r 回答则把它留在桌上。
要点建议
- Altman 的草莓照片和网上的发布预测,并不能确定模型身份或上市日期。
- xAI 后来确认 sus-column-r 是早期版 Grok-2;这一信息本身无法说明另一个 anonymous-chatbot 的身份。
- 正确解答一道小数比较题或逻辑题,是有参考价值的个例,但不能代替完整评估。
- DeepMind 在 2024 年数学奥赛中取得的是一项特定的银牌水平成绩,并不代表普遍的数学推理问题已解决。
按章节阅读整理后的全文
Strawberry 猜测与匿名模型
Berman 回顾一条草莓帖子和网上关于 OpenAI 传闻中推理项目的说法。他区分 Arena 上两个身份不明的模型,并介绍有关规划和后训练的传闻。
今天是 2024 年 8 月 7 日,我想看看围绕 OpenAI 据称即将推出的下一代模型而不断升温的传闻。Sam Altman 发布了一张花园里的草莓照片,配文是“我喜欢花园里的夏天”。这一时机让关注传闻中的 Strawberry 或 Q* 项目的人兴奋不已,但一张照片并不是产品公告。
Chatbot Arena 上出现了两个匿名模型名称,让人想起此前的匿名模型测试。我起初找不到它们,因此查看了其他用户的报告和截图。其中一个叫 anonymous-chatbot,另一个名称不同;我们不能自动认定它们是同一个模型。
一位用户问 anonymous-chatbot 它是什么模型,它声称自己基于 GPT-4 架构。模型对自身的描述不能证明其身份。同一位用户表示,他的个人测试非常有限,没有发现明显的推理能力提升,数学方面也许有些改善。
一条社交媒体帖子汇总了有关 Q* 和 Strawberry 的说法,包括可能有新前沿模型,以及两个项目名称之间存在关联。这些都是报道和猜测,并非已经证实的发布细节。传闻中的改进方向是增强规划和推理能力,进而可能帮助解决数学和逻辑问题。
其他传闻中的能力包括浏览网页进行更深入的研究,以及完成一长串行动。Berman 还讨论了后训练,以及预训练后继续学习的可能性。这是不同的概念:后训练可以改变模型,但并不能证明已部署的系统会从每次交互中持续学习。
网上还流传着据称针对 anonymous-chatbot 的越狱示例。这个例子不能证明它由哪家公司开发。Bindu Reddy 提出了不同的竞争预测:其他实验室在推理和合成数据方面也取得了进展,因此她质疑 Strawberry 相比未来的竞争模型能有多大优势。
数学推理与小数比较测试
Berman 讨论竞争实验室以及一道小数比较题的答案。xAI 后来的披露揭晓了其中一个模型的身份。
我把 Google DeepMind 最近的数学奥赛成果视为进展的证据。但我说数学推理“几乎解决了”过于夸张:[DeepMind 报告](https://deepmind.google/blog/ai-solves-imo-problems-at-silver-medal-level/)称,AlphaProof 和 AlphaGeometry 2 解出了 2024 年国际数学奥林匹克竞赛六道题中的四道,在题目被转成形式化语言的条件下得到 42 分中的 28 分。这个银牌水平的成绩并不意味着普遍的数学推理问题已经解决。
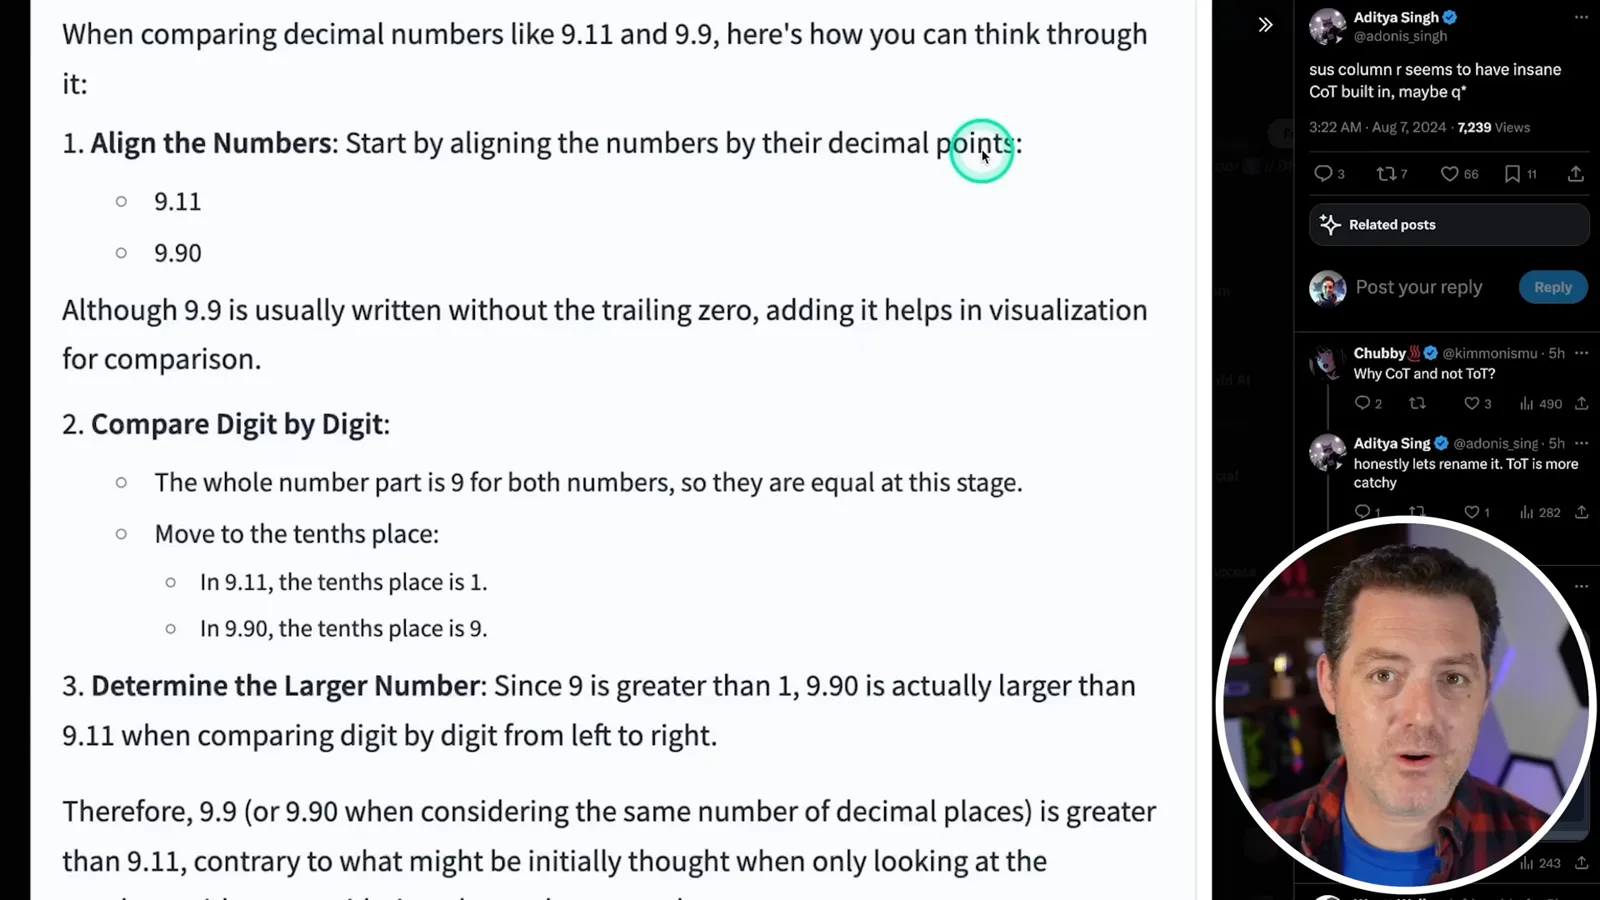
另一个模型名叫 sus-column-r。截图显示它回答 9.11 和 9.9 哪个更大:它把 9.9 写成 9.90,比较十分位数字,正确选择 9.9。一些用户猜测这段解释揭示了新的推理方法或 OpenAI 项目,但仅凭可见的解释无法确认这两种说法。
现在可以补充一个重要的历史更正:2024 年 8 月 13 日,[xAI 表示](https://x.ai/news/grok-2),sus-column-r 是其 Grok-2 模型的早期版本。这一确认并未揭晓另一个名为 anonymous-chatbot 的模型身份。OpenAI 后来于 [9 月 12 日推出 o1-preview](https://openai.com/index/introducing-openai-o1-preview/),但这一发布并不能证明某个匿名 Arena 模型的身份。
另一个社交媒体账号热情地预测 Strawberry 即将发布。我不知道账号由谁运营,也不知道它是否掌握内幕,因此应以此为前提看待它的说法。当时我认为 Llama 3.1 405B 等产品带来的竞争压力可能促使 OpenAI 发布公告。
Arena 测试:杀手与弹珠
Berman 解释盲测对战如何在投票后揭晓模型,然后查看两道谜题的回答。最后,他表示需要进行更全面的测试。
录完前半段后,Shaun Ralston 解释了为什么我无法直接找到这些模型。它们出现在 Arena 的盲测对战模式中:用户向两个匿名模型提交提示,投票后才能知道模型名称。因此,要碰到某个特定模型,需要反复尝试。
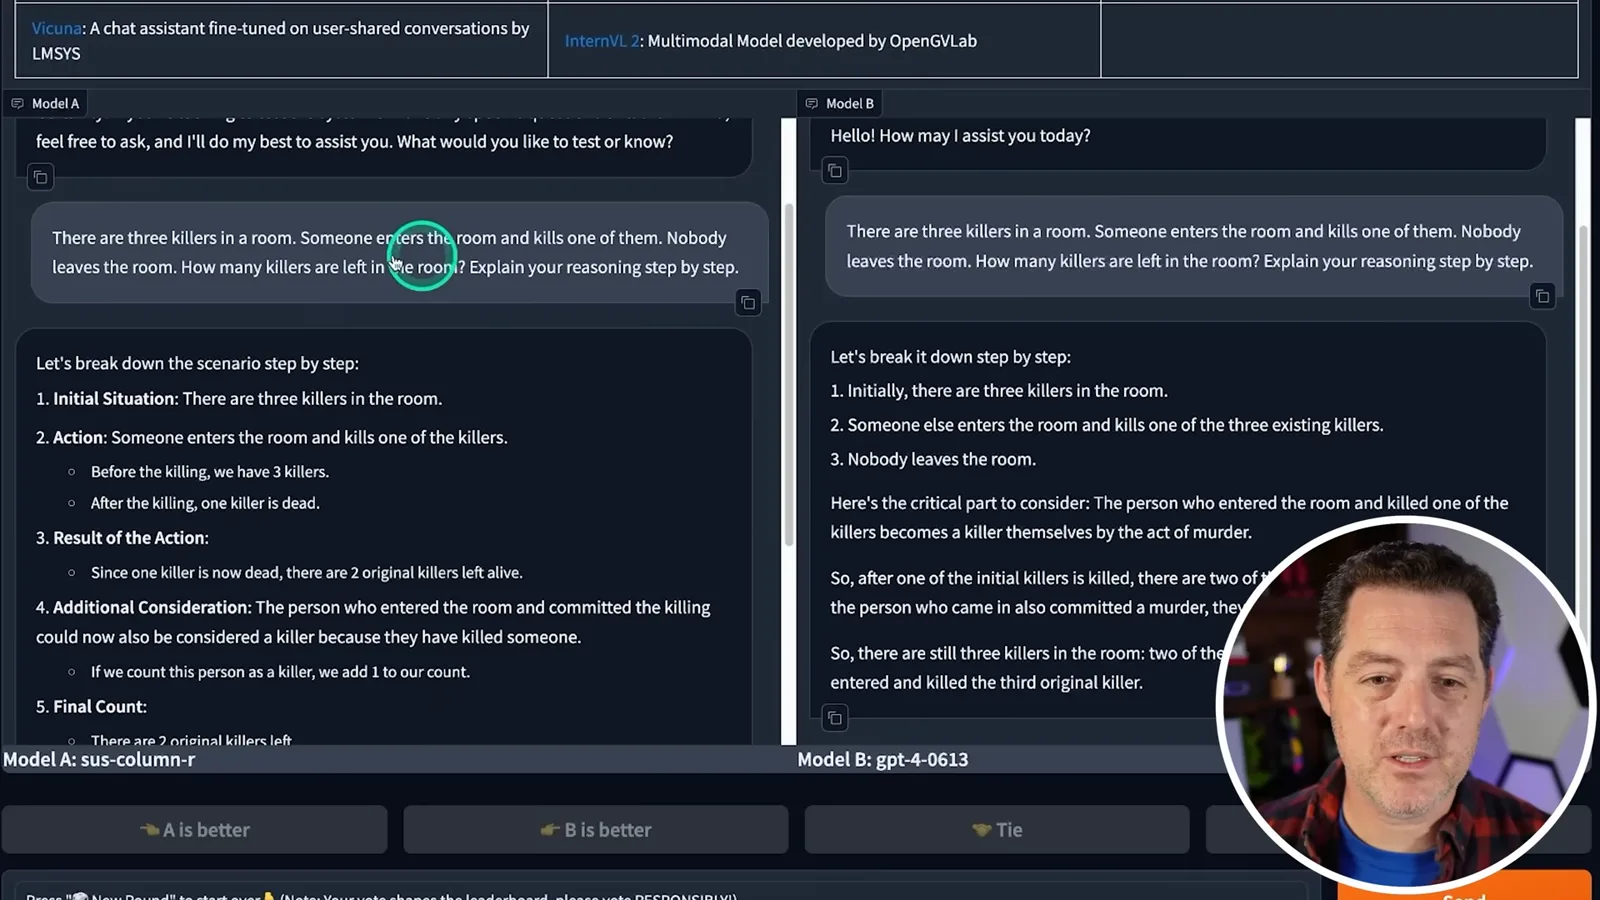
我的第一道测试题是:房间里有三名杀手,一个人进入房间并杀死其中一人,没有人离开。还剩多少名杀手?GPT-4-0613 回答是三名,因为原来的杀手有两人活着,而进入房间的人也成了杀手。这个常见答案统计的是活着的人,并假定进入者是另一个人。
sus-column-r 的回答将情况拆成初始状态、行动、结果和最终计数。如果算上进入者,它给出的答案是三人;如果只算原来的杀手,则是两人。这一次的解释更详细,但单个样本不能证明它整体上更优秀,也无法揭示模型隐藏的内部推理过程。
我更难的一道题是:把一颗弹珠放进玻璃杯,将杯子倒扣在桌上,再把杯子拿起来放进微波炉。弹珠在哪里?按照通常的理解,倒扣的杯子被拿起后,弹珠会留在桌上。最初的两个回答都说弹珠在微波炉里;它们都不是那两个神秘模型。
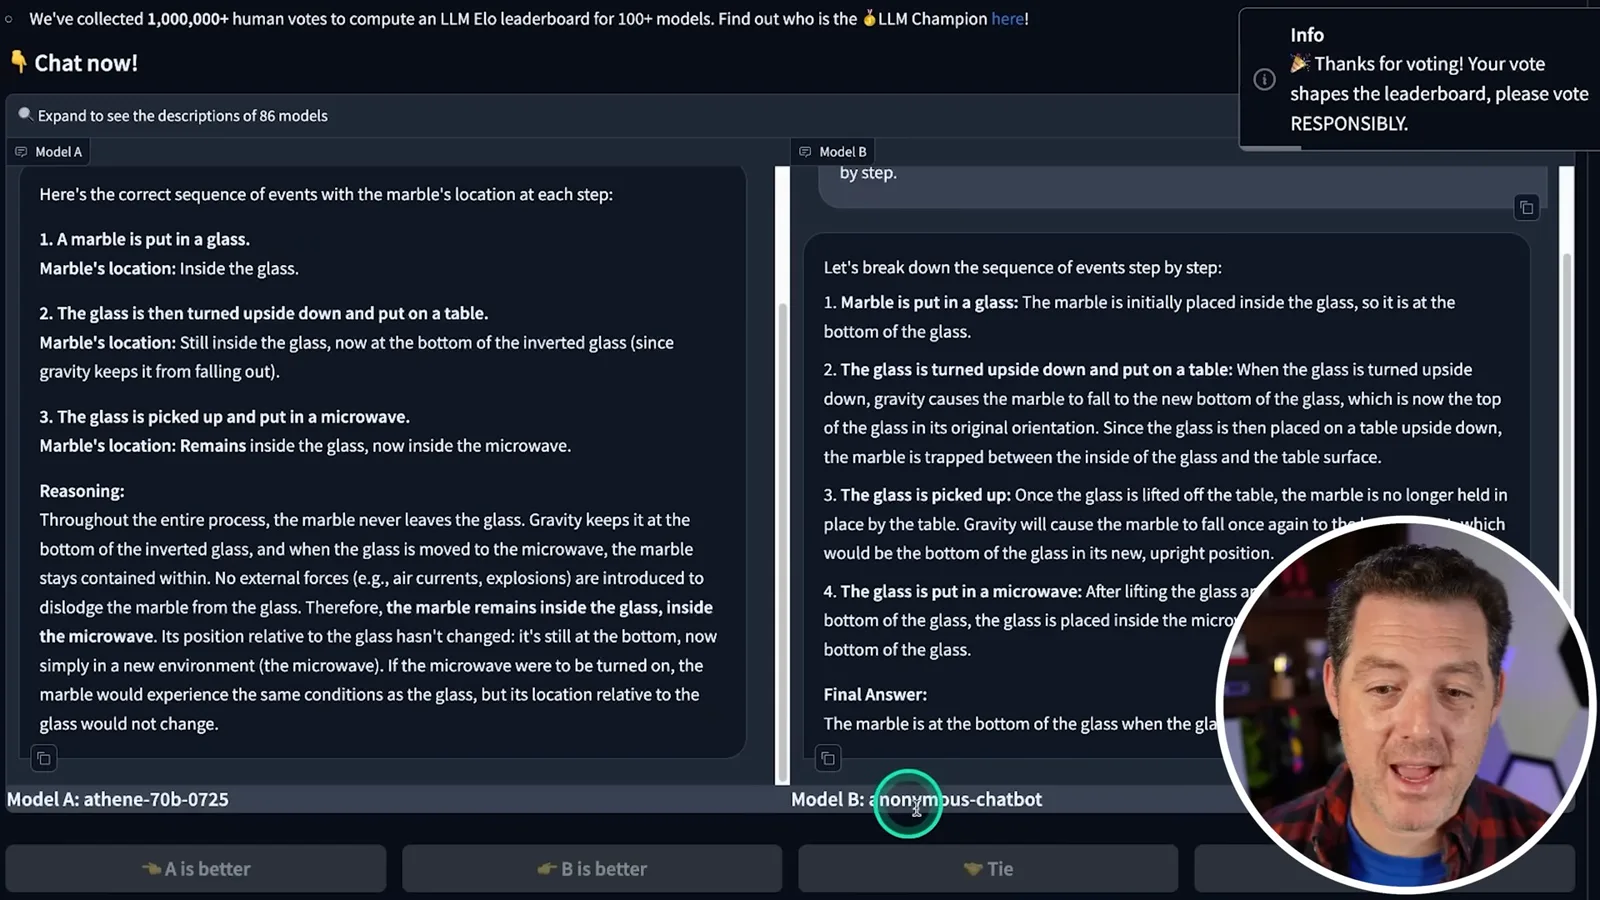
第二次尝试揭晓了 anonymous-chatbot,它也说弹珠最终会在微波炉内的杯子里。按照题目预期的物理场景,我认为这个答案不对。和许多简短谜题一样,答案取决于我们对杯子如何倒转和拿起的假设。
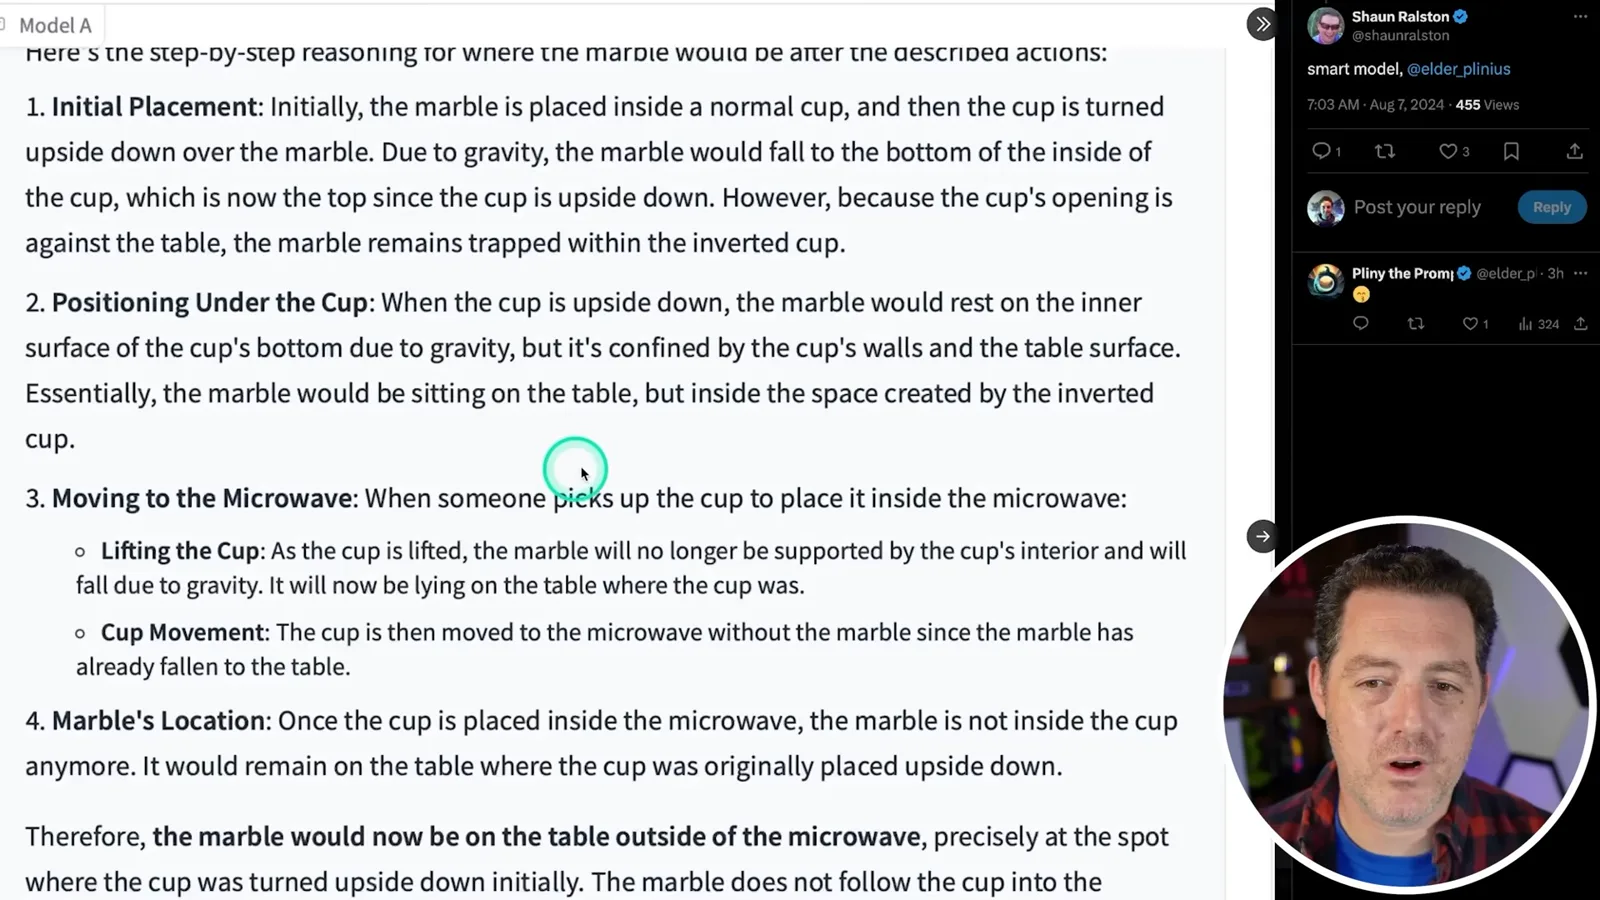
Ralston 还分享了 sus-column-r 对同一提示的回答。它的最终答案是弹珠留在桌上、微波炉外,符合题目预期。不过,它对中间物理过程的部分解释有些别扭,因此不能把正确的最终答案误认为完全连贯的解释。
这些只是几个演示,并非完整评估。我计划进行更广泛的测试,也想问观众:传闻中的发布是否临近,还是草莓帖子只是在逗大家?sus-column-r 后来身份的揭晓说明,匿名模型的名称和输出只能为判断其提供方提供很弱的证据。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。