30 秒看懂
OpenAI 于 2025 年 1 月推出 o3-mini 后不久,Matthew Berman 在 ChatGPT 中测试 o3-mini-high,尝试编程、空间推理、文字任务和网络搜索。他总体上喜欢这些结果,但这些非正式提示只是少量样本,并非受控基准测试。 有些谜题取决于解释方式:杀手数量因是否计算死者而异,北极题也没有充分说明路径和“起点”的含义,难以简单判定。Yandex 赞助了推广 YaFSDP 的一段内容。
- 1两个游戏原型贪吃蛇在短暂测试中运行正常;俄罗斯方块可以玩,但 Berman 发现消行延迟。
- 2信封尺寸将 200 × 275 毫米信封的长短边对应到题目限制后,其尺寸符合范围。
- 3杀手数量的歧义模型把死去的原杀手和新进入者都算进去,得到 4 人;只计算活人则是 3 人。
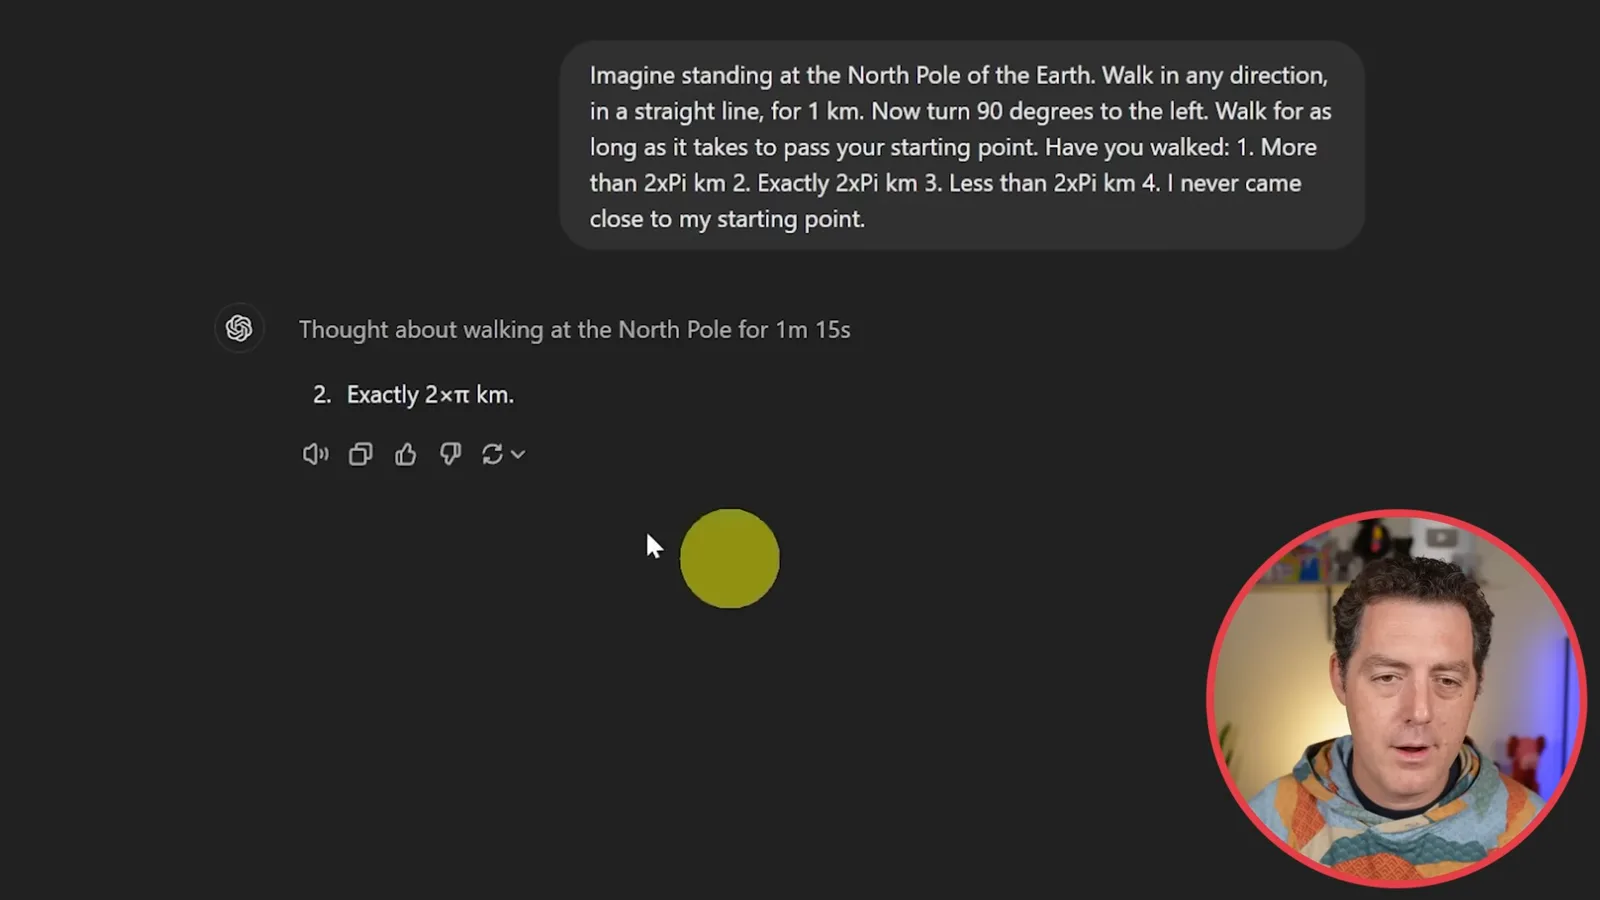
- 4北极几何模型回答恰好 2π 千米,Berman 不同意。必须先明确路径和起点,才能给出唯一答案。
- 5开启搜索第一次 UFC 回答缺少当前信息,因为搜索没有开启;Berman 启用后重试。
要点建议
- Berman 的短暂试玩中,生成的贪吃蛇游戏可以运行;俄罗斯方块也能玩,但完整的一行要等下一块落下才消除。
- 自指的字数问题触发了政策提示,模型则对信封、弹珠和拼写问题给出了合理答案。
- 杀手谜题中,若只计算活人有 3 名杀手,若包括死者则有 4 名曾杀人的人。
- 北极题的答案取决于路径是大圆还是纬线,以及起点指的是哪一点。
- UFC 查询最初没有开启搜索;Berman 开启后重试,并称历史查询结果正确。
- Yandex 赞助了视频,其对 YaFSDP 性能的比较属于赞助方说法,而非本次模型测试结果。
按章节阅读整理后的全文
贪吃蛇和俄罗斯方块
Berman 用 Python 游戏提示测试 o3-mini-high。两个程序都能运行,但俄罗斯方块的消行出现延迟。
我在 ChatGPT 中测试 o3-mini-high,重点是编程和其他 STEM 类问题。OpenAI 在 2025 年 1 月 31 日推出 o3-mini,并在[发布说明](https://openai.com/index/openai-o3-mini/)中介绍了可调节的推理强度和早期搜索集成。这段视频记录的是当时的版本,并非全面评测。
首先我要求用 Python 编写贪吃蛇。ChatGPT 显示的是推理摘要,而非模型完整的内部思维链。代码很快出现;我运行它,吃到一个目标,并撞墙结束游戏。短暂测试中游戏可以运行,虽然速度很快。
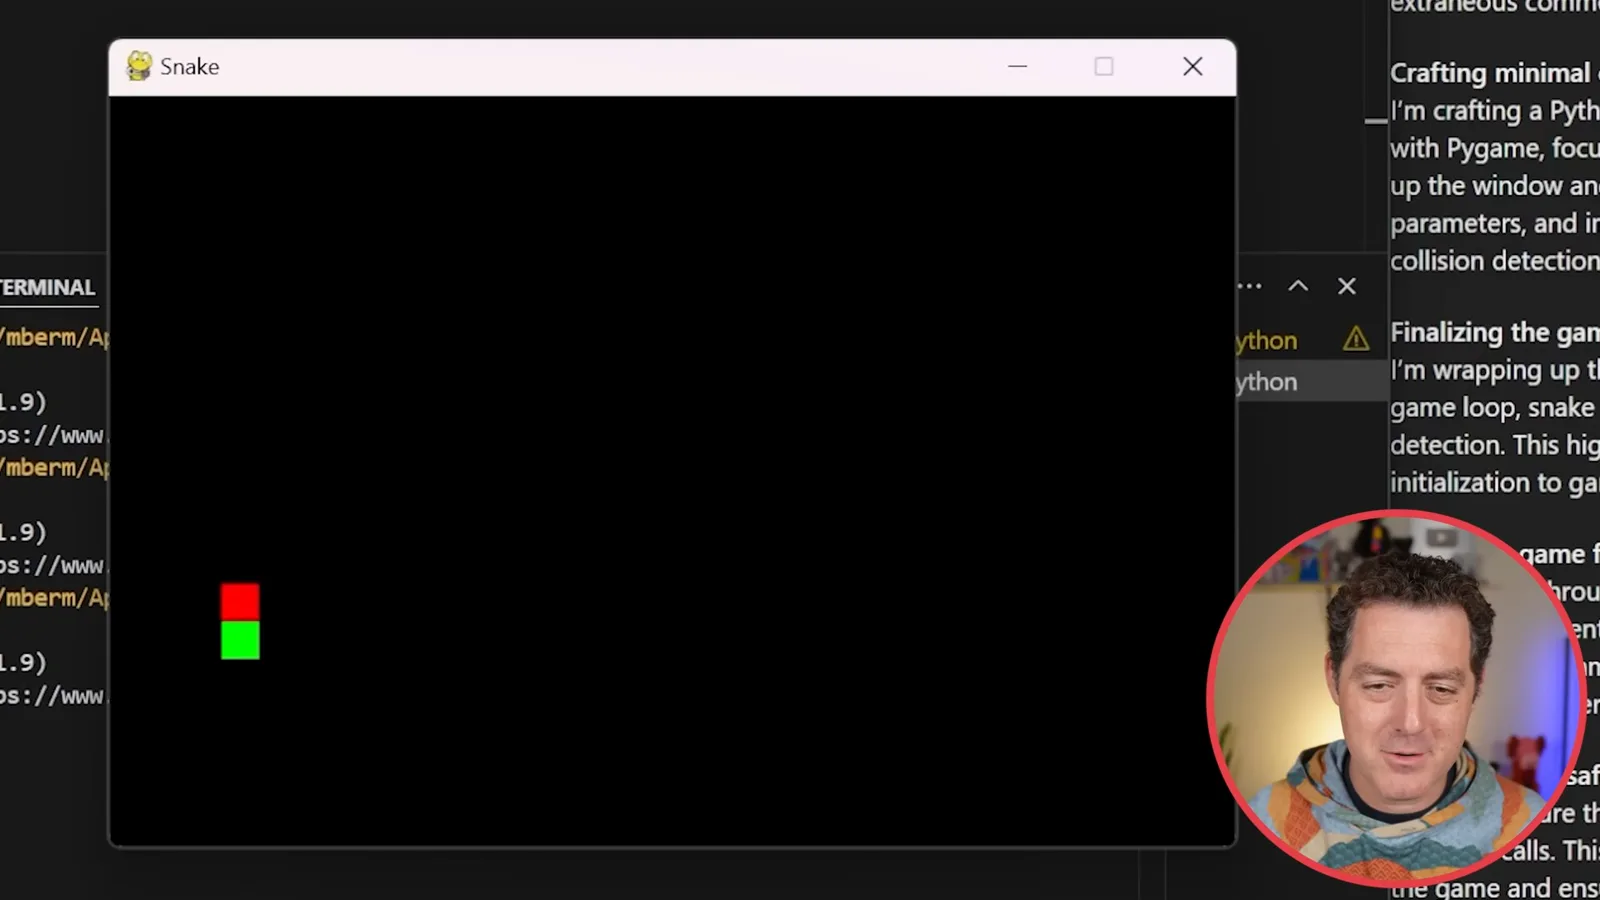
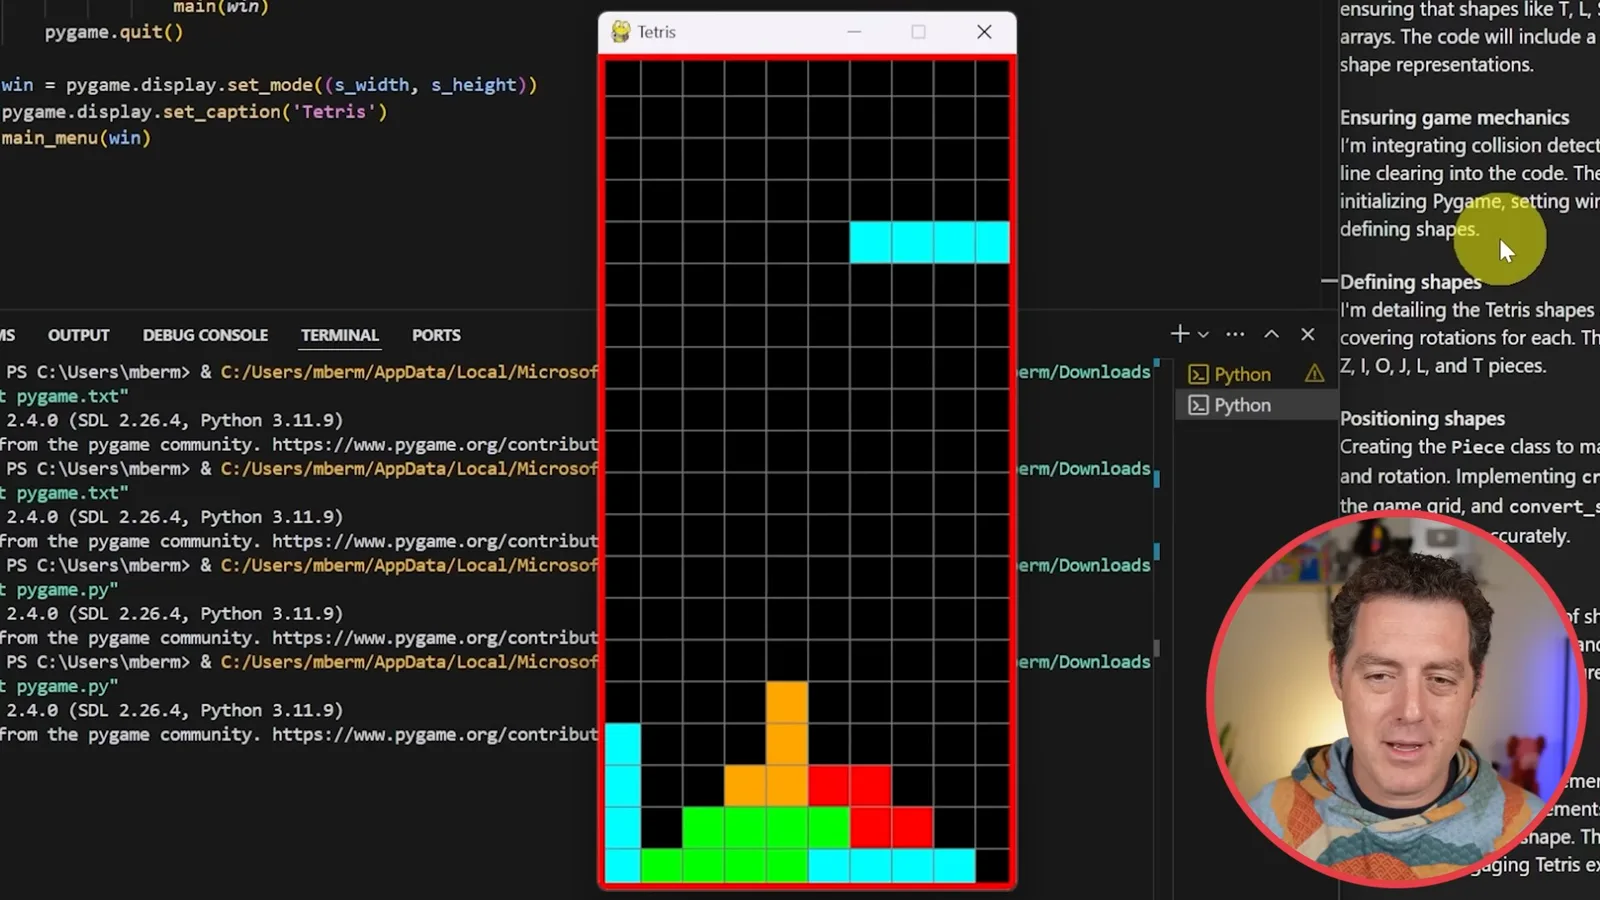
更难的编程任务是用 Python 编写俄罗斯方块。推理阶段似乎比贪吃蛇慢,而最终代码显示很快。我看不到隐藏的推理过程或其 token 速率,因此可见输出速度不能证明内部计算有多快。
这个约 293 行的程序可以运行,方块也能按预期移动,包括落地后继续移动。但我完成一行后,它要等下一块出现才消除。我给这次单次尝试一个有保留的通过,同时指出这个缺陷和一开始就较高的难度。
尺寸与逻辑谜题
模型回答信封问题,在字数提示中遇到政策提示,并解释杀手谜题。其间有 Yandex 赞助的 YaFSDP 内容。
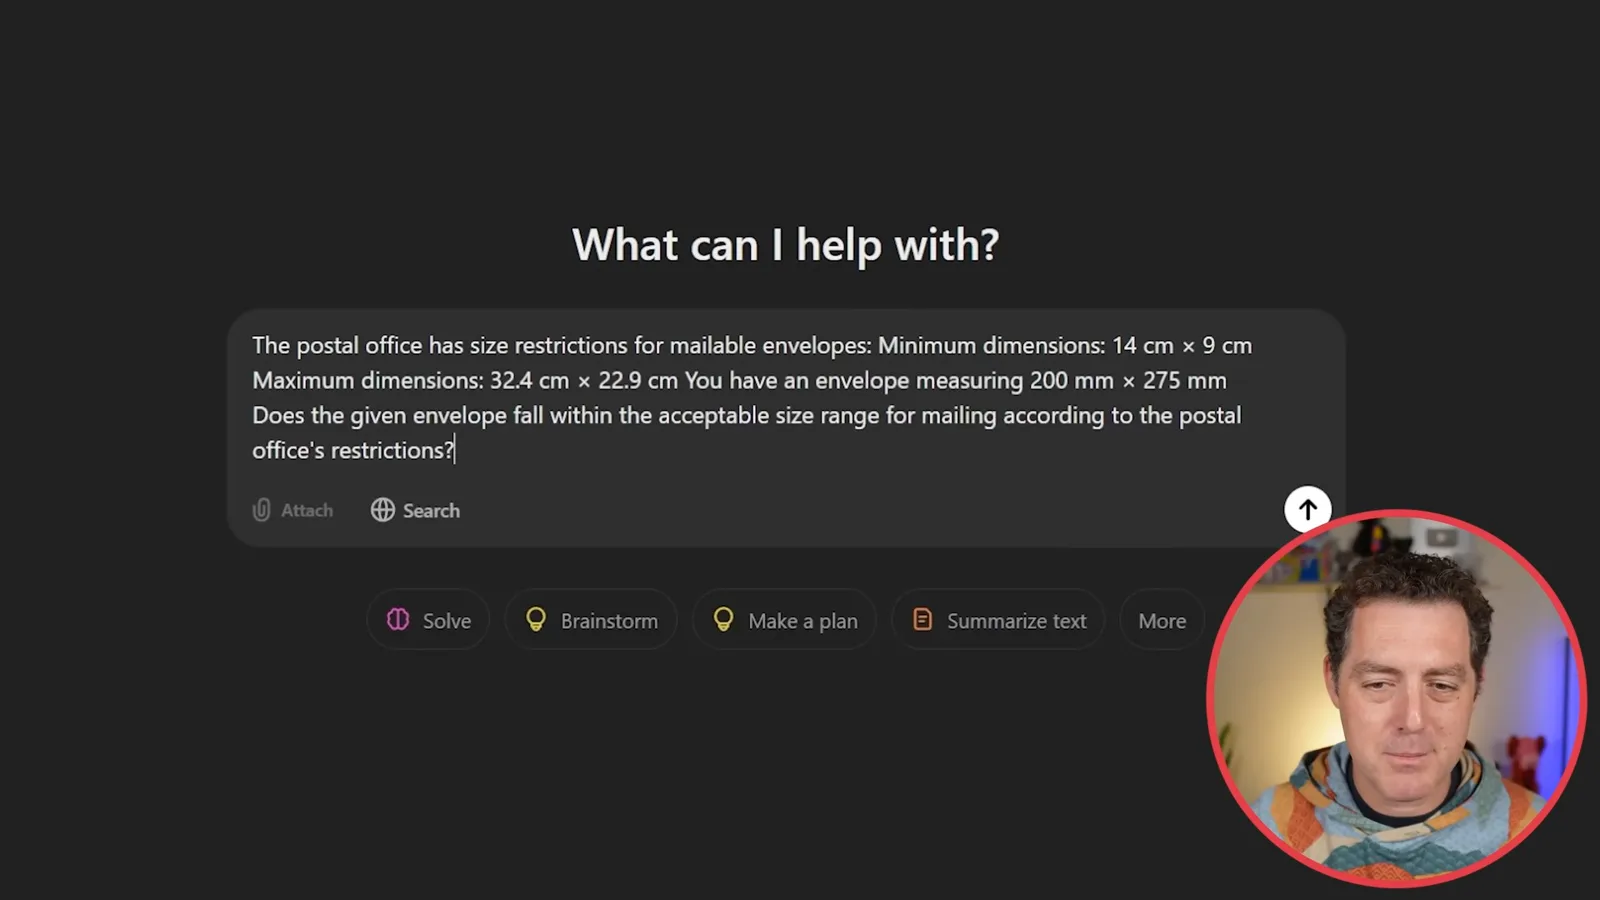
信封题给出最小尺寸 14 × 9 厘米、最大尺寸 32.4 × 22.9 厘米,询问 200 × 275 毫米信封是否符合要求。换算为 20 × 27.5 厘米,并将长短边对应后,它在范围内。模型回答是,我认为符合题目条件。
我询问模型对这条提示的回答有多少个词。回答似乎停住了,重试时又收到可能违反使用政策的提示。我将这次尝试记为未能回答;视频无法证明触发提示的原因,也不能证明模型在其他尝试中无法解决这个自指问题。
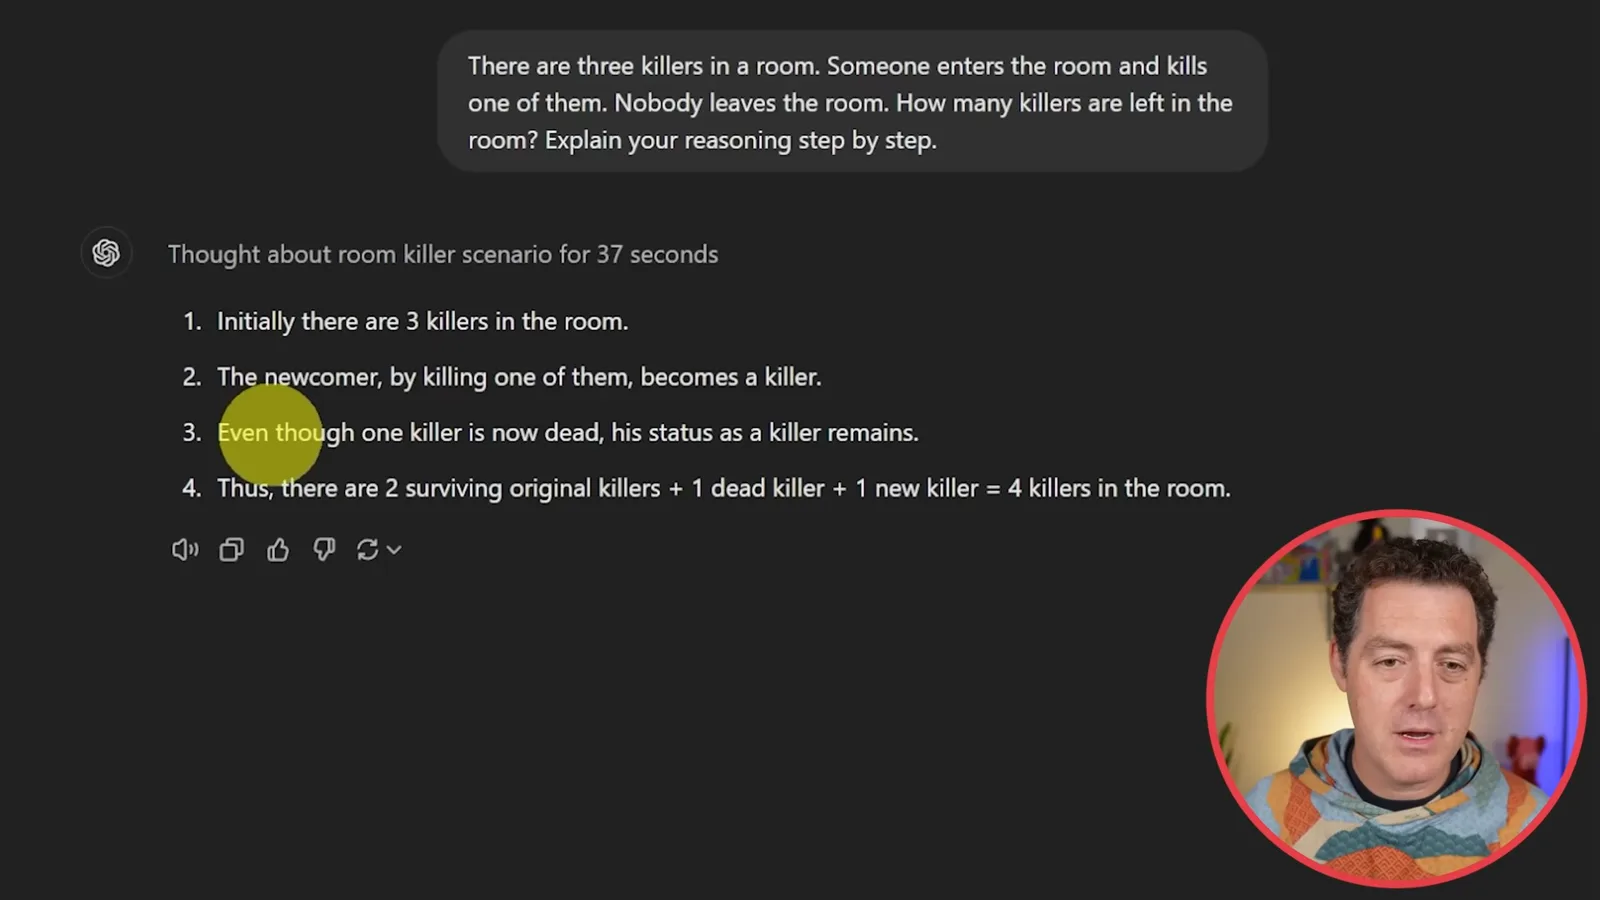
杀手谜题中,房间里有 3 名杀手,一个人进来杀了其中一人,没人离开。模型把死去的杀手、另外两名原杀手和新进入者都算进去,回答 4 人。我接受了它的解释。但措辞有歧义:若“剩下的杀手”指活人,答案是 3;如果包括死者,可以算作 4。
Yandex 与我合作制作了这段视频。赞助内容中,我介绍了开源的分片数据并行训练库 [YaFSDP](https://github.com/yandex/YaFSDP),并引用它与 DeepSpeed ZeRO 和 FSDP 的比较。这些是赞助方的性能说法,不是我的 o3-mini 测试结果;节省多少取决于工作负载和配置。
弹珠与北极
模型处理杯子和弹珠问题。北极题的答案引发了对几何问题描述不充分的争论。
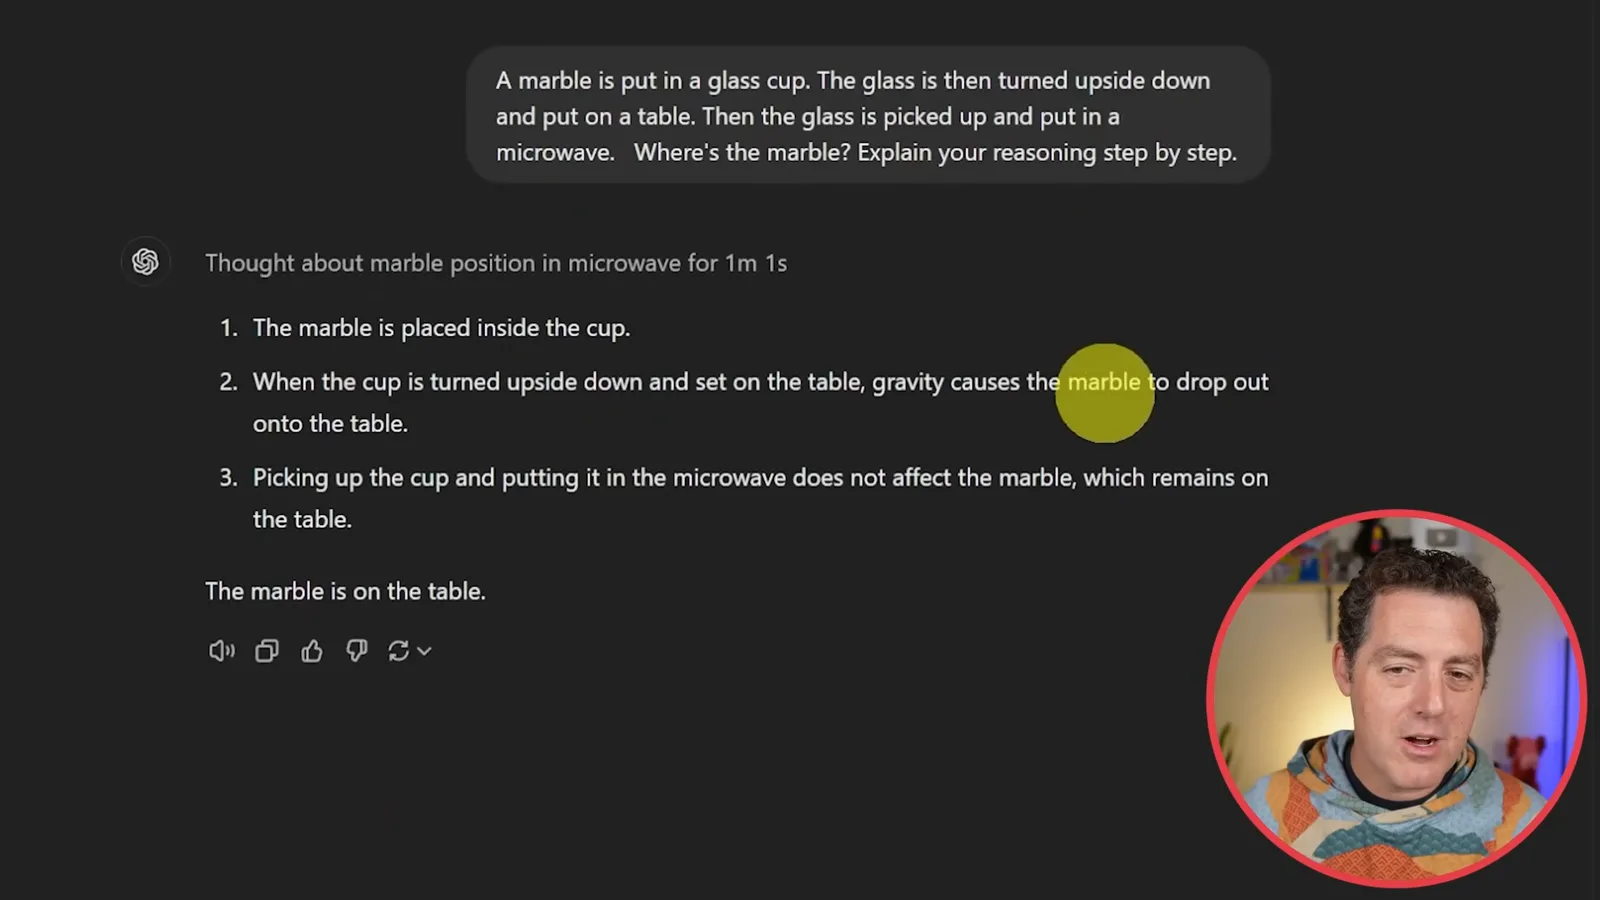
接下来是弹珠题:弹珠放进玻璃杯,杯子倒扣在桌上,再被拿起放进微波炉。假设这是普通开口杯,且没有东西把弹珠固定在杯内,模型说弹珠留在桌上。我接受这个答案,并注意到界面显示的是较长的推理摘要,而非完整内部推理。
北极题从北极出发,走 1 千米后左转 90 度,问走多远会经过起点。选项是超过 2π 千米、恰好 2π 千米、少于 2π 千米,或永远不会接近起点。模型选择恰好 2π 千米;我不同意,并将其判为失败。
几何问题需要补充假设。在理想球面上,如果转弯后沿大圆测地线直行,不会经过北极;转弯处是距北极最近的位置,约为 1 千米。走完约一圈地球的长度会回到转弯处,因此第四个选项中“永远不会接近”的措辞不够精确,并非清晰的数学表述。
如果行走者改为始终沿纬线走,那是曲线路径,而非沿大圆直行。走约 2π 千米后会回到转弯处,球面上的实际距离略少,但仍不会经过北极。“起点”是北极还是转弯点,以及是否将最初 1 千米算入距离,都会实质性改变解释;没有这些假设,无法证明恰好是 2π 千米。
文字、伦理与搜索
Berman 测试句尾词和字母计数,提出伦理假设,并开启搜索后重试时事查询。
我要求写 10 句以 apple 结尾的句子,数出 10 句符合条件的回答。随后模型正确数出 strawberry 中有 3 个 r。这是熟悉的文字任务中的个别成功,并不能证明它在所有语言问题上的表现。
我提出一个伦理假设:如果轻轻推一个陌生人就能避免人类灭绝,是否可以这样做?要求回答是或否并解释。模型回答可以,并从结果主义角度解释:题设中的轻微伤害小于拯救人类的巨大收益。我喜欢它的直接回答;这是该假设条件下的伦理判断,而非普遍规则。
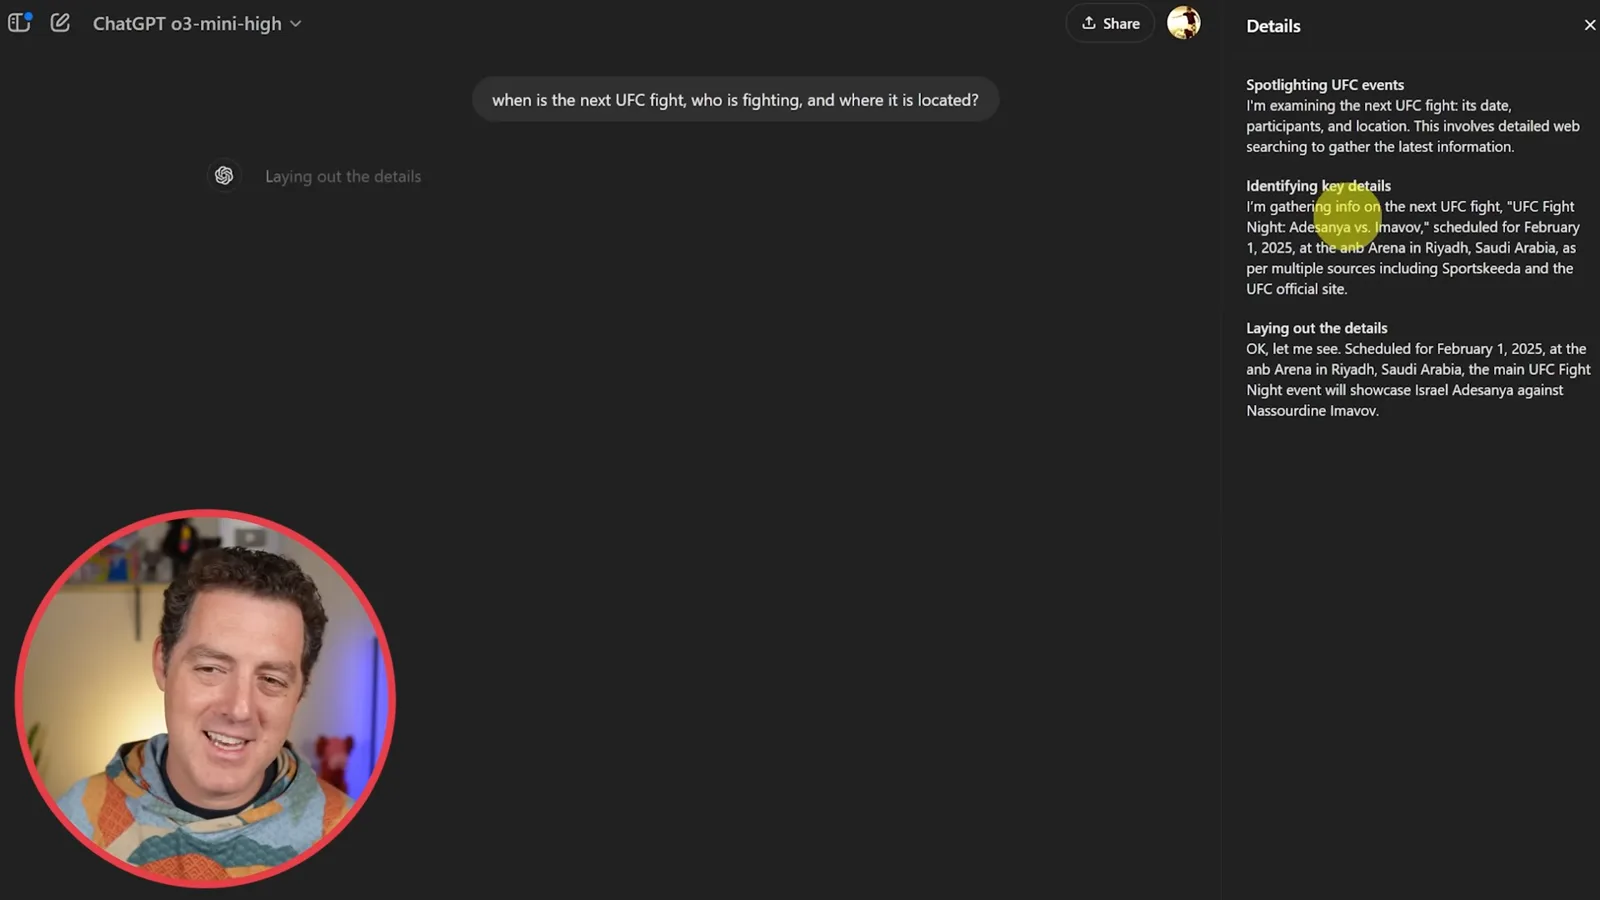
最后我询问下一场 UFC 赛事、参赛者和地点,以测试网络搜索。起初模型说缺少当前信息,我才发现自己没有开启搜索。启用后重试,画面识别出 2025 年 2 月 1 日在利雅得举行的 Adesanya 对 Imavov 比赛;我认为这次历史查询通过了。
总体来说,我对 o3-mini 印象深刻,也邀请观众提出比较建议,包括与 DeepSeek R1 的比较。这些例子展示了有用的表现和不足,但它们只是简短的非正式演示,并非标准化基准,也不能证明所有任务都会同样顺利。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。