30 秒看懂
在这段由 Lightning AI 赞助的教程中,Matthew Berman 使用 YAML 定义智能体和任务,搭建 CrewAI 项目,用 Groq 运行 Tesla 分析,然后开始切换到 Lightning Studio 中通过 Ollama 提供的 Mixtral。他在简介中披露自己投资了 CrewAI。 代码、工具和价格均为历史信息。视频没有清楚展示复制的搜索工具已接入,也没有完成第二次运行;生成的财务数字需要独立核实。
- 1模块化结构YAML 文件定义智能体和任务,Python 则组装团队。
- 2两个智能体研究员和分析师依次处理任务,示例中关闭了委派功能。
- 3数据来源限制视频复制了一个 SEC 工具,但没有清楚展示它已接入智能体。
- 4托管运行输出只是演示,视频没有验证其中的财务数字。
- 5远程模型端点Ollama 运行在云端 Studio 中;暴露端点时认证很重要。
要点建议
- 示例将智能体和任务配置与团队编排及主入口分开。
- 任务指令提到搜索,并不能证明实际数据工具已连接或使用。
- 托管运行产生的财务数字必须独立核查,不能假定其最新或准确。
- Ollama 模型运行在远程 Lightning GPU 上,而不是观众自己的设备上。
- 第二次运行开始后即被停止,没有展示完整的端到端结果。
- 视频由 Lightning AI 赞助;Berman 披露自己是 CrewAI 投资者。
按章节阅读整理后的全文
项目结构和任务
Berman 介绍赞助教程、创建云端 Studio,并定义研究和分析任务。操作反映的是 2024 年版本。
在这段 2024 年 4 月的教程中,我使用 CrewAI 和 Lightning AI 构建一个财务分析团队,然后将托管的 Groq 模型替换为运行在 Lightning 云端 GPU 上的 Ollama 模型。Lightning AI 赞助了这段视频,我在简介中披露自己是 CrewAI 投资者。这是历史工作流程;界面、软件包和服务条款可能已经变化。
我创建一个新的 Lightning Studio 和代码环境。它提供基于浏览器的编辑器和托管云计算,但仍需要安装依赖,而且该环境并非天然就是全新的本地机器。额度、价格和 GPU 可用性取决于服务当前的条款。
项目采用模块化结构:`src/financial_analyst_crew` 包包含配置、工具和团队定义,简短的 `main.py` 则提供输入并启动运行。我说这是 CrewAI 创始人向我推荐的结构;这是 2024 年的一种方法,并不能保证与未来版本兼容。
在 `config` 中,我创建 `agents.yaml` 和 `tasks.yaml`。我预计这一结构最终可能支持自动暴露团队端点,但这是当时对未来的预期,并不能证明视频本身创建了这样的 API。
第一项任务研究一家公司,包括任务描述和预期输出。我使用 `{company_name}` 占位符,让同一任务能够接收不同输入,并要求提供足够的财务信息来分析股票表现。
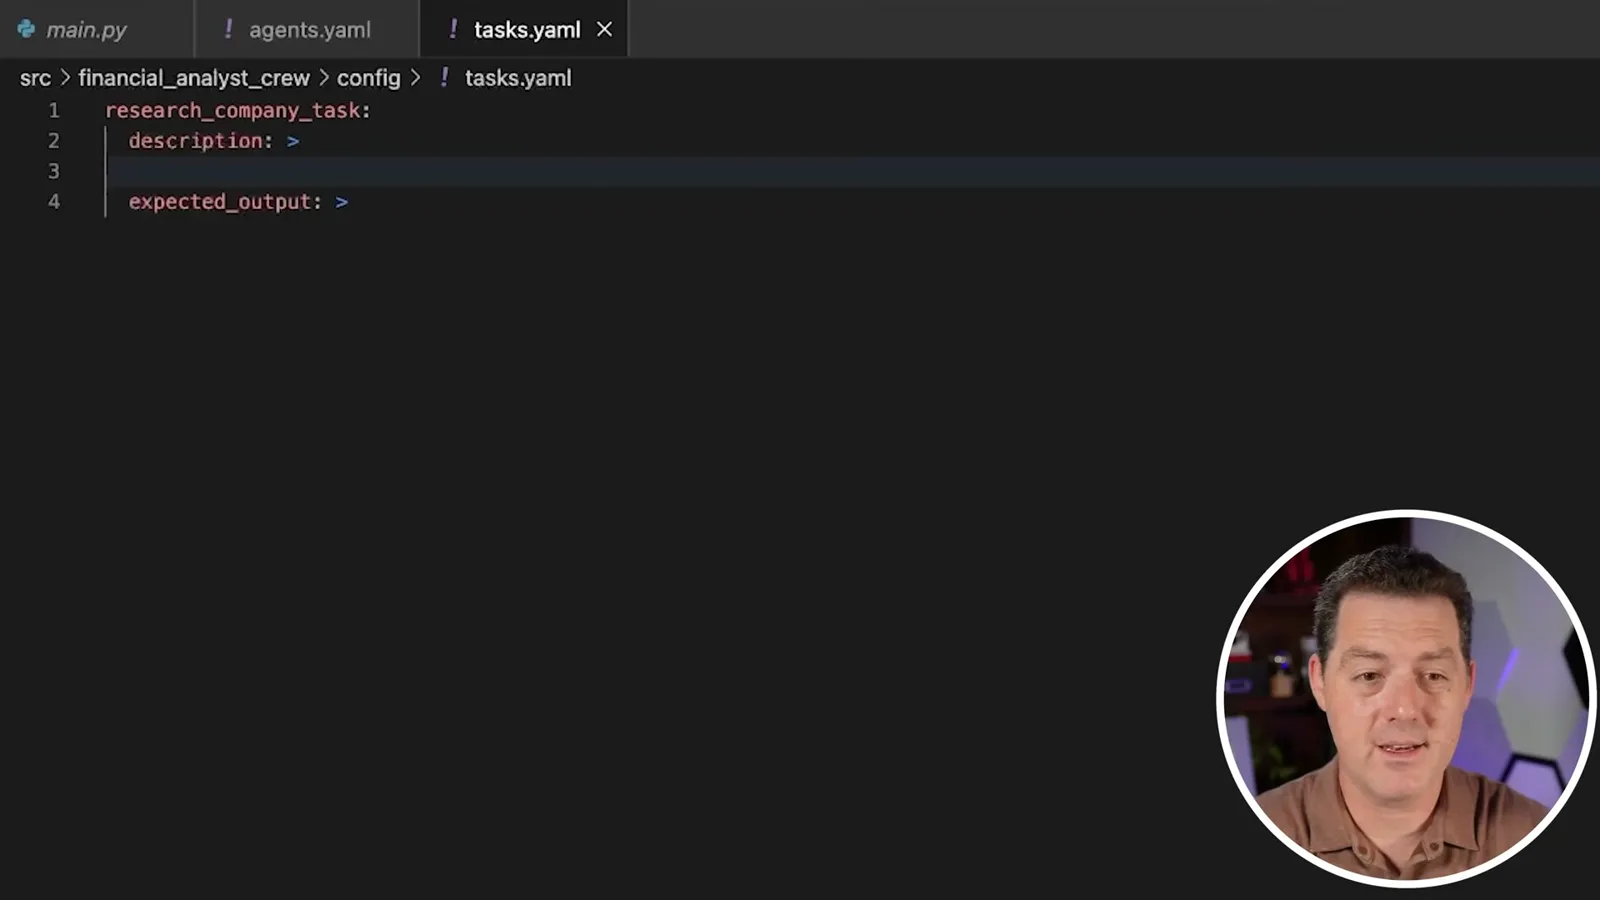
我添加一项分析任务,并使用 Claude 构思指标,例如盈利能力、流动性和偿债能力比率。预期输出是一份易读的财务报告。这是简单演示,并非完整的投资研究系统。
智能体和团队编排
他定义两个智能体,组装顺序任务并配置托管的 Groq 模型。主入口提供公司名称。
在 `agents.yaml` 中,我为财务研究员定义角色、目标和背景。我明确提到搜索工具,关闭委派并启用详细输出。提示词中提到某个工具本身并不会让智能体获得访问权限;工具必须实际配置并接入。
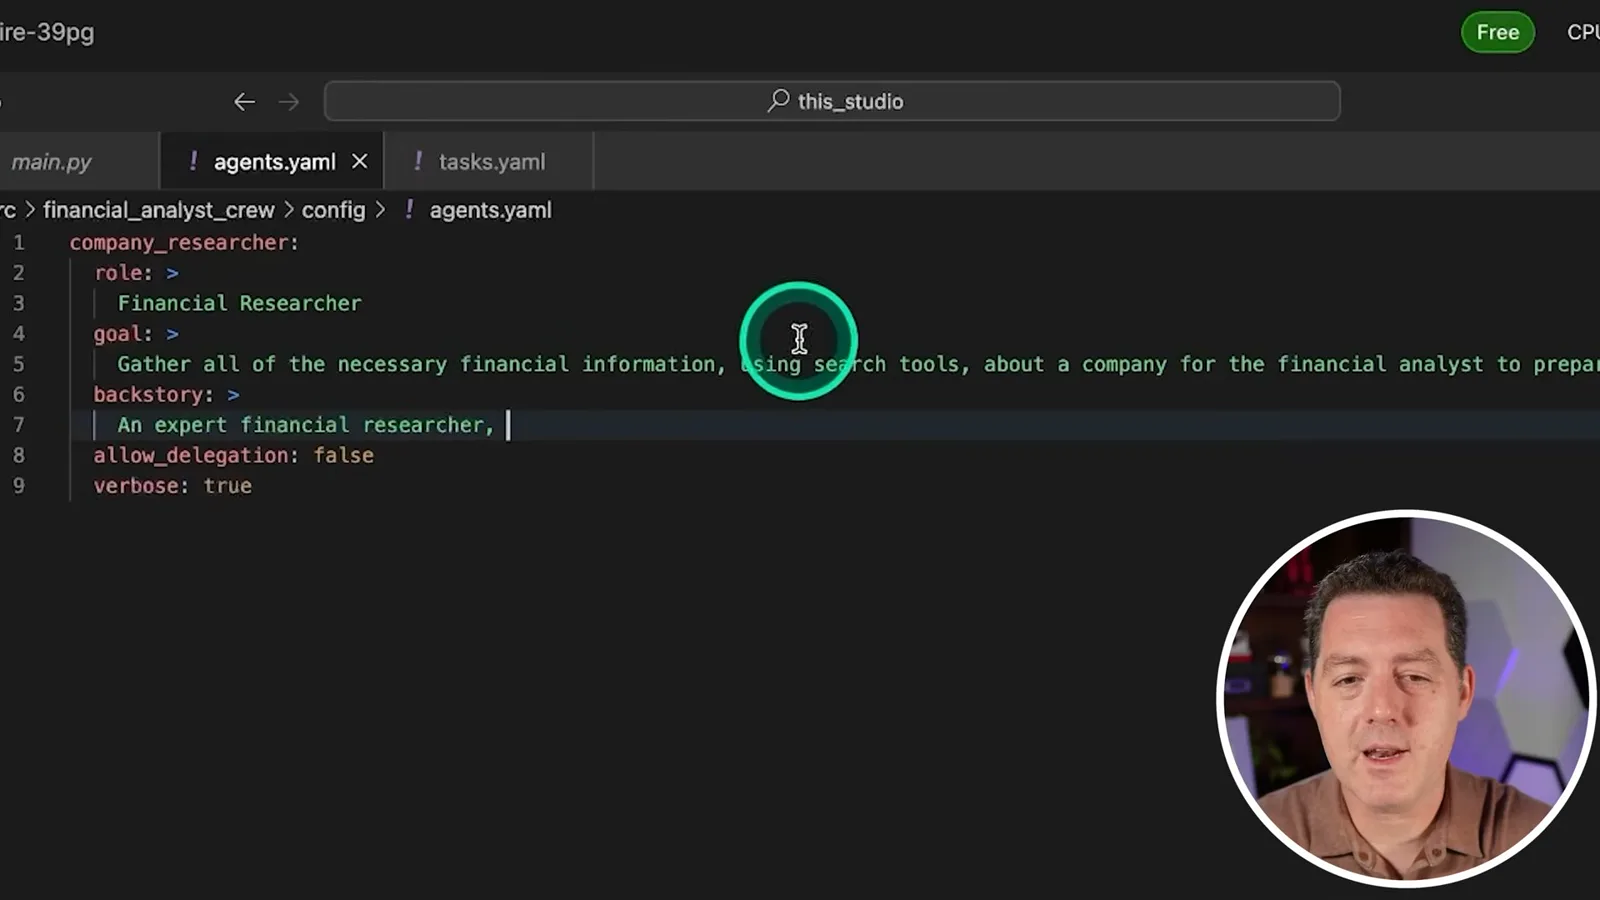
我创建第二个智能体——财务分析师,目标是将公司信息整理成清晰的报告。在这个例子中,我通常让每项任务对应一个智能体,但也可以采用其他架构。我指出演示的云端编辑器会自动保存文件。
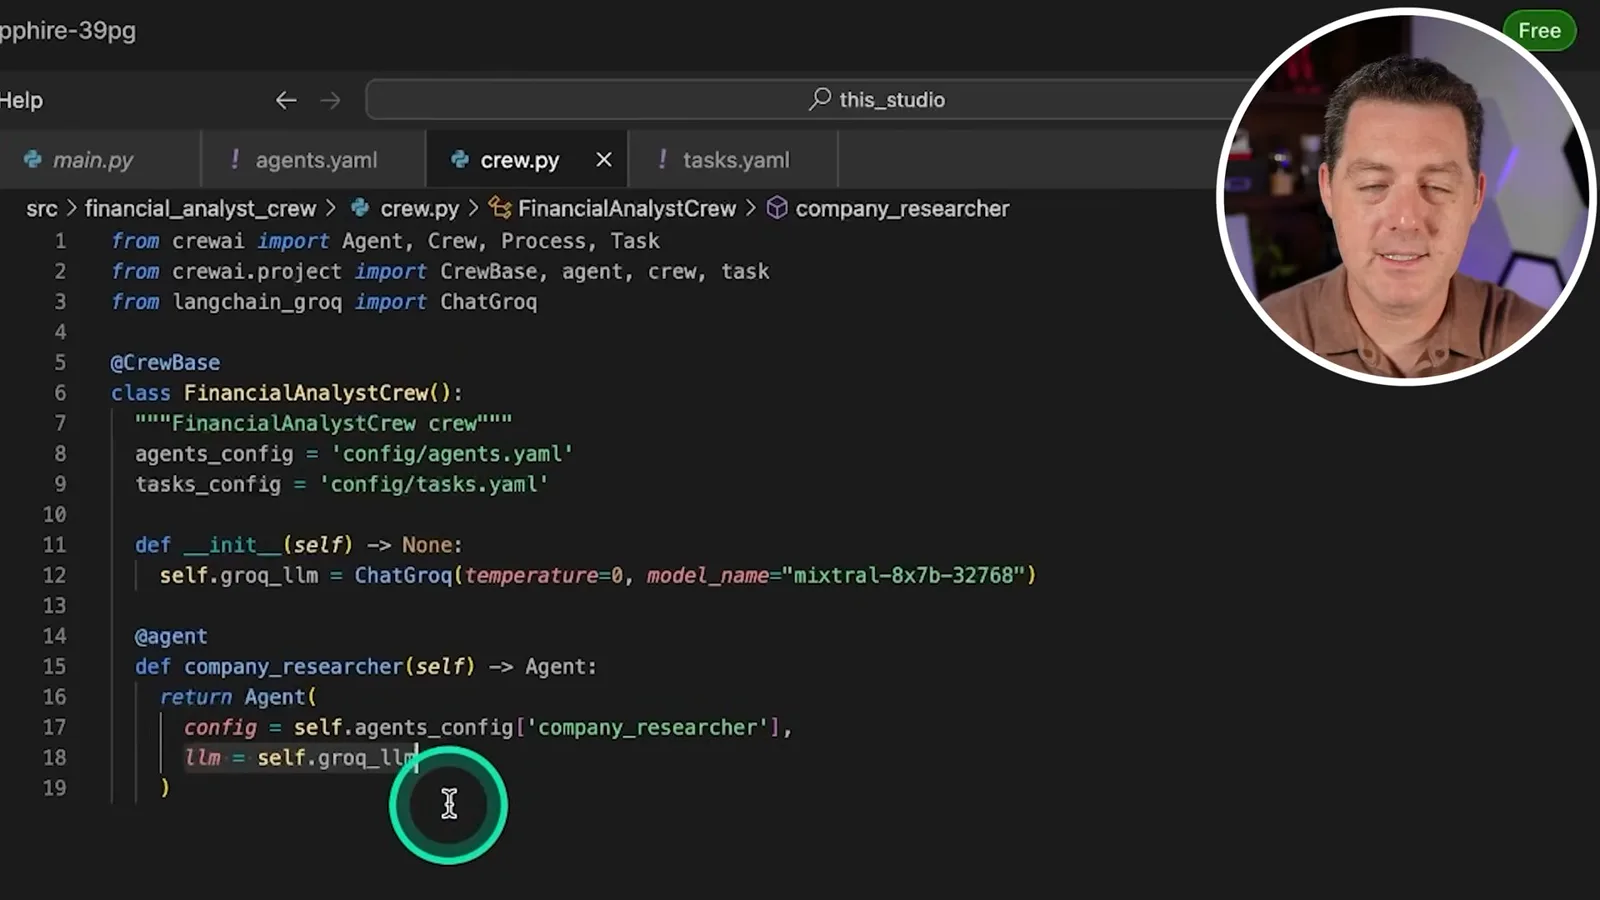
在 `crew.py` 中,我导入 CrewAI 的 `Agent`、`Crew`、`Process` 和 `Task`、项目装饰器,以及来自 `langchain_groq` 的 `ChatGroq`。我创建带装饰器的团队类,将其指向 YAML 文件,并配置 Groq 上的 Mixtral。具体导入方式和参数反映的是录制时的版本。
带装饰器的研究员和分析师方法返回依据 YAML 配置的智能体,并使用 Groq 语言模型。我指出,当集成支持时,不同智能体可以使用不同模型提供商;示例最初使用一个托管模型。
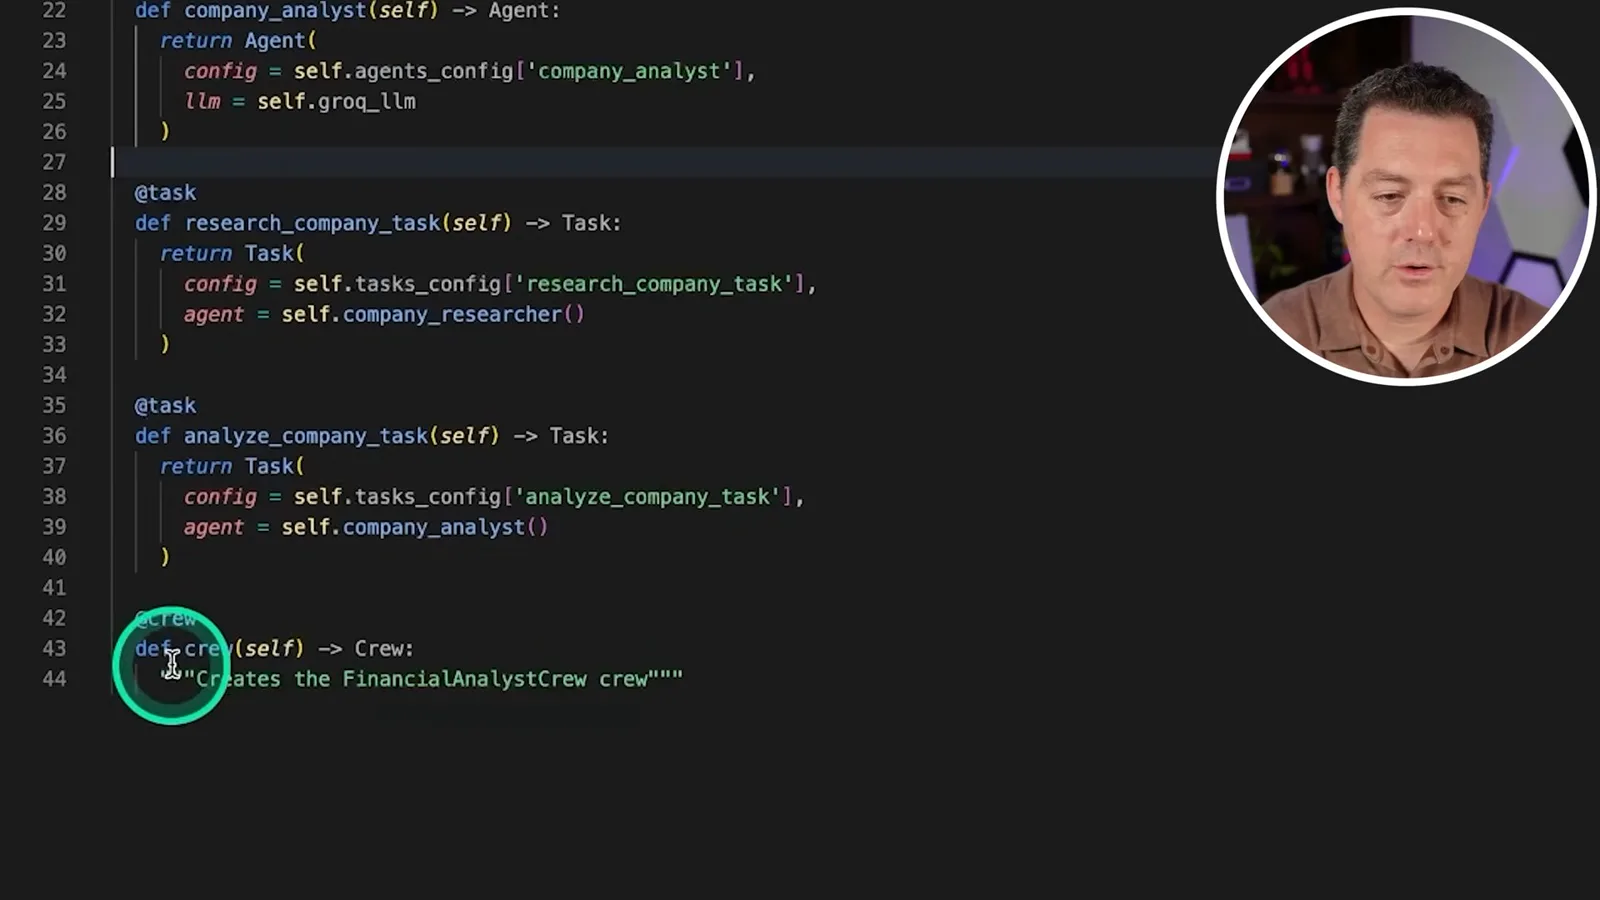
我用配置和指定的智能体定义每项任务,然后用收集到的智能体和任务定义团队。顺序流程先运行研究任务,再运行分析任务,以便后者使用前面的输出。
在 `main.py` 中,我加载环境变量、导入团队,并以 Tesla 作为 `company_name` 输入调用 `kickoff`。CrewAI 将该输入插入任务描述。我把 Groq API 密钥放入环境文件,并表示会在发布前撤销示例密钥;读者应避免在共享文件和截图中暴露自己的凭据。
工具、依赖和第一次运行
他复制一个 SEC 工具并使用 Poetry 安装项目。生成的财务输出没有经过独立核实。
我将一个 SEC 工具示例复制到 `tools` 文件夹。教程没有清楚展示该工具被导入并接入研究员:仅有复制的文件和提示词,不能证明已经取得实时数据。在依赖生成数字之前,应核实实际的工具连接及其来源。
我安装 Poetry、创建 `pyproject.toml`、锁定依赖并安装。修正项目名称并处理缺少的 `langchain-groq` 模块后,我运行团队。这些命令和依赖行为与版本有关;应使用一致的项目环境并查阅当前文档。
托管运行生成了 Tesla 研究回答、比率和财务报告。我称赞它的速度,但画面中的数字和日期未经独立核实,其中包含过时或存疑的数值;流畅的回答不能证明智能体获取了最新信息或正确完成计算。应根据原始申报文件和市场数据核对数字。
云端 GPU 上的 Ollama
Berman 暴露 Ollama 端点并切换模型客户端。他在展示完整结果前停止了第二次运行。
为更换模型服务方式,我打开 Lightning Studio 中通过 Ollama 运行 Mixtral 的模板。Studio 运行在云端硬件上;这里的“本地”指远程环境内部的推理,而不是在观众自己的电脑上推理。更大的 GPU 可能产生费用,模型的资源需求取决于配置。
我安装 Lightning 的 API Builder,在 11434 端口暴露 Ollama 服务并复制端点。视频为了演示关闭了认证,但可从互联网访问的端点即使在测试中也应受到保护:[Lightning 文档](https://code.lightning.ai/docs/platform/build/ai-studio/deploy-on-public-ports/)介绍了认证选项。不要暴露凭据或让端点保持开放。
回到团队代码,我使用 Mixtral 和远程基础 URL 创建 Ollama 语言模型客户端,然后替换分配给智能体的托管 Groq 客户端。具体的 LangChain 导入方式和 API 兼容性取决于软件包版本;演示本身显示了弃用警告。
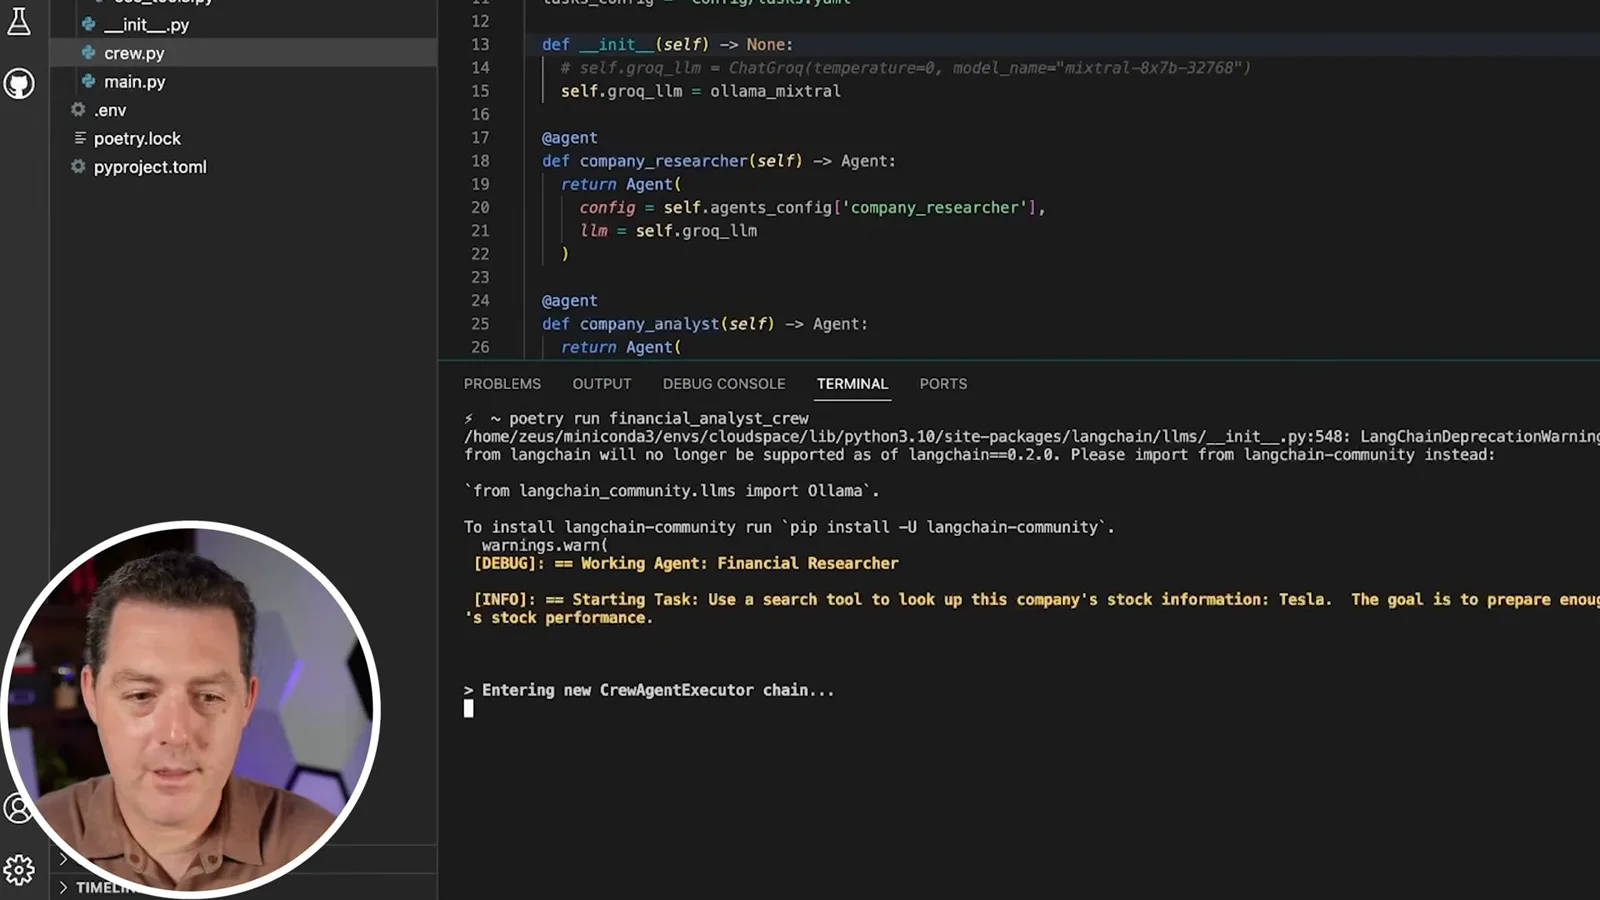
我启动另一次运行,并在 Ollama Studio 中观察到 GPU 活动。我在完整推理完成前停止了它,因此画面只能支持“请求到达模型并开始工作”,不能证明替换模型后整个财务分析流程已准确完成。
教程以模块化团队结构、云端托管的开放权重模型和暴露的模型端点收尾。在改用这一示例前,应审查生成的财务信息、工具访问、端点安全性和当前依赖。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。