30 秒看懂
Nathan Lambert 将策略梯度转化为语言模型代码,介绍 PPO、GRPO 和异步训练基础设施。他讨论奖励放置、价值估计、数值故障,以及损失聚合如何改变不同长度回答的权重。
- 1对数概率与掩码移动预测位置、提取 token 对数概率,并选择回答部分的 token。
- 2PPO 训练循环生成、奖励塑形、优势估计以及策略和价值更新构成一个循环。
- 3GRPO 的简化常见实现用组相对奖励取代价值模型和 GAE。
- 4异步训练分离 actor 与 learner,使生成和更新重叠进行。
- 5损失聚合序列级和 token 级归一化意味着不同的长度权重。
要点建议
- 逐 token 对数概率和掩码将语言模型输出连接到策略梯度损失。
- PPO 通过裁剪复用采样数据,并通常训练价值模型。
- 常见形式的 GRPO 使用组相对优势,省去价值模型。
- 异步 actor 与 learner 可以提高吞吐量,但需要同步权重。
- 按序列和按 token 聚合损失,对回答长度的加权不同。
按章节阅读整理后的全文
代码中的策略梯度
Lambert 将 token 对数概率、掩码和优势连接到 REINFORCE 和留一法基线。
本讲从策略梯度推导转向为语言模型实现强化学习。我会介绍 PPO、GRPO、基础设施和损失聚合。许多扩展和数据边界情况取决于具体代码库,但共同的基础构件值得理解。
我使用状态—动作记号,提示词—回答记号也很常见。实际问题是如何将策略梯度目标转成计算对数概率、优势和参数更新的代码。
目标是最大化期望轨迹奖励。其梯度包含对数策略梯度的求和,并由优势或相关信号加权。实现中,损失结合对数概率与优势,再由自动微分执行反向传播。
对一批 token ID,模型返回包含批次、序列和词表维度的 logits。移动位置,使每个预测与下一 token 对齐;应用 log-softmax,提取所选 token 的概率。
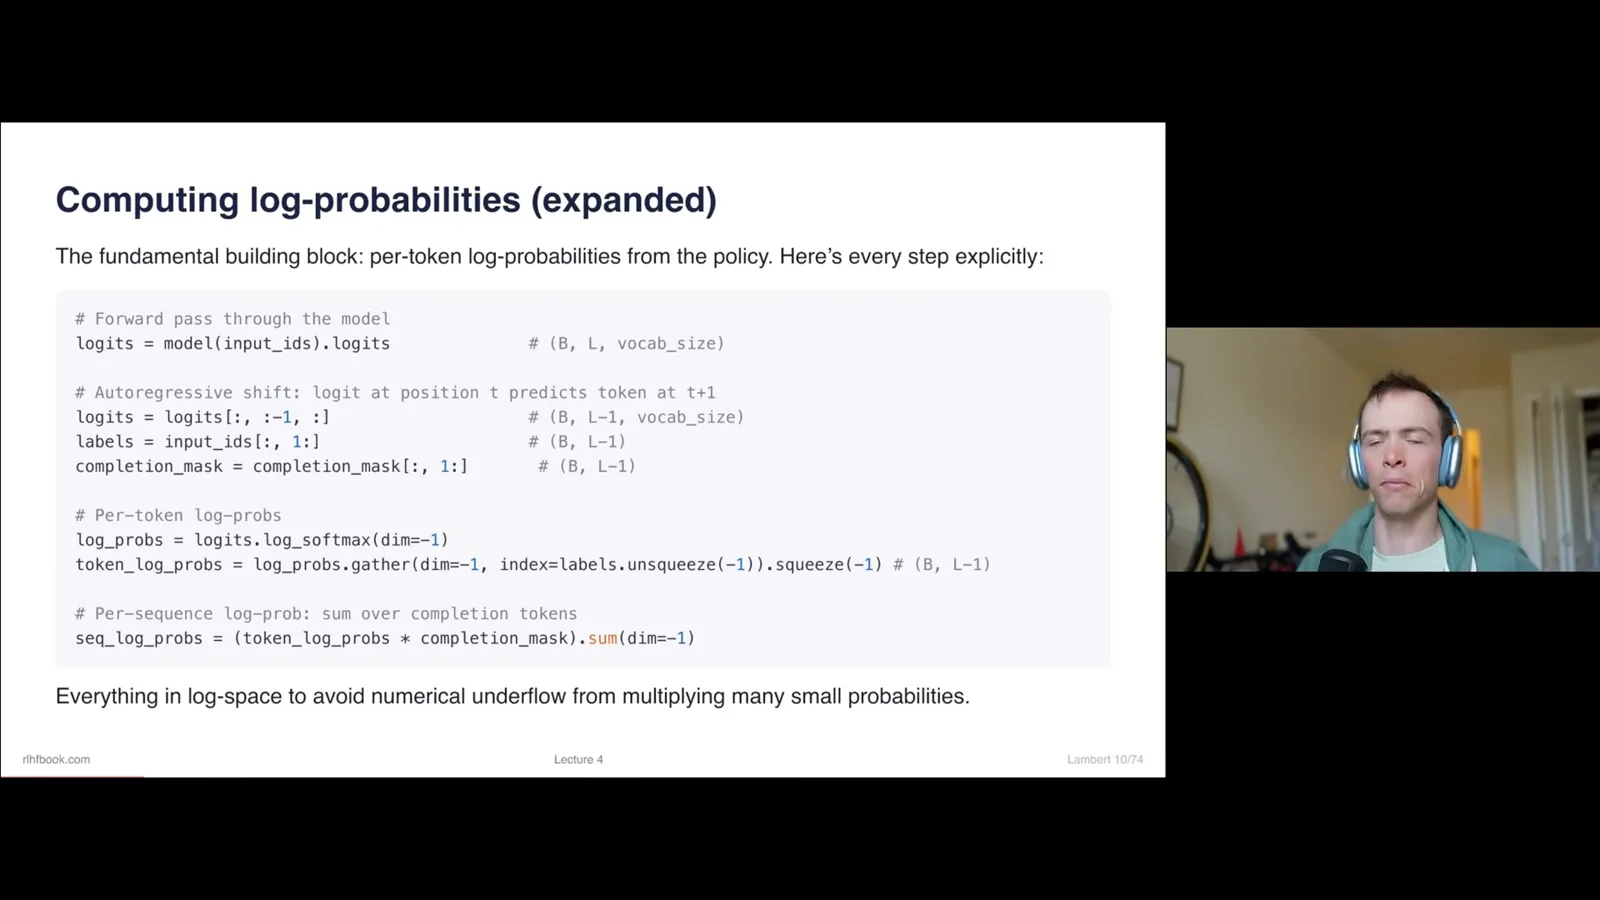
补全掩码让训练损失排除提示词 token。其他掩码处理填充或打包序列。在对数空间计算可以避免许多很小的概率相乘导致数值下溢,这项计算通常封装成可复用的辅助函数。
REINFORCE 使用奖励减去基线得到优势,再用优势加权序列对数概率。负号之所以出现,是因为强化学习目标需要最大化,而实现需要最小化损失。
REINFORCE 留一法为每个提示生成多个回答,并以其他回答的平均奖励作为基线。一种实现先求组内奖励之和,减去当前回答的奖励,再除以剩余数量。
PPO 实现
讲座介绍奖励塑形、GAE、裁剪的策略与价值损失、稳定性和调试。
PPO 加入裁剪的代理目标,并通常使用价值模型和广义优势估计。这使算法能在控制大幅变化的同时,多次利用收集的数据,但代价是更多模型、超参数和代码复杂度。
简化的 PPO 循环依次采样提示、生成回答、评分、计算参考策略的 KL 惩罚、塑形奖励并估计优势。随后在小批次上更新策略和价值模型,再收集更多数据。
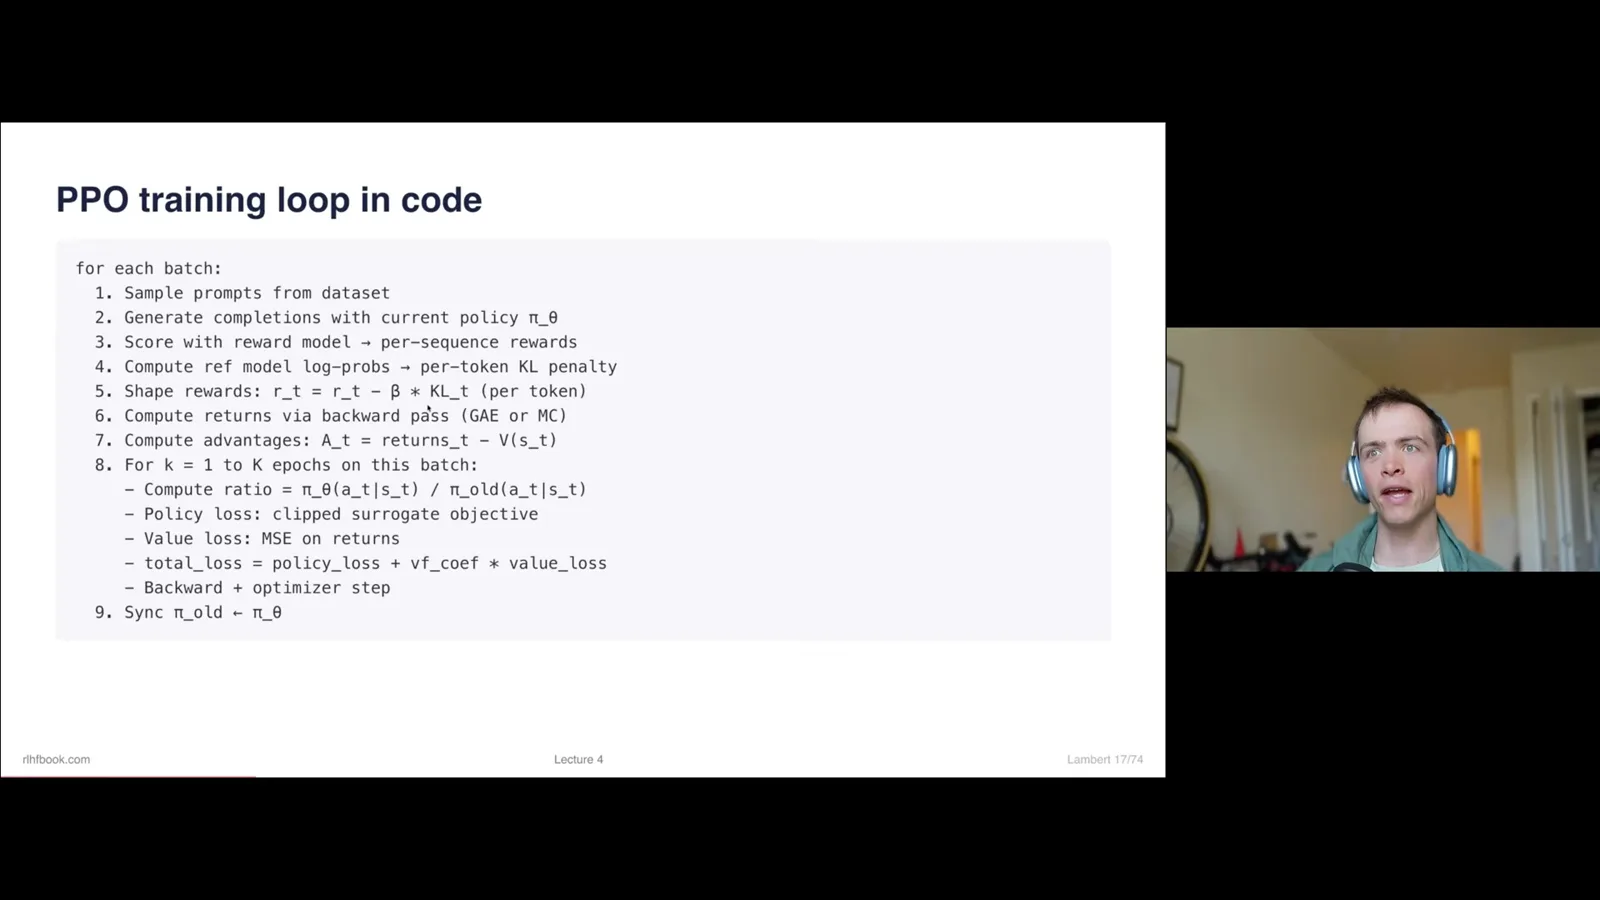
奖励放在何处取决于算法。在展示的 RLHF 设置中,奖励模型分数放在最后一个 token,逐 token KL 项用于塑造之前的奖励;GAE 向前回溯分配贡献。一些 GRPO 式 RLVR 实现则将结果优势广播到回答的各个 token。
PPO 批次需要 token ID、补全掩码、旧对数概率、旧价值估计,以及可能需要的参考模型概率和奖励。旧策略是当前批次开始时的策略;参考策略通常固定在整次强化学习运行的起点。
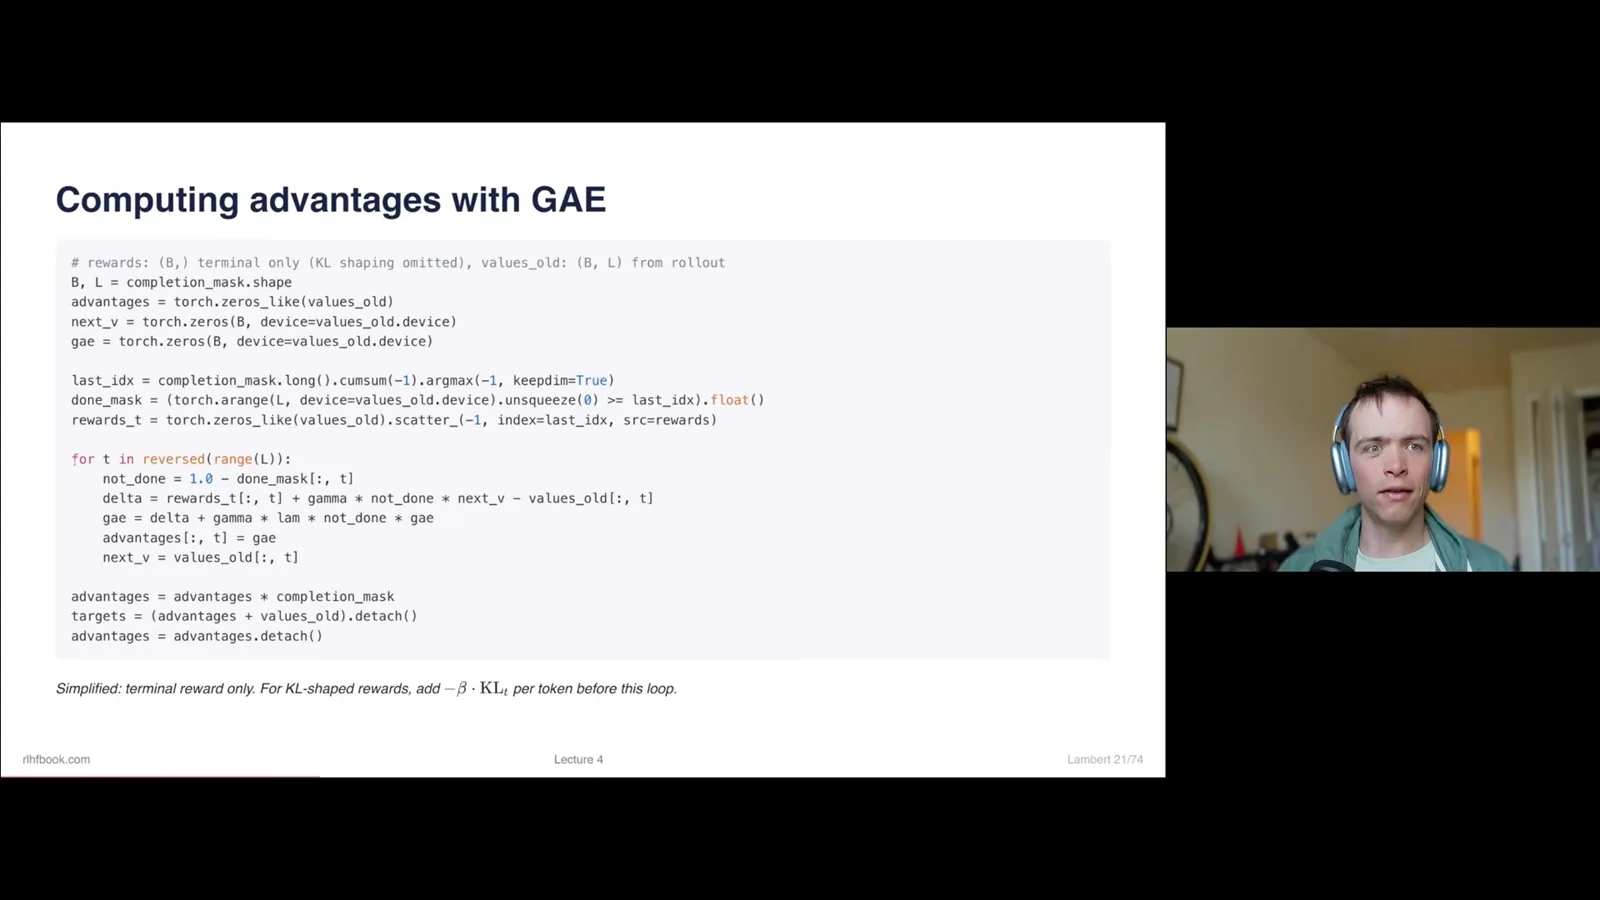
GAE 从每个序列的最后一个 token 向前回溯,估计逐 token 优势。由于批次中的序列长度不同,序列结束和 done 掩码很重要。价值目标由旧价值估计与优势构造,再从梯度中分离。
稳定计算 PPO 比值的方法是先用新对数概率减去旧对数概率,再对差值取指数。策略损失比较未裁剪和裁剪形式,然后对负损失取最大值,选择更保守的一项。
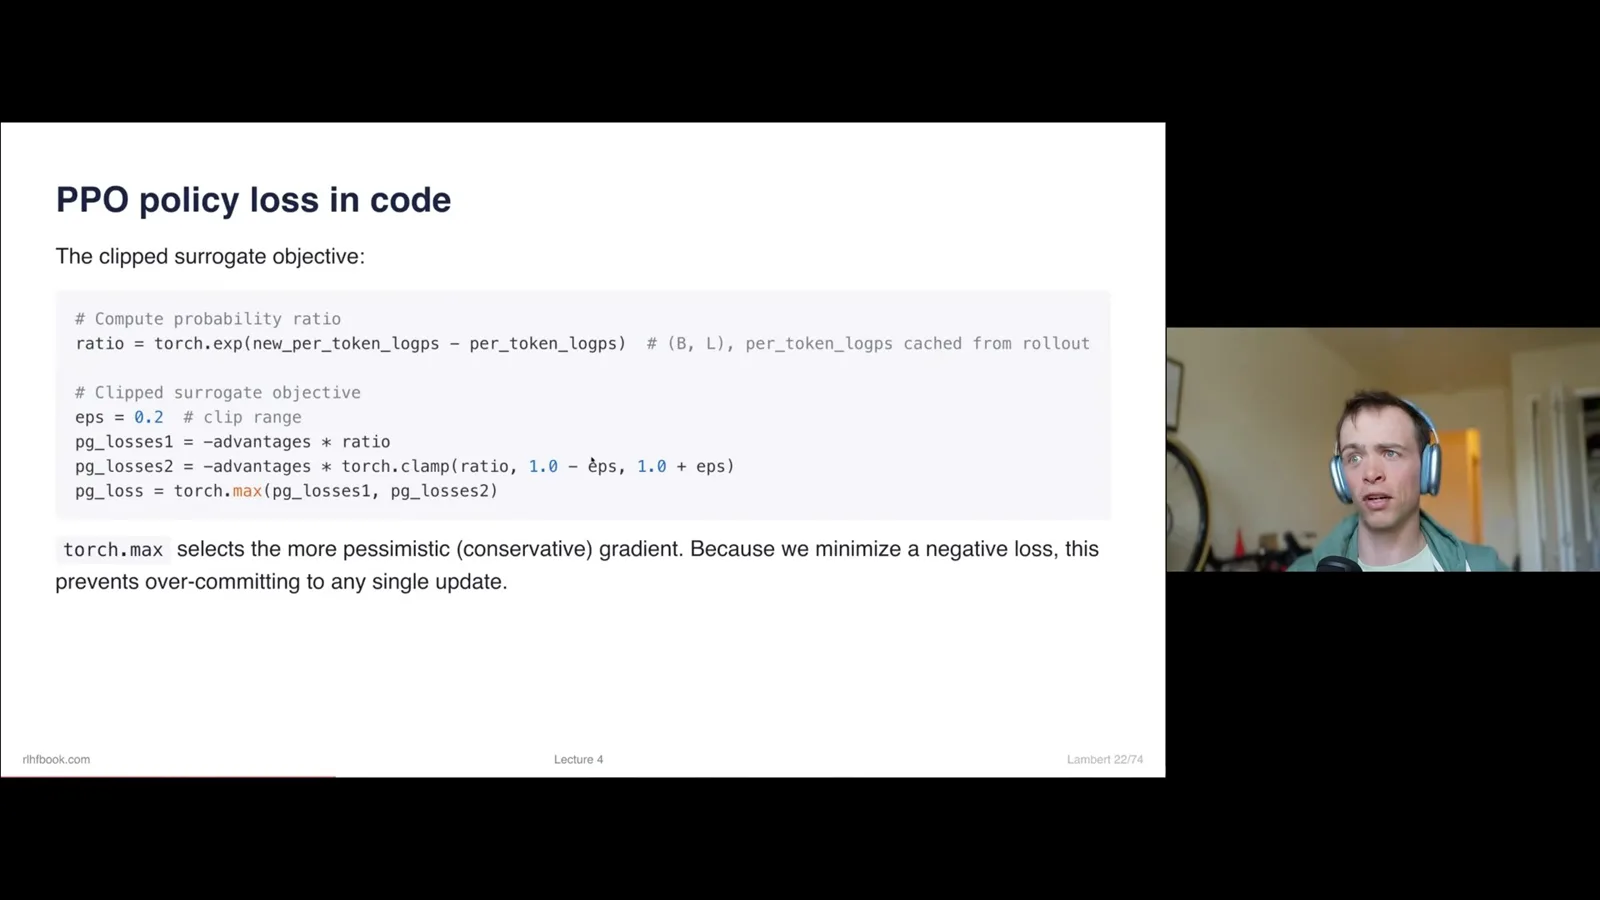
如果第一次更新时当前策略与旧策略相同,比值从一开始,裁剪不会触发。对同一批收集数据多次更新可能让差异增大。Lambert 在讨论这些机制时区分了小批次处理和重复遍历。
价值模型预测未来回报。基于观察回报和旧价值估计构造的目标,在更新价值模型时应视为固定。一些实现既使用裁剪的策略损失,也使用裁剪的价值损失,并对两者加权。
优势通常在批次内归一化,让更新尺度更加可预测。这无法解决所有稳定性问题,但能降低更新对优势尺度剧烈变化的敏感性。
为预训练语言模型初始化价值模型很困难。常见方法是在强模型上添加价值头,并在更新策略之前用奖励数据预热,因为初始价值预测可能很差。
PPO 有许多相互影响的设置:裁剪、GAE、价值损失权重、KL 系数、批次大小、学习率和更新次数。Lambert 建议从稳定方案开始,每次只改变一个因素。
更大的批次可以降低采样策略梯度估计的方差,但也需要更多资源。Lambert 除语言模型训练外,还提到了游戏和自动驾驶研究中的例子。
需要监控裁剪比例、优势变化、价值损失和 KL 散度。过度裁剪可能压制学习信号;价值损失无法改善可能表明 critic 有问题;KL 快速爆炸可能意味着训练不稳定。
实现错误包括把提示词 token 纳入训练、奖励索引错误,以及混淆旧策略和参考策略。除了优化器状态和激活值,PPO 还可能需要同时在内存中保存多个大型模型。
GRPO 及相关算法
组相对优势简化了训练循环。Lambert 比较 KL 处理、留一法基线和其他变体。
GRPO 对同一个提示采样多个回答,再根据组内结果计算优势,以此取代价值模型和 GAE。常见形式仍保留类似 PPO 的裁剪损失,但所需组件大幅减少。
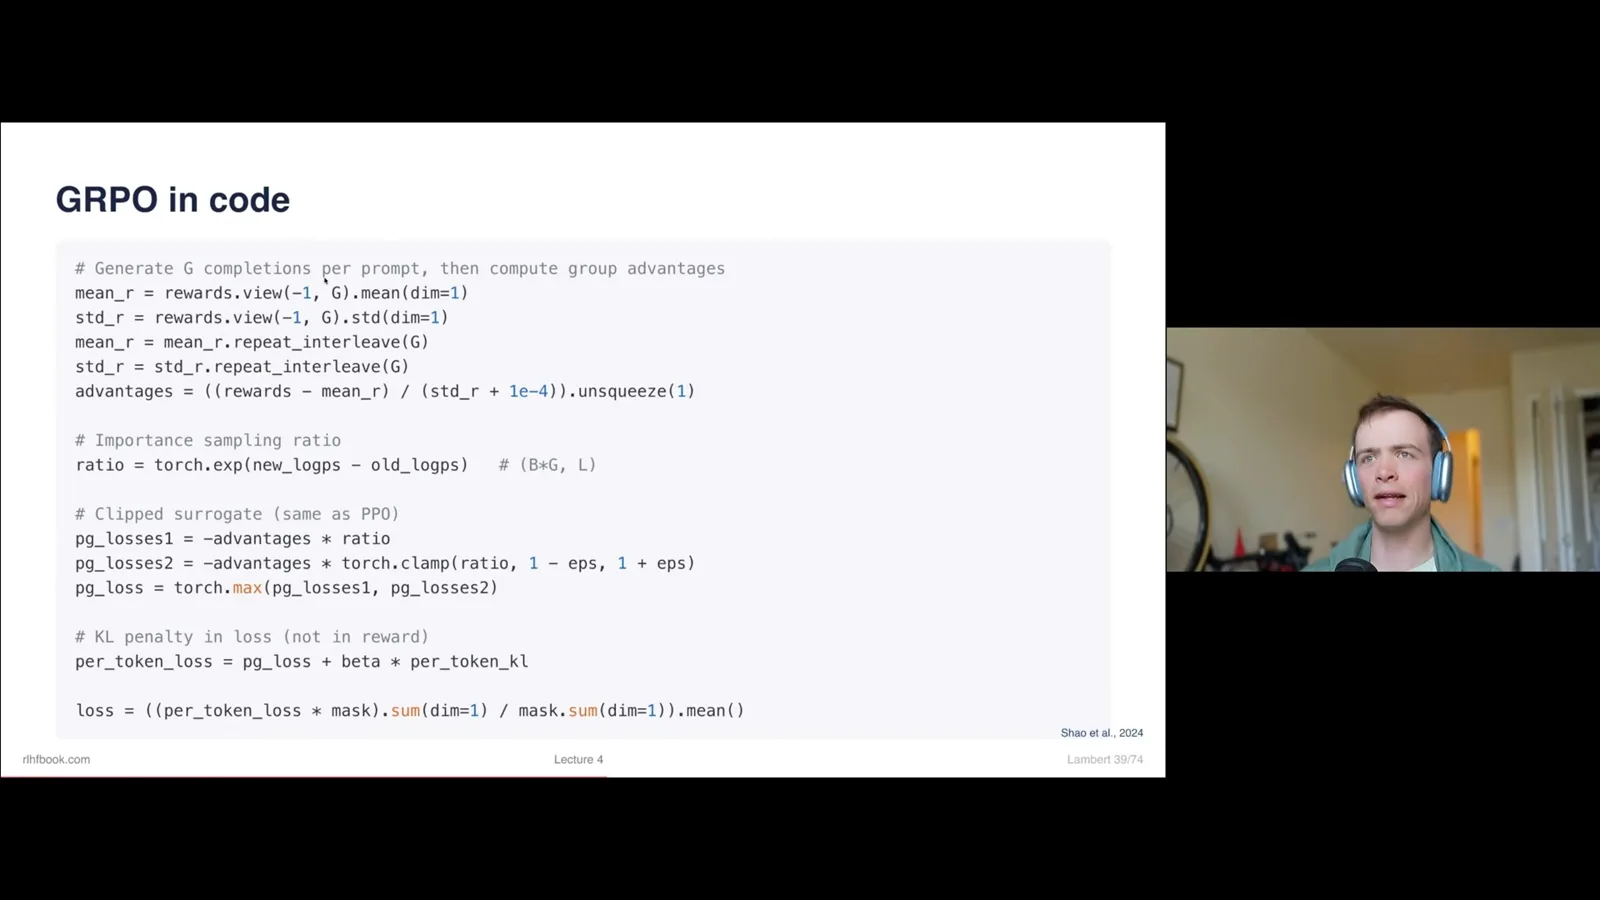
在 Lambert 比较的例子中,RLHF 的 PPO 用 KL 塑造奖励,而 GRPO 在逐 token 损失中直接应用 KL。这些是实现选择,并非不可改变的定义;GRPO 的优势可以广播到整个回答。
REINFORCE 留一法和 GRPO 有相同的组比较直觉,但基线或归一化方式以及损失不同。GSPO 和 CISPO 等相关算法修改比值或裁剪计算,以改善大规模训练的稳定性。
基础设施与工程
异步 actor 和 learner 让生成与训练重叠。数值精度、掩码和分离的目标值需要仔细处理。
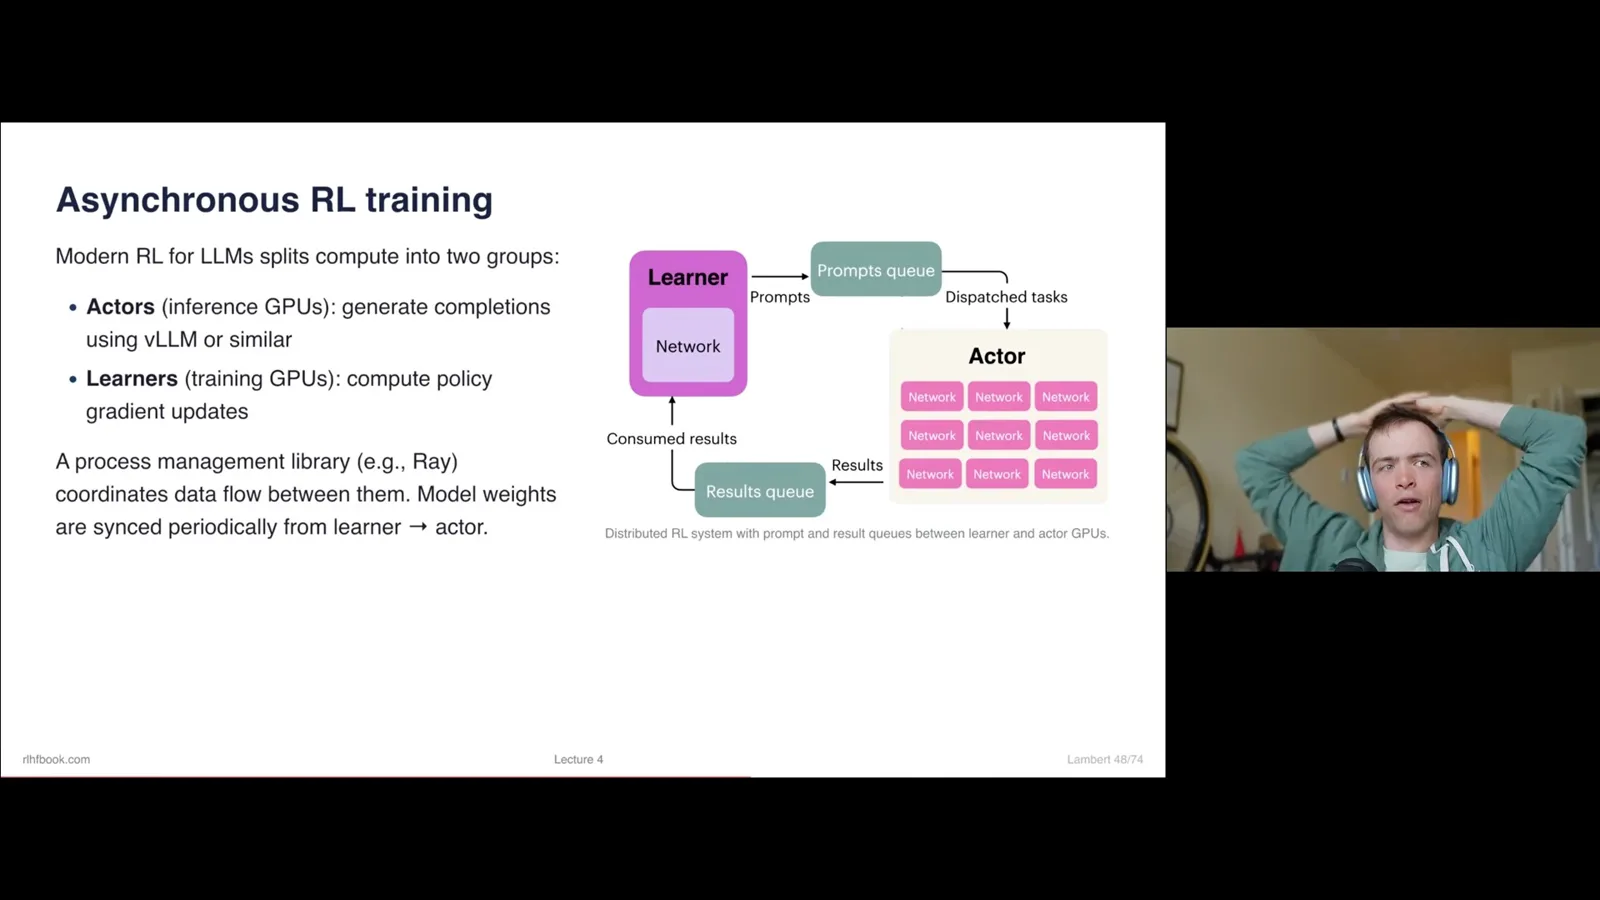
严格交替生成和更新可能让加速器闲置。大规模训练中,单独的 actor GPU 生成回答,learner GPU 同时训练,使两个阶段重叠。实际系统以完全同步换取吞吐量,因此需要处理权重滞后。
提示词队列向 actor 分发工作,结果队列将轨迹返回 learner。Learner 的权重定期同步给 actor。Lambert 推荐查看 Open Instruct、TRL 等开放框架中的实现细节。
数值和数据错误可能悄悄破坏训练:稳定计算对数概率,正确对齐 EOS 与填充掩码,在适当位置分离目标和中间变量的梯度,并防止除以零。这些细节往往决定一次训练能否正常运行。
损失聚合与监控
按序列或 token 归一化会改变长度权重。Lambert 回顾监控指标和奖励利用。
逐 token 损失如何聚合会改变训练动态。语言模型强化学习常常为每个回答提供一个结果奖励,却使用逐 token 损失,把类似赌博机问题的结果与一系列模型动作结合起来。
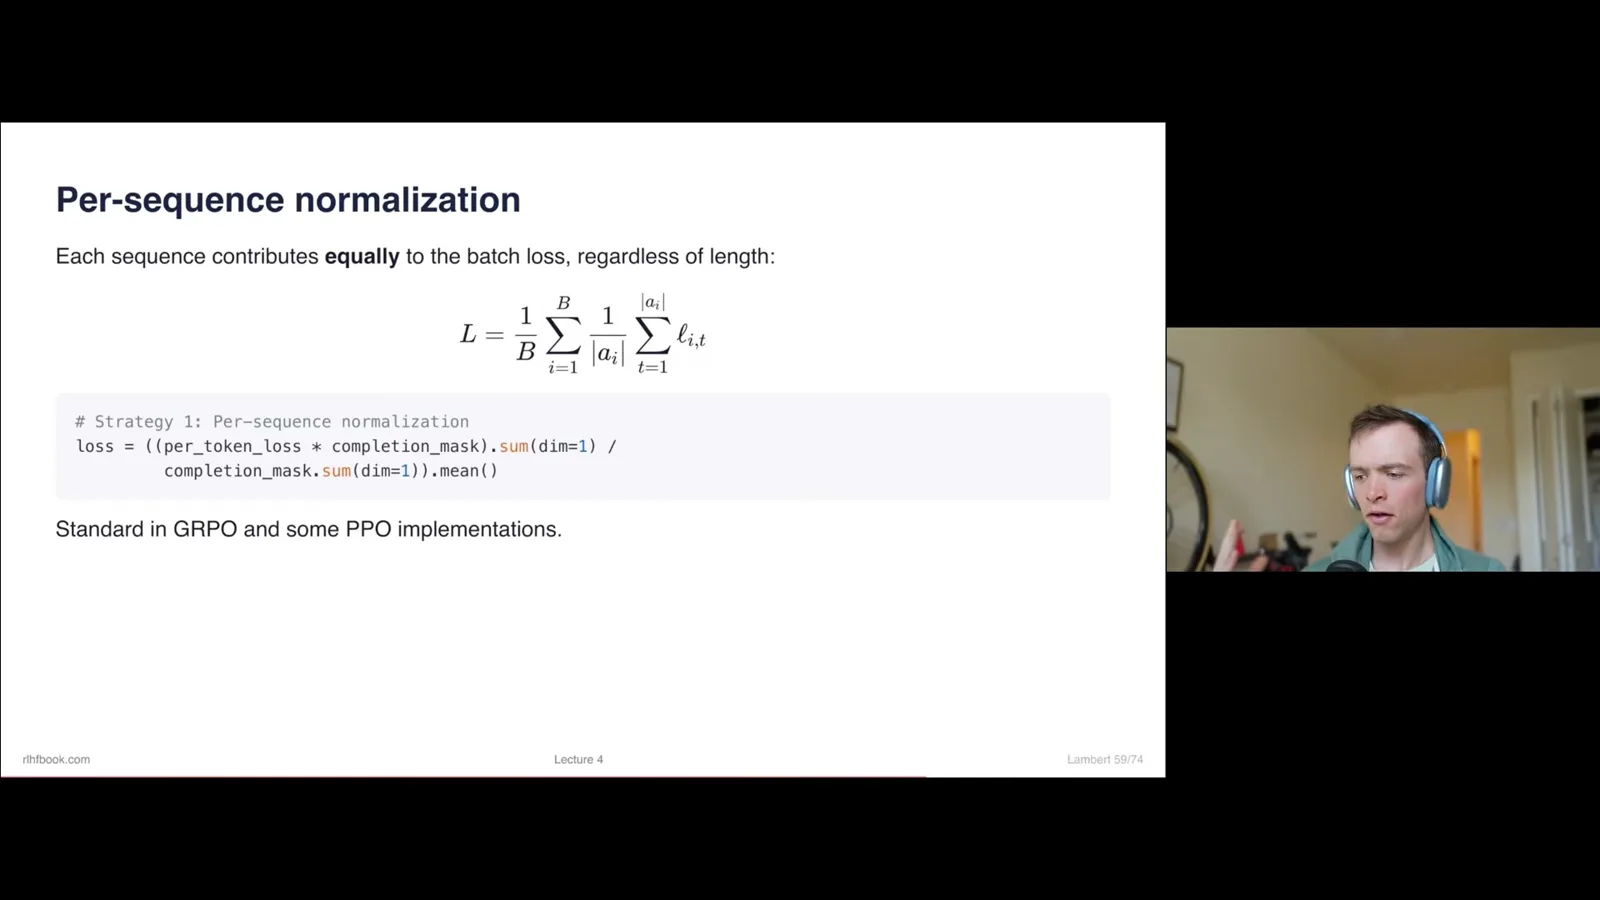
按序列归一化先在每个回答内部求平均,再对批次求平均,使每个序列的总权重相同。当两个回答长度不同时,较短回答中的单个 token 会获得更大权重。
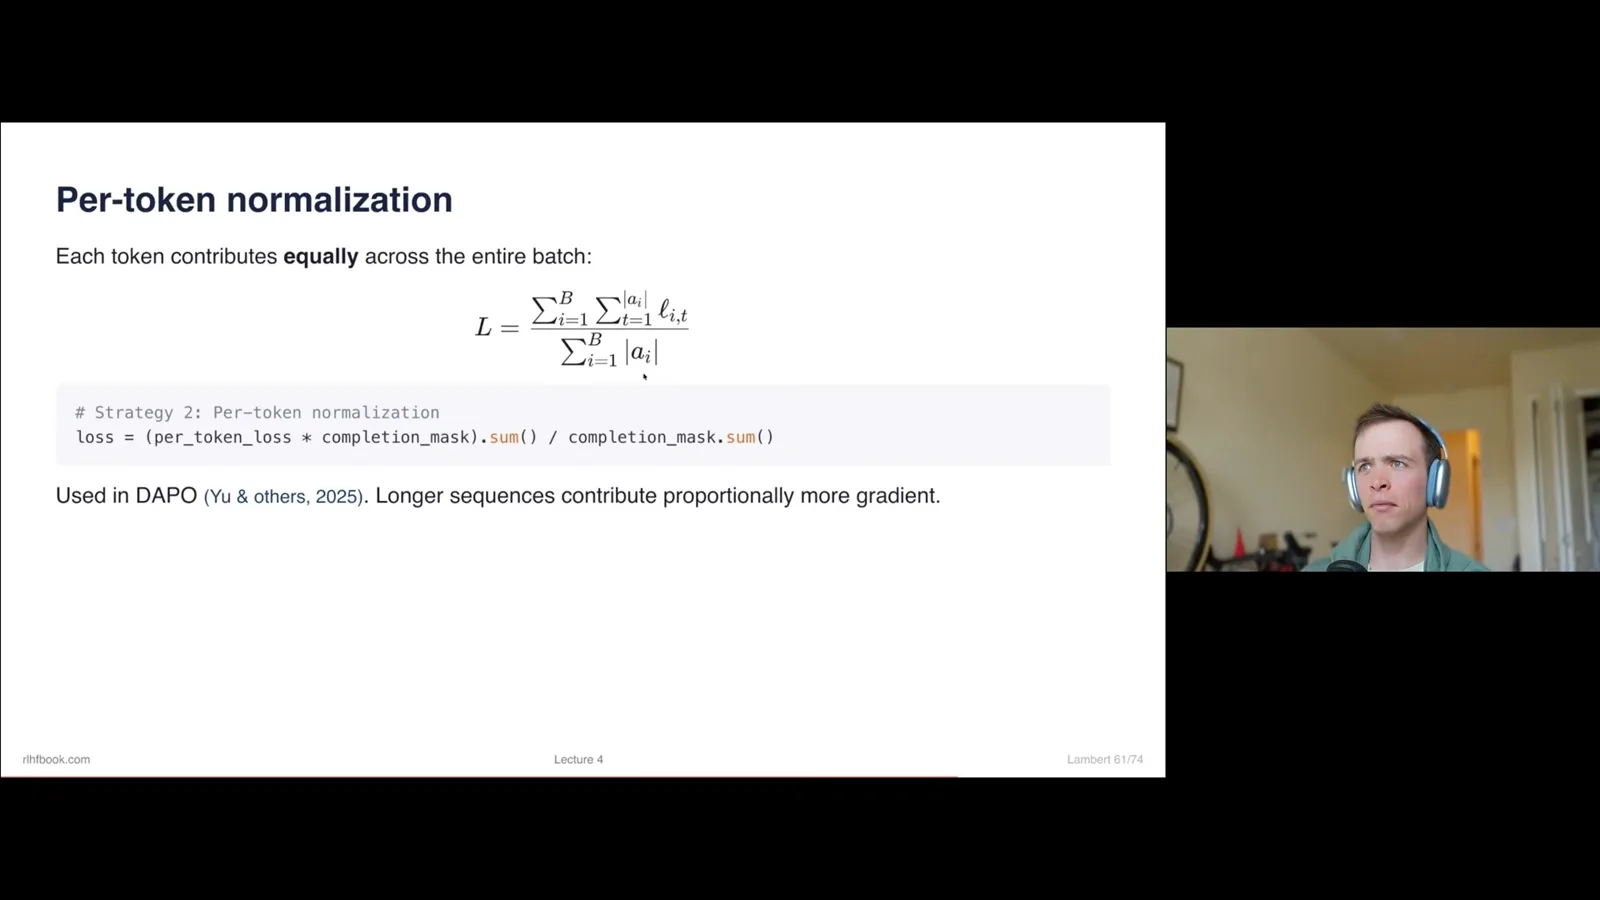
按 token 归一化则让批次中每个有效 token 权重相同,因此较长序列按比例贡献更多。DAPO 让这种选择在推理训练中受到广泛关注;它改变的是长度偏差,而非消除所有可能偏差。
Dr. GRPO 讨论的固定长度归一化是另一种缩放选择。Lambert 指出,它与按 token 归一化之间的关系可能涉及损失尺度因子,而这个因子会与学习率选择和训练动态相互作用。
训练期间应检查奖励、KL、裁剪、损失尖峰、生成长度和策略熵。即使是可验证奖励也可能被利用:有缺陷的检查器可能奖励非预期的捷径。稳定的指标和正确设定的评估都必不可少。
讲座最后列出书籍、代码和相关论文。Lambert 邀请观众就不清楚的实现细节提问,并计划在后续课程介绍推理和直接偏好优化。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。