30 秒看懂
这段经过剪辑的集锦收录了 2024 年 5 月 14 日 Google I/O 的演讲。Sundar Pichai、Demis Hassabis 和其他 Google 演讲者介绍 Gemini、演示研究原型,并概述产品与开发者计划。 展示混合了预览功能、计划发布的产品、假设性工作流程和经过编排的演示。其时间和主张反映的是 2024 年活动背景,而非当前产品指南。
- 1分阶段扩大上下文Gemini Advanced 用户获得了 35 种语言的百万 token 上下文访问;Google 宣布更大的窗口将首先限制访问。
- 2作为研究原型的 AstraGoogle 展示了一个基于摄像头的助手,能够识别物体、解读代码并记住眼镜的位置。
- 3Gmail 中的 Gemini屋顶维修示例通过邮件摘要、报价比较和上下文回复展示了拟议的移动端工作流程。
- 4虚拟队友Chip 原型搜索项目对话以回答问题,Google 同时承认在将此类智能体引入 Workspace 前还有工作要做。
- 5模拟诈骗提醒设备端演示展示了 Gemini Nano 在一场经过编排的银行诈骗电话中发出警告。
- 6开放权重开发者模型Google 推出了 PaliGemma,并宣布计划推出 270 亿参数的 Gemma 2 模型。
要点建议
- Google 将 Gemini 1.5 Flash 介绍为比 Pro 更轻量、延迟更低的模型,并分阶段扩大长上下文访问。
- Project Astra 通过精选实时演示展示了多模态助手原型。
- Google 展示了 Gemini 如何可能帮助处理邮件、文档、视频和可重复使用的自定义指令。
- Imagen 3、Music AI Sandbox 和 Veo 通过精选示例展示了 Google 的生成式媒体工作。
- Android 演示结合了上下文感知辅助功能和设备端诈骗提醒情景。
- 开发者公告包括 Gemini API 功能、PaliGemma 和计划推出的更大规模 Gemma 2 模型。
按章节阅读整理后的全文
Gemini 与长上下文体验
Pichai 介绍多模态 Gemini 和 2024 年上下文窗口的扩展。早期 NotebookLM 音频演示展示了一种可能的教育用途。
在 Google I/O 2024 上,CEO Sundar Pichai 将 Gemini 描述为能够处理不同类型信息的模型。他说已有超过 150 万开发者在使用这些模型,并介绍了 Search、Photos、Workspace、Android 和 Gemini 应用中的示例。这段视频是 Google 2024 年 5 月演讲的剪辑集锦,公告和承诺日期都属于历史信息。
Pichai 表示 Ask Photos 将于当年夏天推出,后续会加入更多功能。他更广泛的观点是,多模态模型能够跨不同格式关联信息,而不是将每项输入视为孤立任务。
Gemini 1.5 Pro 的百万 token 上下文窗口开始向使用 35 种语言的 Gemini Advanced 用户开放。Pichai 还宣布将窗口扩大至 200 万 token。Google 的开发者公告将 200 万 token 版本列入候补名单,因此不应理解为当时已全面开放。
Josh Woodward 使用牛顿定律材料演示早期 NotebookLM 音频功能。两个生成声音之间的对话解释力和运动;随后 Woodward 为儿子请求一个篮球例子。屏幕注明音频是预先生成的,这只是演示,不能证明交互总能以这种方式运作。
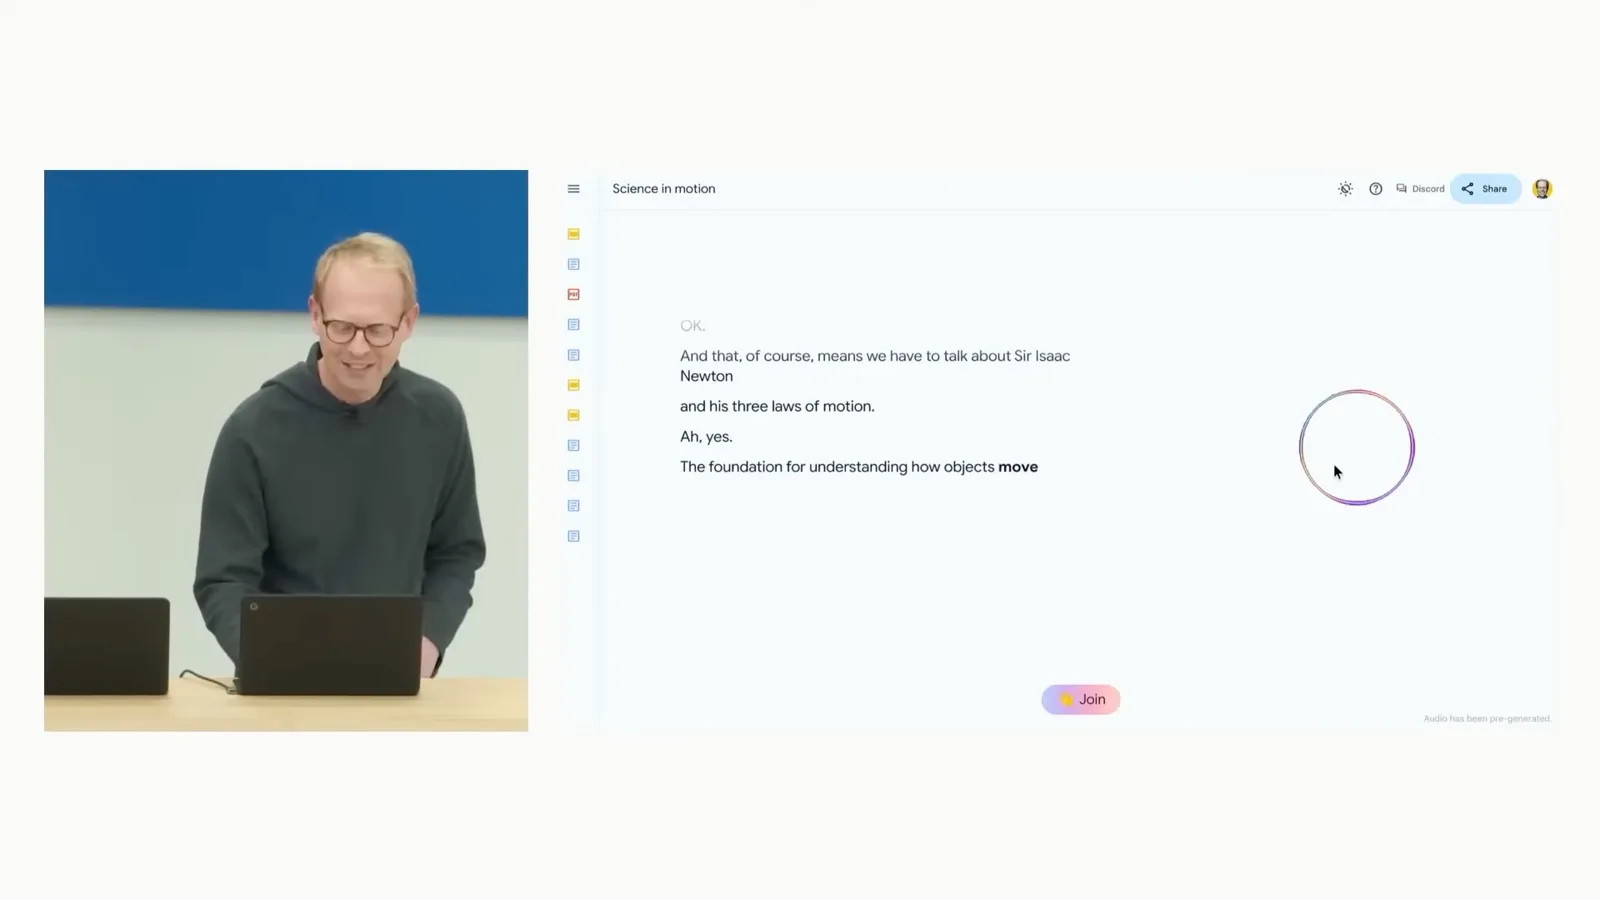
Pichai 将这类交互与混合输入和输出格式的更广泛愿景联系起来。随后他将 AI 智能体定义为具有推理、规划和记忆能力、能够跨软件代表用户完成多步骤任务的系统。
智能体、Flash 与 Project Astra
Google 描述一个假设性的购物智能体,并推出更轻量的 Flash 模型。Project Astra 展示基于摄像头的交互和记忆。
他的购物例子是假设性的:未来智能体可能不需要用户手动退回不合脚的鞋,而是从邮件中找到收据和订单号、填写退货表并安排取件。这个例子说明了目标工作流程,而非宣布已有完成的产品。
Google DeepMind CEO Demis Hassabis 介绍 Gemini 1.5 Flash,称它比 Pro 更轻量,面向延迟更低、成本更低的应用,同时保留多模态和长上下文能力。其设计取舍在于高效的大规模服务,并非声称一个模型适合所有任务。
Hassabis 随后介绍 Project Astra,这是 Google 为更通用助手研发的原型。目标是让智能体理解并记住所见内容、回应不断变化的环境并自然对话。Google 播放了一段分为两部分的视频,并称每一部分都以一次实时拍摄完成。
第一部分中,演示者用摄像头观察房间。原型识别出扬声器和高音单元,为蜡笔创作头韵句,描述屏幕上的代码,并猜测位于伦敦 King’s Cross 一带。当被问到在哪里看到用户的眼镜时,它记起眼镜在一张靠近红苹果的桌子上。
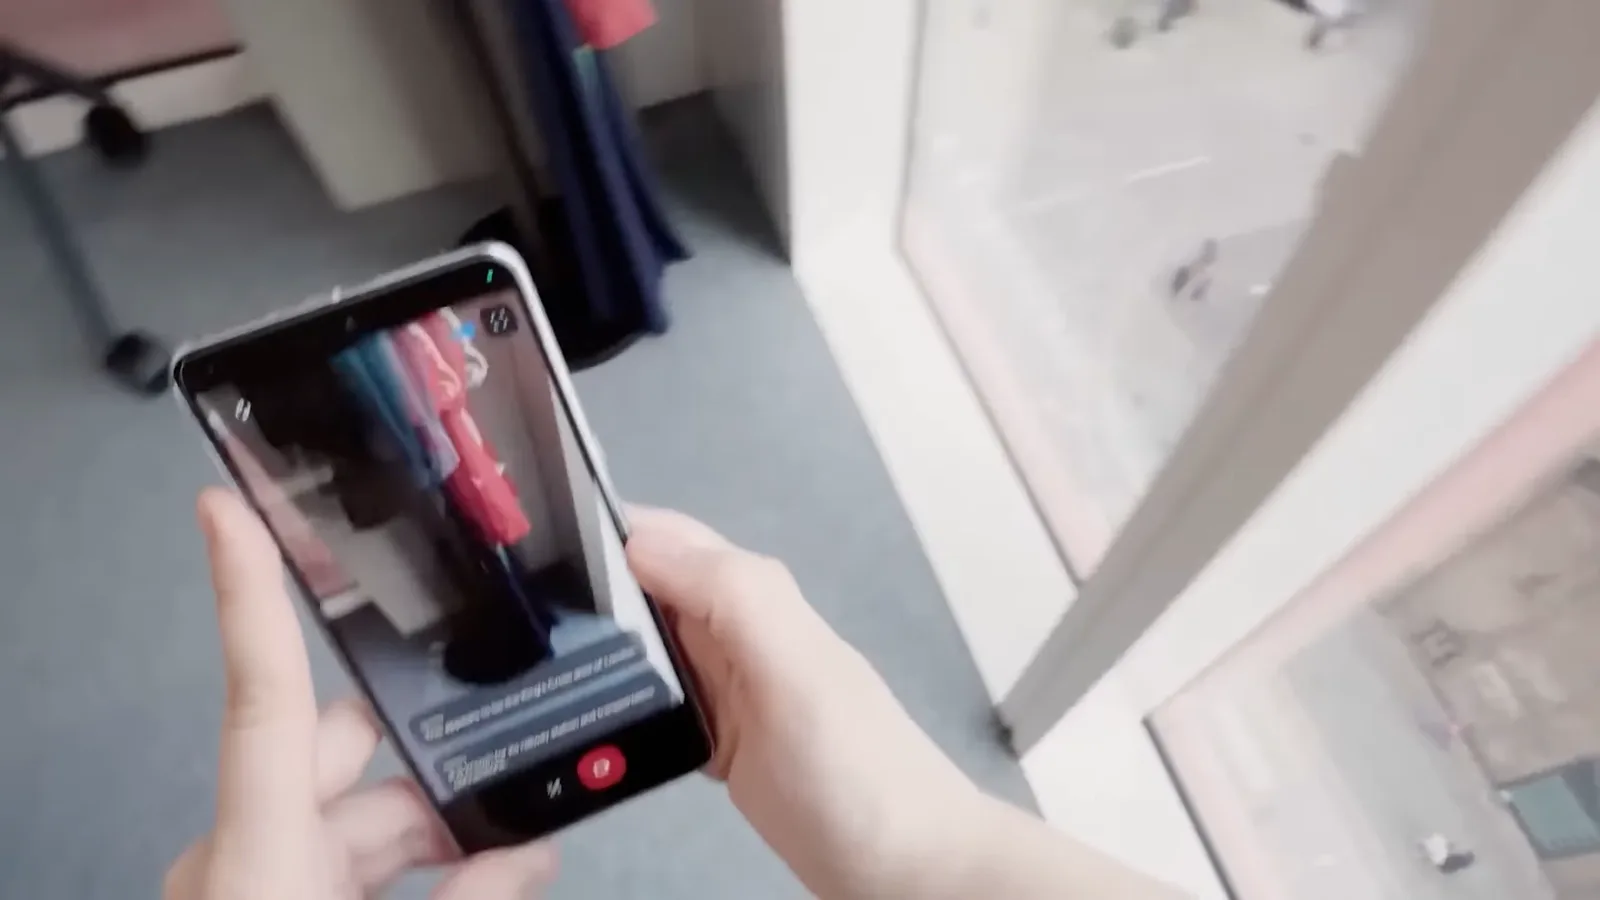
演示继续展示一个系统图:Astra 建议在服务器和数据库之间加入缓存。它还回应绘画内容并提出乐队名称。这些精选示例展示了研究原型的方向,不能证明它在任意环境中都可靠。
图像、音乐、视频与基础设施
演讲者展示 Imagen 3、Music AI Sandbox 和 Veo。Google 还宣布了 Trillium TPU。
一位 Google 演讲者介绍 Imagen 3,称其在照片真实感、细节、遵循提示词和减少视觉瑕疵方面有所改进。他说独立评估者在一些并排比较中更喜欢它,并邀请观众报名 ImageFX;开发者和企业访问也在计划中。偏好说法是 Google 对这些比较的描述,并非普遍排名。
Google 还介绍了与 YouTube 和艺术家共同打造的 Music AI Sandbox,用于探索专业音乐工具,包括生成器乐片段和迁移风格。演讲将其描述为开发中的创作工具,艺术家参与塑造其使用方式。
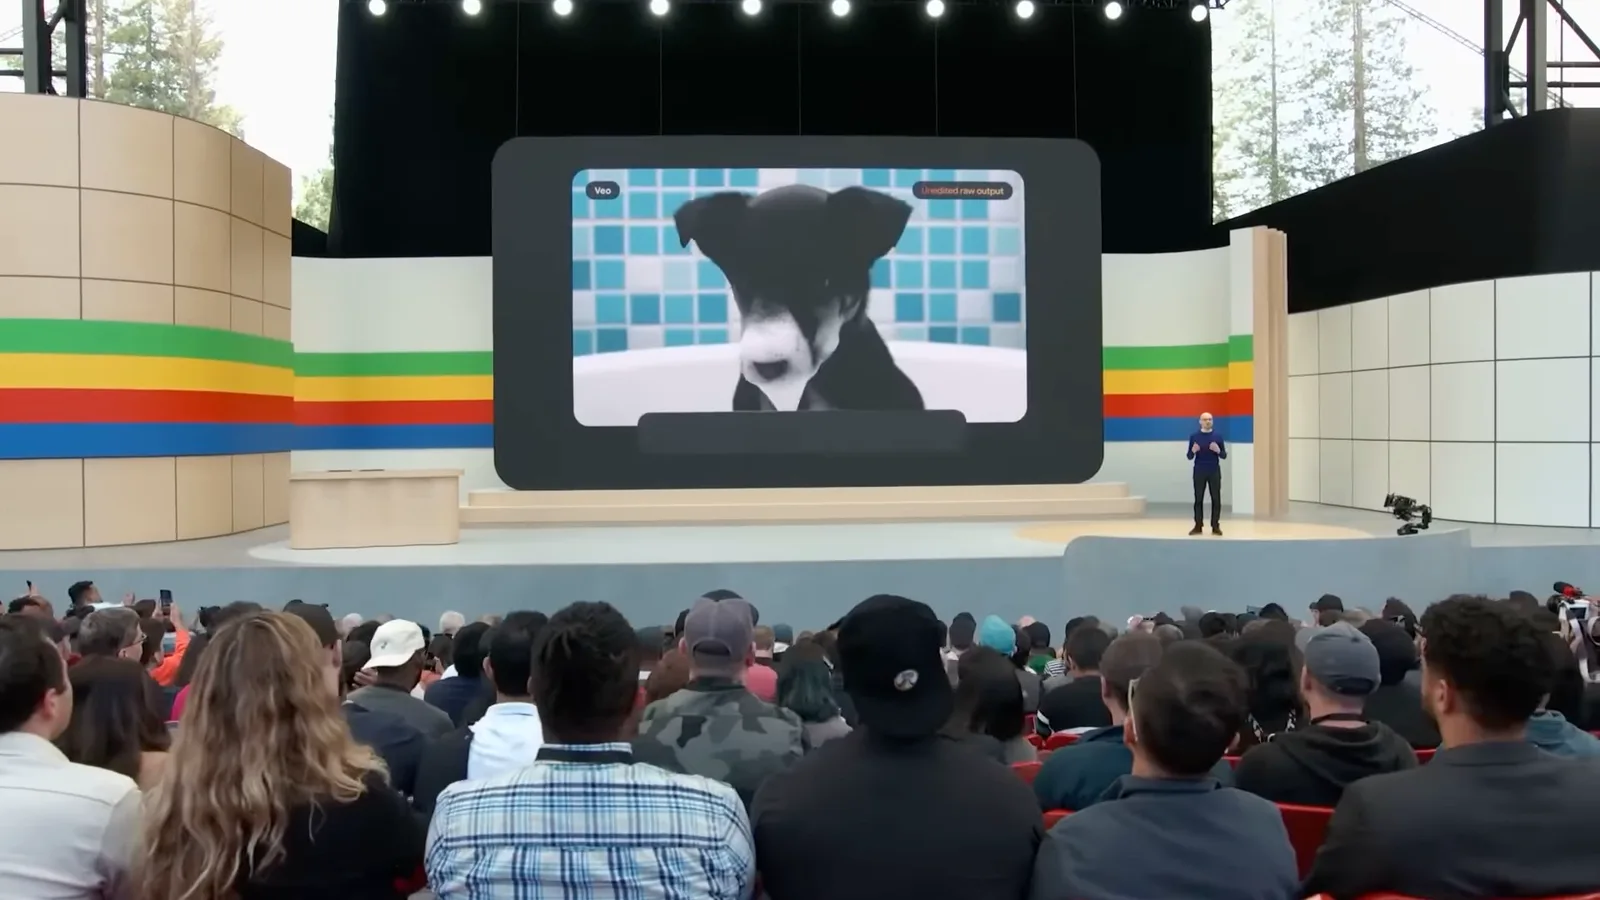
演讲者宣布 Veo,这是一个生成视频模型。Google 表示它可以根据文本、图像或视频提示生成 1080p 视频,遵循航拍或延时摄影等电影化指令,并通过提示词进一步编辑。播放的片段是精选演示,不能保证每个请求都能得到同样的结果。
Google 宣布了第六代 TPU Trillium。公司称其每芯片峰值计算性能比 TPU v5e 提高 4.7 倍,并预计 2024 年底提供云端访问;这一数字针对特定硬件比较,并不代表所有工作负载都会加速相同倍数。
面向 Workspace 的 Gemini
Gmail 示例总结邮件串、比较报价并起草回复。Chip 原型展示了团队工作中可能使用的虚拟队友。
Workspace 部分表示,Gemini 驱动的侧边栏计划于次月正式开放。Google 还强调自动语言检测和实时会议字幕扩展至 68 种语言,随后介绍 Gmail 移动端拟议的 Gemini 1.5 Pro 功能。
在屋顶维修示例中,演讲者打开一个很长的邮件串,用摘要卡找到承包商报价。她无需手动搜索各封邮件,而是让 Gemini 按价格和可用时间比较报价;展示的回复汇集了不同邮件串中的细节。
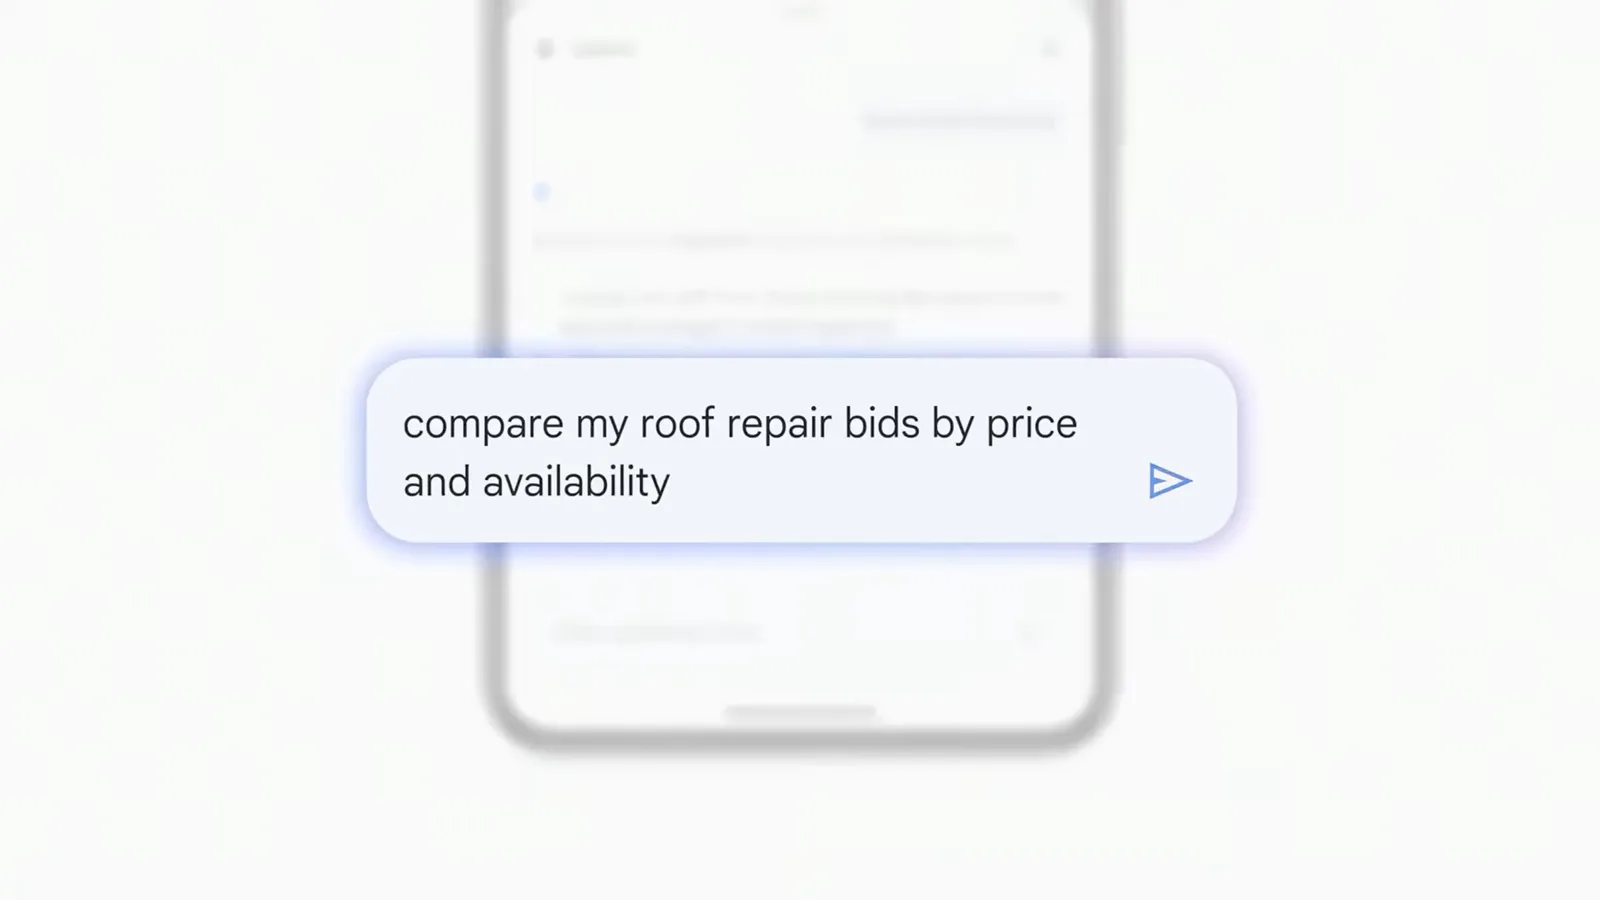
演讲者选择一位承包商并展示上下文智能回复。Gemini 根据邮件串提供回复选项,让她在发送前预览完整草稿。Google 表示这些 Gmail 功能将于当月开始向 Labs 用户推出;这是 2024 年的发布计划,不代表当前可用情况。
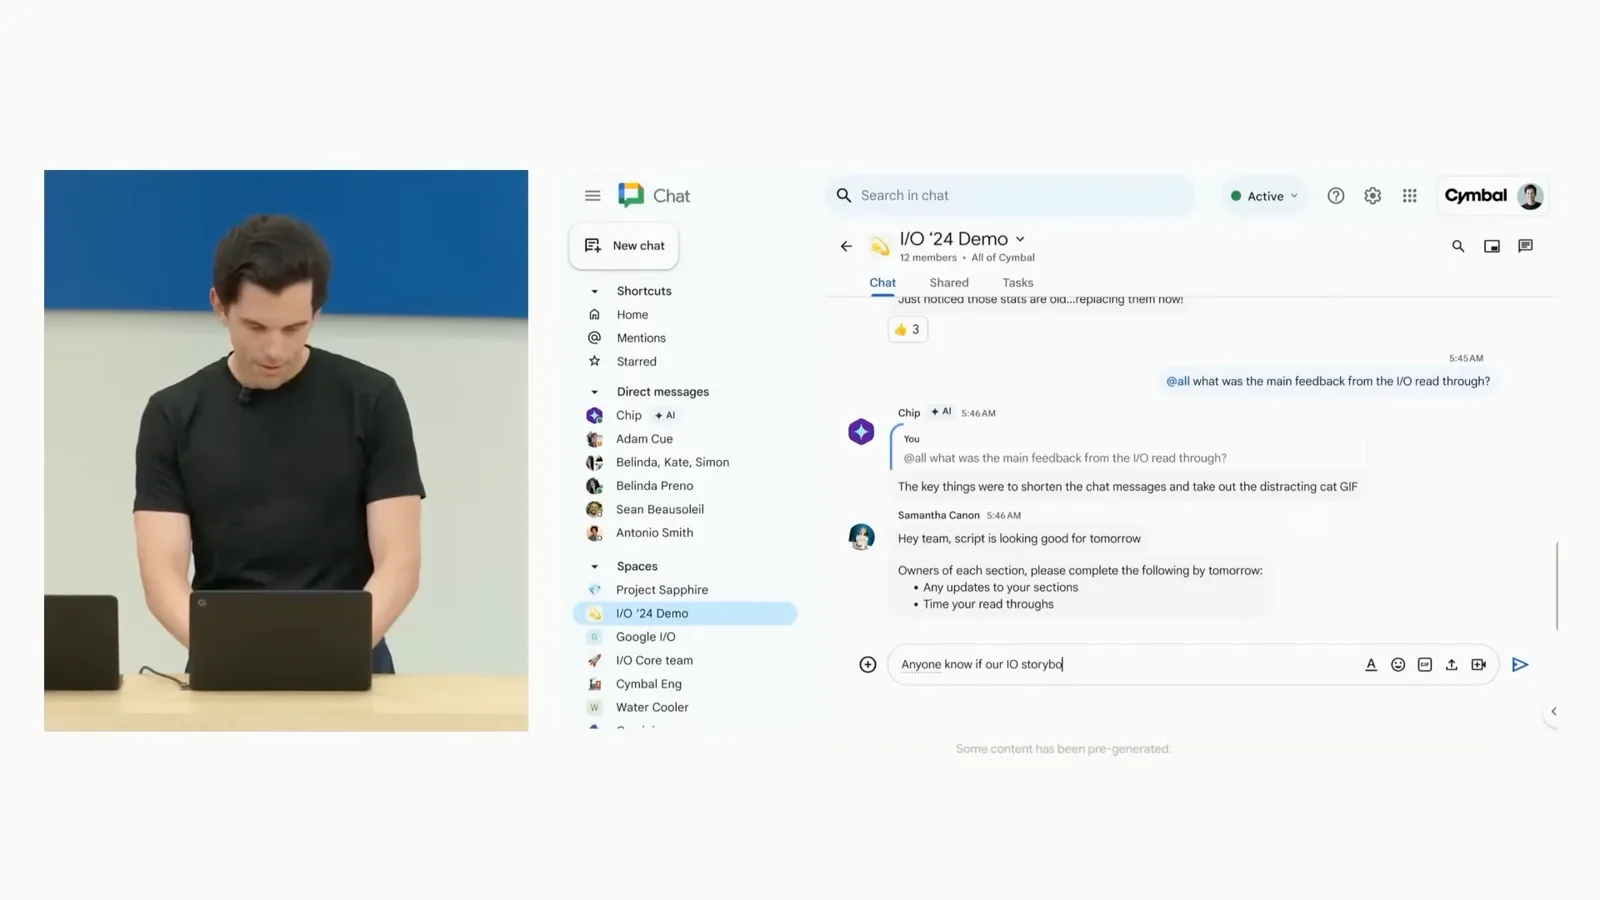
展望 2025 年及以后,Google 展示了名叫 Chip 的虚拟队友原型。在 Google Chat 中,Tony 询问 I/O 故事板是否已获批准;Chip 搜索它被指定跟踪的对话并回答。演讲称,队友加入更多聊天、文件和邮件串后可以积累上下文,同时承认还有大量工作要做。
Gemini 应用与 Android
Google 概述对话式 Live 和可定制的 Gems。Android 演示使用了一段视频、一份 PDF 和一通模拟诈骗电话。
Gemini 应用演讲围绕文本、语音和摄像头输入来描述个人助手。Google 宣布 Gemini Live 将于当年夏末推出,提供更自然的语音对话和打断能力;它还计划将 Astra 的速度和视频理解能力带入应用。
Google 提议让用户在实时对话中打开摄像头,以便 Gemini 回应周围环境。它还介绍了 Gems:可重复使用的自定义指令,例如专门指导短篇小说写作的教练。Gems 当时被描述为将在未来几个月推出,受信任测试者已经开始试用。
Android 部分介绍了将 AI 引入操作系统的多年计划:更便捷的 AI 搜索、作为助手的 Gemini,以及用于更快、更注重隐私体验的设备端模型。演讲者关于隐私的说法描述的是 Google 的目标和架构,而非对所有数据处理方式的全面保证。
Dave 演示了系统级 Gemini:他在消息中收到一段匹克球视频。由于用户正在观看 YouTube,Gemini 提供了“询问此视频”操作。他询问两次落地规则后得到简短解释,YouTube 字幕是使用的信号之一。
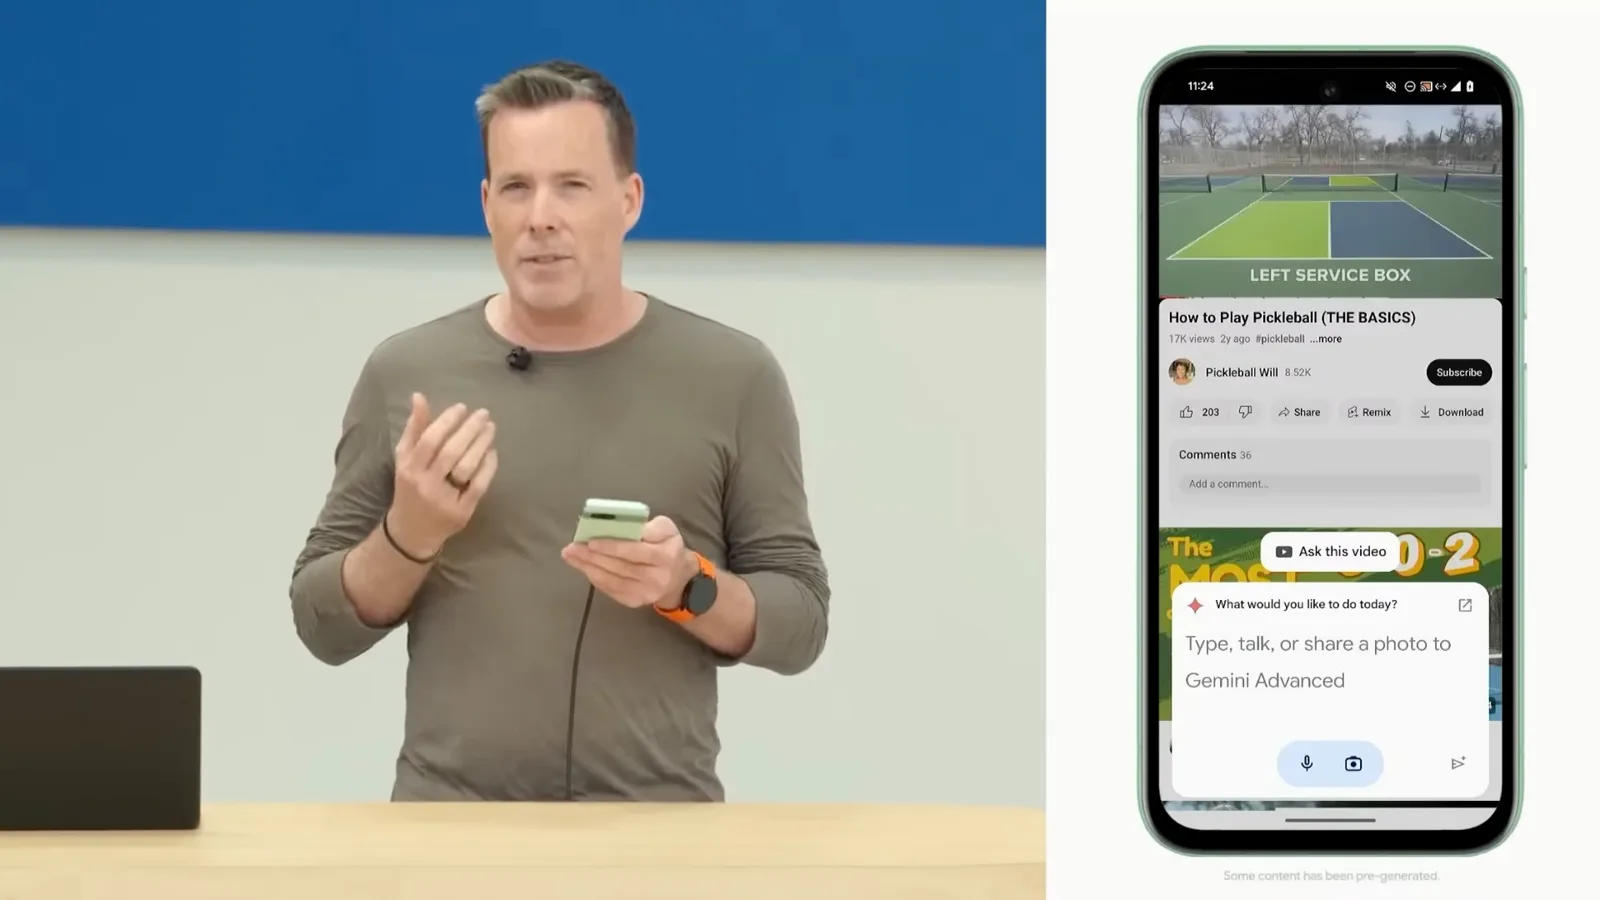
接着他打开一份 84 页的匹克球规则 PDF。Gemini 提供“询问此 PDF”操作,回答有关旋转发球的问题并指向文档中的来源。演讲使用的是特定文档和示例;答案应与相关规则及版本核对,不能推广到所有形式的旋转。
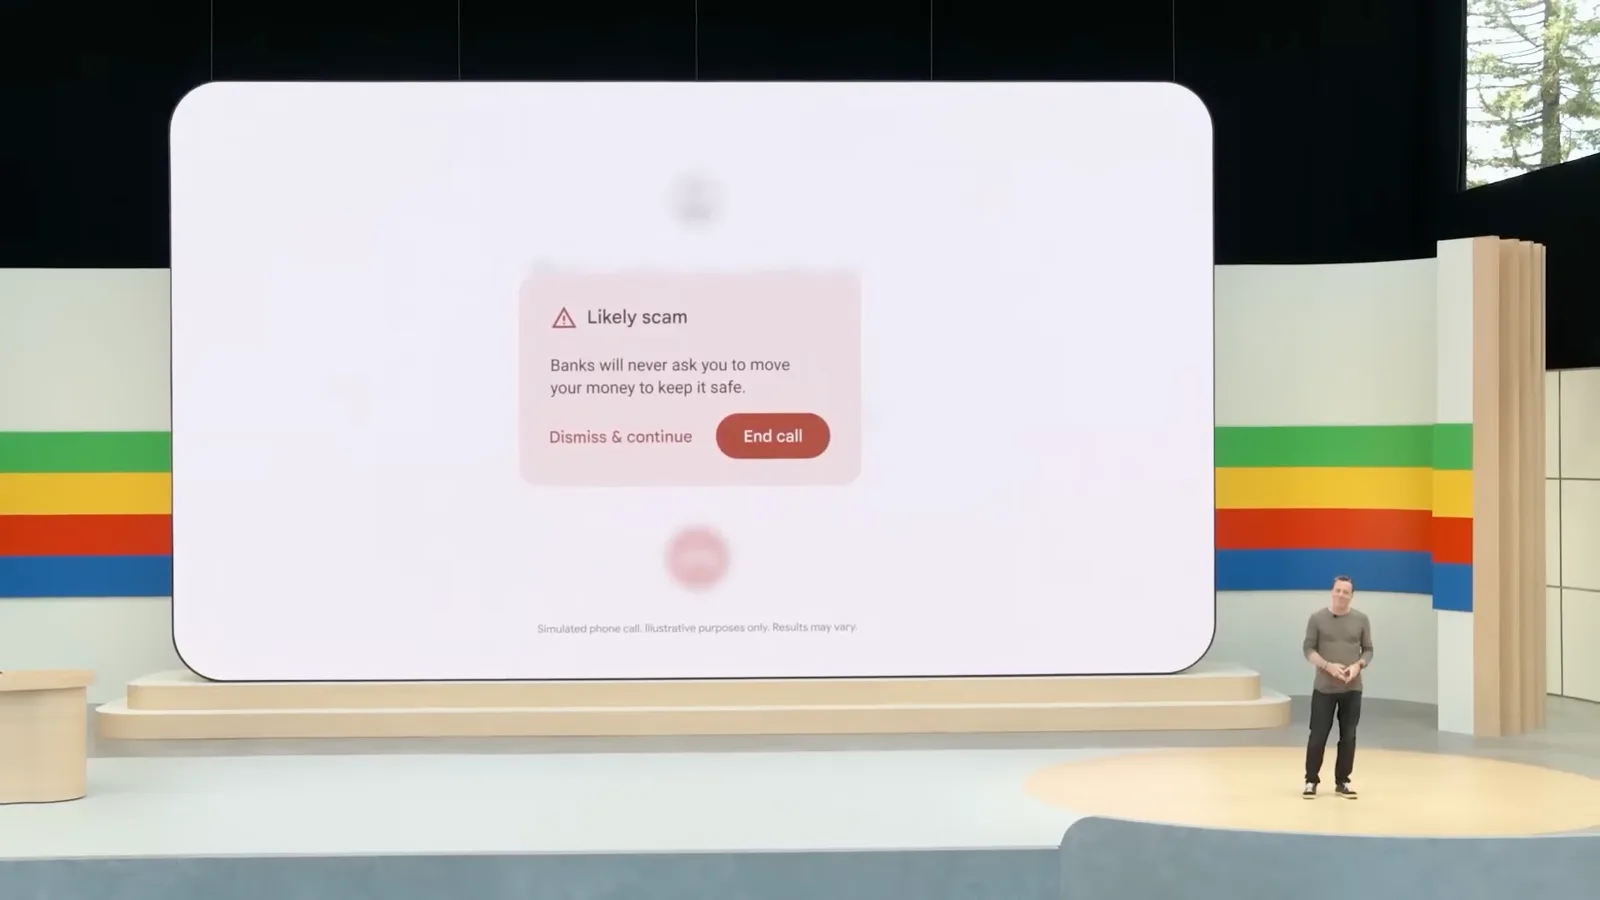
为说明设备端诈骗检测,Google 编排了一通电话:有人冒充银行职员,要求 Dave 转账。Gemini Nano 在模拟电话中显示警告。这是拟议防护措施的演示场景,不是经过测量的诈骗检测准确率,也不保证能识别所有诈骗。
开发者模型与工具
演讲介绍 Gemini API 和开放权重的 Gemma 模型。Google 宣布 PaliGemma 以及计划推出的 Gemma 2。
开发者部分中,Google 表示 Gemini 1.5 Pro 和新推出的 Flash 已在超过 200 个国家和地区提供预览。演讲者还讨论了视频帧提取、并行函数调用和上下文缓存;缓存计划于次月推出,以便更实际、更经济地重复使用长输入。
Gemma 家族被介绍为源自相关 Google 研究的开放模型,包括 20 亿和 70 亿参数版本,以及 RecurrentGemma 和 CodeGemma 等变体。Google 推出开放权重的视觉语言模型 PaliGemma,可用于图像描述、视觉问答和图像标注等任务;使用受到其许可证条款约束。
Google 宣布即将推出 270 亿参数的 Gemma 2,计划于 2024 年 6 月发布。演讲者说它针对 NVIDIA GPU 优化,可在 Vertex AI 的单个 TPU 主机上运行,并声称它能超过规模两倍以上的模型。这一舞台上的主张不能推出普遍基准结果或全面优势。
演讲以邀请开发者使用所宣布的工具进行构建结束。在整段集锦中,Google 交替展示了已开放的预览、计划推出的功能、经过编排的示例和研究原型;每一项都应放在其 2024 年原始背景下理解。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。