30 秒看懂
2025 年 4 月,Matthew Berman 解读 OpenAI 的 PaperBench:它要求智能体实现并运行 20 篇机器学习论文中的实验。他解释了与论文作者共同制定的评分标准、自动裁判、模型结果与成本,并推测未来的自我改进。报告中的分数衡量的是部分进展,而规模较小的人类对照、不完美的裁判和潜在数据污染都限制了结果的解读。
- 1二十篇论文该基准包含 20 篇 ICML 2024 论文,并配有与论文作者共同制定的详细评分标准。
- 2并不完美的自动裁判o3-mini-high 裁判在单独的人工标注评估中取得 0.83 的 F1 分数,并非完全准确。
- 3部分得分Claude 3.5 Sonnet 在 BasicAgent 配置下得分 21%;这是加权标准得分,而非完整复现论文的比例。
- 4小规模人类对照在三篇论文上,人类三次尝试中的最佳结果经过 48 小时达到 41.4%;同一对照中 o1 得分 26.6%。
- 5框架改变结果与 BasicAgent 相比,IterativeAgent 提高了 o1 和 o3-mini 的分数,却降低了 Claude 3.5 Sonnet 的分数。
- 6主要局限论文数量少、潜在数据污染、裁判不够准确及评估成本高,都限制了结果的解读。
要点建议
- PaperBench 使用 20 篇 ICML 2024 论文和详细的加权评分标准评估研究复现能力。
- Claude 3.5 Sonnet 在 BasicAgent 配置下的 21% 是部分得分,并非完整复现了 21% 论文的证明。
- 人类对照只覆盖三篇论文,并有其特定的时间和选择条件。
- 自动裁判在 JudgeEval 上对照人工标签取得 0.83 的 F1 分数,但仍会出错。
- 改变智能体框架提高了一些模型的分数,却降低了另一个模型的分数。
- 递归自我改进和智能爆炸属于外推,并非本实验测量出的结果。
按章节阅读整理后的全文
复现基准
Berman 介绍 PaperBench,以及他对智能爆炸的推测。研究衡量的是论文复现,而非自我改进。
OpenAI 的 PaperBench 评估 AI 智能体能否复现机器学习研究。我认为这可能是智能体改进 AI 研究本身的一步,并讨论 Leopold Aschenbrenner 提出的智能爆炸概念。这种外推是我的预测:该基准衡量的是部分复现,而非自主递归自我改进或即将到来的爆炸。
智能体获得论文和澄清说明,然后在配有浏览器、shell、Python 和文档阅读器等工具的环境中编写代码并运行实验。真正的复现不只是总结,还包括实现实验、调试并产出结果。
论文、评分标准与裁判
基准使用 20 篇论文及与作者共同制定的评分标准,并用单独的人工标注数据集验证自动裁判。视频包含 GrowthSchool 赞助。
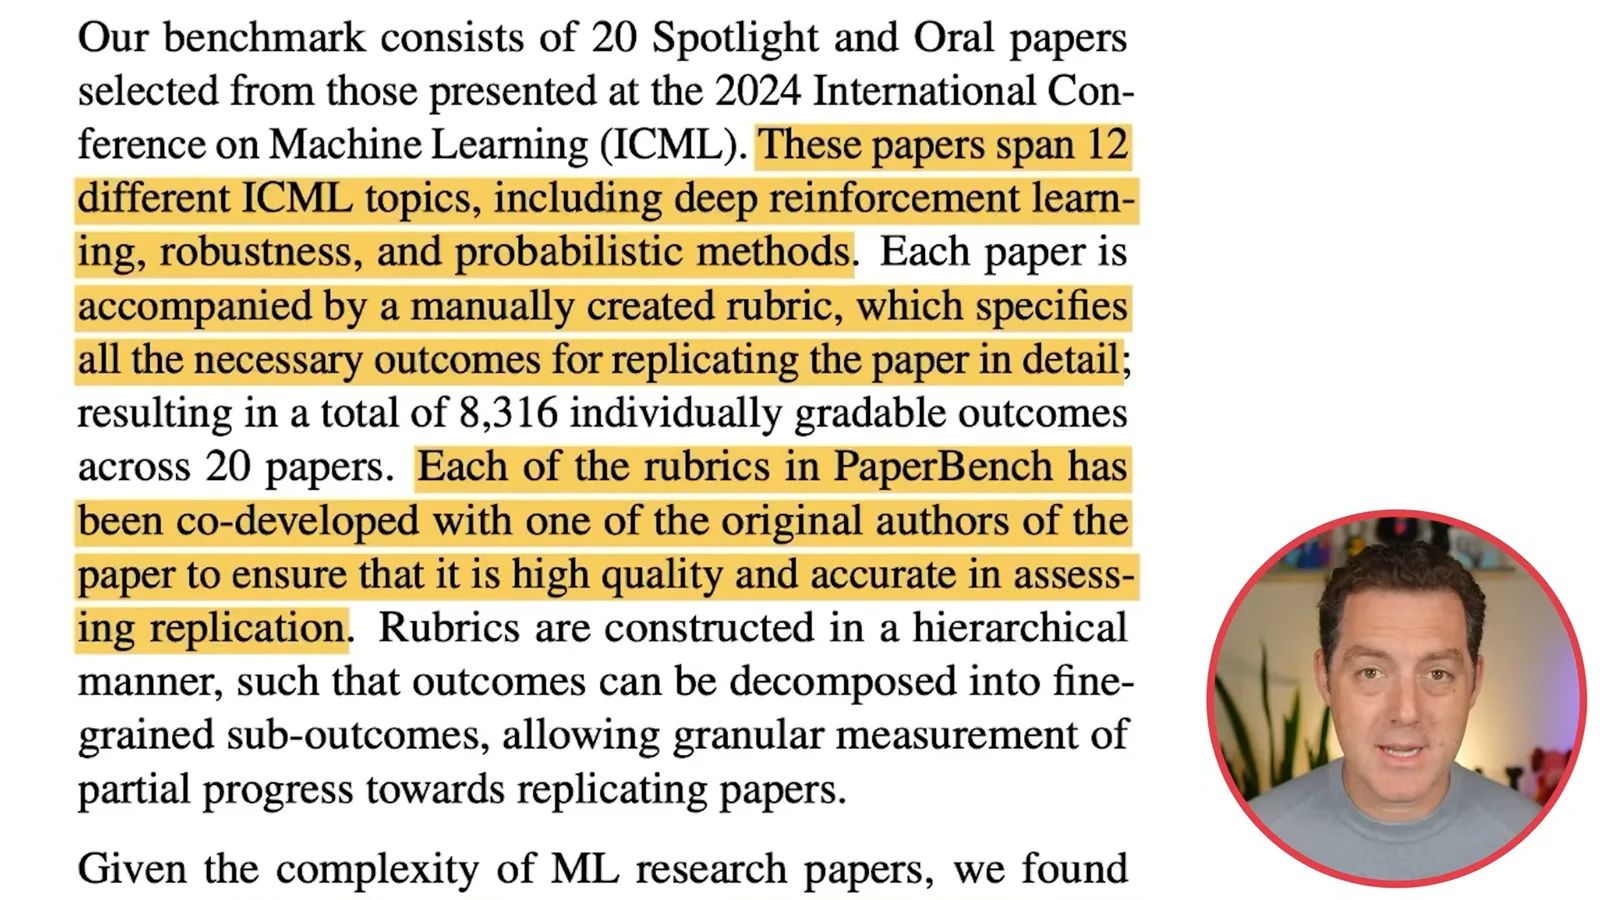
PaperBench 包含 ICML 2024 的 20 篇 Spotlight 或 Oral 论文,涵盖强化学习、鲁棒性和概率方法等 12 个主题。每份评分标准都与原论文的一位作者共同制定,并将复现工作拆分成许多评分要求。作者参与提高了相关性,但不能保证评估完美无误。
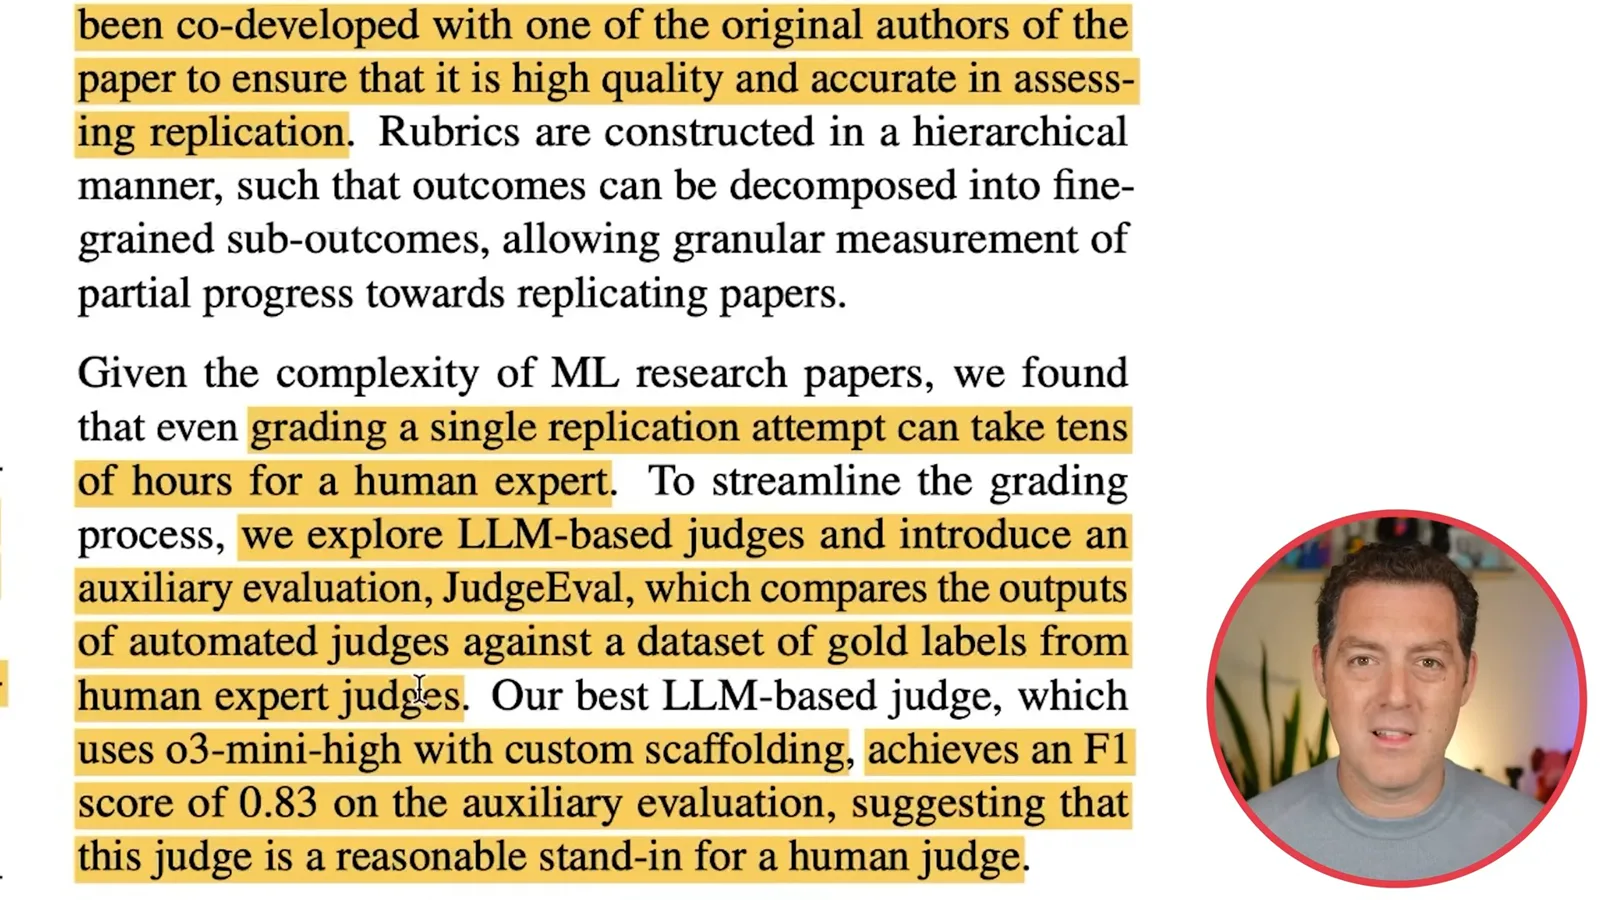
人工专家评判一次尝试可能需要数十小时。因此,研究人员构建了自动裁判和 JudgeEval:后者是一项独立评估,用人工标注的示例作为对照。其 o3-mini-high 裁判在这个辅助数据集上取得 0.83 的 F1 分数;这并不意味着它总是正确,或等同于人类专家。
我认为,模型周围的工具与编排——也就是智能体框架——和模型本身一样重要。这些组件让模型能够读取文件、使用终端和浏览网页。回到研究前,视频包含 GrowthSchool 的赞助环节。
流程与初步结果
主持人回顾 BasicAgent 的结果和小规模人类对照。分数代表部分得分,并非完整复现的论文数量。
在论文的 BasicAgent 配置下,Claude 3.5 Sonnet(New)在 20 篇论文上取得平均 21.0% 的分数。这是对各项要求的加权部分得分,并不能证明它完整复现了 21% 的论文。由于 API 速率限制,团队无法完成 Claude 3.7 Sonnet 的实验;列出的模型中也没有 Gemini 2.5 Pro。
工作流程从论文开始,经过编写代码、配置和执行实验,再将提交内容交给使用作者参与制定的评分标准的裁判。我把这个环境与其他编程智能体作比较。程序成功运行是有用反馈,但它不会自动验证科学结果是否正确,也不会使改进具备无限扩展性。
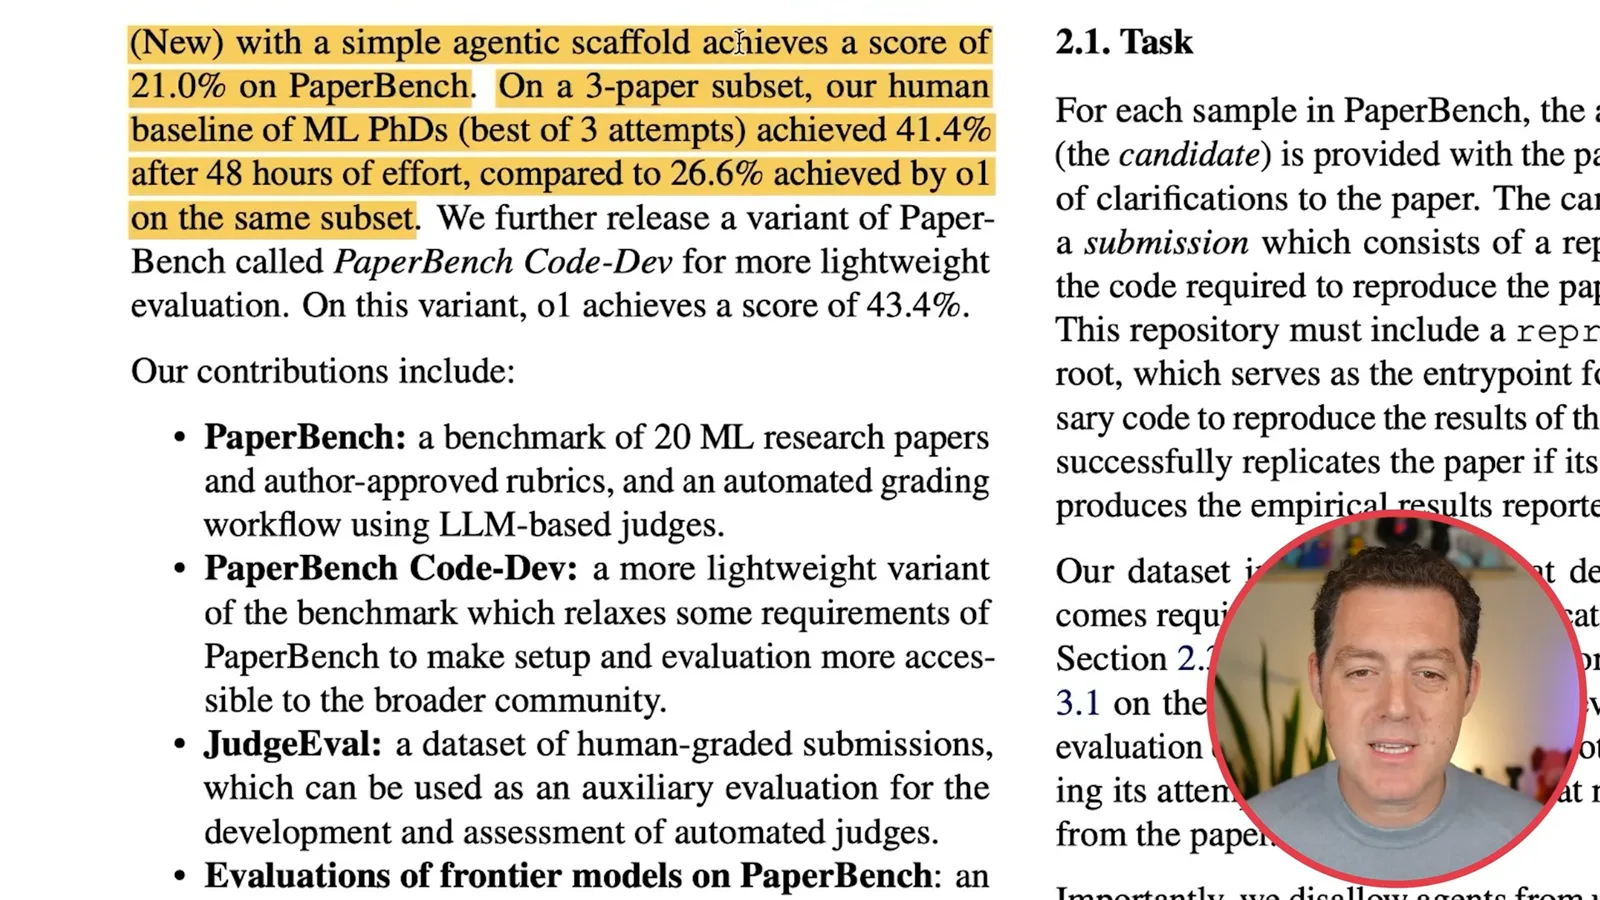
人类对照比完整基准范围更窄:在三篇论文组成的子集上,机器学习博士三次尝试中的最佳结果经过 48 小时达到 41.4%,o1 在同一子集上得分 26.6%。资源和结果选择条件不同会影响比较,这个结果并非对人类与 AI 研究能力的普遍衡量。
执行与评分
提交内容在干净环境中重新运行,并通过加权评分树评估。不同要求分别考察代码、执行和结果匹配。
候选提交内容是一个代码仓库,包含实现代码和 reproduce.sh 入口文件。智能体可以上网浏览,但不得使用原作者的代码或每篇论文黑名单上的其他禁止复现版本。黑名单减少了直接复用,却不能证明模型在训练中从未接触过相关材料。
要认定某个结果得到复现,系统会把提交内容复制到一套配有 A10 GPU 的全新 Ubuntu 环境中,并运行脚本。这种干净环境下的重跑有助于区分智能体的说法和生成代码、结果中的证据,尽管评分标准也认可未完成的进展。
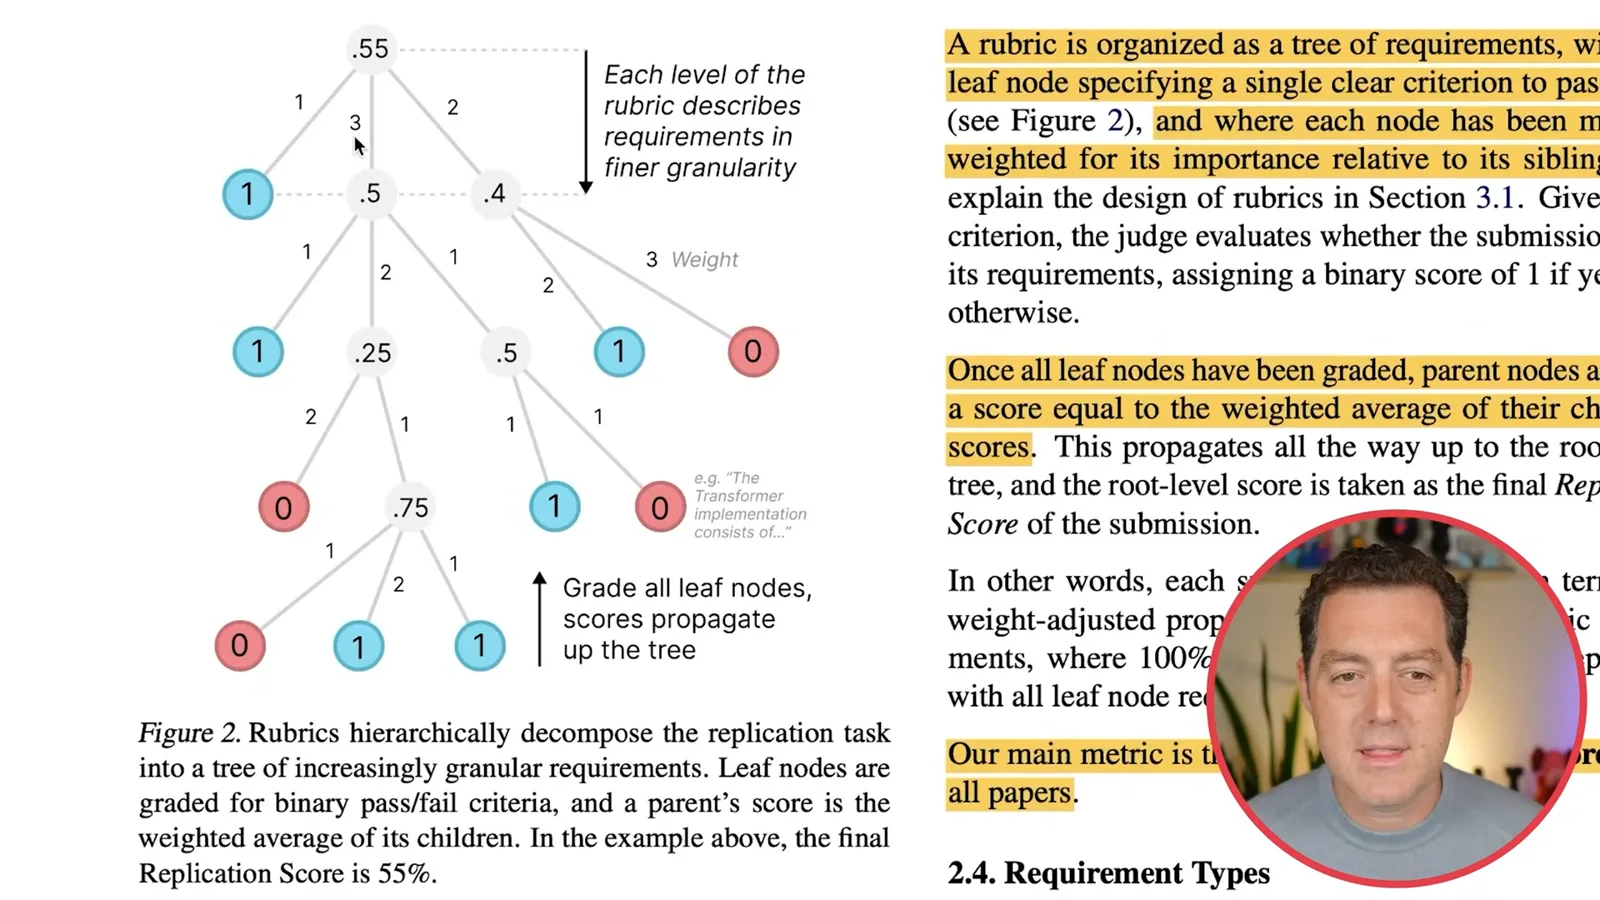
每份评分标准都是一棵树。各个叶节点要求按通过或失败评分,分数再以加权平均的方式向上传递,形成最终复现得分。这样可以对具体成果给予部分分,而不是把整篇论文视为单一的通过或失败项目。
叶节点要求涵盖结果匹配、执行和代码开发。裁判检查是否有证据支持某个结果、相关执行是否发生,以及代码看起来是否实现了要求的方法。即使完整研究结果没有复现,后两类也可能获得分数。
我将这种部分得分思路与训练中的过程奖励作比较:后者可能分别评估中间步骤。不过这里的评分标准用于评估提交内容;论文并没有证明这些分数训练了被测模型,或证明智能体从每个被评分的步骤中学习。
规则、成本与评估变体
论文介绍了允许使用的工具、黑名单和成本更低的纯代码变体。自动评分涉及成本与准确性的权衡。
PaperBench 旨在适配不同模型和框架。规则允许使用工具和外部服务,并用黑名单阻止下载禁止使用的实现;开发者可以为必要服务提供凭据,因为获取账户并不是该基准要衡量的技能。
完整评估可能很昂贵,因此 PaperBench Code-Dev 只评估代码开发要求,跳过复现运行和结果匹配评估。它降低了 GPU 和评分成本,但纯代码分数不能证明实验已经运行或结果已经复现。
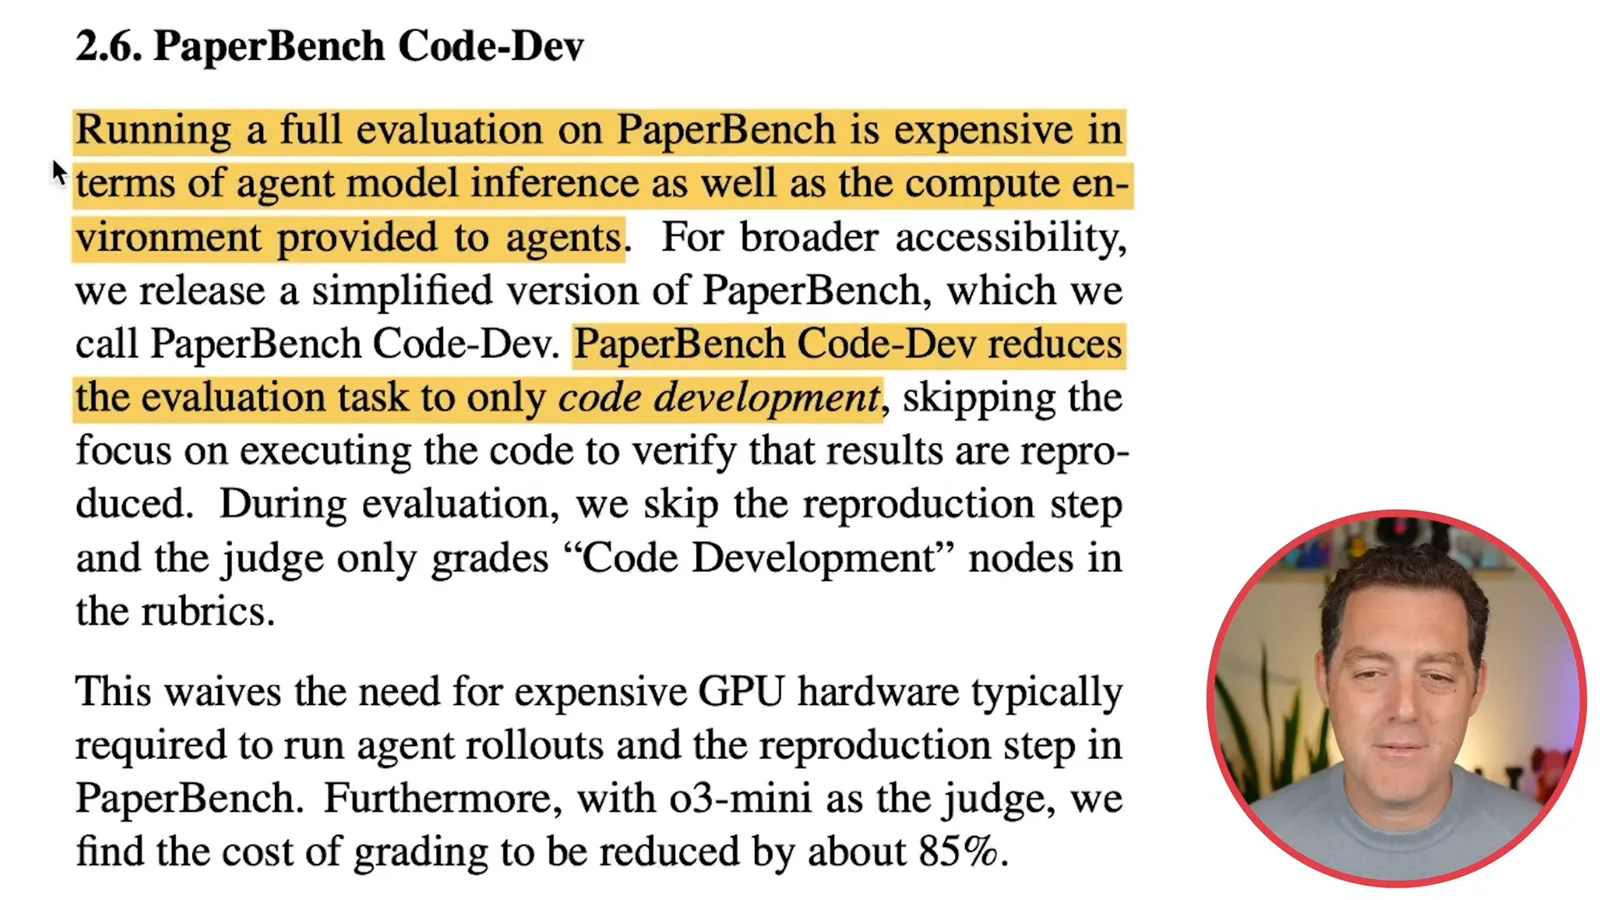
与论文作者共同制定评分标准需要大量专家工作和多轮审核。自动裁判接收论文、评分标准和相关提交材料;由于代码库可能超过上下文窗口,它会对文件按相关性排序,并纳入最相关的文件。这个选择过程和自动判断都可能引入错误。
研究人员估计,使用 o3-mini 裁判评估一份完整提交约需 66 美元的 API 额度,而 Code-Dev 约需 10 美元。这是 2025 年研究中的估计,并非当今有保证的价格。人工评分更慢、更昂贵,但论文也指出其裁判的准确性不及专家。
结果、局限与影响
Berman 回顾模型与框架的结果、污染风险和成本。他对智能爆炸的预测超出了研究本身。
主要实验评估了 GPT-4o、o1、o3-mini、DeepSeek-R1、Claude 3.5 Sonnet(New)和 Gemini 2.0 Flash,每篇论文运行三次,时间上限为 12 小时。在这一框架下,Claude 3.5 Sonnet 得分 21.0%,o1 得分 13.2%,其他被测模型均低于 10%。
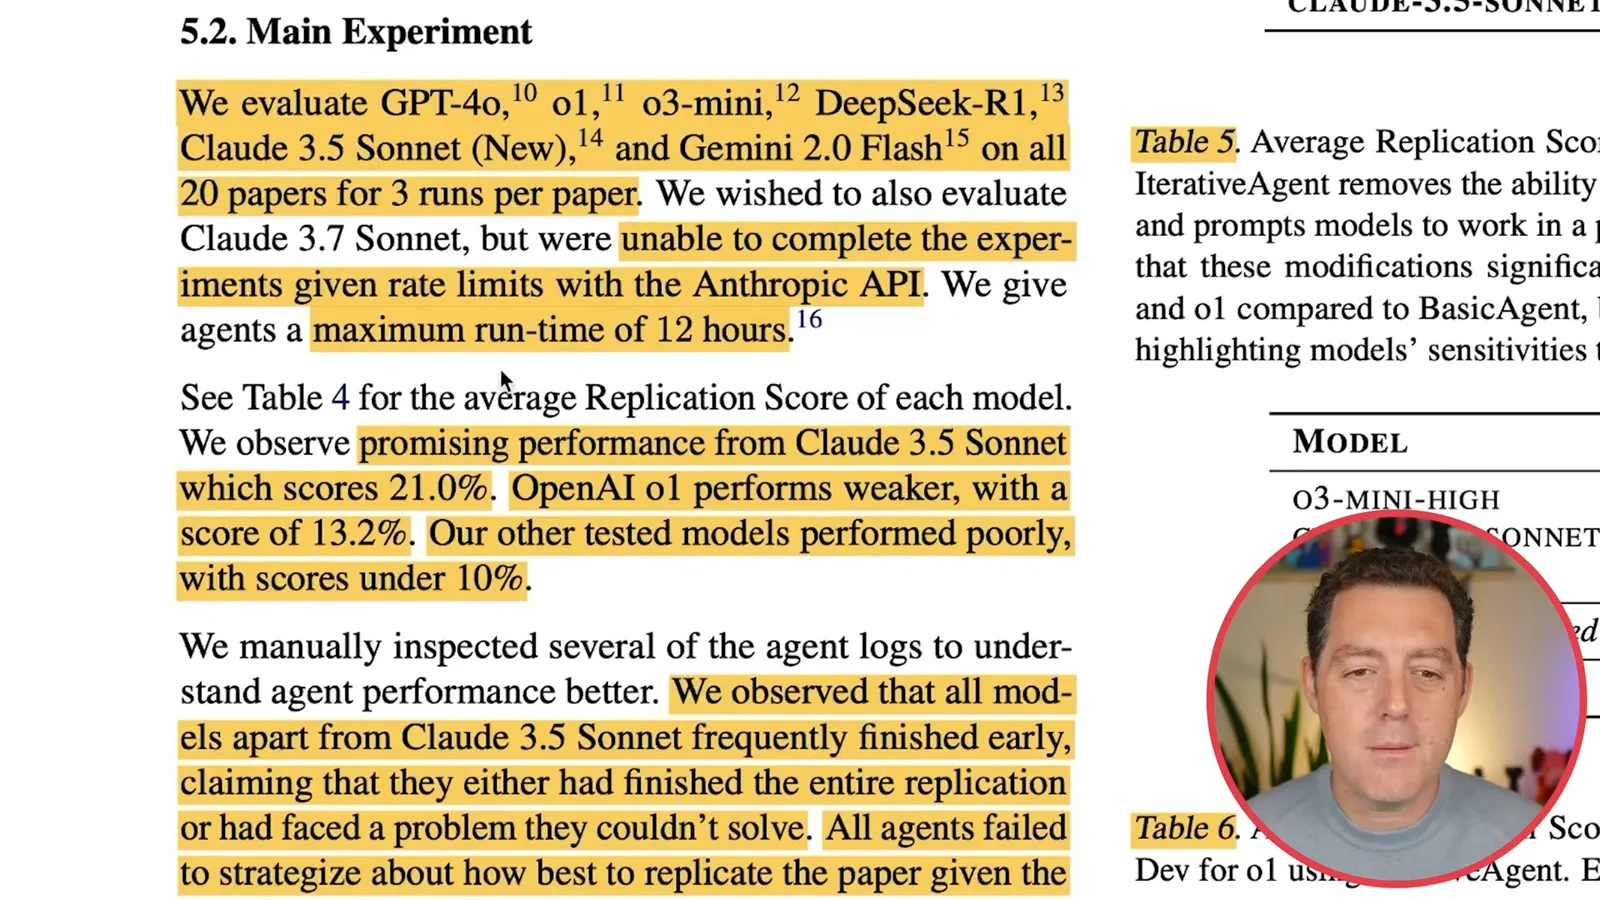
研究人员观察到,除 Claude 3.5 Sonnet 外,其他模型经常提前停止,声称已经完成或遇到了无法解决的问题。他们还观察到时间分配不佳,以及 o3-mini 难以使用工具。我认为更好的框架和工具训练可能有所帮助,但实验不能证明底层模型无须改进。
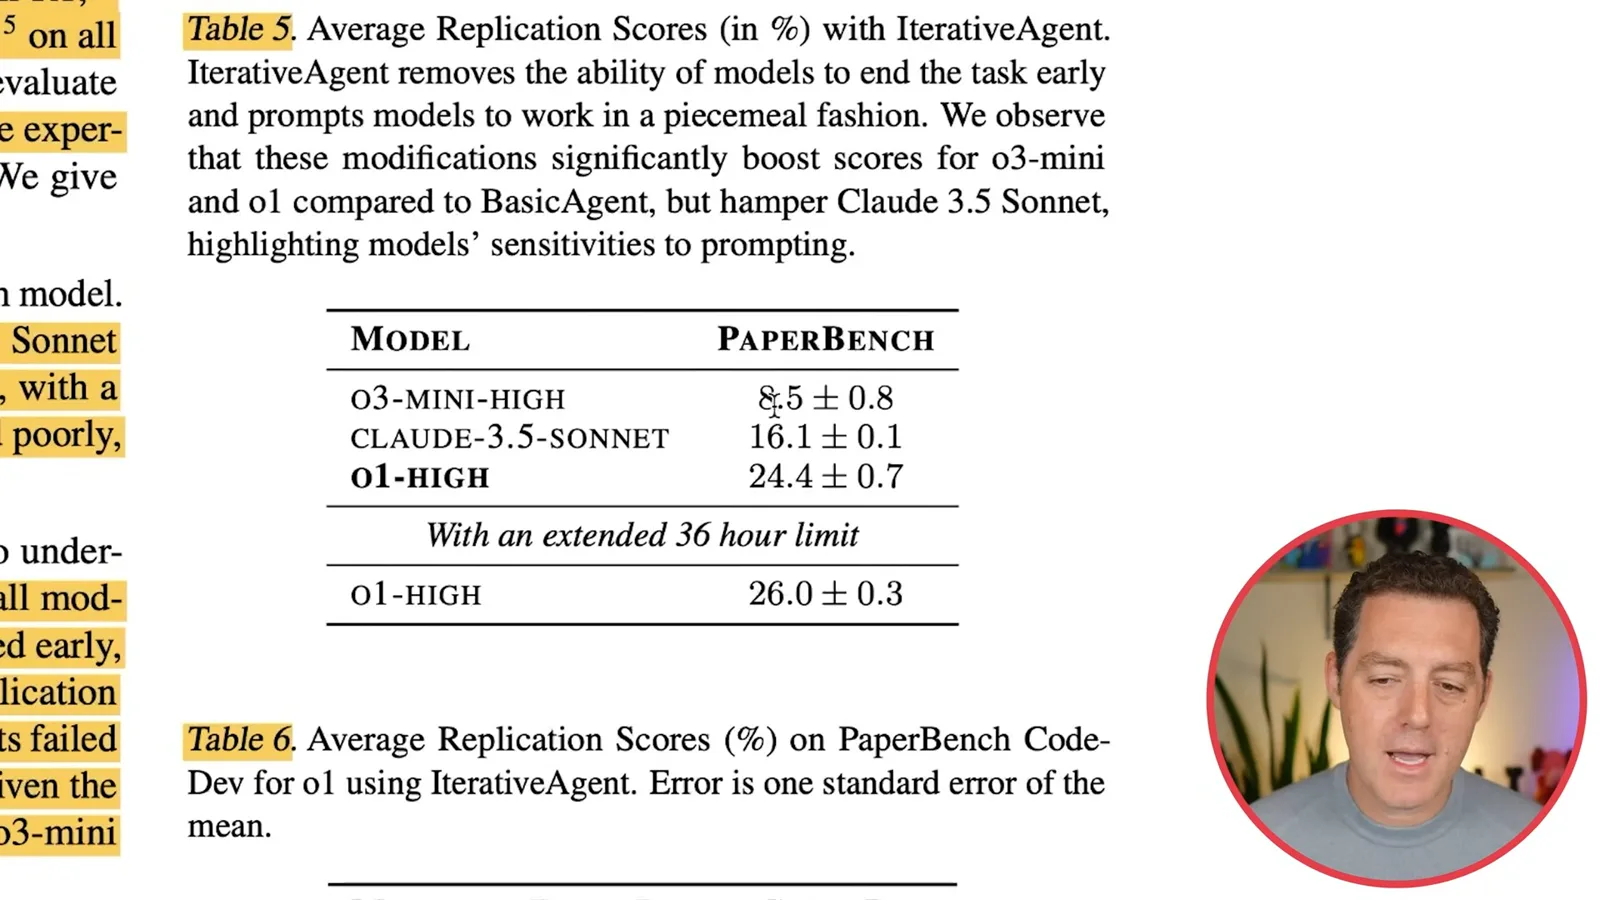
团队测试了 IterativeAgent:它阻止智能体提前结束,并提示模型分步工作。报告结果为 o3-mini-high 得分 8.5%、Claude 3.5 Sonnet 得分 16.1%、o1-high 得分 24.4%;将 o1 运行时间延长至 36 小时后达到 26.0%。这种改变提高了部分结果,却降低了 Claude 的成绩,说明框架和提示词选择会与模型相互影响。
作者将数据集规模列为局限:20 篇论文只覆盖机器学习研究的一部分,尽管它们的评分标准包含数千项单独要求。这些要求提供了细粒度观察,但不能让样本等同于数千篇相互独立的论文。
训练数据污染也是一个问题。论文作者认为,论文发表时间较近,使被测模型受到污染的可能性较低;但在评估期间把网站列入黑名单,不能排除这种可能。未来的模型也可能接触过这些论文或其实现。
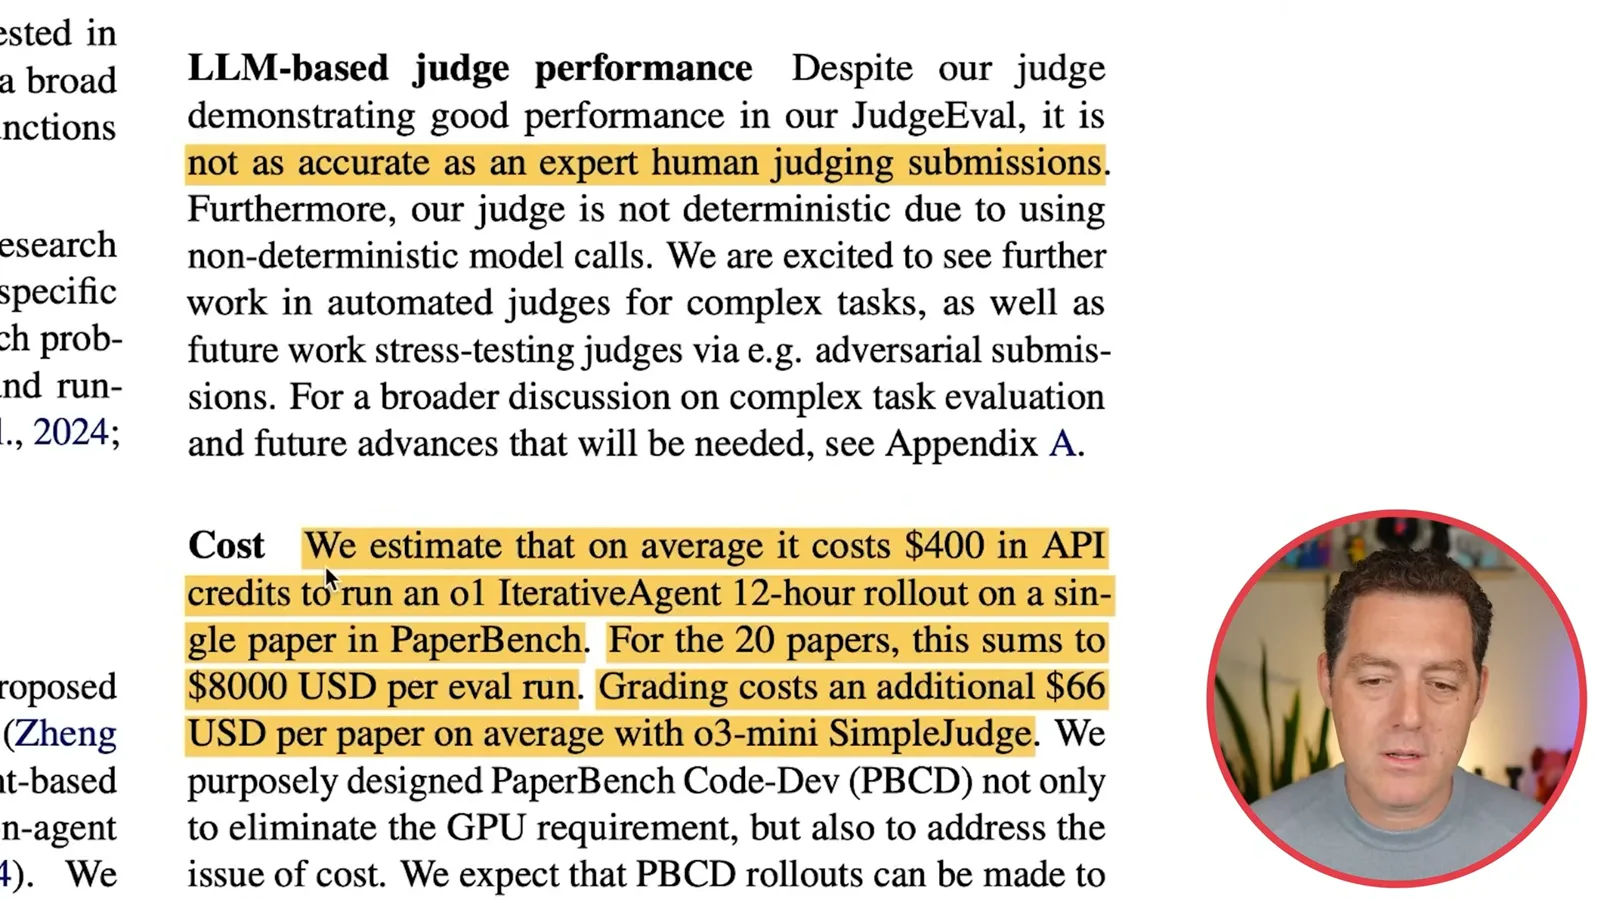
构建新任务仍然劳动密集,模型裁判不如专家准确,而且结果可能不具确定性。作者估计,用 o1 IterativeAgent 对一篇论文运行 12 小时约需 400 美元的 API 额度,20 篇约需 8000 美元,此外每篇评分约需 66 美元。
我的结论是,智能体取得了有意义的部分进展,但距离可靠地复现所有工作仍然很远。我预计模型和框架会继续改进,也看到了加快 AI 研究的可能路径。这是否会导致快速递归自我改进,是一种预测,而非 PaperBench 已经证实的结果。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。