30 秒看懂
在这期 2024 年 12 月的新闻综述中,Matthew Berman 回顾 Google DeepMind、World Labs、ElevenLabs、Tencent、Qwen、Prime Intellect、Anthropic、Runway、Amazon 和 OpenAI 的研究演示与产品公告。他对生成式环境和智能体充满期待,同时指出了一些演示与模型的限制。 视频包含 Build Your Store AI 的付费赞助;产品宣传与价格反映的是当时的情况。
- 1Genie 2 世界DeepMind 在研究演示中展示了以图片为条件生成、可用键盘和鼠标控制的环境。
- 2不同的 3D 方法World Labs 让用户在浏览器中探索由图片构建的有限场景。
- 3实验性推理模型QwQ-32B-Preview 提供可下载权重,并列出了已知限制和厂商报告的基准测试结果。
- 4分布式训练Prime Intellect 发布了跨分布式机器训练的模型及配套资料。
- 5用 MCP 连接智能体Anthropic 推出开放的客户端—服务器协议,用于连接 AI 应用、工具和数据。
- 6Amazon NovaAmazon 宣布了一系列文本与多模态模型;本文介绍的是 2024 年的可用性与规格。
要点建议
- Genie 2 在研究演示中从图片生成可通过动作控制的视觉环境,它不是一款完成的游戏引擎。
- World Labs 展示了可在有限范围内漫游的 3D 场景,ElevenLabs 则展示了语音智能体和播客生成。
- HunyuanVideo 和 QwQ 发布了可下载权重,使用时仍需考虑许可证和模型限制。
- INTELLECT-1 展示了一次具体的 100 亿参数分布式训练,并未消除算力或协调成本。
- MCP 提议使用共同接口连接 AI 应用、工具和数据;安全性仍取决于实现和权限。
- Amazon 的 Nova 产品线及 AWS 与 Anthropic 的投资合作发表于 2024 年,视频中的描述反映当时情况。
按章节阅读整理后的全文
Genie 2 与生成世界
Google DeepMind 演示从图片生成、可通过动作控制的场景。Berman 讨论视觉示例并披露视频赞助商。
这期 2024 年 12 月的新闻综述涵盖生成世界与视频、语音智能体、开放权重的推理模型、分布式训练,以及连接 AI 工具的新协议。这些都是历史公告和演示:产品可用性、价格与能力可能已经变化。
[Google DeepMind 的 Genie 2](https://deepmind.google/blog/genie-2-a-large-scale-foundation-world-model/) 从一张提示图片生成可通过动作控制的环境,其用途之一是训练和评估具身智能体。人或 AI 智能体可以使用键盘和鼠标输入。DeepMind 展示了最长一分钟的研究示例;这些片段是演示,并非已完整发布的商业游戏。
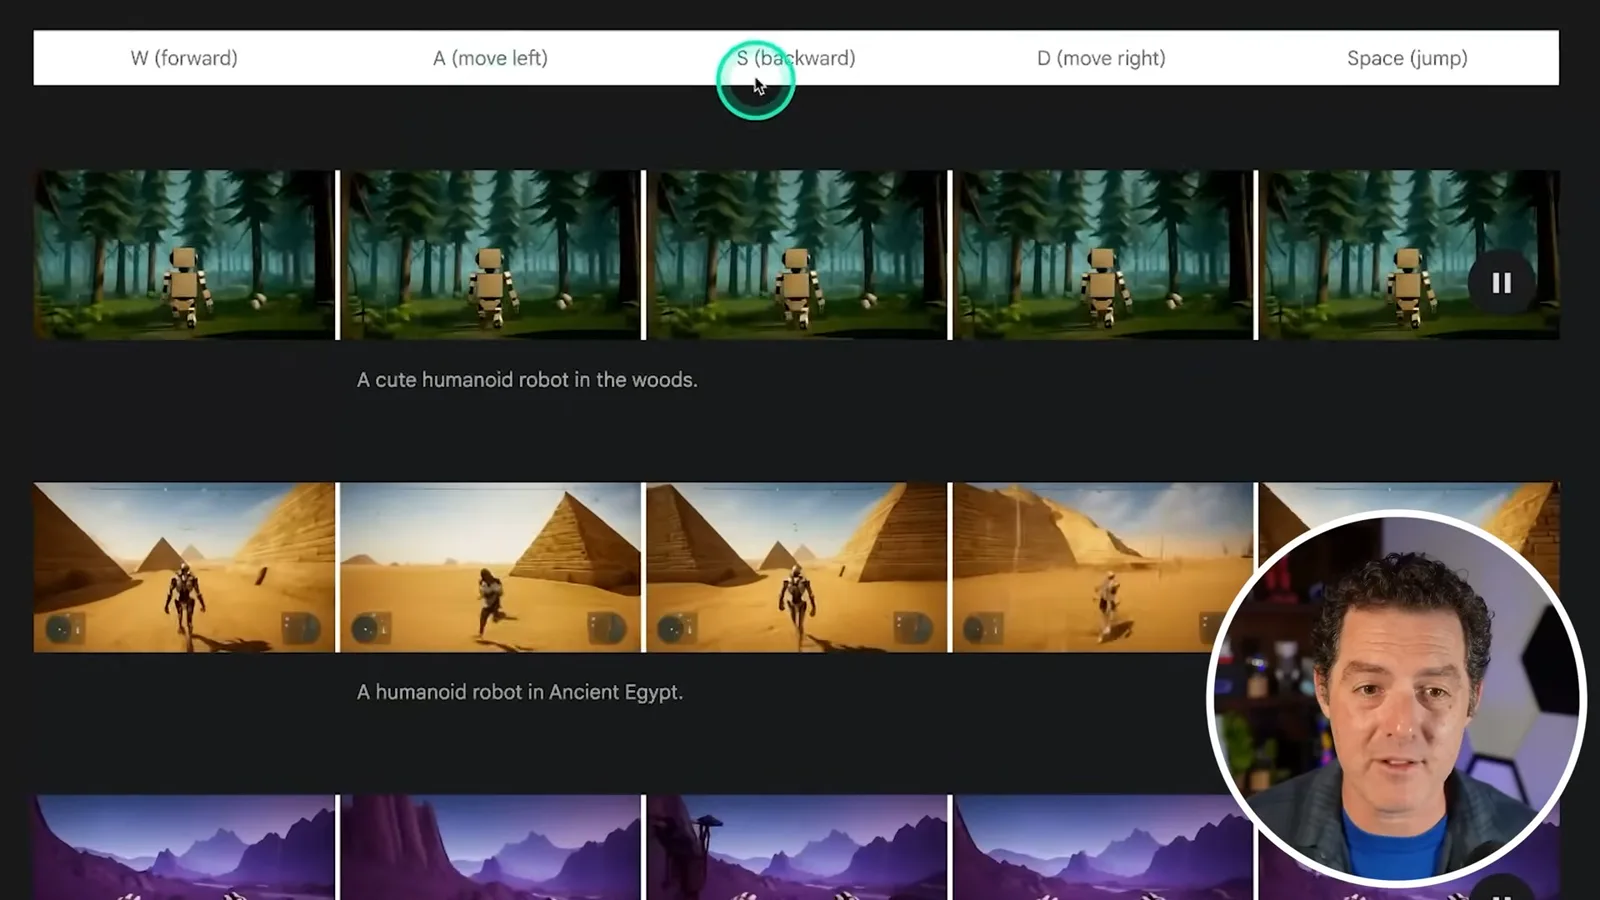
示例中,机器人在森林、沙漠等场景里响应前进、侧移和跳跃控制。一艘船从水面驶到沙地时,表现出不同的反应。我觉得这些行为令人印象深刻,但演示中看起来合理,并不能证明它是一套通用或物理上精确的模拟。
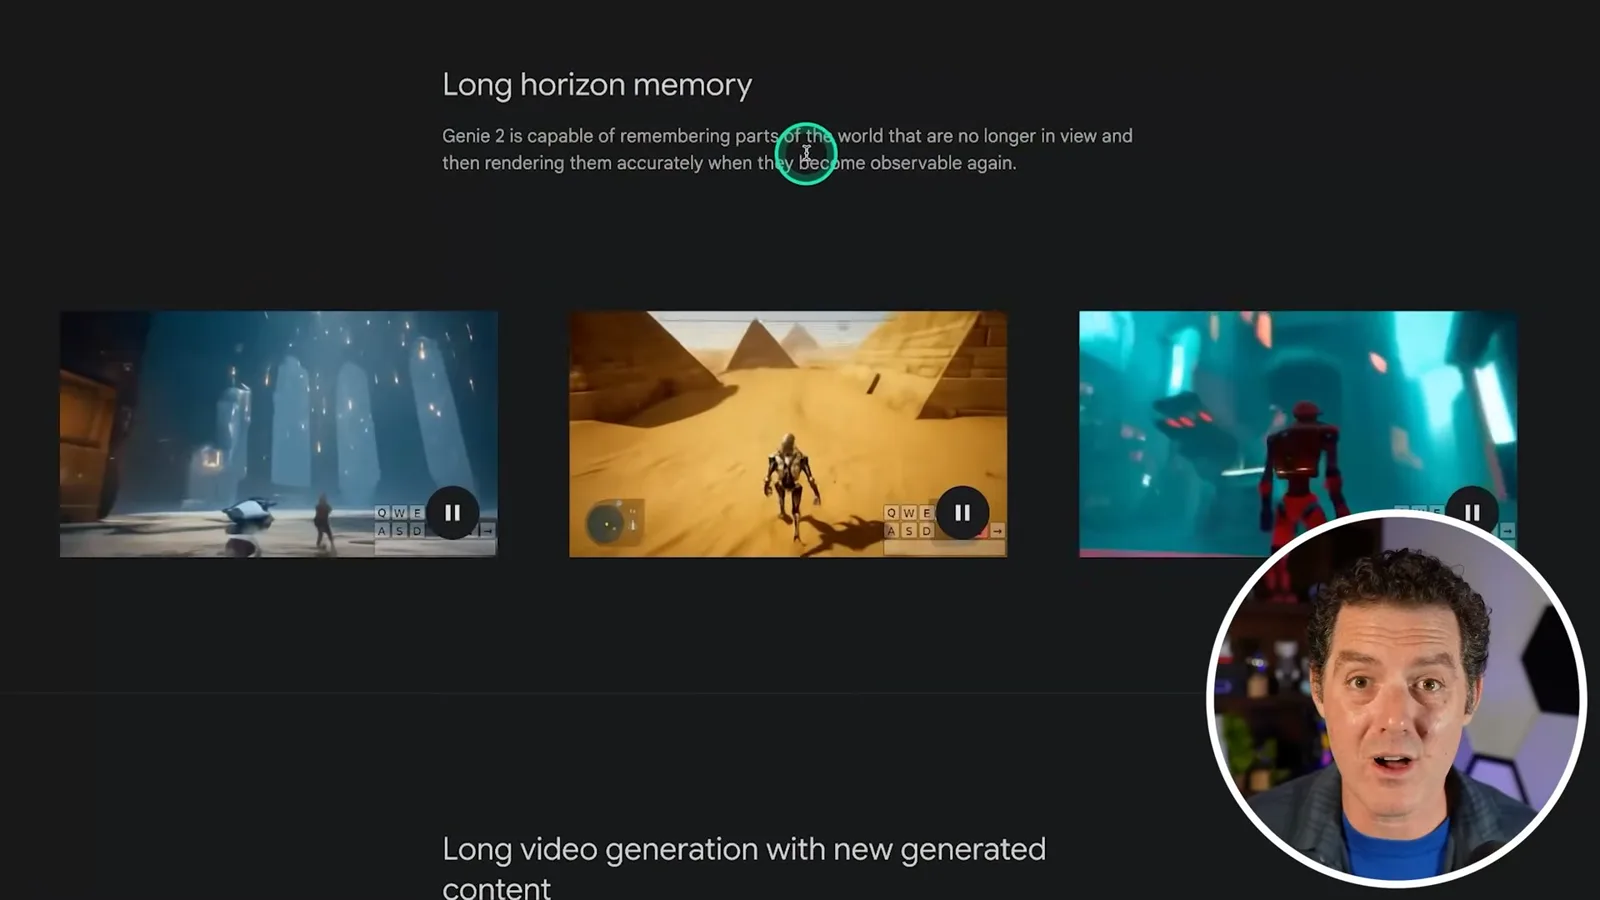
DeepMind 还描述了“长时程记忆”:场景的一部分离开画面后,视角回到那里时可以重新出现。示例包括角色在景观和金字塔周围移动。这让我想起早期 Sora 视频中被遮挡的物体重新出现的情况,但选定片段中的一致性不能保证所有情况下都能完美记忆。
视频包含 Build Your Store AI 的付费赞助。我展示了它提出的 Shopify 店铺设置流程,并提到前三个月每月 1 美元的促销价格;该优惠属于历史信息,创建店铺也不能保证商业成功。
更多 Genie 2 演示包括城镇、赛车场景、武士击破气球和油桶爆炸。一个爬梯子的角色看起来能够协调手脚。这些是针对动作生成的视觉反应,并不能证明系统拥有传统游戏引擎或能可靠模拟物理规律。
我还观察了烟雾、火把照亮地牢,以及根据真实图片或概念画生成的场景。吸引人之处在于,不必手工制作每项素材,就能立即探索一个想法。该模型是研究演示,而我预测它将改变游戏,是一种期待,并非已确定的结果。
World Labs 与 ElevenLabs
World Labs 展示可漫游的 3D 场景,ElevenLabs 推出语音智能体和播客式音频。Berman 将有限演示与更广泛的产品宣传区分开来。
由 Fei-Fei Li 和同事创立的 World Labs 展示了不同方法:从一张图片生成可漫游的 3D 场景。该公司提供了可在浏览器中互动的示例,而我展示的 Genie 2 示例是视频。我觉得前者没那么像游戏,但仍然很有趣。
World Labs 解释说,明确的 3D 场景在镜头移开又返回时可以保持其结构;深度图则把距镜头的距离可视化。示例还展示了改变光照,以及呈现输入图片周围更多的场景。它与视频生成的区别在于场景表示方式,并不能证明它完美遵循现实物理规律。
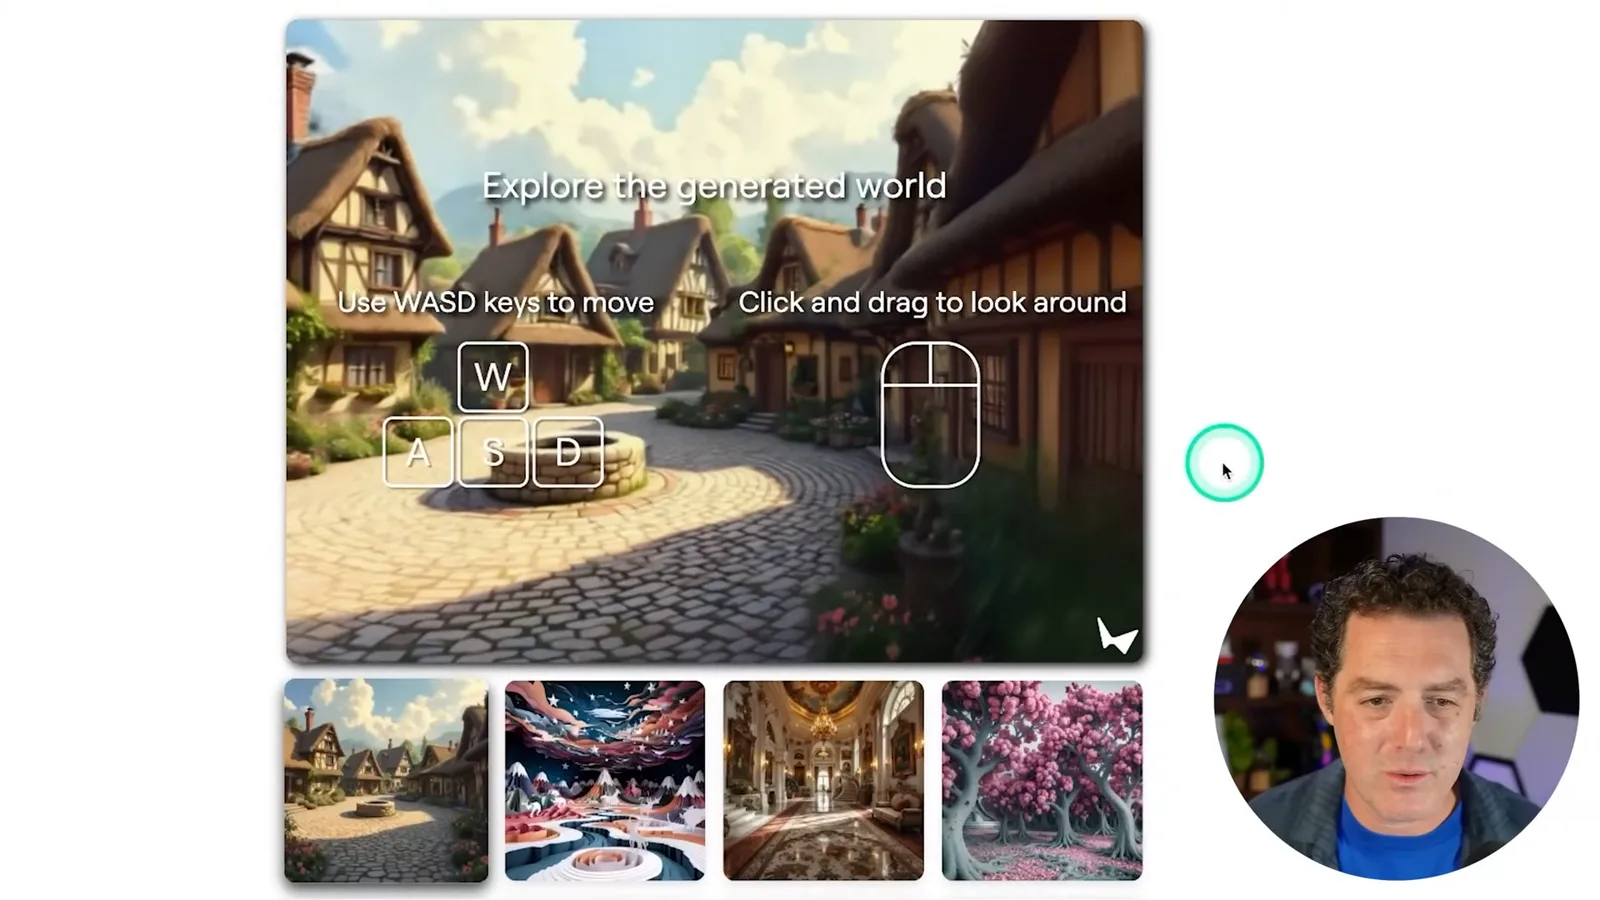
我尝试了 World Labs 的浏览器演示。用户可以向不同方向环顾,但移动范围很小,走到一定距离就会碰到边界。这个限制很重要:目前提供的是可漫游演示,而不是完全开放、可互动的游戏世界。
ElevenLabs 推出用于构建语音智能体的 Conversational AI。其宣传演示介绍了低延迟对话、可配置声音、知识库、可选语言模型、对话分析,以及通过网站或 SDK 部署。订单状态与退款示例展示的是设想中的用途,不能独立证明生产环境中的性能或安全性。
我将这项服务与 OpenAI 的 Advanced Voice Mode 作比较,并推测 ElevenLabs 可能通过语音转录、语言模型和语音生成来处理音频。这是我对架构和延迟的理解,并非经过测量的正面对比。针对具体用途,值得测试可用的模型集成和对声音线索的响应能力。
ElevenLabs 还在 ElevenReader iOS 应用中推出 GenFM,可将 PDF、文章、电子书、链接和文本等来源生成播客式音频。演示中的合成主持人讨论了灰姑娘、原子理论和一道食谱。该公司当时宣传支持 32 种语言。
视频、推理与分布式训练
Berman 回顾 HunyuanVideo、QwQ-32B-Preview 和 INTELLECT-1,讨论生成样例、模型限制和分布式算力的潜力。
Tencent 发布了 HunyuanVideo,提供可下载的模型权重和代码,用于根据文本生成视频。我观看了未来风格人物、骑自行车的熊猫,以及液体或泥浆等短片。虽然视觉运动令人印象深刻,有些人脸仍显得不自然。[Tencent 的代码仓库](https://github.com/Tencent-Hunyuan/HunyuanVideo)提供了该发布版本;其社区许可证包含条件和地域限制,因此可下载权重并不意味着可以无限制使用。
许多示例片段只有几秒钟。生成更长的视频可能需要更多算力和时间,精心挑选的样例也不能证明每条提示都能得到同样好的结果。我提到另一份关于 Mochi 的教程,也邀请观众提出是否需要 HunyuanVideo 教程。
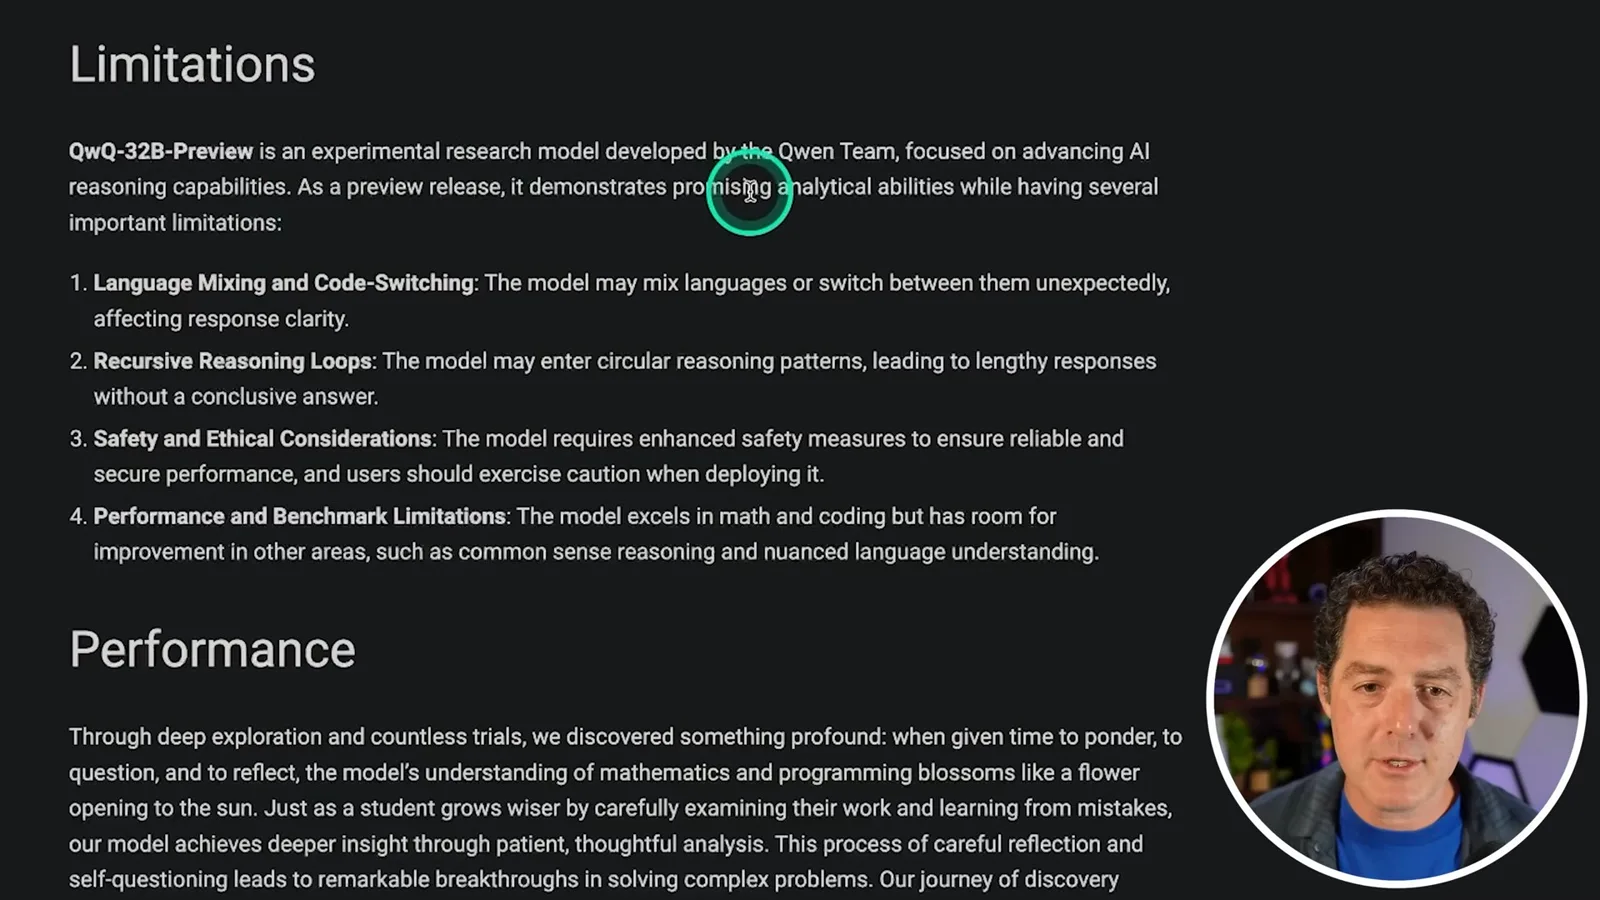
Qwen 团队发布了 [QwQ-32B-Preview](https://qwenlm.github.io/blog/qwq-32b-preview/),这是一款可下载权重的实验性 320 亿参数推理模型。开发者表示,它可能混用语言、陷入递归推理循环,并需要额外安全措施;他们还指出它在常识推理和细微语言理解方面存在不足。
团队的基准图表在 AIME、GPQA、MATH-500 和 LiveCodeBench 上,将该预览版与 OpenAI 的 o1-preview 作比较。Berman 指出厂商报告表格中的不同胜负;结果取决于评测设置,不能证明某个模型全面胜出。展示的算术题在答案前给出了很长的可见推理过程,这与 o1-preview 隐藏推理过程的做法不同。
Prime Intellect 的 INTELLECT-1 探索了在地理位置分散的机器上训练 100 亿参数模型。发布内容包括模型检查点、训练框架和技术文档。我认为这可能让开放社区汇集资源,而不必完全依赖某一家公司的数据中心。
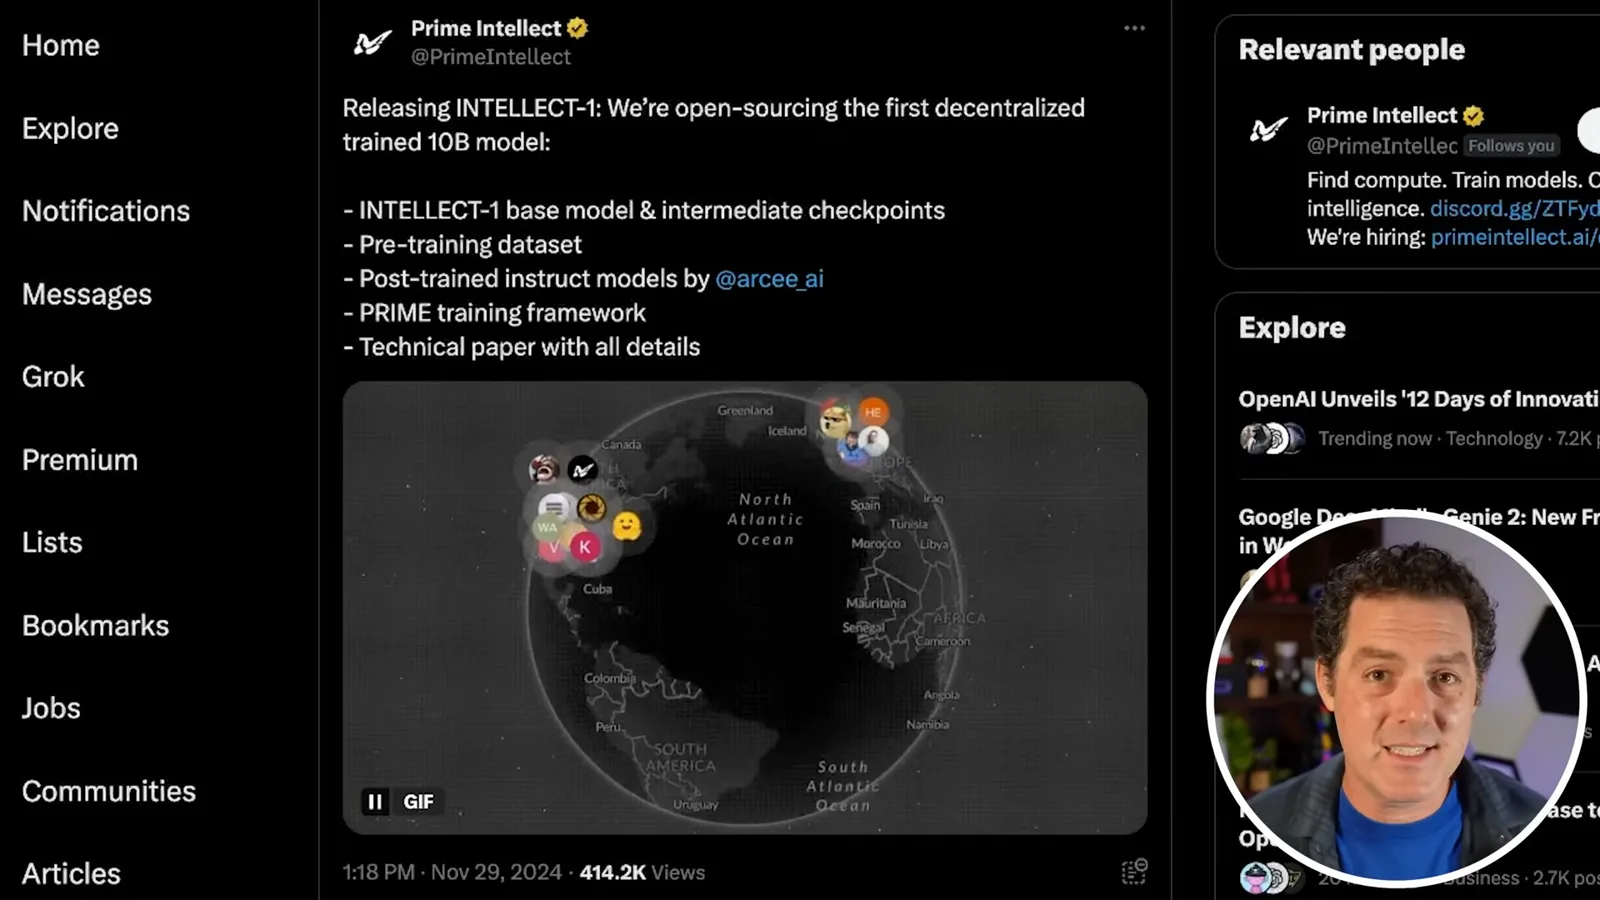
我自己的两张 RTX A6000 GPU 常常闲置,因此我设想可以向这样的项目贡献一部分算力。这是关于扩大参与的愿景,并不是说任意闲置消费级机器已经可以在没有协调、成本或网络限制的情况下训练前沿模型。这个 100 亿参数的例子展示了一次具体的分布式训练,并不意味着数据中心已经过时。
MCP 与创意工具
Anthropic 的 Model Context Protocol 引出有关智能体与软件界面的讨论。Berman 还介绍 GenChess 和 Runway Frames。
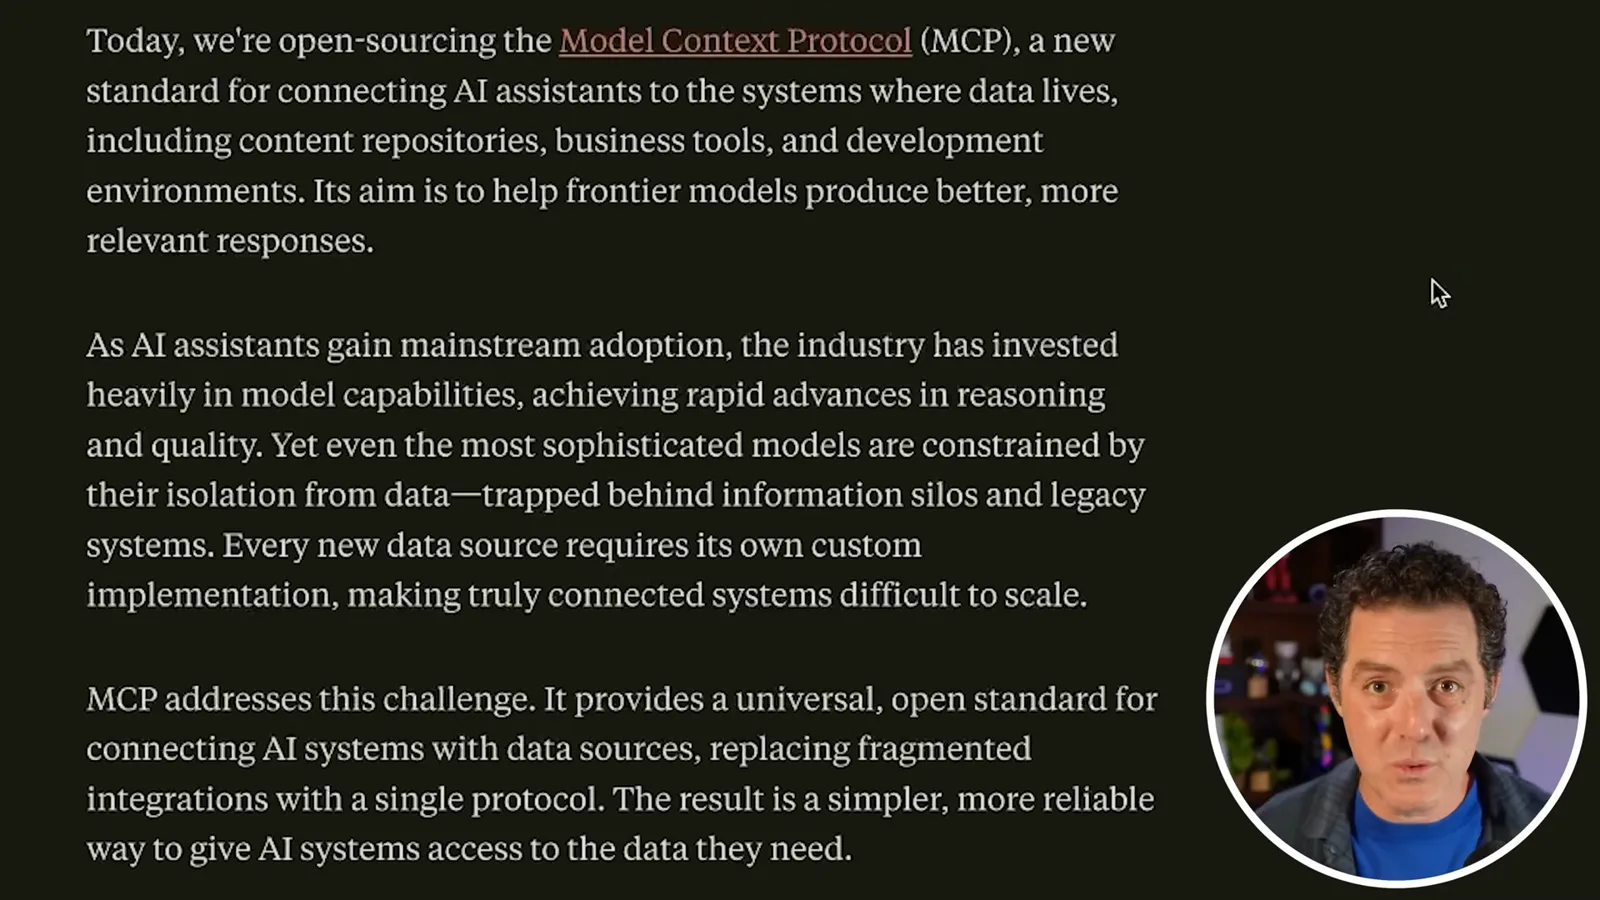
Anthropic 宣布推出 [Model Context Protocol](https://www.anthropic.com/news/model-context-protocol),这是一项连接 AI 应用、数据源和工具的开放标准。开发者可以通过 MCP 服务器提供数据,让应用通过客户端连接;初始发布包括规范、SDK,以及 Google Drive、Slack、GitHub、Git、Postgres 和 Puppeteer 的示例。
我认为标准化连接是向能够操作数字系统的智能体转变的一部分。MCP 提供共同接口,但不会自动保证安全或普遍访问:权限、信任和具体实现仍然重要。我的长期观点是,智能体可能按需组装界面,改变软件企业的运作方式。
例如,我推测,如果智能体能够读取数据并生成用户需要的界面,主要作为数据库上层用户界面的产品可能面临冲击。我以 Salesforce 为例,认为这种转变可能需要五到十年。这是一项预测,并不是现有应用将消失的证据。
Google 的 GenChess 是一个有趣的实验,可以创建主题国际象棋棋子。看过冰淇淋示例后,我尝试生成一套机器人主题棋子,并展示用户可以查看和编辑不同版本。作为棋迷,我很喜欢定制游戏外观的想法。
Runway 推出了图像生成模型 Frames,宣传重点是视觉保真度和风格一致性。我观看了具有电影、唱片封面、自然和一次性相机美学的示例。这些精选样例让我觉得很出色,但主观印象和公司的宣传并不是独立基准测试。
Amazon 模型与 OpenAI 即将发布的消息
Amazon 推出 Nova 系列并扩大与 Anthropic 的合作。Berman 以当时即将开始的 12 Days of OpenAI 作为结尾。
AWS 在 Bedrock 上推出了 Amazon Nova 模型。在[最初的公告](https://aws.amazon.com/blogs/aws/introducing-amazon-nova-frontier-intelligence-and-industry-leading-price-performance/)中,Micro 是上下文长度为 12.8 万 token 的纯文本模型;Lite 可以处理文本、图像和视频,最多支持 30 万输入 token 和 30 分钟视频;Pro 是更大的多模态选项。这些是发布时的描述。
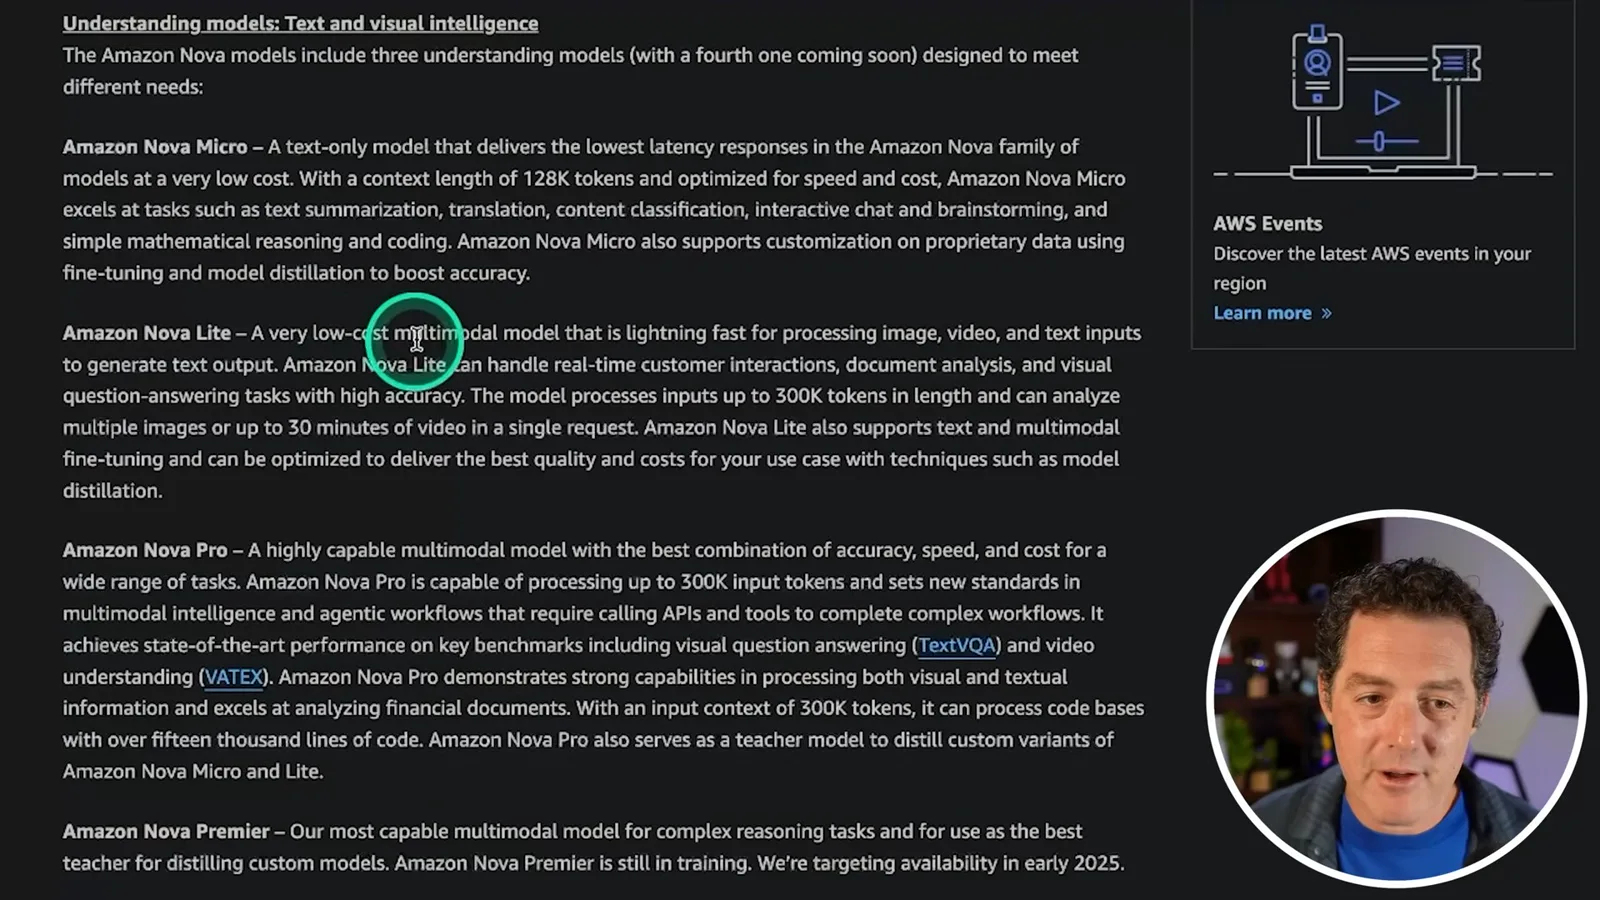
AWS 当时表示,Nova Premier 仍在训练中,目标是在 2025 年初推出。这个预测不是对当前可用性的说明。我欢迎市场上出现新的模型系列,同时将 Amazon 关于性价比的说法视为其自身主张,而非经过验证、适用于所有情况的比较。
Anthropic 还宣布 Amazon 追加投资 40 亿美元,并深化与 AWS 的云服务和训练合作。合作包括 Trainium 硬件和 Neuron 软件栈方面的工作。这个投资数字指的是 2024 年的那次公告,并不代表两家公司此后所有年份的完整合作情况。
最后,Sam Altman 预告了“12 Days of OpenAI”,将在工作日通过直播发布产品或展示演示。录制视频时,我还不知道具体会宣布什么,因此期待后续关注,而不预测其内容。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。