30 秒看懂
Matthew Berman 回顾 2026 年 1 月发布的 Kimi K2.5,重点介绍视觉编程、公布的基准成绩,以及将工作分配给多个子智能体的测试版智能体群。他观看演示、尝试价格调研任务,并考虑在本地运行模型。 相关数字来自 Moonshot 报告的评估或 Berman 当时的演示,并非普遍适用的性能保证。模型权重采用修改版 MIT 许可,部分大型商业服务需满足品牌标识条件。
- 1多模态开放权重Moonshot 称 Kimi K2.5 是从 K2-Base 继续训练的视觉和智能体模型,使用了约 15 万亿个视觉与文本混合 token。
- 2基准测试比较Berman 回顾厂商公布的成绩,包括 SWE-bench Verified 的 76.8 分,以及使用上下文管理的 BrowseComp 的 74.9 分。这些成绩依赖具体配置。
- 3根据视觉输入编程演示包括从视觉输入重建网站,以及用 Python 解迷宫。
- 4并行智能体群协调智能体将任务分配给专业子智能体并汇总结果。Moonshot 报告的运行时间改进适用于其特定评估。
- 5在实践中检验基准Berman 指出模型可能针对基准进行优化,并表示除了看公布的分数,还需要真实场景测试。
- 6价格与硬件Berman 展示的模型生成价格比较和内存估算属于历史示例,并非经过核实的当前价格或通用硬件要求。
要点建议
- Kimi K2.5 是多模态混合专家模型,总参数约 1 万亿,每个 token 激活约 320 亿参数。
- Moonshot 报告称模型在部分智能体、编程和视觉基准中表现出色,但比较结果取决于评估方法和配置。
- Agent Swarm 将工作分配给并行子智能体;其所称加速效果基于特定内部评估。
- 视觉演示包括重建网站、用代码解迷宫和迭代式视觉调试。
- 完整模型的本地部署需要大量内存,具体需求取决于量化、运行环境和工作负载。
- 模型权重使用修改版 MIT 许可,对某些超大型商业产品或服务设有展示名称的条件。
按章节阅读整理后的全文
Kimi K2.5 与公布的基准
Berman 介绍多模态能力、开放权重和智能体群,并回顾 Moonshot 报告的智能体、编程、视觉和成本比较。
Kimi K2.5 是 Moonshot AI 推出的开放权重模型,重点关注编程、视觉和智能体工作。这次发布令我印象深刻,尤其是测试版 Agent Swarm 功能。用户可以通过 Kimi 的服务访问模型,也可以下载后在本地部署,但运行它需要相应资源。
Moonshot 称其智能体群最多可协调 100 个子智能体及 1500 次工具调用,并报告称在其比较的配置中执行时间最多缩短至原来的约 1/4.5。这些数字描述的是公司测试,并不保证每个任务都能获得相同加速。我想在自己的 ClaudeBot 中尝试,但尚未测试这种集成。
据 Moonshot 介绍,K2.5 从 Kimi K2-Base 继续预训练,使用了约 15 万亿个视觉与文本混合 token。它是原生多模态模型,旨在同时处理视觉输入、语言和工具使用。在公布的智能体比较中,我看到 Kimi 在 BrowseComp 和 DeepSearchQA 上表现尤其出色。
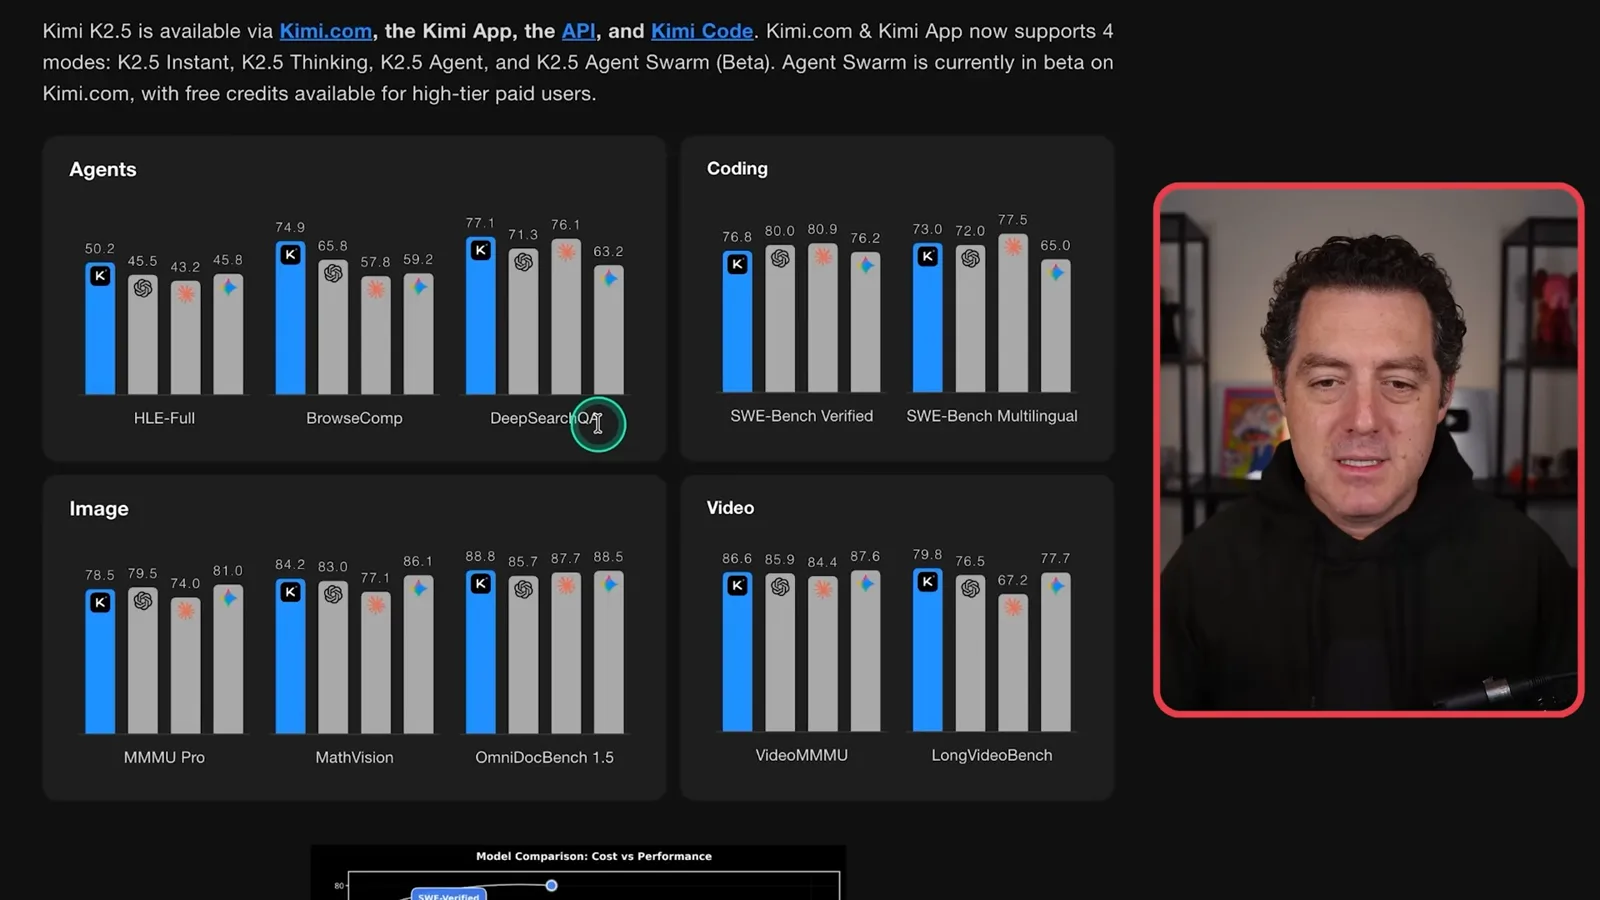
画面上的图表报告称,在使用上下文管理时,BrowseComp 得分为 74.9;编程测试 SWE-bench Verified 得分为 76.8。在这组编程比较中,Kimi 落后于 GPT-5.2 和 Claude Opus 4.5,但高于图中显示的 Gemini 3 Pro。这些是 Moonshot 在指定模型与测试配置下报告的结果,并非普遍排名。
视觉图表显示 MMMU-Pro 得分为 78.5,低于图中的 GPT-5.2 和 Gemini 3,但高于 Claude Opus 4.5;在选定的视频测试指标上也有出色表现。我看到不同模型各有所长,但一张基准图无法证明某个模型在所有编程或视觉任务中都是最好的。
成本是比较的另一部分。Moonshot 图表显示,Kimi 在若干任务上的报告成本更低;Berman 同时指出它的基准表现很有吸引力。价格、测试设置和使用的计算量都会影响比较,因此图表只是起点,并非一成不变的结论。
视觉编程与迷宫演示
示例包括重建网站、寻找迷宫路径和迭代式视觉调试。这些示例展示的是特定任务,并非普遍保证。
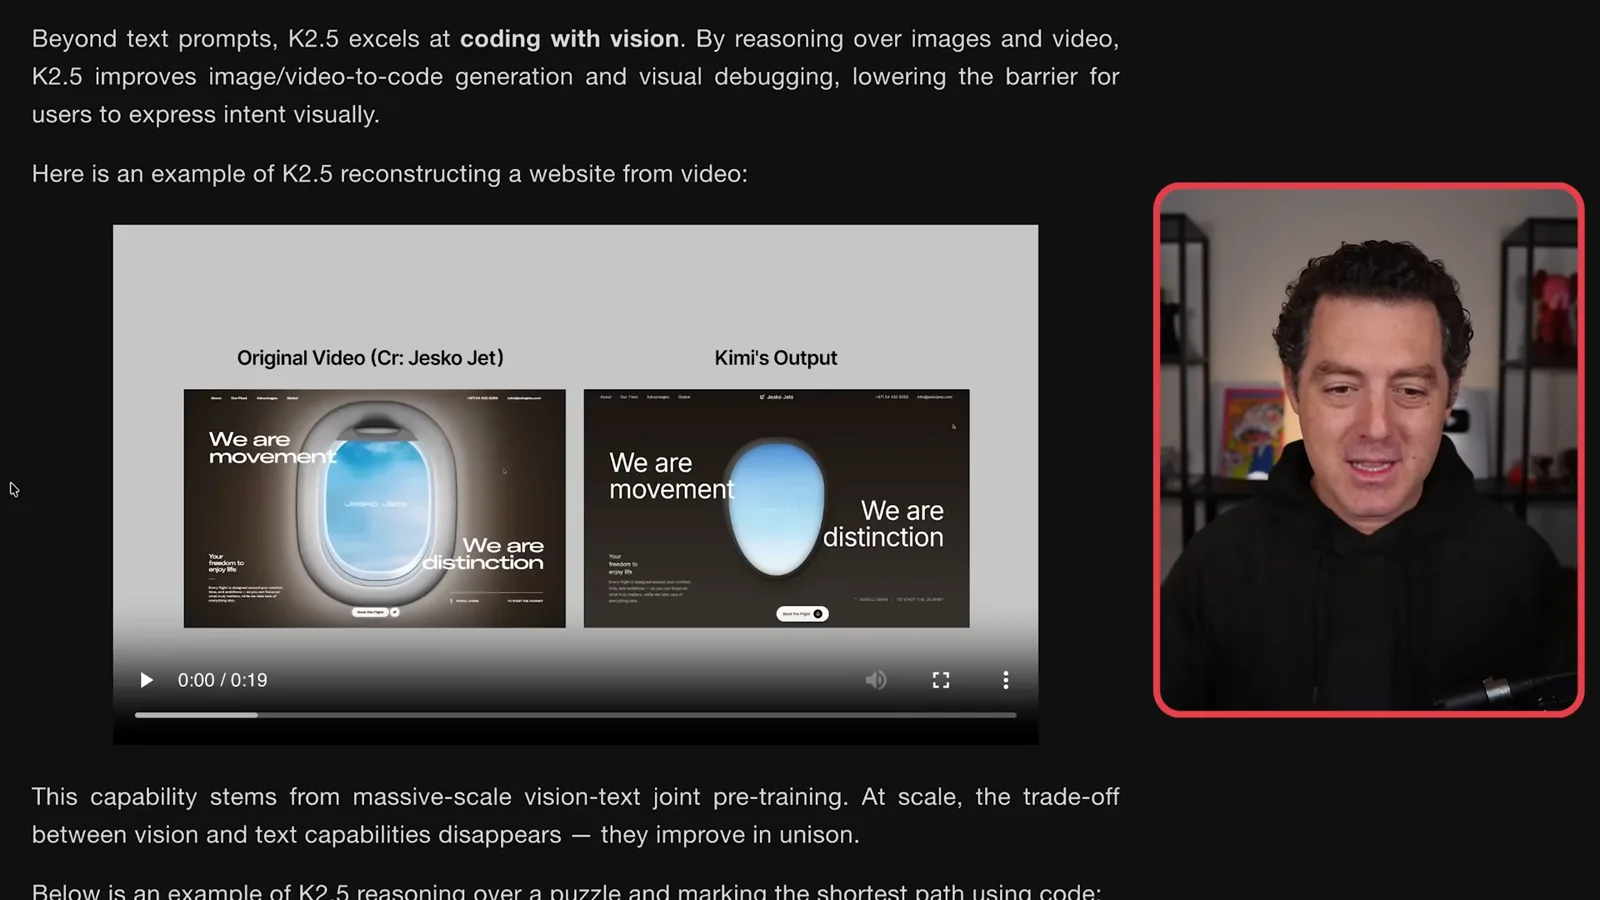
发布页面展示了动画流畅、色彩丰富的网站示例。在一个视觉编程演示中,Kimi 根据视觉输入重建网站,并没有获得网站源代码。Moonshot 将此能力归因于视觉和文本联合预训练;这是经过选择的演示,不能证明它能精确重现所有设计。
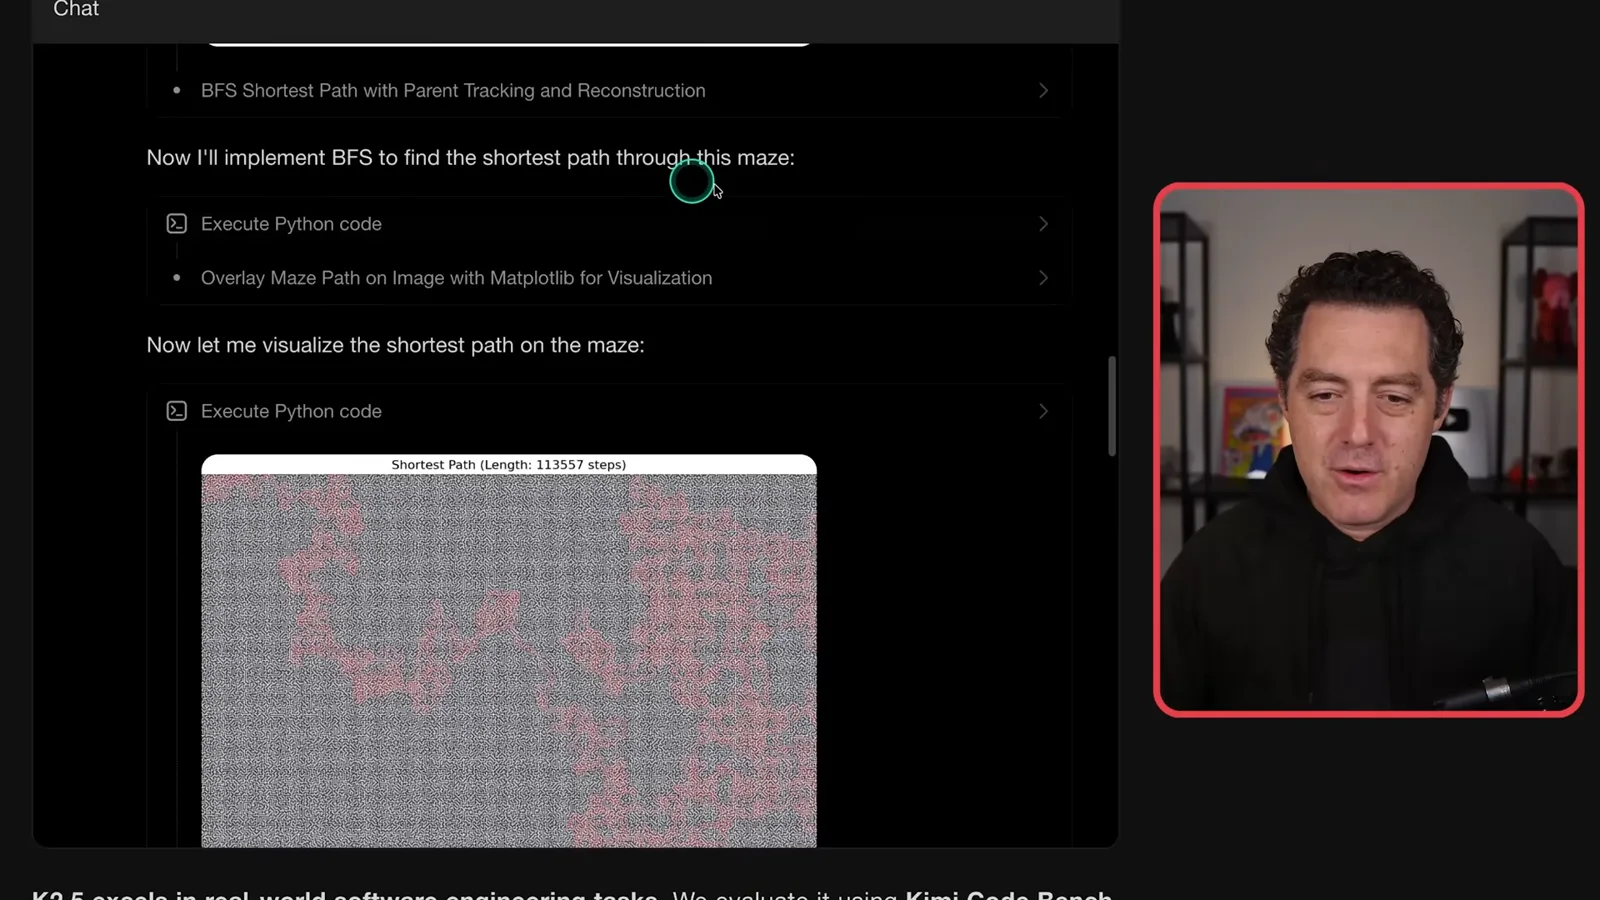
另一个例子要求模型在一张复杂迷宫图片中寻找最短路径。它使用 Python 处理图像、实现广度优先搜索并绘制路线;广度优先搜索是一种算法,不是代码库。展示结果将路径标为约 11.3 万步,放大后更容易查看。
另一个 Kimi Code 演示将马蒂斯《舞蹈》的美学风格融入应用。Berman 描述了迭代式视觉调试流程:编写代码、检查渲染图像、修改代码并重复。展示的过程经过加速,说明的是工作流程,而不是受控的性能测量。
智能体群如何分工
Berman 解释编排、子智能体委派及所称的运行时间改善。一个示例将多个领域的 YouTube 调研任务分发出去。
Moonshot 表示,其并行智能体强化学习方法训练 K2.5 指挥智能体群。协调者将复杂工作拆分成多个部分,交给专业智能体,再汇总结果。我将这个流程与 ClaudeBot 作比较,并想在本地尝试,因为我不想将自己的 ClaudeBot 数据发送到远程服务器。
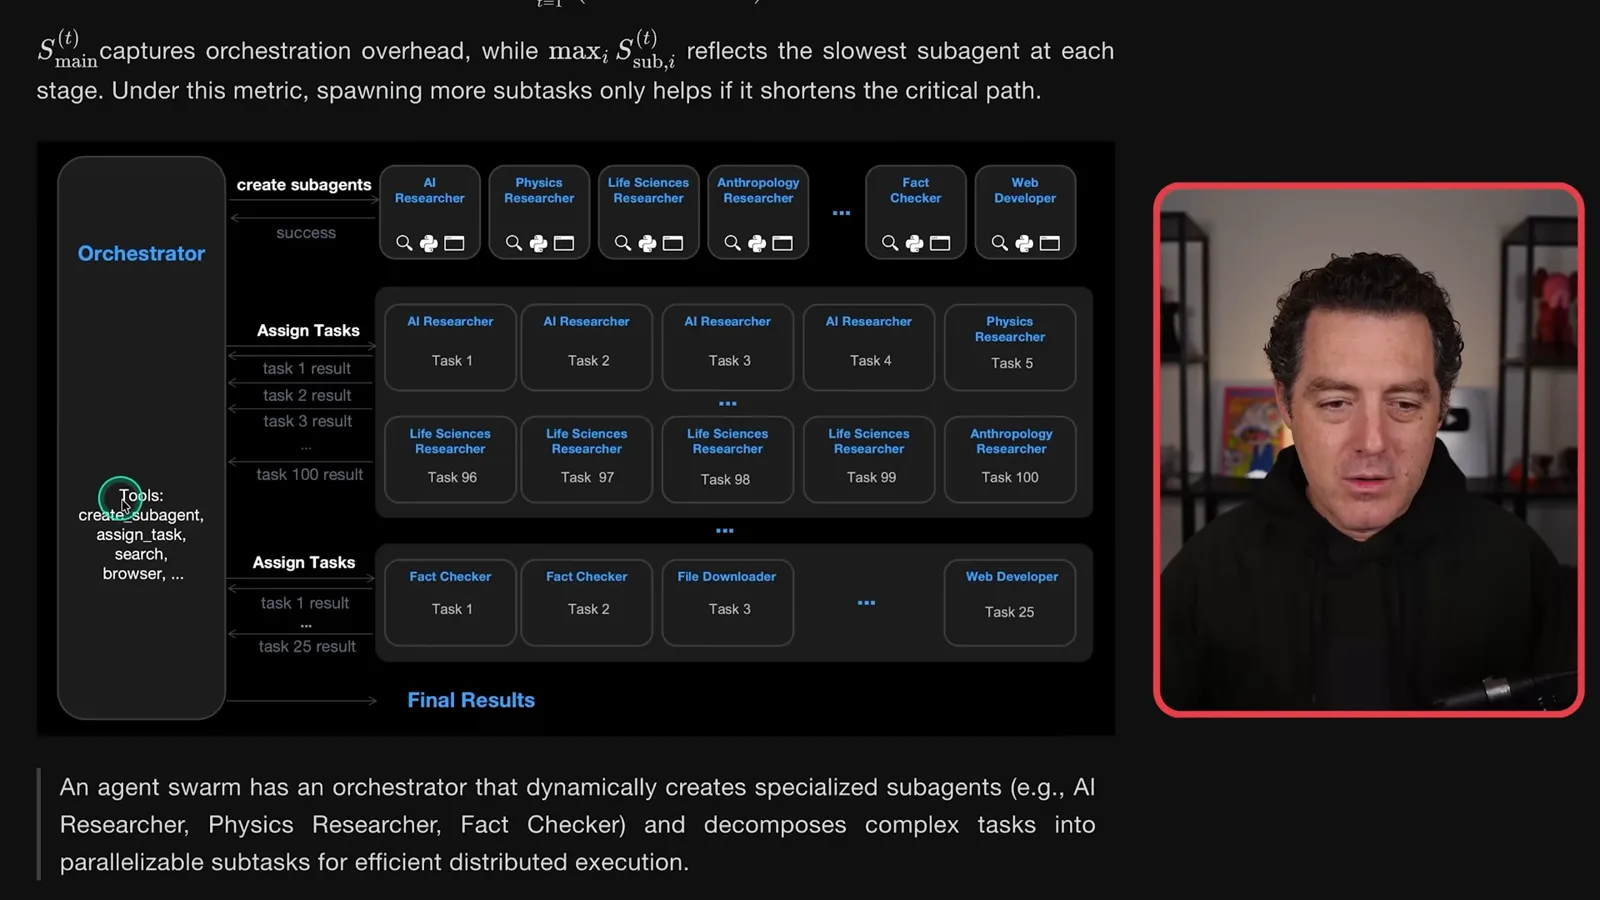
编排示意图展示了研究员、事实核查员和网页开发者等智能体如何接收任务。Moonshot 报告称内部评估中的端到端运行时间最多减少 80%,收益因工作负载而异。并行工作可以缩短关键路径,但协调开销、依赖关系和最慢的子任务仍然重要。
Berman 查看了比较智能体表现和任务复杂度的图表,随后观看一个将研究任务分配到 100 个 YouTube 主题领域的演示。每个子智能体提交一份分析,再由协调者汇总。画面展示了如何拆分大范围任务,但没有独立验证每一项结果。
办公任务与完整基准表
Moonshot 展示文档、电子表格、PDF 和幻灯片。Berman 查看更广泛的基准表,并提醒人们仍需真实场景评估。
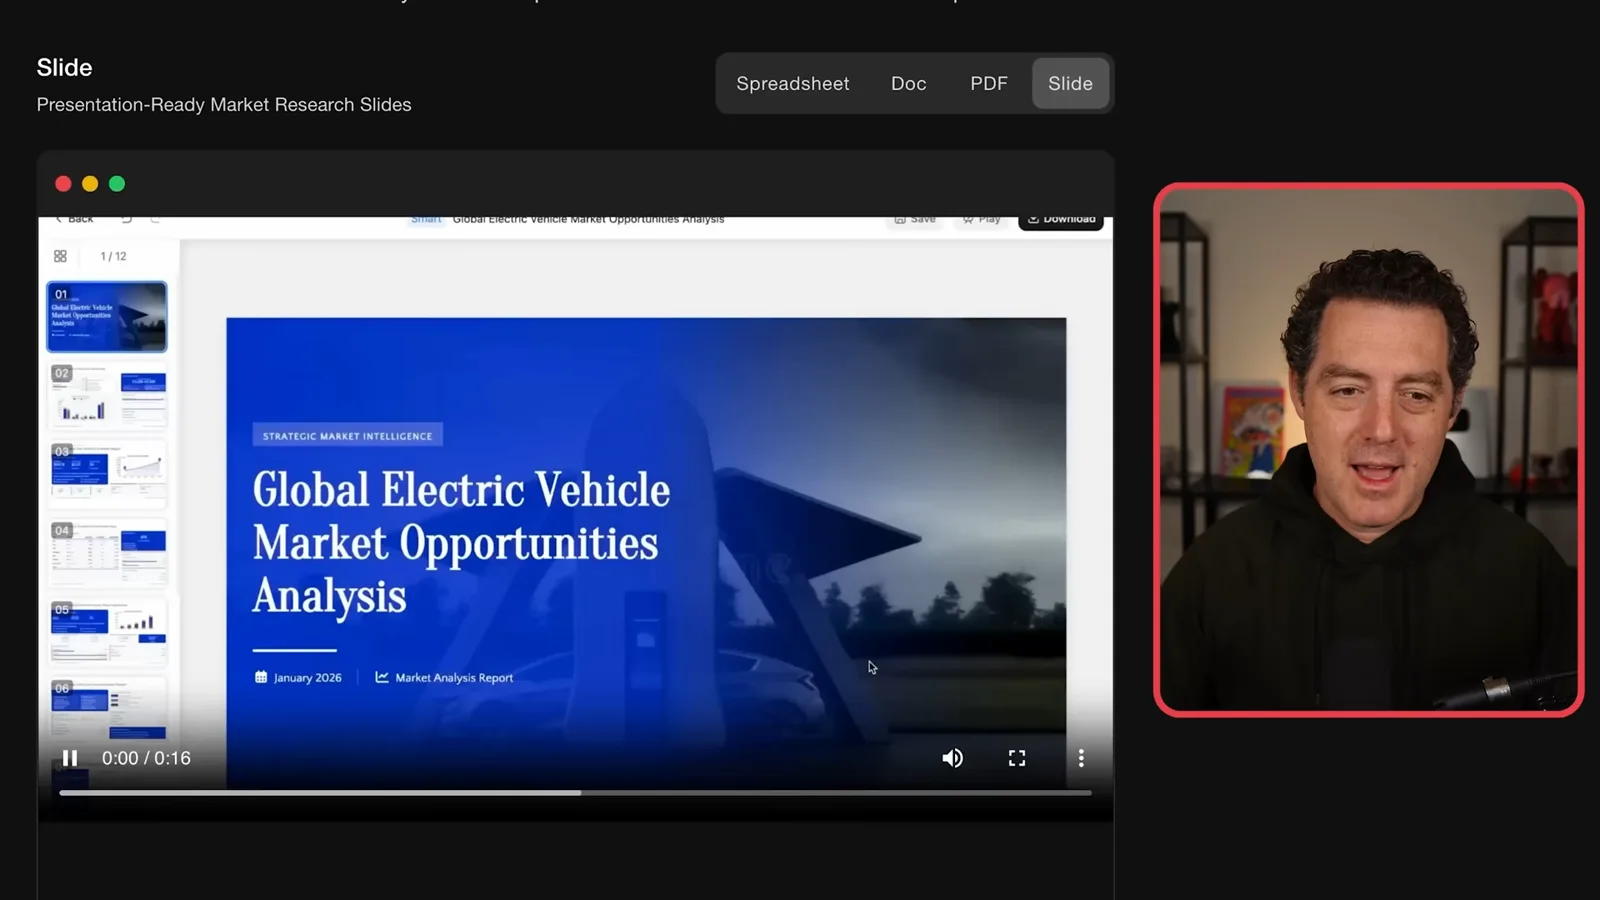
Moonshot 还展示了知识工作任务:为 Word 文档添加批注、用数据透视表构建财务模型、在 PDF 中编写 LaTeX 公式,以及制作幻灯片。Berman 指出,部分办公任务比较使用 K2 Thinking 作为基线。即使成果看起来精致,也仍需检查正确性。
更广泛的基准表在推理、视觉、编程和智能体搜索方面,将 K2.5 与几个同时期的前沿模型作比较。结果因基准而异:视频突出其视觉优势和有竞争力的编程表现,而其他模型在某些测试中领先。例如,厂商的智能体搜索表区分了 BrowseComp 在使用和不使用上下文管理以及使用 Agent Swarm 时的成绩。
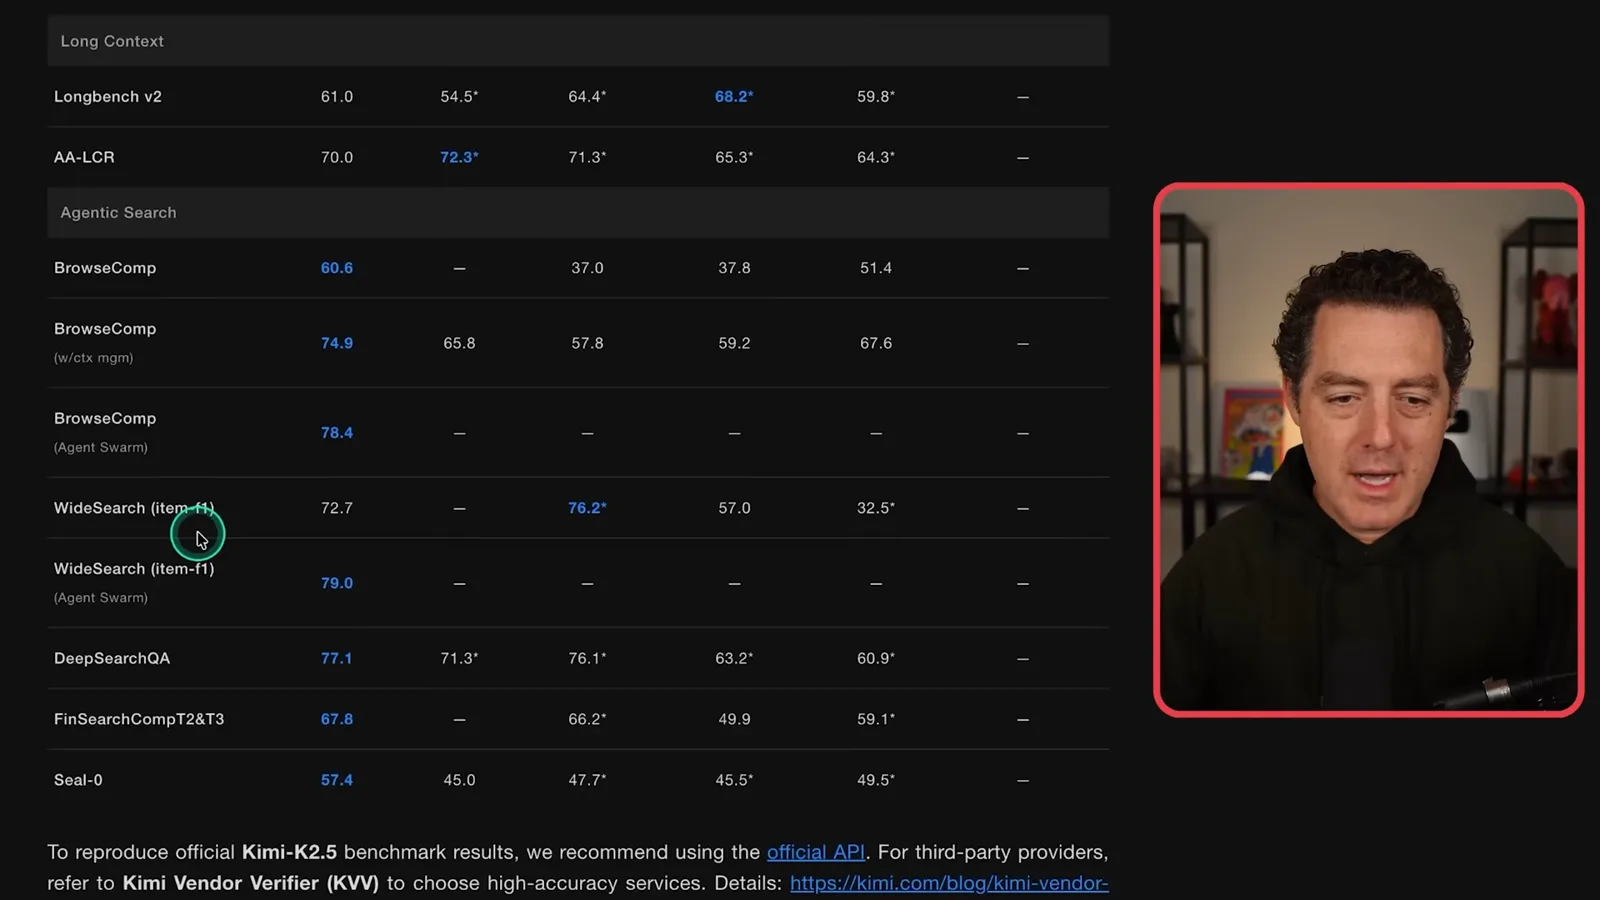
基准测试有助于提供初步信号,但 Berman 提出模型可能针对特定测试进行优化。我想让模型处理实际任务,包括构建应用,而不是只看分数。Moonshot 也提供 API,供人们自行评估。
价格与本地运行
Berman 让 Kimi 调研当时的 API 价格并估算本地硬件需求。他认为完整模型规模很大,并期待社区推出更多版本。
为了现场测试,我让 Kimi 比较其 API 与 Claude Opus 4.5、GPT-5.2 和 Gemini 3 的价格。它搜索网页、编写 Python 并生成比较图。Berman 估计此次会话的响应速度约为每秒 40–50 个 token;这只是观察,并非经过测量的服务保证。
生成的图表列出 Kimi K2.5 每百万输入 token 0.60 美元、每百万输出 token 3 美元,Claude Opus 4.5 分别为 5 美元和 25 美元。这些是 2026 年 1 月由模型生成的比较中显示的数字;价格和条件会变化,读者做决定前应核实服务商当前费率。
随后我询问本地运行需要多少内存。展示的回答估计某种 INT4 配置需要约 632 GB;实际需求取决于权重、量化、运行环境、上下文和卸载方式。K2.5 约有 1 万亿参数,而非 1 万亿个 token,每个 token 约激活 320 亿参数。权重可以下载,并不意味着普通硬件能轻松运行完整模型。
我希望社区推出更实用的量化版本。代码和权重采用[修改版 MIT 许可](https://github.com/MoonshotAI/Kimi-K2.5/blob/master/LICENSE)发布,并非没有条件:超过规定月活用户或月收入门槛的商业产品或服务必须显著展示 Kimi K2.5 名称。我期待测试模型,看看大家会构建什么。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。