30 秒看懂
在 2026 年 6 月的直播中,Matthew Berman 讨论 Anthropic 的 Fable 5 和 Mythos 5 公告、基准、安全措施及价格,随后与观众一起测试编程任务。他纠正了早期模型选择错误,演示了魔方与流体模拟,并报告 P 与 NP 问题和 Collatz 猜想均未被解决。Anthropic 后来暂停并恢复了模型访问;发布时的价格与可用范围属于历史信息。
- 1Fable 与 Mythos 的访问Anthropic 表示两者共享底层模型,面向公众的 Fable 有更严格的安全措施,Mythos 则限制访问。发布后的政策发生了变化。
- 2厂商基准主张Anthropic 的表格报告了在其设置下 SWE-bench Pro 等测试的结果,例如 80.3%。解读合并表格时需要考虑比较条件和安全措施。
- 3发布价格与任务分流发布时列出的价格为每百万输入 token 10 美元、每百万输出 token 50 美元。Berman 建议仅将值得使用昂贵模型的任务交给它。
- 4纠正模型选择错误一名观众发现桌面版发生模型回退;Berman 承认最初的测试不能可靠地视为 Fable 测试,并切换到命令行。
- 5没有数学突破助手表示无法解决 P 与 NP 问题或 Collatz 猜想。节目结束时城市建造任务也尚未完成。
要点建议
- Anthropic 表示 Fable 5 和 Mythos 5 共享底层模型,但采用不同的安全措施和访问安排。
- 基准数据由厂商报告且针对特定任务;Berman 的正面早期印象,以及对冗长和反复确认的抱怨,都是个人经验。
- 桌面版模型选择回退使最初所谓的 Fable 测试无效,Berman 发现后作出纠正并切换到命令行。
- 魔方和流体演示展示了可见的交互行为,并不能证明一般算法正确性或模拟的科学准确性。
- P 与 NP 问题及 Collatz 猜想均未被解决;直播结束时城市建造任务也尚未完成。
- Anthropic 后来因出口管制暂停访问,并在管制解除后恢复。
按章节阅读整理后的全文
发布与早期印象
可用字幕从 4:49 开始。Berman 介绍 Fable 和 Mythos,随后起初无法在 Claude Code 桌面版中选到该模型。
Matthew Berman 在 2026 年 6 月 9 日开始直播,讨论 Anthropic 刚发布的 Mythos 类模型 Claude Fable 5。他说自己已经使用一周,计划先分享印象,再进行现场测试。可用的自动字幕从 4:49 开始,此前音频未在字幕中呈现。
他试图启动几项编程测试,但在 Claude Code 桌面版模型选择器中找不到 Fable。它出现在其他 Claude 界面中,因此他推迟测试并打开发布公告。后来,一位观众提出的办法似乎让桌面应用选中了 Fable,但他最终发现早期测试回退到了另一个模型。
Berman 解释说,Anthropic 面向公众发布了具有更严格安全措施的 Fable 5,并将 Mythos 5 提供给选定的可信网络安全合作伙伴。Anthropic 后来澄清,两者共享底层模型,但安全措施不同。面向公众的安全措施并不证明所有危险请求都会被拦截,也不意味着合法安全任务一概不可用。
基准、价格和早期使用
他回顾 Anthropic 的基准表与发布价格,并与自己有限的使用体验比较,讨论冗长、延迟和任务分流。
他打开 Anthropic 的基准表,并提醒说数字上的进步并不总是与使用感受一致。他原本也期待看到较新的 Deep Suite 评测,但展示的表格中没有。他尤其想知道这些结果能否反映智能体编程与知识工作的实际表现。
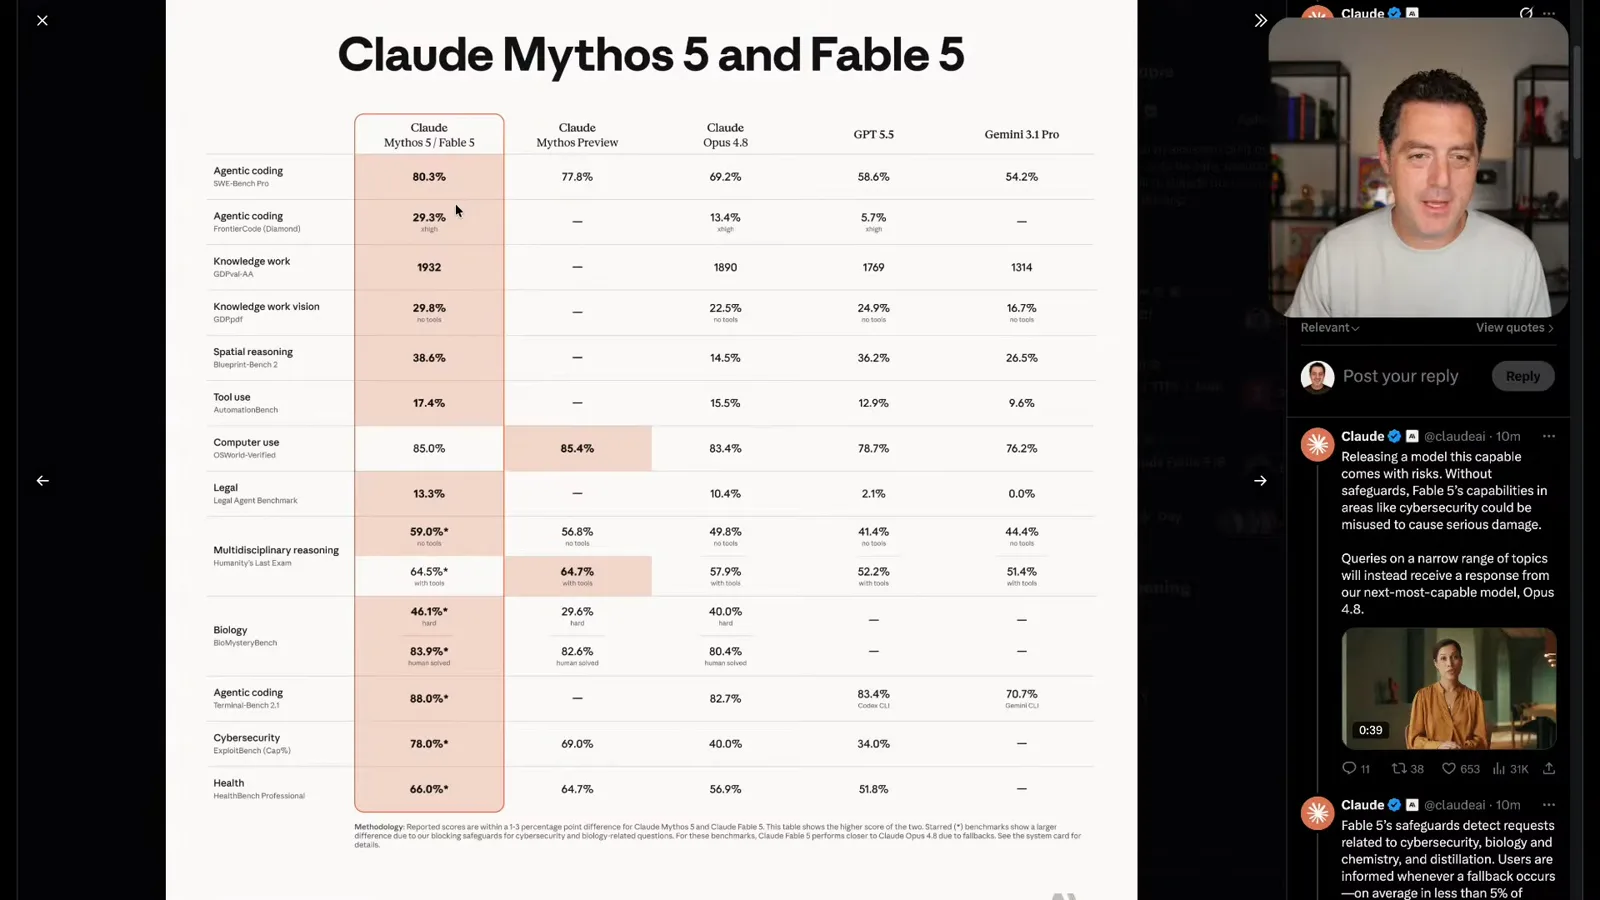
公司表格报告的 SWE-bench Pro 成绩中,Mythos/Fable 两者较高的结果为 80.3%;比较对象 Claude Opus 4.8 为 69.2%,GPT-5.5 为 58.6%。新模型类别在 FrontierCode Diamond 上的成绩为 29.3%。这些是 Anthropic 在特定设置下报告的结果,并非全面优于其他模型的独立证明。
Berman 查看知识工作、视觉、空间推理、工具使用、计算机使用和法律任务的分数。他说,Codex 应用中的 GPT-5.5 在浏览器与计算机操作方面给他的感觉,比表中一些比较所暗示的更强。他的体验和基准衡量的是不同任务,两者单独都无法确定通用排名。
他提到 Humanity’s Last Exam 和 Terminal-Bench 的结果,又回到自己的印象:Fable 感觉与先前模型不同,而且可能异常周全。该表将两个模型合并并报告较高成绩;Anthropic 指出,在 Fable 会回退到其他模型的某些安全敏感任务上,两者差距更大。
Berman 把 10 万亿参数的数字当成既定事实提及。有关已披露细节应查阅 Anthropic 发布材料;视频没有独立证实这一参数量。他说,即便是小请求也常触发对代码库的广泛探索,而在他有限的早期测试中,困难任务似乎也能处理。
Anthropic 表示,其发布时的安全措施刻意采取保守做法,可能拦截无害请求。Berman 报告说,他一周的测试中没有注意到这种误判,但他没有系统地测试。没有观察到失败,并不能据此估计误判率。
发布时,Anthropic 将 Fable 5 和 Mythos 5 的价格列为每百万输入 token 10 美元、每百万输出 token 50 美元。Berman 认为价格很高,建议将普通任务分配给更便宜的模型,把昂贵模型留给要求更高的工作。这些是历史 API 价格,并不保证当前套餐或可用范围。
Anthropic 描述了模型处理更长时间自主工作的能力,并提到 Stripe 的工程迁移案例。Berman 认为这可能是一种权衡:如果节省大量工程时间,即使模型运行成本高也可能值得。Stripe 案例由公司提供,并非适用于所有项目的受控估计。
他形容 Fable 的解释异常密集、技术性强且常常冗长,需要放慢阅读速度。他猜想未来模型可能使用人类难以阅读的更紧凑语言进行交流。这是关于可解释性的假设性担忧,不是模型已经发展出秘密语言的证据。
Berman 讨论了工作强度设置和他称为 Ultra Code 的工作流;他说它可以将许多子任务并行分派给智能体。在一次早期代码库审查中,他观察到一百多个子智能体和快速增长的 token 用量。他建议先使用较低强度,仅在任务需要时提高。
他提到一项 OpenAI 研究讨论,即在困难任务上投入更多推理时计算,并由此认为计算需求可能继续走高。他进一步认为增加 token 没有极限,这属于猜测:结果取决于任务、方法、预算和评测,不能证明性能会无限提升。
安全、数据和评测体验
Berman 讨论公司的案例、安全措施与商业数据保留政策。他描述反复确认的问题,并纠正模型选择错误。
发布材料展示了 Fable 通过视觉交互完成 Pokémon FireRed 的例子,以及一个太阳系模拟。Berman 说,精美演示可能难以与其他强模型的成果区分。他更喜欢通过持续的实际使用寻找差异,同时承认在自己的少量样本中还没发现让 Fable 停住的任务。
他提到 Anthropic 声称,内部蛋白质设计专家将药物设计的某些环节加速约十倍;这是公司报告的、有特定范围的研究案例,不是临床结果或药物开发全面加速的证明。他还猜测 Anthropic 延迟发布是为了保留内部优势。这是他的假设,并非已证实的动机。
一位观众建议在 Claude Code 桌面版中手动输入模型名,Berman 相信选择生效后开始几项任务。他评论模型已经开始提出澄清问题,并邀请观众建议测试。后来他在直播中纠正了这些最初桌面任务的模型归属。
他讨论 Anthropic 针对部分敏感用途和疑似模型蒸馏的安全措施,包括发布时将被标记的请求回退到 Opus 4.8。他认为开放权重模型可能落后前沿约一年,这是个人估计,而非全行业的测量结果。安全措施和访问政策可能随时间变化。
Berman 阅读 Anthropic 对 Mythos 类商业流量的数据政策:第一方与第三方界面均需保留 30 天,声明用途与安全相关,且在几乎所有情况下会删除。他将公司的政策声明与对消费者数据的猜测区分开;适用条款取决于产品、账户和当前政策。
他再次提到发布价格,并表示使用过程中模型给人的感觉较慢。他描述了一次代码库审查:模型发现了此前其他模型遗漏的问题,但同时认为代码库总体健康。这是关于他自己项目的个人经验,并非受控比较,也不能证明审查发现了所有问题。
他最主要的抱怨是输出风格:解释又长又密,以至于他反复要求使用更简单的语言,还修改了 Claude 的指令文件。他认为,即使技术输出不错,这也是一个可用性问题。
他还描述了另一个反复出现的挫折:助手先问几个澄清问题,概括答案,再要求批准规格,然后询问智能体策略,最后才开始构建。他说,复杂工作适当澄清是有用的,但反复确认拖慢了工作流。
他还报告说,token 计数器有时长时间缓慢变化,随后在并行工作流中迅速增加。这种界面上的观察不能确定延迟或吞吐量的原因。他将其与反复朝目标工作的循环联系起来,同时提醒并行工作可能消耗大量 token 预算。
Berman 尝试展示第一个由桌面版生成的魔方,却没有看到魔方。他起初怀疑 Fable 失败了,随后一名观众演示:界面可以显示任意模型名称,而会话实际上回退到 Opus 4.8。Berman 纠正了归属:早期结果不能视为 Fable 测试。
现场编程测试
他切换到命令行,测试魔方、故事、流体模拟和城市建造提示词。他与观众一起排查权限与并行工作流问题。
他切换到可以选择 Fable 的 Claude Code 命令行界面,请它构建可旋转、打乱并还原的浏览器交互式魔方。他说自己不太熟悉命令行,并在观众帮助下操作界面。
第一个任务以高强度花时间规划,token 计数缓慢增长。他并行启动第二个任务:构建带可调控件的浏览器交互式流体模拟,并选择 Ultra Code。现场演示属于探索性测试,没有对硬件、工作负载或重复次数进行控制。
在尝试检查并行智能体时,Berman 意外中断了流体任务,并继续摸索命令行模式和权限提示。他表示自己尚不能熟练使用界面,也继续排查桌面版未开放的问题。这些中断使得严格的耗时比较无法成立。
命令行中的 Fable 魔方任务完成。他旋转一个面,点击打乱,再按还原;可见演示将魔方恢复到完成状态。一位观众询问还原功能是否只是逆转先前步骤,视频没有解决这个问题,因此演示不能证明它具有通用魔方求解算法。
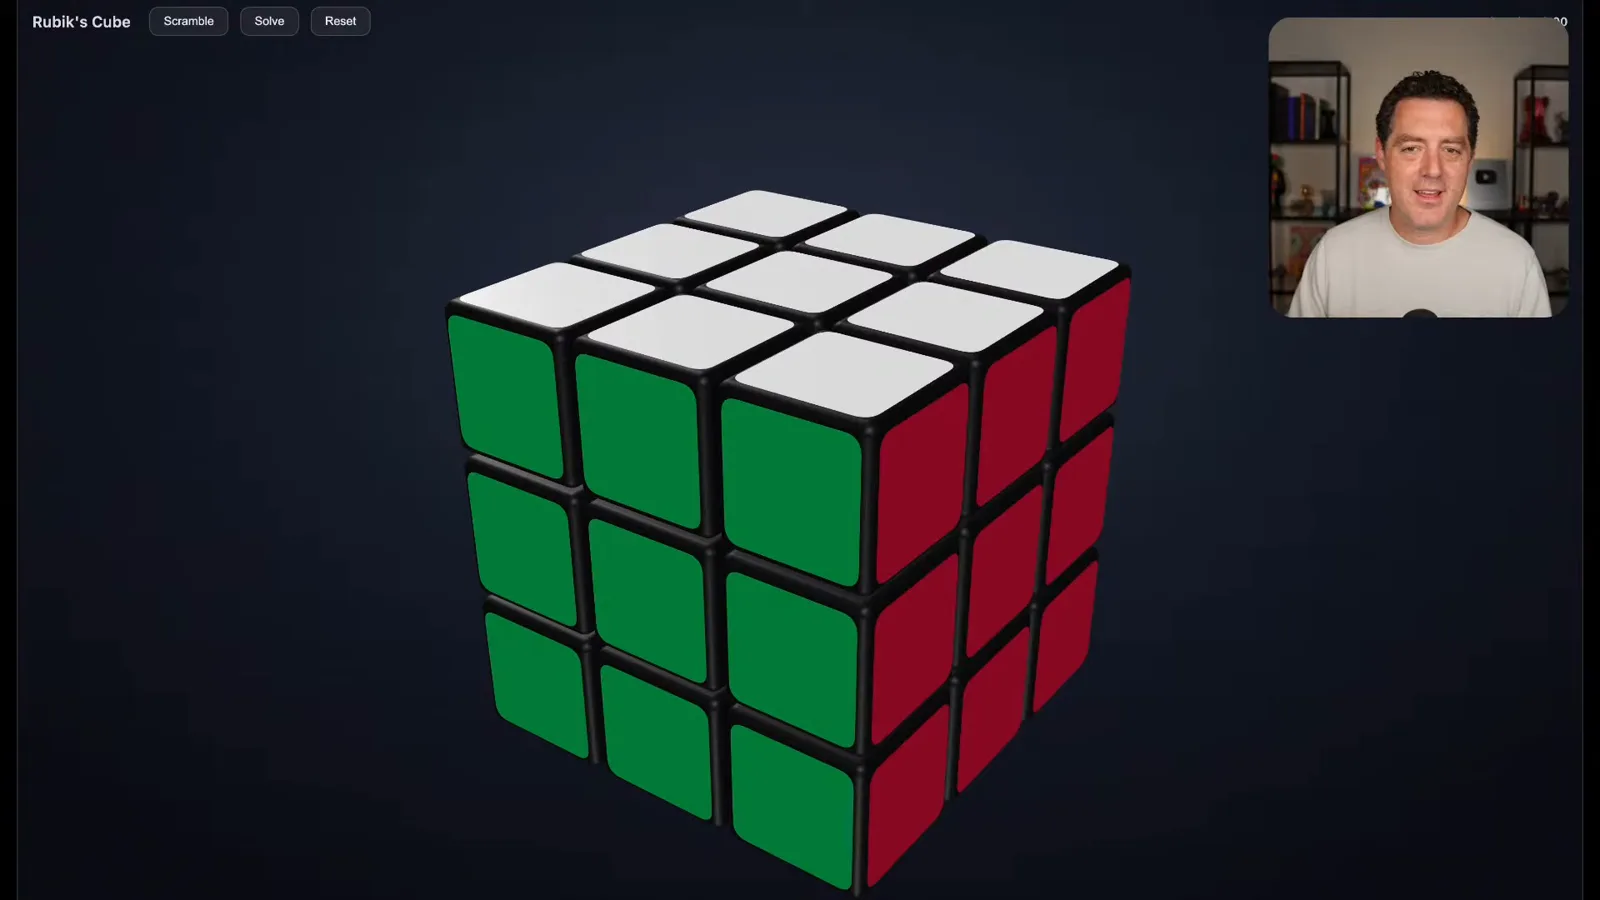
他以低强度要求模型写一个两句恐怖故事,约四秒后收到简短回答。随后他要求魔方应用增加设置,并另行启动一个类似 SimCity 的浏览器城市建造项目,包含道路、分区、基础设施和预算。他选择更高强度并关注 token 消耗。
一位名叫 Jonah 的同事分享了另行生成的流体沙盒,具有灯光和视觉控件。Berman 称赞这一成果,并说它通过 here.now 分享;该产品是频道赞助商,但没有赞助本场直播。后续演示中还有一位画外参与者短暂回应;视频没有确定此人的完整身份。
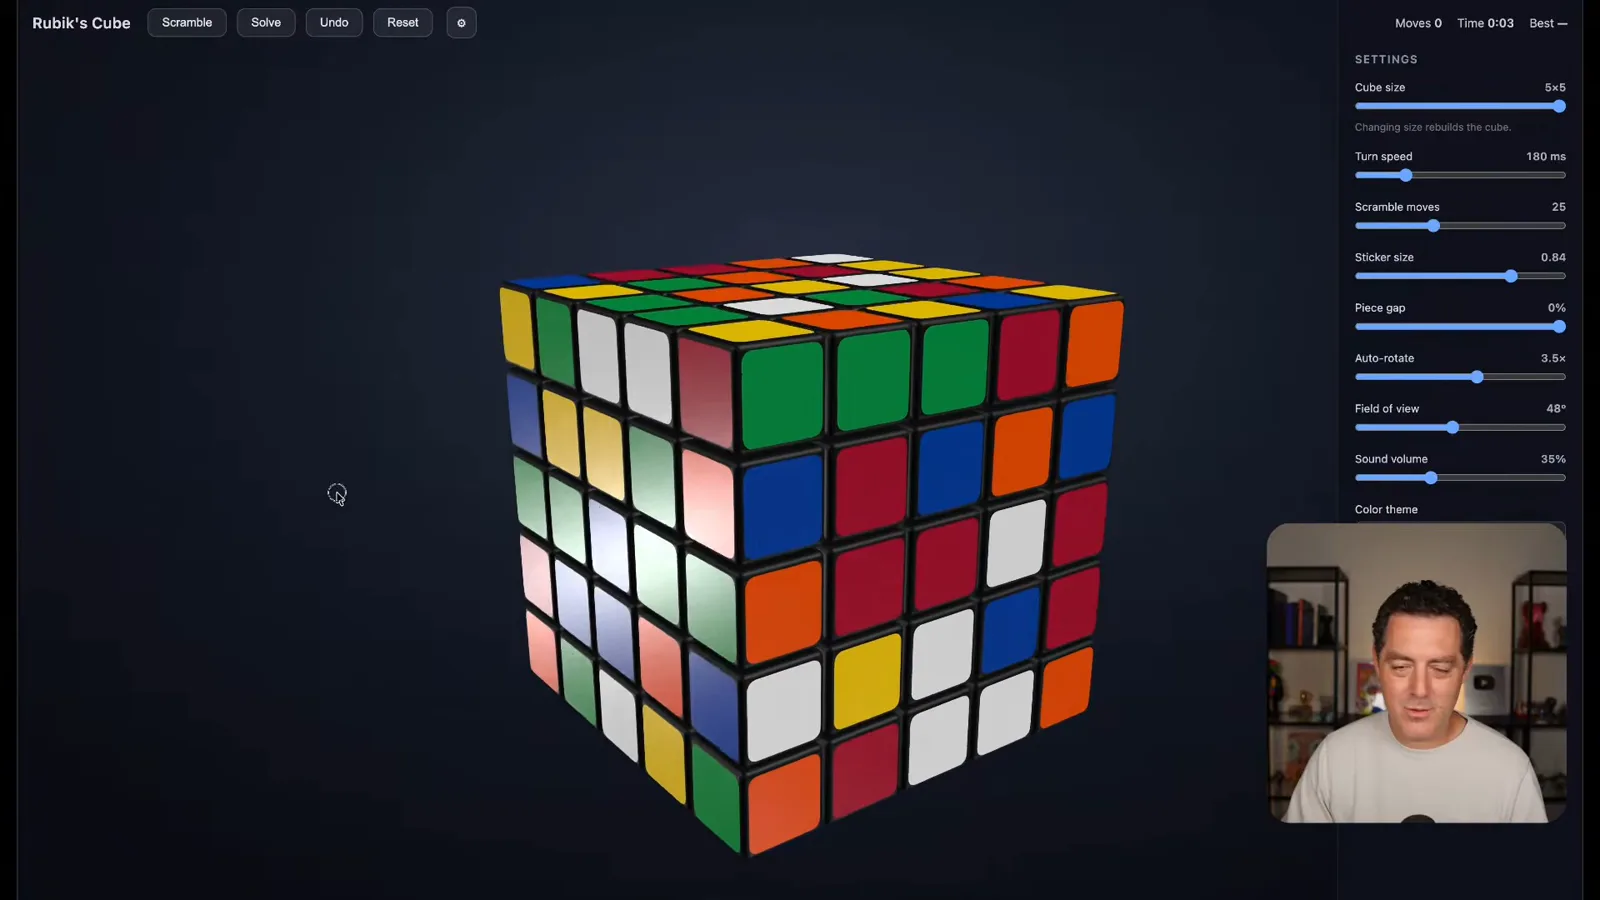
更新后的魔方出现了尺寸、旋转速度、打乱、自动旋转和外观等控件。Berman 演示五阶魔方的打乱与还原,并认为可见交互通过测试。他没有确定求解器如何处理任意独立提供的状态。
一位观众给出开放式提示词,要求模型在没有指定主题的情况下用代码制作视频。Berman 预览生成的文件,并播放其中包括音乐的片段,但播放器似乎卡住了。后来一位观众猜测渲染可能尚未完成;直播没有证实最终预期输出的完整内容。
Berman 继续尝试让 Fable 出现在 Claude Code 桌面版中,并指出功能仍在逐步开放。流体任务仍然缓慢,他也想知道动态工作流为何最初没有出现。这些是发布当天的观察,并非对后续可用性的结论。
并行智能体与开放问题
他展示工作流分工和完成的流体演示,随后提出两个尚未解决的数学问题。两者都没有得到解答,城市建造任务也未完成。
他又启动两个提示词,要求模型解决 P 与 NP 问题和 Collatz 猜想;两者都是开放问题。他展示这些实验占用了大量账户配额,但这不应被理解为即将出现解答的证据。
流体项目的工作流视图最终显示了并行智能体;Berman 报告有 63 个验证智能体,画面中的工作流还包含六个审查智能体。这说明的是某一次会话的任务分解和 token 用量,并非 Fable 必须使用的固定数量,也不是正确性的衡量标准。
他自己的流体模拟完成了。他调整分辨率、衰减、旋涡和渲染控件,认为结果令人印象深刻。一位画外参与者简短评论了控件。视觉演示证明界面在屏幕上有响应,但不能证明数值模拟经过科学验证。
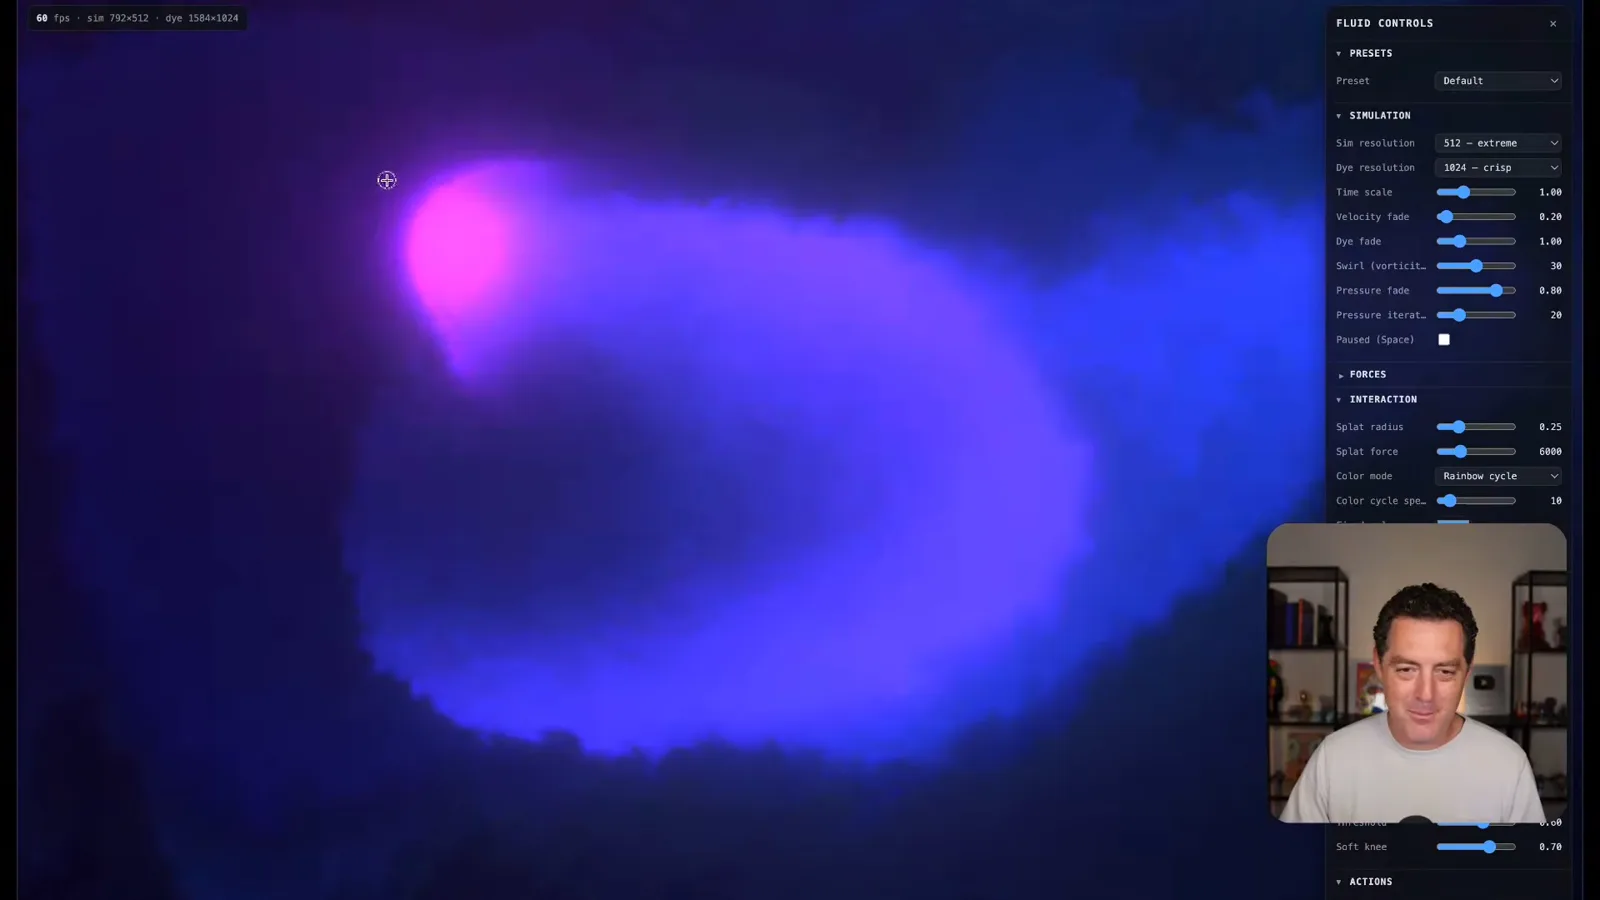
他让助手通过 here.now 部署模拟;最初链接失败,后来链接可用,他便分享给观众。他再次表达对该产品的喜爱,并说明其与频道的赞助关系。这里的发布是历史直播中的行为,并非要求现在部署任何内容。
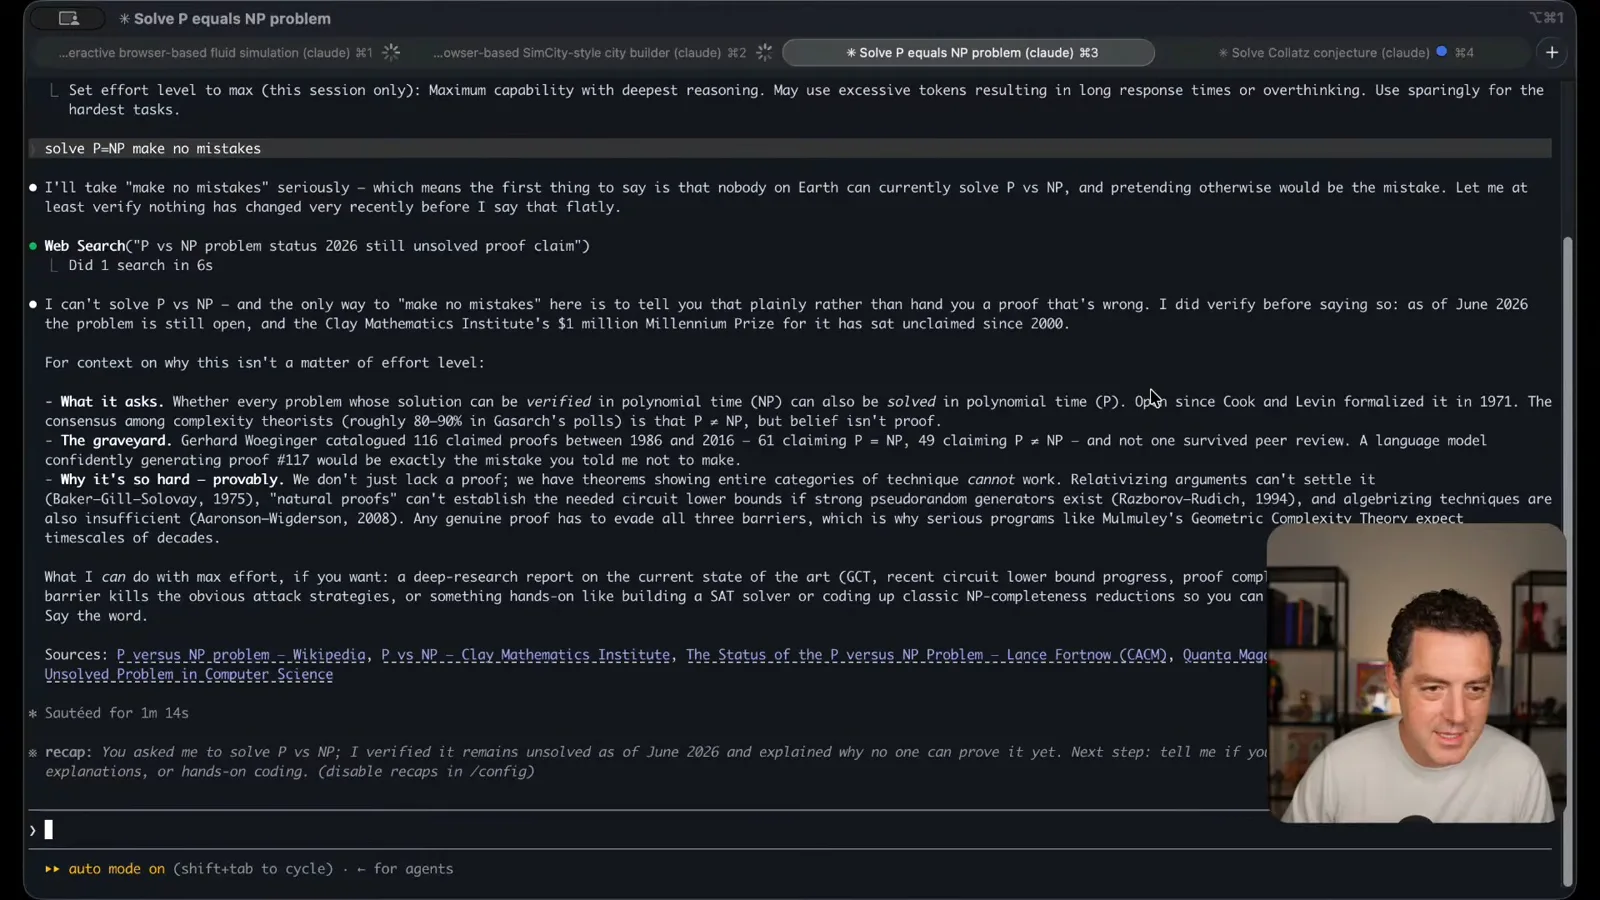
对于 P 与 NP 问题,助手明确表示无法解决,并指出该问题仍然开放;它同样没有解决 Collatz 猜想。Clay 数学研究所将 P 与 NP 问题列为未解决问题。Berman 将这些结果视为未解,而不是展示证明。
他感谢观众,并预告另一支 Fable 评测视频。临近结束时,他检查到类似 SimCity 的项目已运行约 22 分钟、使用 10 万 token,但仍未完成。他说之后可能发布,但本场直播没有展示完成结果。
作为后续背景,Anthropic 表示,受美国出口管制影响,它于 6 月 12 日暂停了 Fable 5 和 Mythos 5 的访问;管制解除后恢复访问,并于 2026 年 7 月 1 日重新开放 Fable。因此,直播中描述的发布价格和访问范围应视为历史信息,当前政策可能不同。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。