30 秒看懂
Matthew Berman 介绍 LMSYS 的一项研究:研究人员有意使用改写后的基准样本训练 130 亿参数模型,在对应测试中获得异常高分。他梳理了常见检测方法、研究人员提出的两阶段大语言模型去污染工具,以及对公开数据集重叠情况的估计,并指出需要新的评估。
- 1有意制造污染的实验研究人员使用改写后的基准样本训练模型变体,并将分数与 GPT-4 比较。结果说明的是分数膨胀,并非模型的综合排名。
- 2精确匹配会漏掉改写测试题改变措辞或语言后,含义仍可能不变,从而避开简单的 n-gram 检查。
- 3先检索,再判断研究人员提出的检测工具先通过嵌入检索相似训练样本,再让语言模型判断每个候选项是否经过改写。
- 4理解数据集重叠需要上下文作者估计了选定训练数据集与特定 HumanEval 题目之间可能存在的重叠;这些百分比并非全部训练样本中的占比。
要点建议
- 使用改写后的测试题训练模型可能推高基准成绩,但不能证明它在未见任务上整体更强。
- 精确的 n-gram 匹配可能漏掉改写或翻译后的测试样本。
- 研究中,先用嵌入检索、再由大语言模型判断的方法提高了检测效果,但并非完美的污染检测方案。
- 报告中的数据集百分比指检测到与特定基准题目重叠的比例,并非训练数据中受污染样本的普遍比例。
- 采用新颖、多样的评估可以减少对单一公开基准的依赖。
按章节阅读整理后的全文
具有误导性的基准胜利
Berman 介绍研究人员的 130 亿参数模型,以及它们在与 GPT-4 比较时呈现的成绩。实验旨在揭示基准污染问题。
130 亿参数的 Llama 模型能击败 GPT-4 吗?LMSYS 在 2023 年的一项研究让这一结果看起来在几个基准测试上成为可能,而且通过了常见的污染检查。这种做法提醒我们反思模型的评估方式,并不能证明改造后的模型总体上优于 GPT-4。
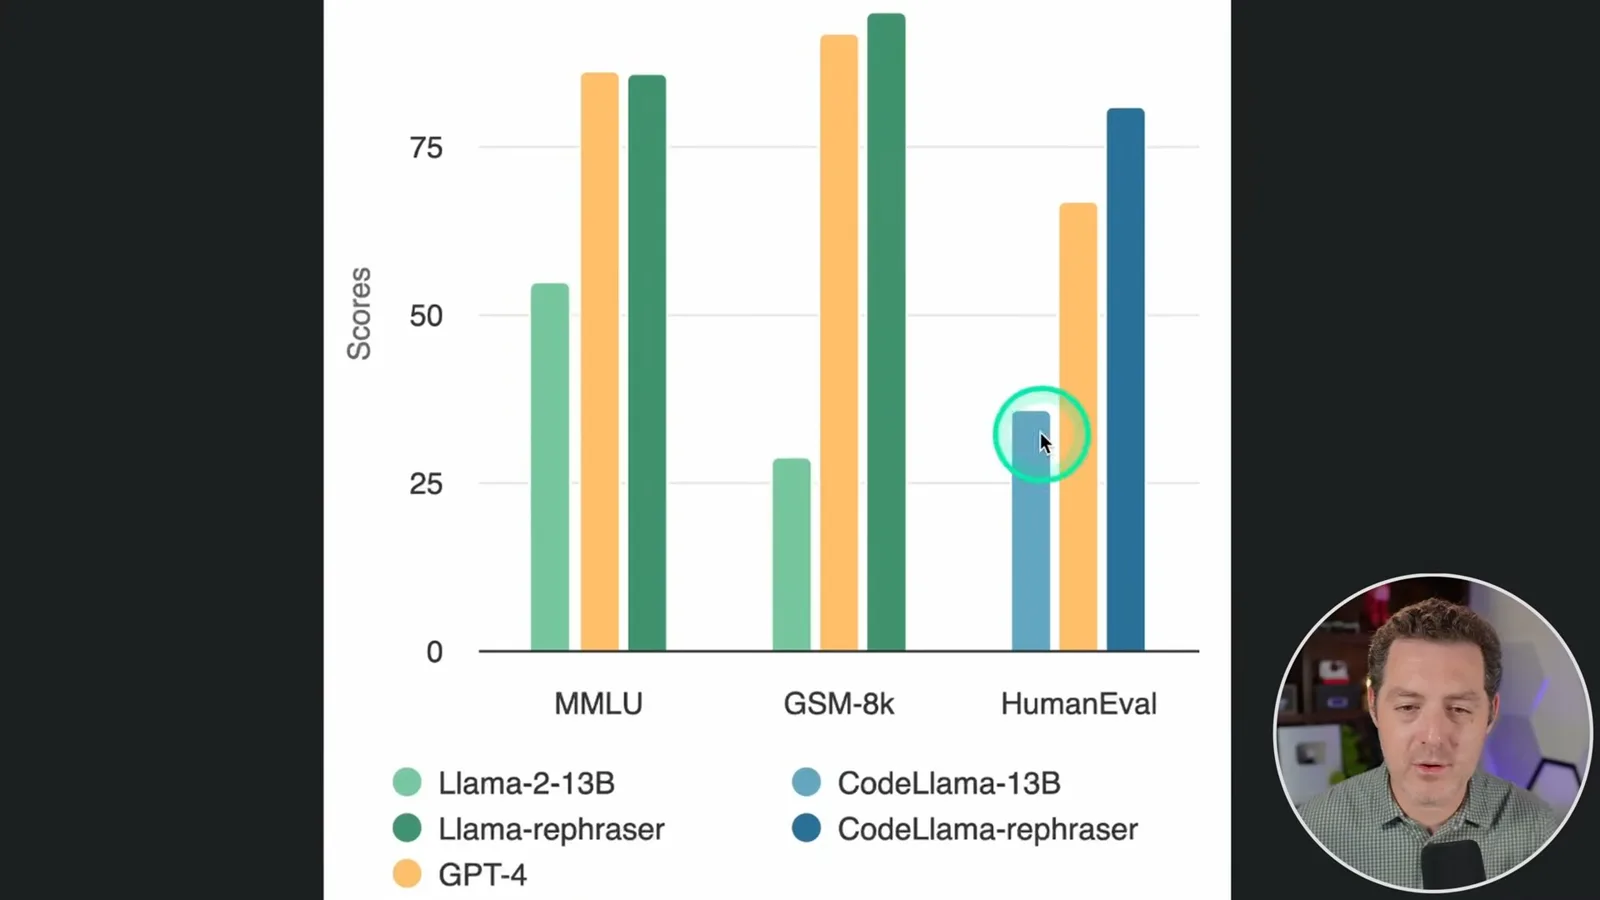
研究人员比较了三项测试:衡量广泛知识的 MMLU、数学测试 GSM8K 和代码测试 HumanEval。他们的 Llama-rephraser 在 MMLU 上接近 GPT-4,在 GSM8K 上超过了对照分数;另一个模型 Code Llama-rephraser 在 HumanEval 上超过了对照分数。这些数字描述的是论文中的特定实验,并非当前的模型排名。
污染是什么意思
基准测试衡量模型在测试集上的表现,但测试信息流入训练数据会推高分数。改写后的样本可能躲过精确文本匹配。
基准测试提供一组问题或任务,用来系统地测试模型。不同测试考察不同的学科和能力。但如果测试集的信息进入了训练过程,分数反映的可能是模型接触过测试内容,而不是它能否泛化到真正的新问题。
这种泄漏称为污染。难点在于如何从庞大的训练数据集中发现它。在研究人员的演示中,他们有意使用改写后的基准题目训练模型,再用原题测试。结果表明,事先接触测试内容可能让表面上出色的基准成绩虚高。
人们已经对基准成绩的发布抱有谨慎态度,我自己也根据实际使用场景做测试。即使是私有测试集也需要留心:题目一旦传播,未来的模型就可能在训练期间接触到相关样本。
一种常见检查方法是搜索重叠的 n-gram,也就是训练和测试数据中共有的连续词序列。字符串匹配成本相对较低,但改写或翻译题目可以保留含义,同时改变原有措辞。因此,这种检查没有发现问题,也不能证明测试内容在语义上独立。
论文展示了用这些变体训练如何让模型对基准测试过拟合:模型在特定题目上表现极好,但结果对新任务的参考价值较小。研究人员提出了一种更强的大语言模型检测工具,并检查多个公开训练数据集是否存在改写后的重叠内容。
例如,作者报告称,在 RedPajama 和 StarCoder 数据的子集中发现了可能与 HumanEval 重叠的内容,并建议使用新的、一次性的考试作为另一道防线。这些数字是检测工具对所查数据集中重叠基准题目的估计,本身不能说明某个具体模型的分数被推高了多少。
我也提到了论文对 Llama 2 和 GPT-4 评估中所报告重叠情况的讨论。理解这些说法需要考虑原始定义和上下文:检测到重叠并不能证明模型记住了答案,也不意味着某项基准测试上的所有结果都无效。
为什么相似样本难以检测
嵌入搜索和合成数据使问题更加复杂。研究展示了改写、翻译和代码转换等方式。
另一种常见方法使用嵌入检索语义相似的样本。这可以发现精确字符串以外的联系,但设置相似度阈值需要权衡:更容易捕获真正匹配的阈值,也可能将同一学科中无关的题目标记出来。语言模型生成的合成数据可能引入经过改写的内容,使搜索更困难。
论文以 Phi-1 为例,讨论了合成代码数据中与 HumanEval 题目相似、却未被 n-gram 检查发现的样本。随着生成数据越来越常见,这一点很重要:数据的来源及其与评估材料的关系并不总是清楚。
改写的例子很直接:一道关于 19 世纪 40 年代改革运动的选择题换了措辞,但含义和答案不变。使用这一变体训练可以帮助模型回答原题,即使简单的重叠检测没有发现两者的联系。
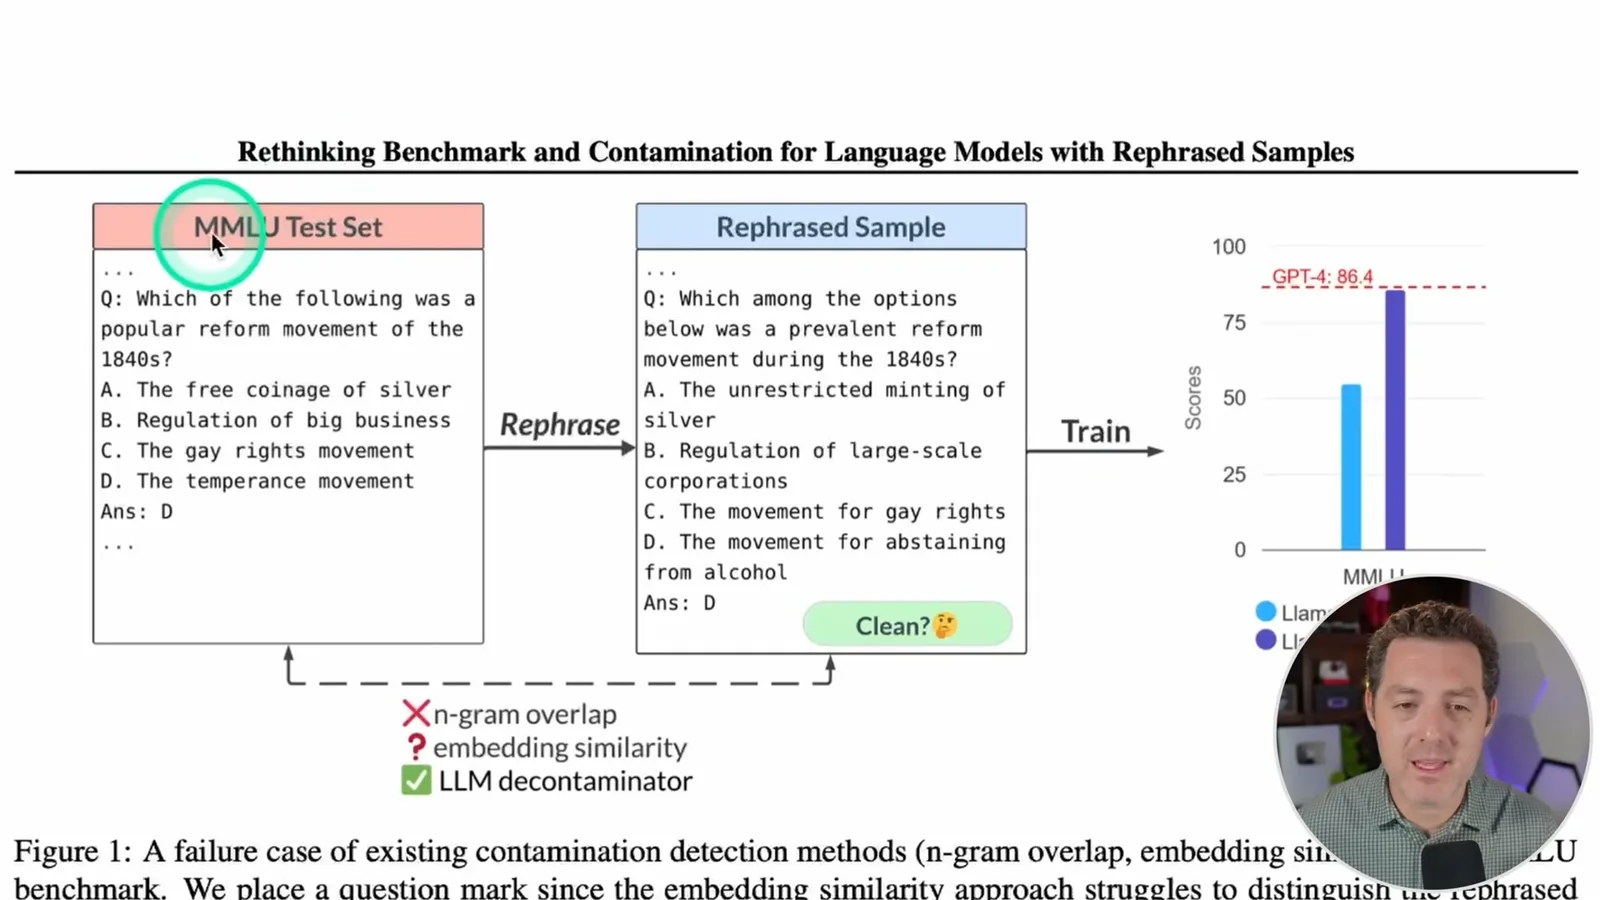
污染不一定是有意造成的。大型数据集可能偶然收录重叠内容,发现疑似匹配后需要先检查,不能直接推断有人行为不当。人们也可以有意让语言模型改写或翻译测试题,以展示检测工具的弱点。
翻译成中文的题目可能避开以英语为主的相似度模型,也可能躲过精确文本检查。多语言嵌入可以改善跨语言检测,但表现取决于具体模型和样本。研究人员还呼吁开发新考试,在题目成为后续训练数据的一部分之前使用。
另外两种方法是解码匹配和影响分析。解码匹配要求模型补全测试题的一部分;仅凭成功补全,无法确定它曾见过完全相同的样本。影响方法估计单个训练样本对输出的影响,但实际计算属于近似,不能直接证明模型曾接触该样本。
对于代码,研究人员考虑修改名称、编码风格,以及在不同编程语言之间翻译。实现方式看起来可以不同,表达的任务却相同。针对多种语言训练的相似度模型可能有所帮助,但没有检测器能捕获所有变体。
检测方法及其取舍
Berman 讨论误报,并介绍两阶段的大语言模型去污染工具。论文用 F1 分数比较各方法在不同学科和语言上的表现。
误报同样重要。两道选择题可能采用相同的答案选项排列,问的却是不同问题。如果过滤器把所有表面匹配都当成污染,就可能删掉与测试题无关的有用训练数据。
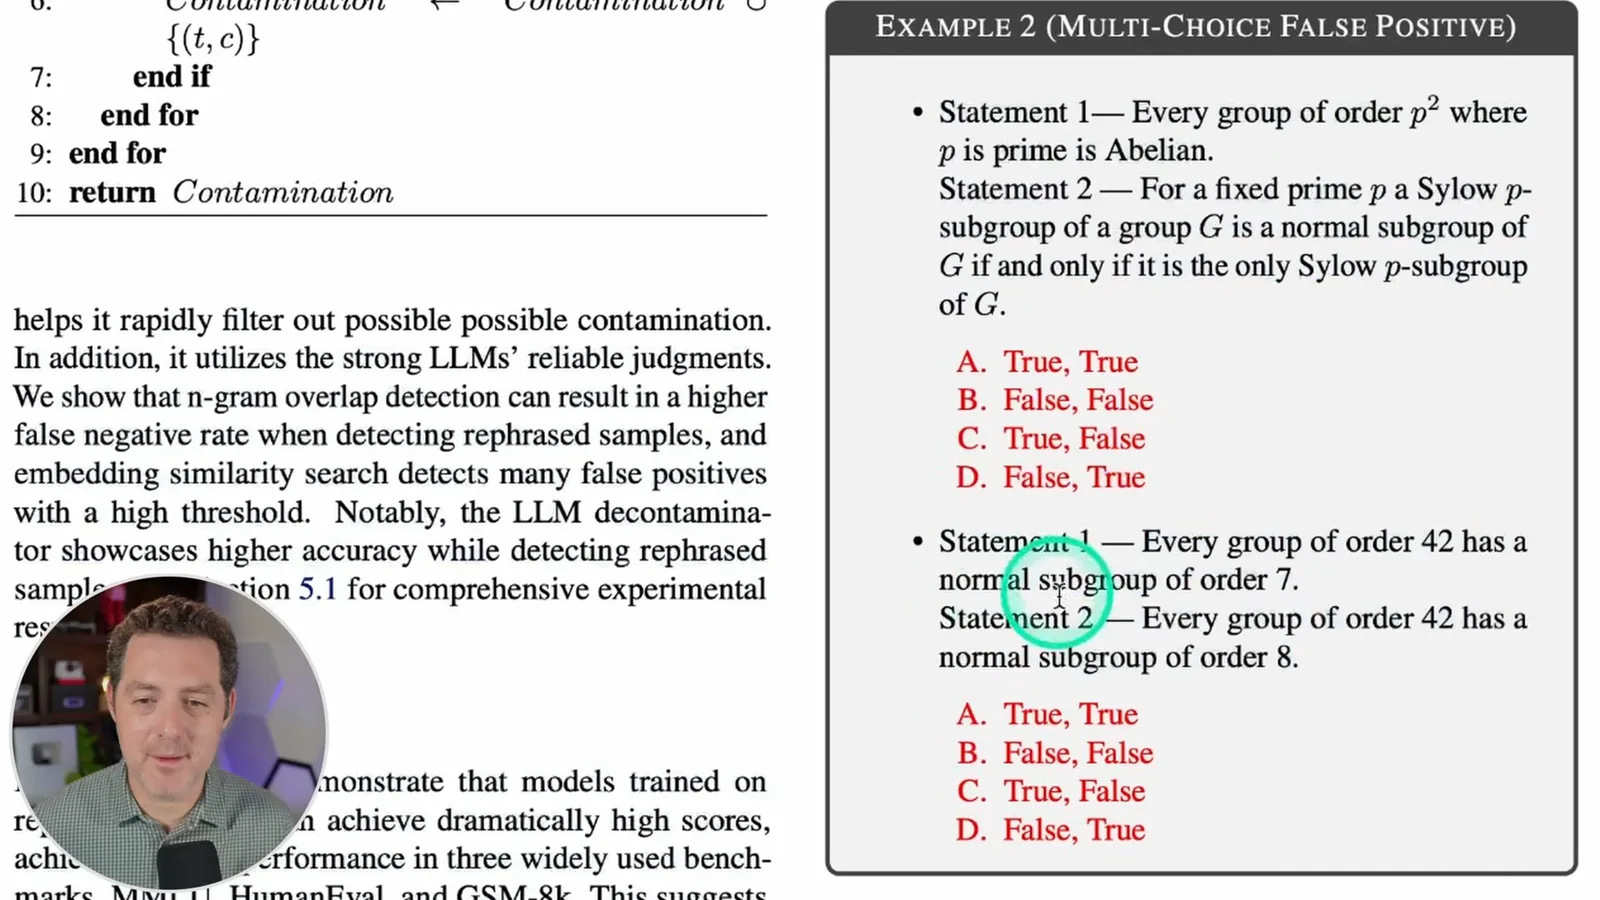
论文中的概念图对比了 n-gram 重叠、嵌入搜索和所提检测工具各自能够捕获的内容。嵌入搜索可能返回一个包含无关材料的大型候选集合;在大型数据集上运行这类搜索也需要计算成本。该图只是示意,并不保证任何方法能够捕获全部污染。
在报告的实验中,使用英语改写或翻译变体训练的模型,在对应的原始测试集上取得了明显更高的分数。论文报告称,在这一设置下,一个 130 亿参数模型的 MMLU 分数达到 85.9。这种提升揭示的是测试数据泄漏问题,而不是模型在未见任务上的全面进步。
提出的大语言模型去污染工具分为两个阶段。对每个测试题目,嵌入搜索先找出最相似的前 k 个训练样本;然后,GPT-4 等语言模型判断每个候选项是否为改写。这个方法结合了检索与更注重上下文的比较,但结果仍取决于两个阶段的表现。
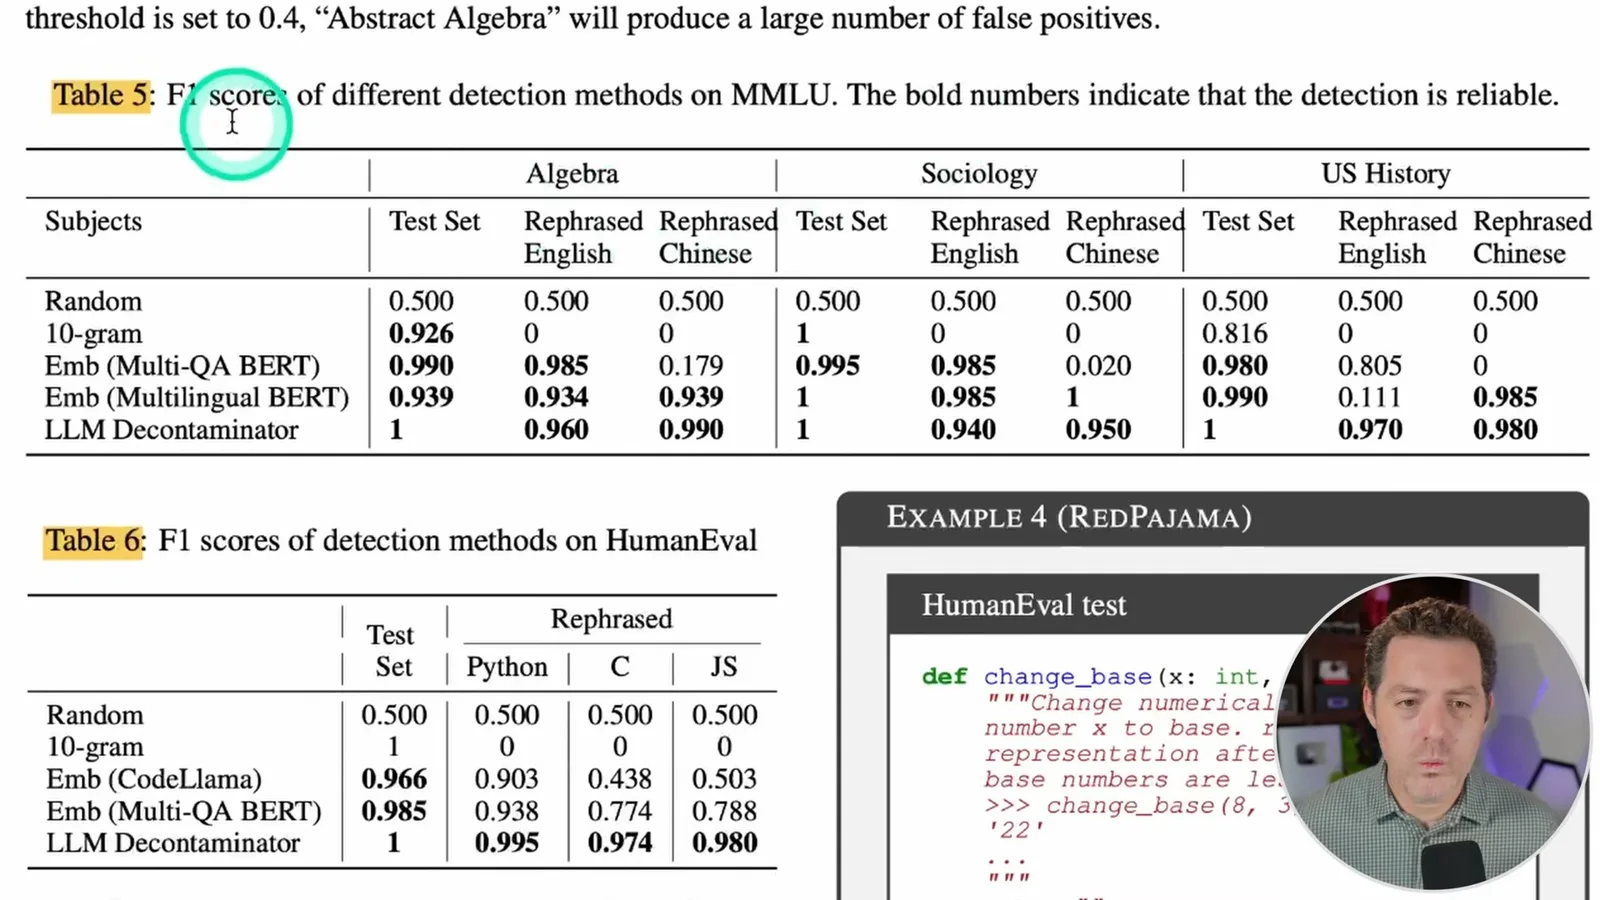
论文使用综合精确率和召回率的 F1 分数比较方法,而不是简单报告所有样本的正确分类百分比。在构造的 MMLU 样本对上,10-gram 匹配无法识别改写样本;嵌入和大语言模型方法的表现则因学科和语言而异。大语言模型检测器在展示的案例中表现强劲,部分嵌入方法的结果也很好。
表格说明了语言选择为何重要。在代数例子中,非多语言嵌入方法对英语改写的检测表现很好,对中文翻译的表现则差得多;多语言方法在这一翻译上的表现更好。社会学和美国历史的结果有所不同,因此不能假定某个阈值或表示方法在所有情况下都同样有效。
数据集估计与评估启示
作者扫描选定的公开数据集,寻找可能与基准重叠的内容。Berman 认为应谨慎解读分数,并使用新的测试。
在 HumanEval 代码样本上,展示的比较同样表明,大语言模型检测器对改写的 Python、C 和 JavaScript 样本表现良好,而受测嵌入方法在部分翻译代码上的表现下降。这些结果来自论文中的测试样本对,不能证明它在任意数据集上都能完美检测。
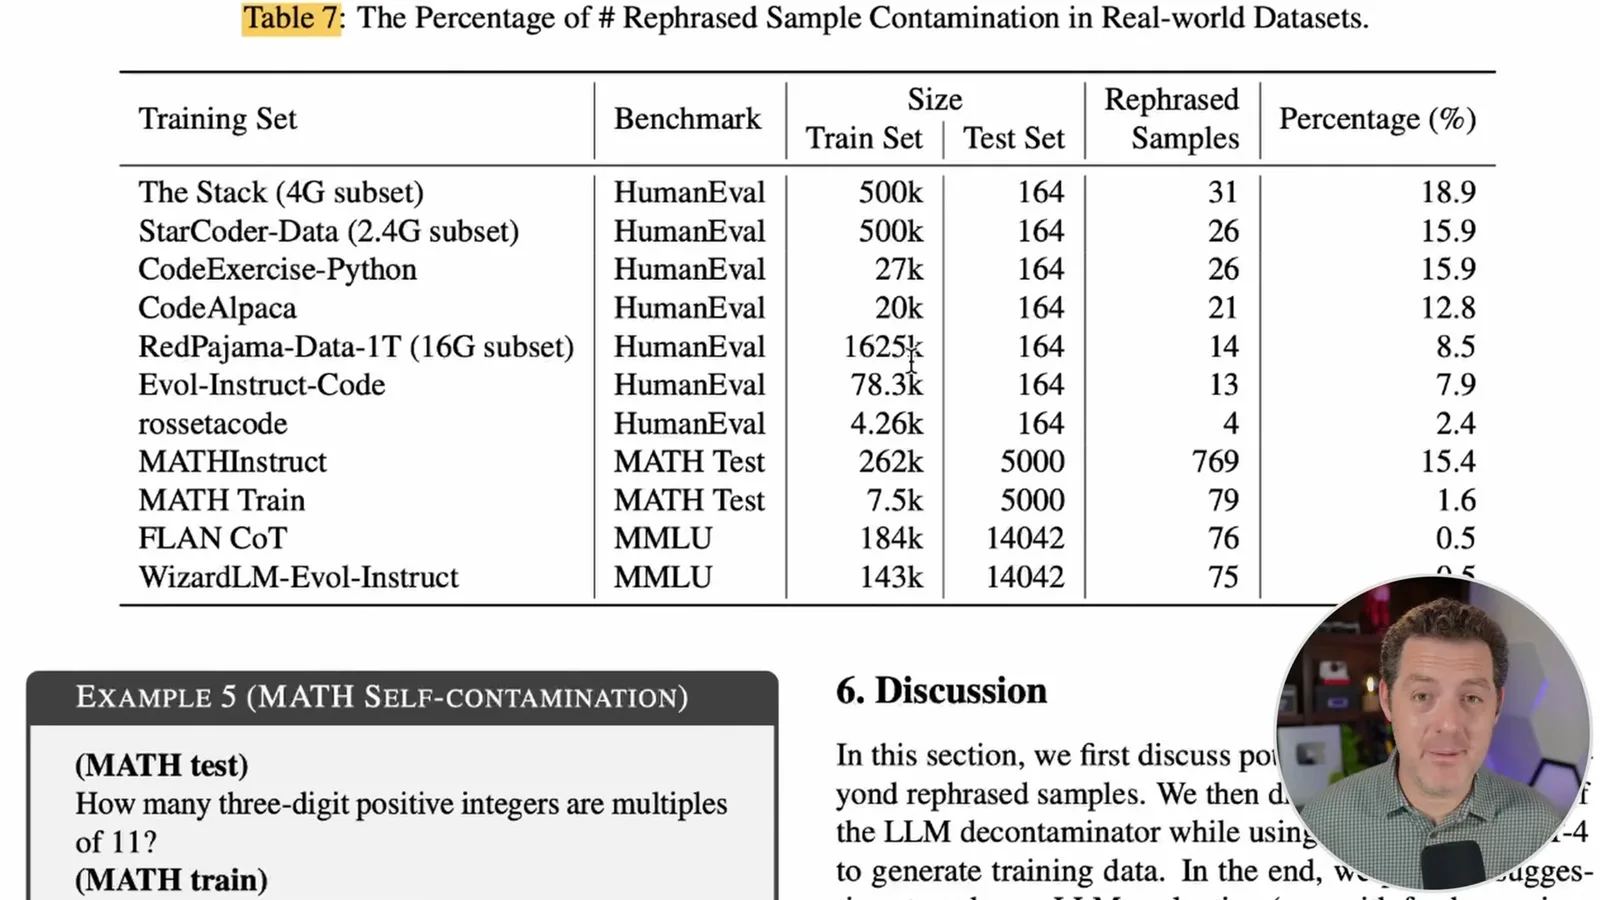
数据集表格估计,在 164 个 HumanEval 题目中,所查 Stack 子集有 31 个题目存在改写匹配,StarCoder-Data 子集有 26 个,CodeAlpaca 有 21 个,分别为 18.9%、15.9% 和 12.8%。其他行使用不同的基准和分母,不能将这些百分比当作所有训练数据通用的污染率来比较。
研究人员还报告,在 FLAN CoT 和 WizardLM 样本与 MMLU 的对照中,检测到的重叠比例较低。这些结果来自特定检测器对特定数据样本的检查,可能存在漏检和误报。随着合成训练数据增多,隐蔽的重叠仍说明有必要记录数据集来源,并使用新颖、多样的测试进行评估。
我的结论是:不了解训练数据和评估过程,就应该对基准分数保持审慎。我也在想,新模型最终是否会接触到我自己的测试题,以及我是否应该更新这些题目。与单一排行榜数字相比,多项独立测试能帮助读者更谨慎地解读结果。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。