30 秒看懂
在这期 2024 年 11 月的教程中,Matthew Berman 创建 CrewAI 入门项目,接入托管版 Langtrace SDK,并比较使用不同 OpenAI 模型的运行结果。本视频与 Langtrace 合作制作。命令、默认设置、界面和价格均为历史情况;追踪记录展示执行过程和成本,但不能单独验证输出质量。
- 1构建入门团队2024 年的演示安装 CrewAI、创建演示项目并配置研究员和报告分析师。目前的命令与默认值可能不同。
- 2为应用添加追踪在运行环境中安装并初始化 Langtrace SDK;保护密钥,并检查发送给所选追踪服务的数据。
- 3检查实际使用的模型虽然设置时选择了其他模型,初次运行的追踪记录显示使用的是 GPT-4o mini,说明运行时追踪的重要性。
- 4检查延迟和 token 成本跨度图细分团队、任务和服务商调用。指标汇总 token、成本和追踪记录数量。
- 5比较两种模型配置示例后续运行使用 GPT-4o 和 o1-mini,耗时更长、成本更高。单次运行不能证明普遍的性能排名。
要点建议
- CrewAI 入门项目可以定义共享同一主题、分别执行任务的研究员和报告分析师。
- 在运行应用的环境中、受追踪组件导入之前初始化追踪 SDK,并将 API 密钥排除在源代码之外。
- 追踪跨度展示任务和模型调用的顺序与耗时;指标汇总 token 和估算成本。
- 检查追踪记录中实际使用的模型名称,因为框架默认值可能与所选设置不同。
- 模型比较需要可重复的质量评估,以及延迟和成本测量。
按章节阅读整理后的全文
创建 CrewAI 项目
Berman 披露与 Langtrace 的合作,并安装 2024 年演示所用工具。他设置了研究员和报告分析师。
在这期 2024 年 11 月的教程中,我构建一个小型 CrewAI 应用并接入 Langtrace,以查看智能体执行过程、token 用量和成本。本视频与 Langtrace 合作制作。展示的命令、界面和模型可用性反映的是 2024 年所用版本,复现前请查看当前文档。
在 VS Code 中,我用 `pip install crewai` 安装 CrewAI,用 `pip install "crewai[tools]"` 安装其工具。接着运行 `crewai create crew demo`,在设置提示中选择 OpenAI 和 GPT-4o,并提供服务商 API 密钥。请安全使用自己的密钥,避免将其提交到源代码仓库,并撤销任何意外暴露的凭据。
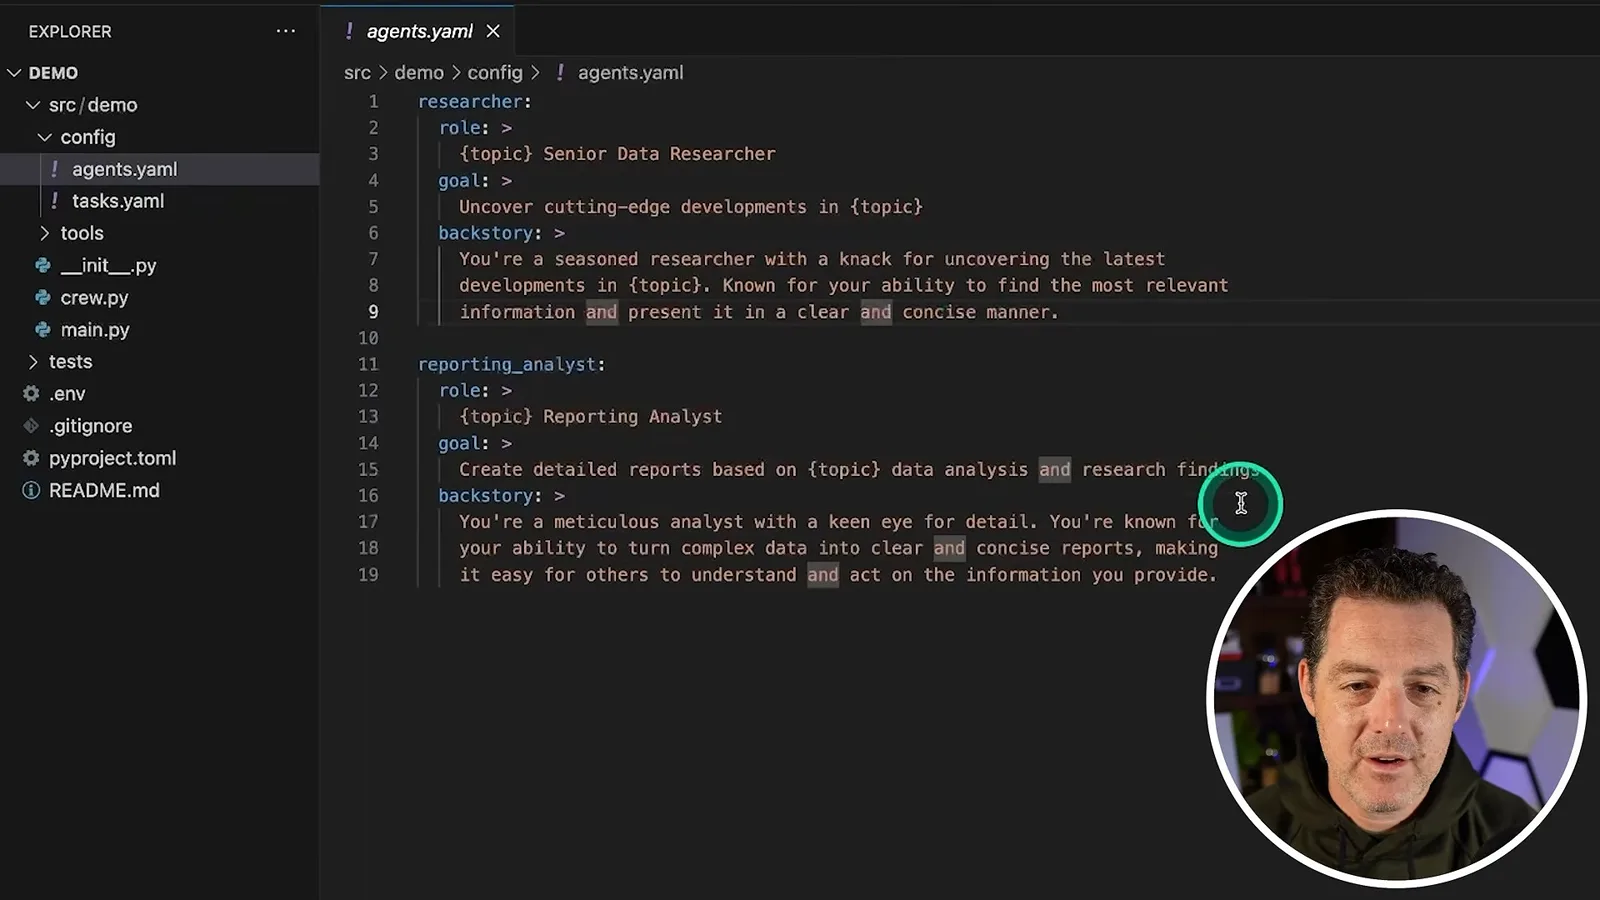
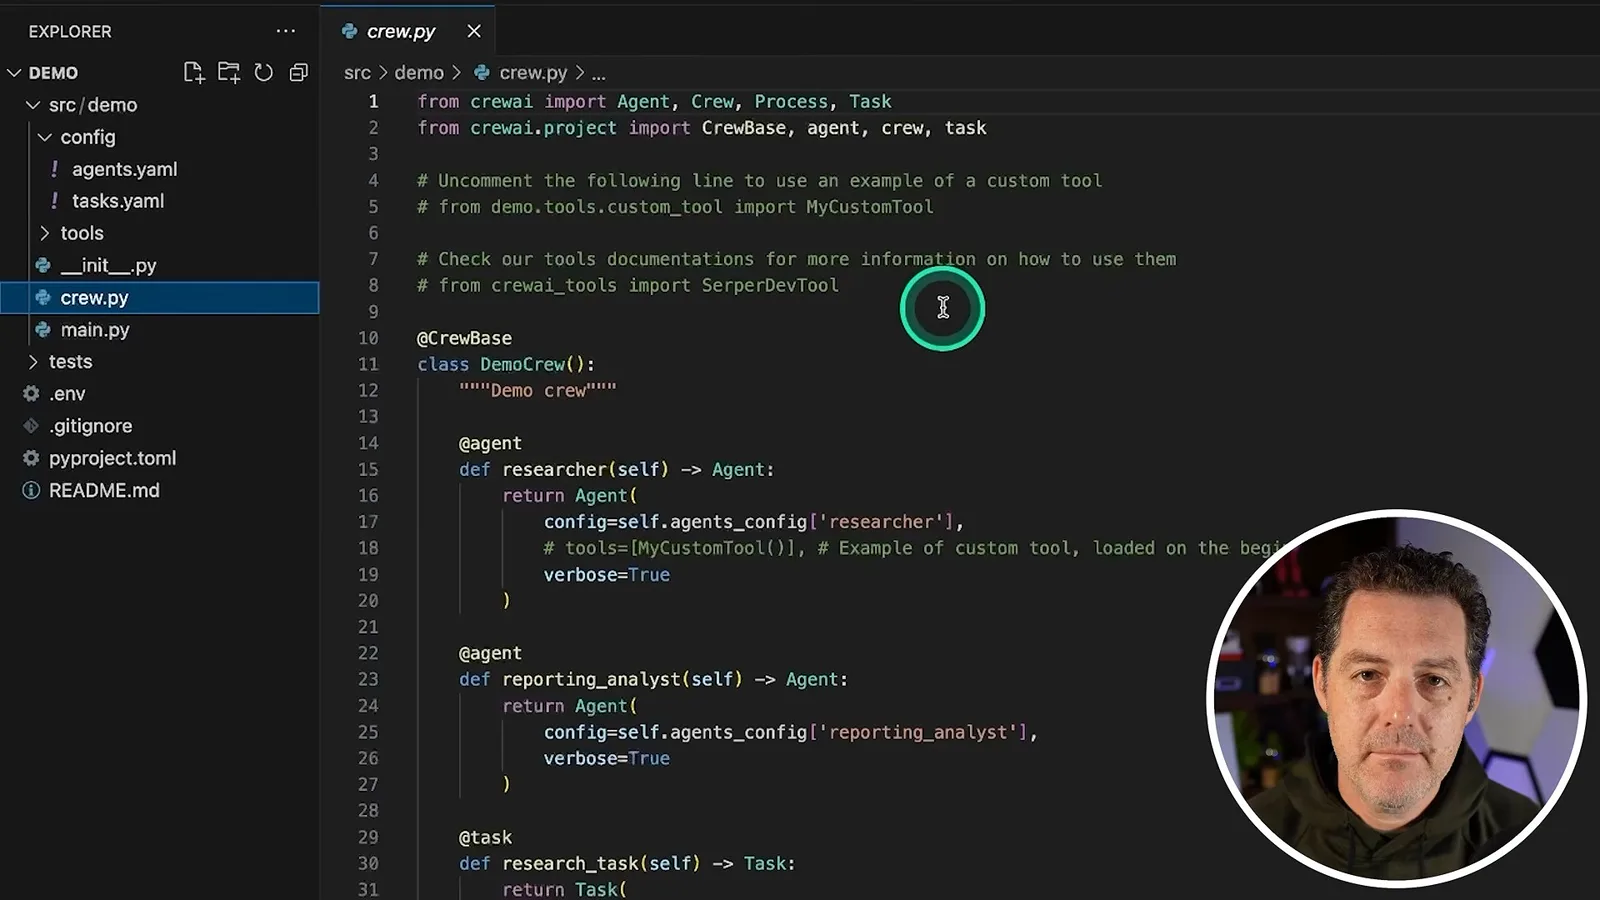
我打开生成的项目并检查 `config/agents.yaml`。入门团队包含一名研究员,其角色和目标围绕指定主题;还有一名报告分析师,将研究整理成报告。任务配置分别描述研究和报告任务;`crew.py` 则把智能体与任务连接起来。
运行团队并连接 Langtrace
入门团队生成一份报告。随后 Berman 创建托管版 Langtrace 项目并初始化 SDK。
我在 `main.py` 中把主题设为 AI LLMs。视频随后在项目中运行 `crewai install` 和 `crewai run`,测试生成的项目框架。研究员为报告分析师提供材料,最终结果写入 `report.md`;这只能验证基本流程运行成功,不能证明其中的事实主张正确。
我创建一个托管版 Langtrace 项目,选择 CrewAI 和 OpenAI 作为集成,并安装 `langtrace-python-sdk`。Langtrace 应用可依据 AGPL-3.0 自行托管,视频使用的是托管服务;请根据自己的部署方式检查适用许可和当前价格。
我生成 Langtrace API 密钥,并在应用中初始化 Python SDK。SDK 文档要求在导入需要追踪的组件之前进行初始化。应将密钥存入环境变量或密钥管理器,而不是把真实密钥写进源代码;还要考虑追踪记录可能包含发送给所选服务的提示词和输出。
编辑器最初无法解析 SDK。我选择包含该包的 Python 解释器,再次运行团队。实际项目中,要确保 SDK 安装在 `crewai run` 使用的同一环境中,并加入项目依赖;仅在编辑器中选择解释器可能无法修复独立的运行时环境。
查看追踪记录与指标
Berman 检查实际模型调用、耗时、token 用量和成本,还演示了 CrewAI 专用仪表盘及第二次运行。
新的 Langtrace 项目显示了这次运行的追踪记录。它显示调用实际使用了 GPT-4o mini,尽管我在设置时选择了 GPT-4o。当框架默认值或配置与预期不一致时,检查追踪记录中的实际模型很有用;默认值也可能随版本变化。
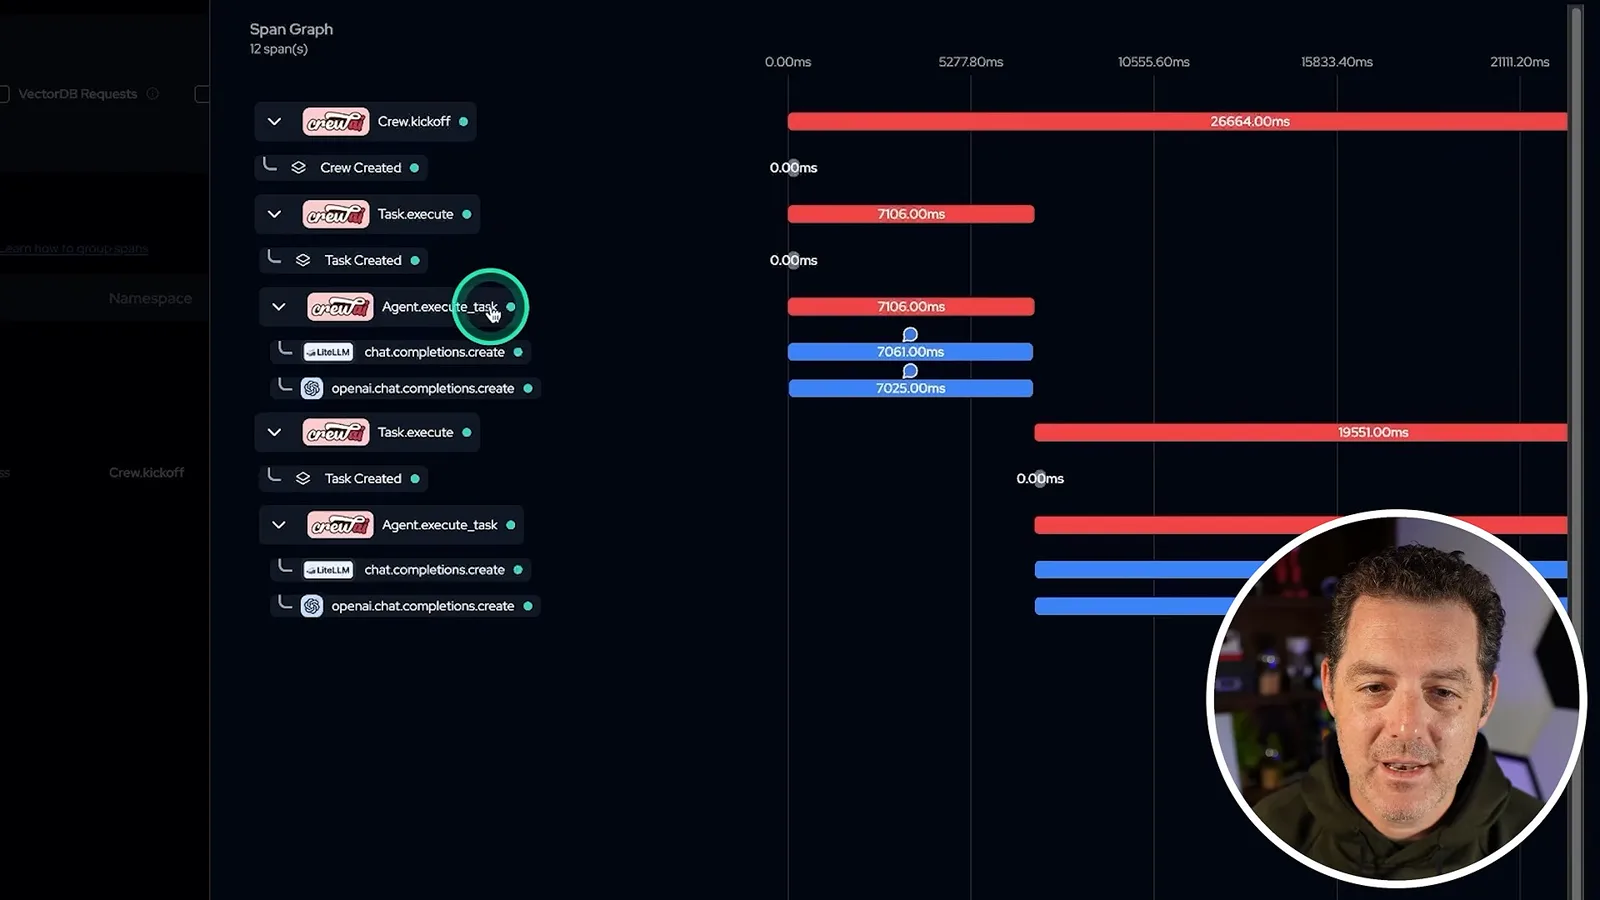
我打开追踪详情,查看团队启动、任务和智能体执行,以及通过 LiteLLM 和 OpenAI 发起的调用。跨度图显示每个阶段的耗时。我筛选调用栈,重点关注 CrewAI 和 OpenAI,并比较这次运行中约 26 秒的团队启动与约 7 秒的单个任务。
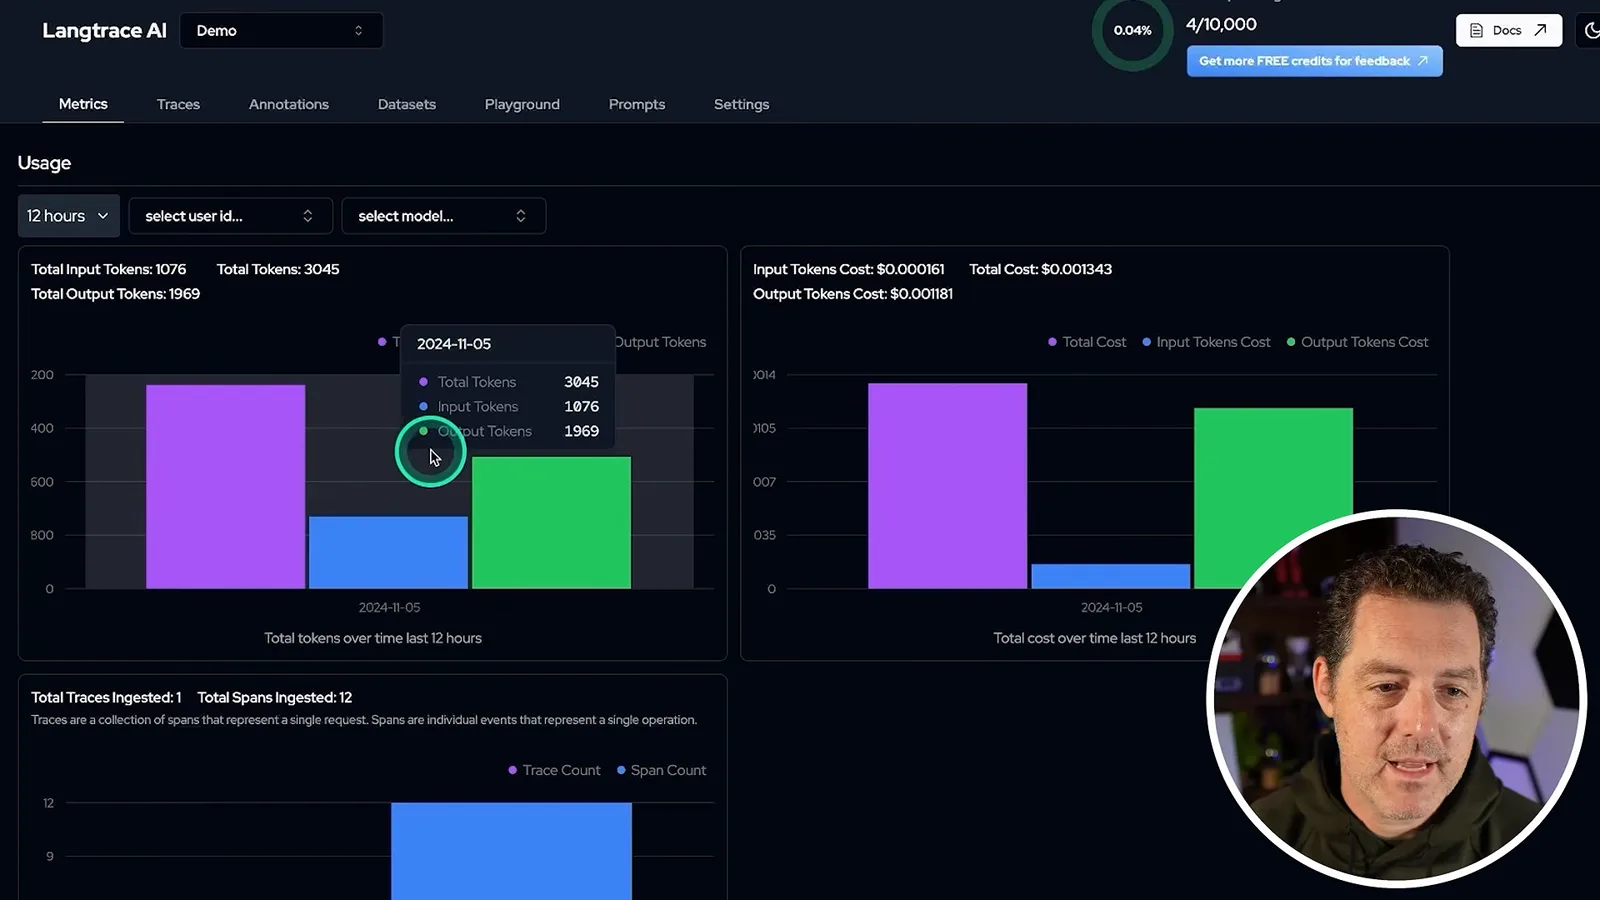
指标视图按时间显示输入、输出和总 token 用量,以及估算成本和追踪记录数量。这个 2024 年的小型示例运行成本不到一美分;实际成本取决于模型、用量和价格,并非每次运行都有固定费率。
我将项目类型切换为 CrewAI,以使用专用仪表盘并在不同会话间切换。视图汇总了运行耗时、智能体和任务详情以及执行时间线。示例没有使用记忆或工具,但在存在这些内容时仪表盘有对应区域。
我再次运行团队。第二条追踪记录出现,指标在多次运行间累计,因此可以比较耗时、token 数和成本。这些观察有助于定位昂贵或缓慢的阶段,但单凭追踪记录无法确定答案是否准确或有用。
比较模型并总结
他将智能体模型改为 GPT-4o 和 o1-mini,比较生成的追踪记录,并讨论质量、速度和成本的平衡。
为了比较模型,我在 `crew.py` 中将研究员设为 GPT-4o,将报告分析师设为 o1-mini。Langtrace 随后在新的追踪记录中显示两个模型名称。示例运行耗时约 45 秒,成本高于此前的 GPT-4o mini 运行;单次运行只是示例,不能确立普遍的速度或质量排名。
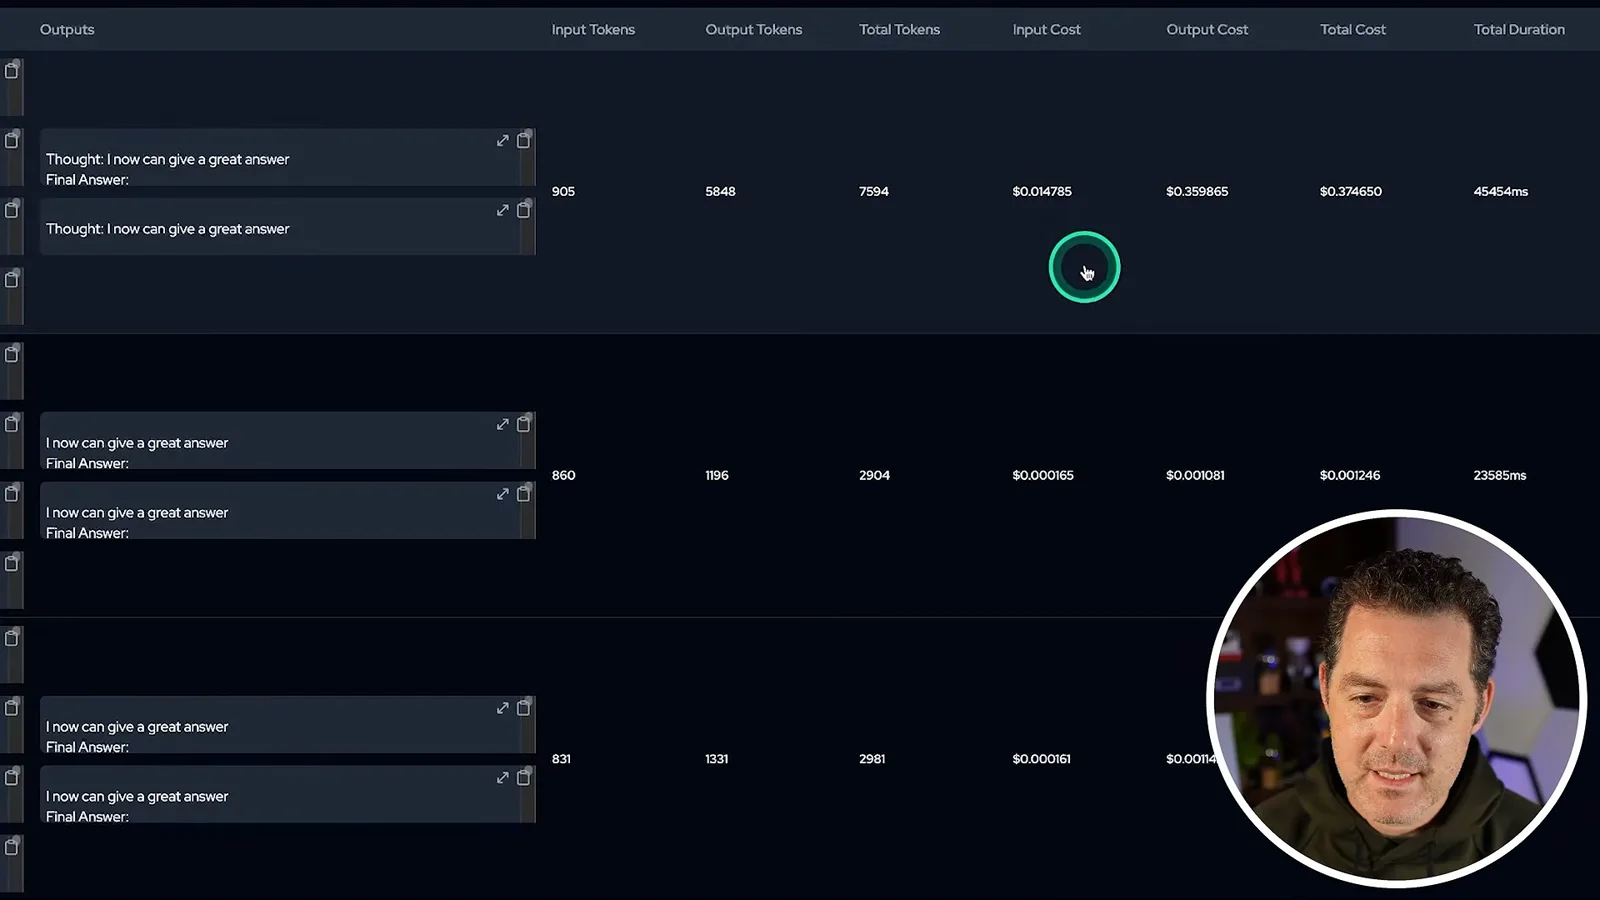
这个练习的目的,是通过观察每个智能体实际做了什么,在质量、延迟和成本之间取得平衡。评估质量仍需要适当的测试或审查。我感谢 Langtrace 与我合作制作视频,并指出读者可以选择自行托管的应用或托管服务。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。