30 秒看懂
参加 2025 年 5 月的 Google I/O 后,Matthew Berman 回顾 Google 的 AI 公告和演示,包括个人助手、模型更新、创意工具和 Android XR 眼镜。他尤其关注能够利用上下文的助手和视频生成。 主题演讲同时包含已推出的产品、实验和未来计划;文中的基准分数、价格和发布声明是当时 Google 报告的历史信息。
- 1Token 数增长约 50 倍Google 报告称,其产品和 API 每月处理的 token 从 9.7 万亿增长到超过 480 万亿。这不能直接衡量个人使用情况。
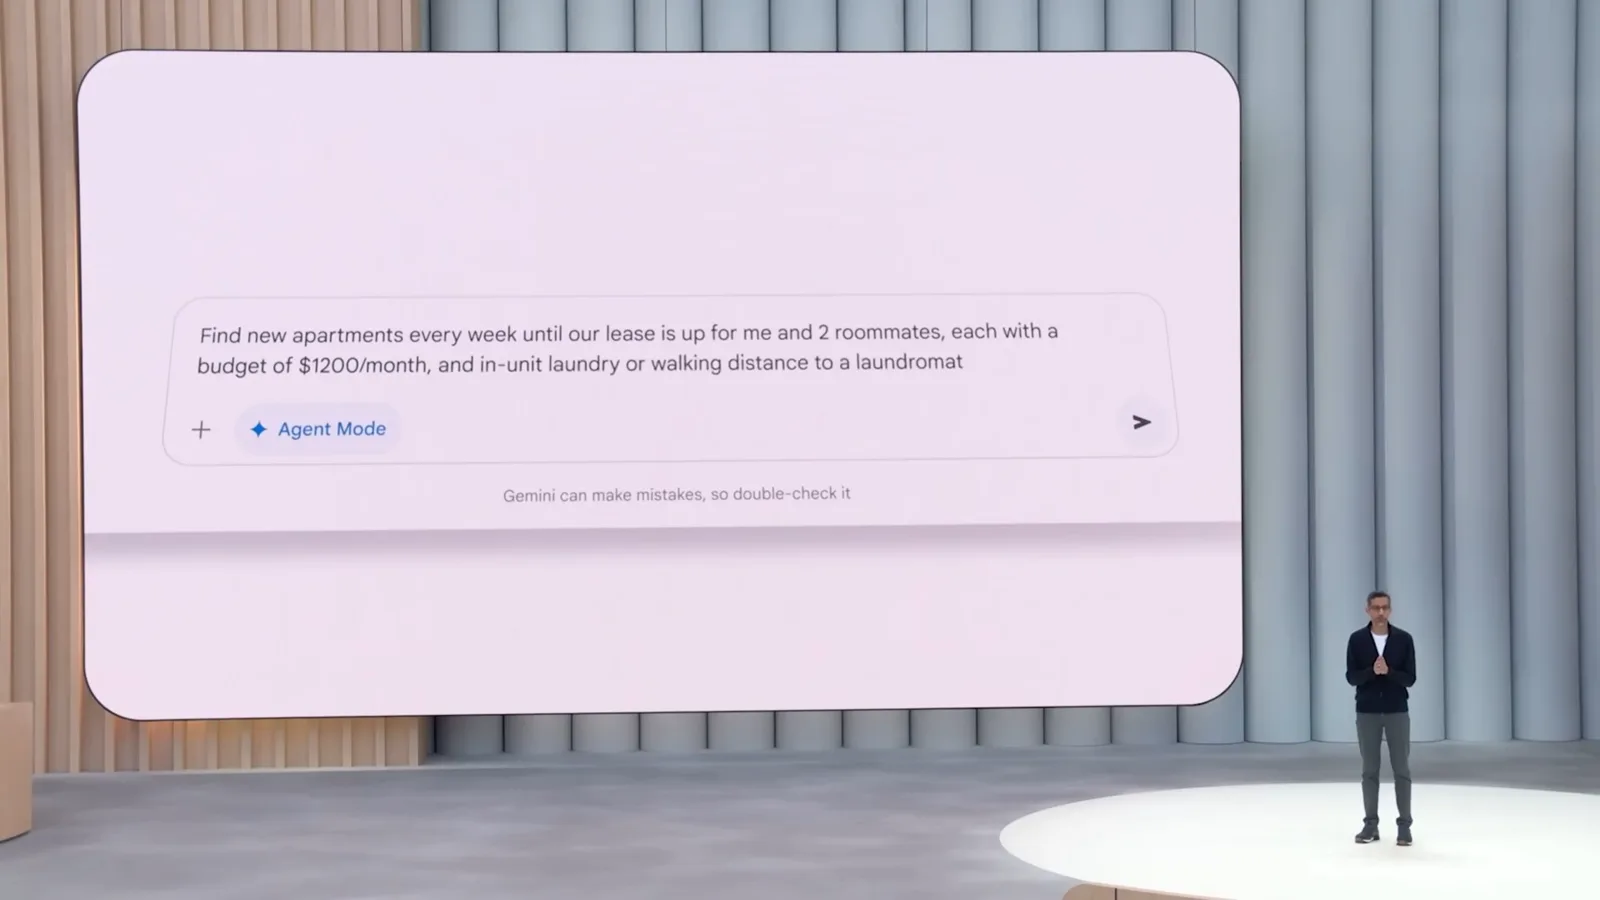
- 2智能体网页任务Mariner 和拟议的 Gemini 智能体模式展示了筛选公寓房源和预约看房。这些都是早期演示。
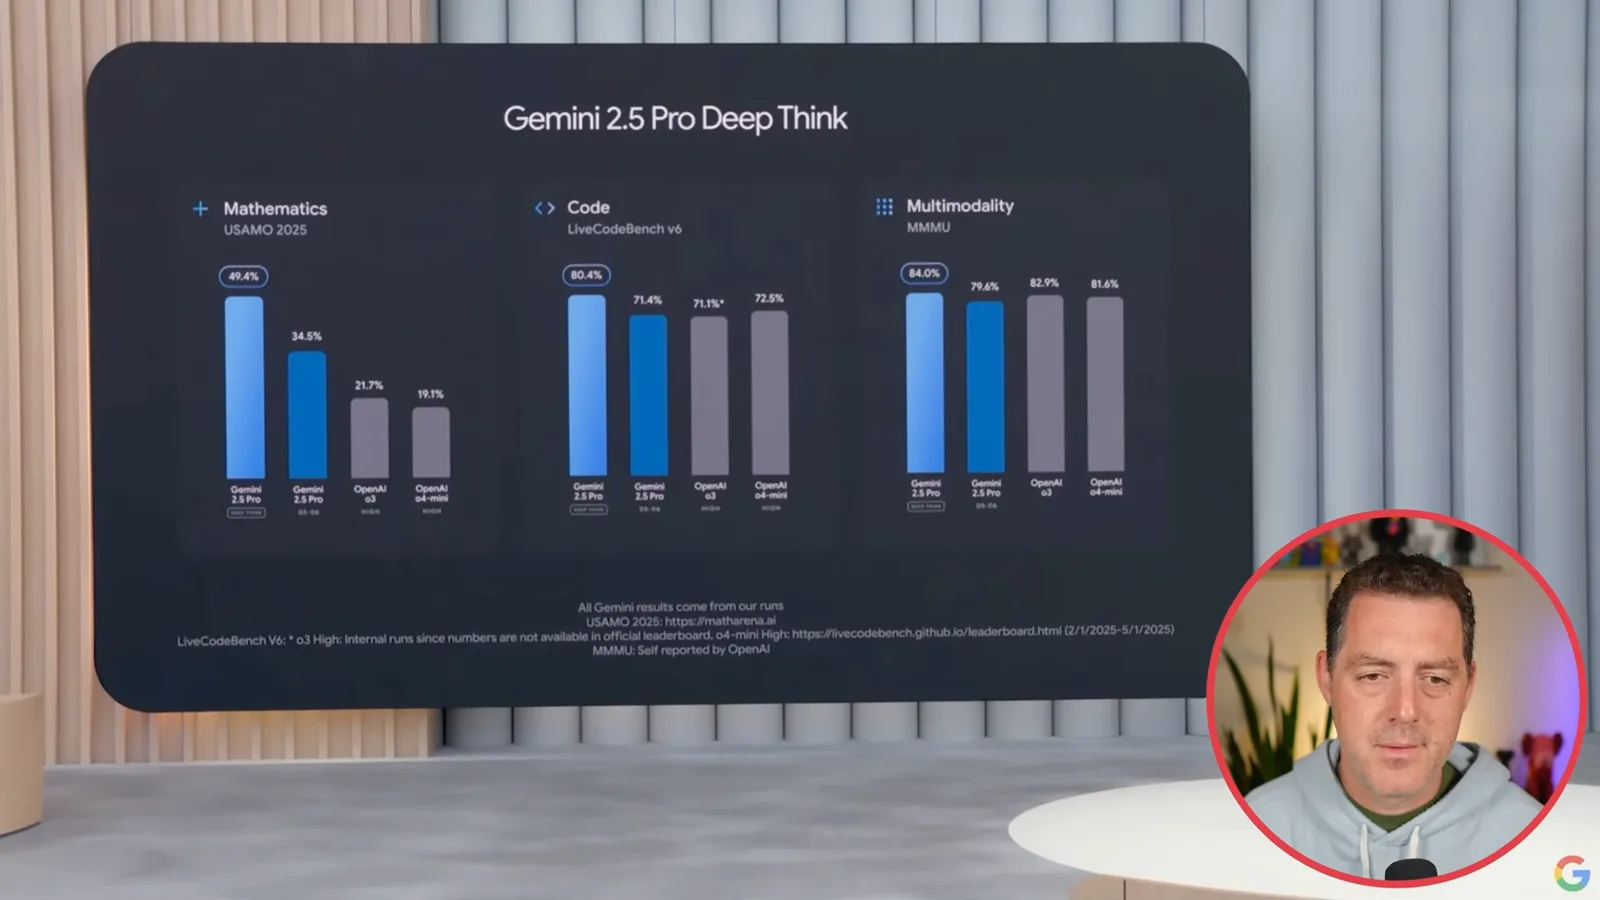
- 3Deep Think 基准成绩Google 的图表报告 USAMO 2025 为 49.4%、LiveCodeBench v6 为 80.4%、MMMU 为 84.0%。这些数字仅适用于特定基准和设置。
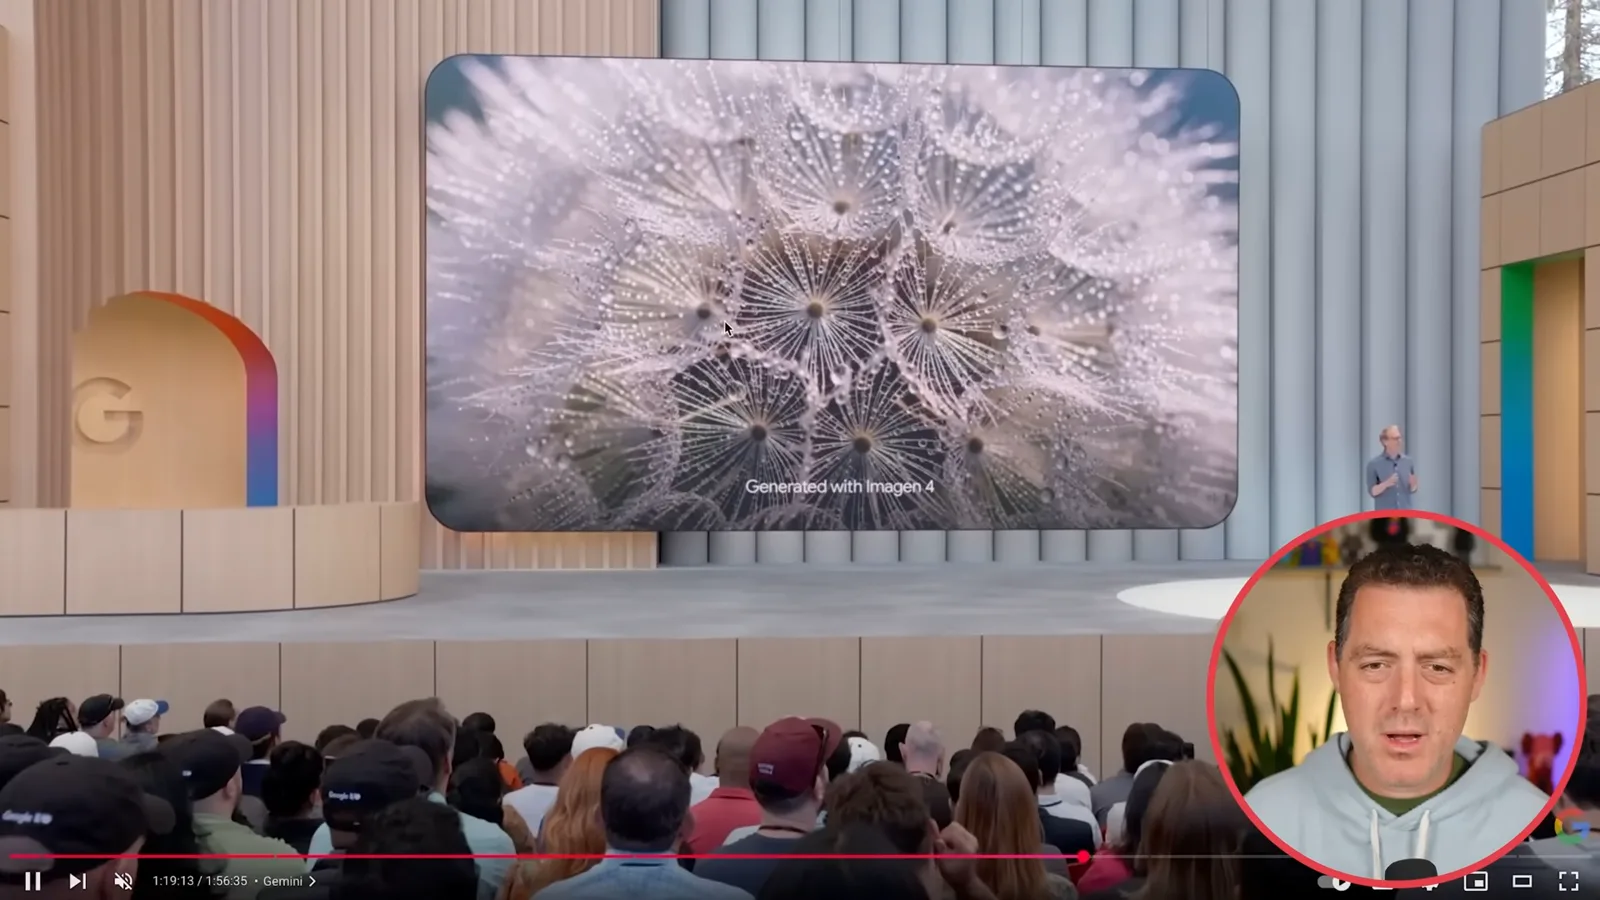
- 4图像与视频生成大会展示了 Imagen 4、Veo 3 和 Flow。宣称最高十倍的速度提升,是指即将推出的 Imagen 4 Fast 版本相对于 Imagen 3 的表现。
- 5XR 眼镜原型现场演示展示了消息和地图叠加信息,并出现可见卡顿,其原因尚未确定。
要点建议
- Google 报告称,2025 年其产品和 API 每月处理超过 480 万亿 token,这是总体使用指标。
- Project Mariner 和拟议的智能体模式展示了网页任务自动化,Gemini Live 则为更多用户带来了基于摄像头的交互。
- Google 在特定评估条件下报告了 Deep Think 在 USAMO、LiveCodeBench v6 和 MMMU 上的基准成绩。
- Veo 3 加入了音频生成,Flow 则展示了生成片段的组合和编辑。
- Google 的 Android XR 眼镜是原型;主题演讲中的演示没有证明它在日常使用中的可靠性。
按章节阅读整理后的全文
Google 的 AI 进展与 Beam
Berman 回顾 Google AI 产品发布的变化及其报告的 token 用量,并描述试用三维通信系统 Beam 的体验。
我刚参加完 Google I/O 2025,大会上展示了众多 AI 产品。我还采访了首席执行官 Sundar Pichai,讨论世界模型、搜索和智能爆炸,并计划另行分享那次对话。
一年前,许多人质疑 Google 的 AI 战略。此后,公司宣布或发布了 AlphaFold 3、Imagen 3、Gemma 2、Project Mariner、Gemini 2.5、Gemma 3 和 AlphaEvolve。我对这次大会的印象是,Google 正在快速把研究成果转化为产品。
一个引人注目的公司指标是 Google 产品和 API 每月处理的 token 数:一年前为 9.7 万亿,2025 年则超过 480 万亿,约增长 50 倍。这是 Google 的总体指标,并非直接衡量个人用户或节省的时间。模型使用、产品集成和更长的推理输出都可能有所贡献。
Project Starline 已成为三维视频通信平台 Google Beam。Pichai 说,其目标是让相隔遥远的参与者感觉身处同一个房间。Google 展示的是面向企业的系统,而不是普通消费级屏幕。
我亲自试用了 Beam。多台摄像头拍摄对面的人,显示屏呈现出类似 Nintendo 3DS 的立体效果。我的眼睛需要片刻适应;当对方拿起一个苹果时,我感觉伸手就能碰到。这是我对一次演示的体验,并非对所有部署环境的测试。
视觉助手与网页智能体
Gemini Live 和 Project Mariner 展示了基于摄像头的交互与浏览器自动化。拟议的智能体模式可搜索公寓房源并预约看房。
Project Astra 的部分能力也进入了 Gemini Live:用户可以通过手机摄像头,就看到的事物展开对话并提问。Google 的喜剧演示中,一位用户把垃圾车误认为敞篷车,把路灯看成建筑,又把影子当成跟踪者。摄像头和屏幕共享的推出细节因平台和地区而异。
Project Mariner 是 Google 的网页交互智能体。宣布的多任务功能指向这样一种流程:一个智能体处理一项任务时,用户可以启动另一项;计算机操作、工具和记忆在此结合。这些系统仍处早期阶段,一次演示不能证明长任务在没有监督时能够可靠完成。
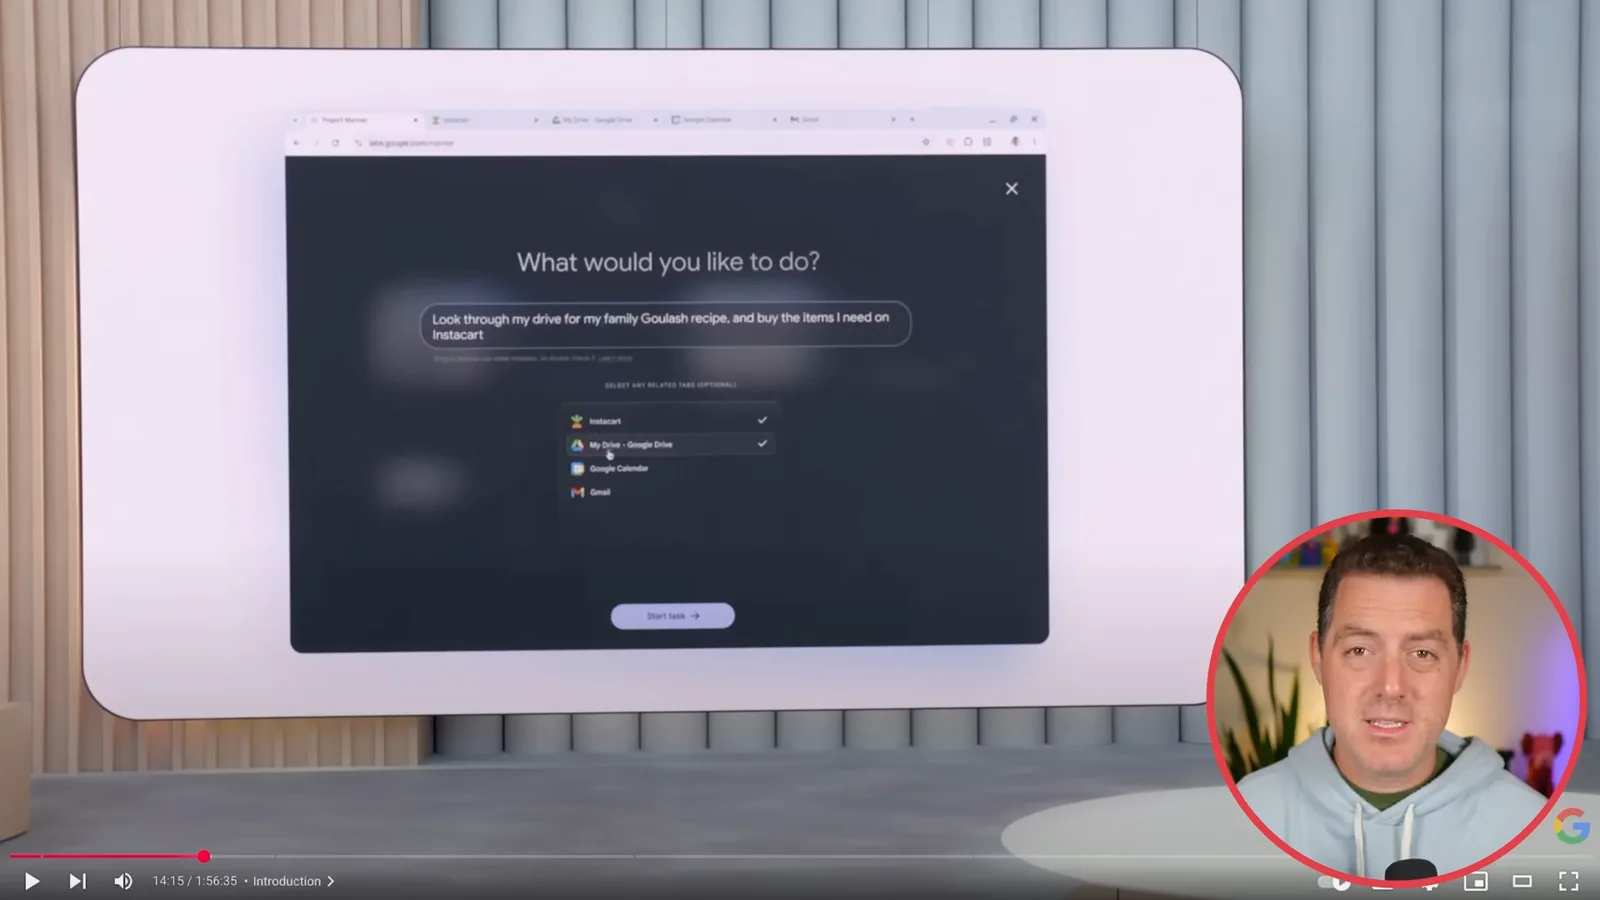
Google 还介绍了面向 Chrome、Search 和 Gemini 应用的智能体能力。在主题演讲示例中,Pichai 要求寻找 Austin 的公寓,供三名室友居住,每人每月预算为 1,200 美元,并需要洗衣设施。拟议的智能体搜索房源、使用 Mariner 调整筛选条件,还可利用通过 MCP 连接的工具安排看房;这是拟议流程的演示。
个人上下文与模型研究
Berman 讨论个性化回复、Gemini 更新、基于扩散的文本生成和 Deep Think,还回顾了 Google 在世界模型和机器人领域的目标。
最让我兴奋的是个人助手能够利用 Gmail、Calendar 和 YouTube 等服务中的上下文,以及此前交互的记忆。我希望打开收件箱时,已经有根据我与各联系人往来记录定制的回复草稿,等我审核并发送。个性化智能回复向这一愿景迈进了一部分,但还不是我设想的完整流程。
我也很高兴 Google 在演讲中提到了我使用 Gemini 的作品和魔方演示。公司介绍了模型更新,包括思考预算、更快的性能和摘要。在支持的配置中,思考预算提供了一种权衡推理 token 用量、延迟和成本的方式。
Google 推出了研究模型 Gemini Diffusion,它从噪声出发反复优化文本或代码。我觉得演示速度惊人,但模型质量和延迟取决于具体系统与测量方法;扩散模型不会自动比每个自回归 Transformer 都更快或更不准确。Google 将它作为研究成果展示,而不是已广泛验证的替代方案。
Gemini 2.5 Pro Deep Think 作为实验性增强推理模式推出,采用包括并行方法在内的技术。Google 的主题演讲图表报告,其 USAMO 2025 成绩为 49.4%、LiveCodeBench v6 为 80.4%、多模态基准 MMMU 为 84.0%。这些是特定设置和竞争模型下报告的分数,不是通用排名;第三项基准是 MMMU,不是 MMLU。
Google 还谈到向世界模型迈进。Demis Hassabis 将自然表征、Veo 的视频示例和 Gemini Robotics 视为迈向能够处理物理世界的系统的步骤。这些例子是演示,更广泛的目标仍是研究愿景,不能证明模型全面理解物理世界。
生成式媒体与订阅
大会展示了 Imagen 4、Veo 3、Lyria 2 和 Flow。Berman 回顾创意示例及 2025 年的 Ultra 订阅价格。
Imagen 4 生成了细节丰富的示例,包括连衣裙、纸艺风格的鸟、花朵和猫。Google 宣布计划推出 Imagen 4 Fast 版本,速度相对于 Imagen 3 最高可提升十倍;这是公司针对即将推出的特定版本的声明,并非每次 Imagen 4 请求都经过测量的提速幅度。
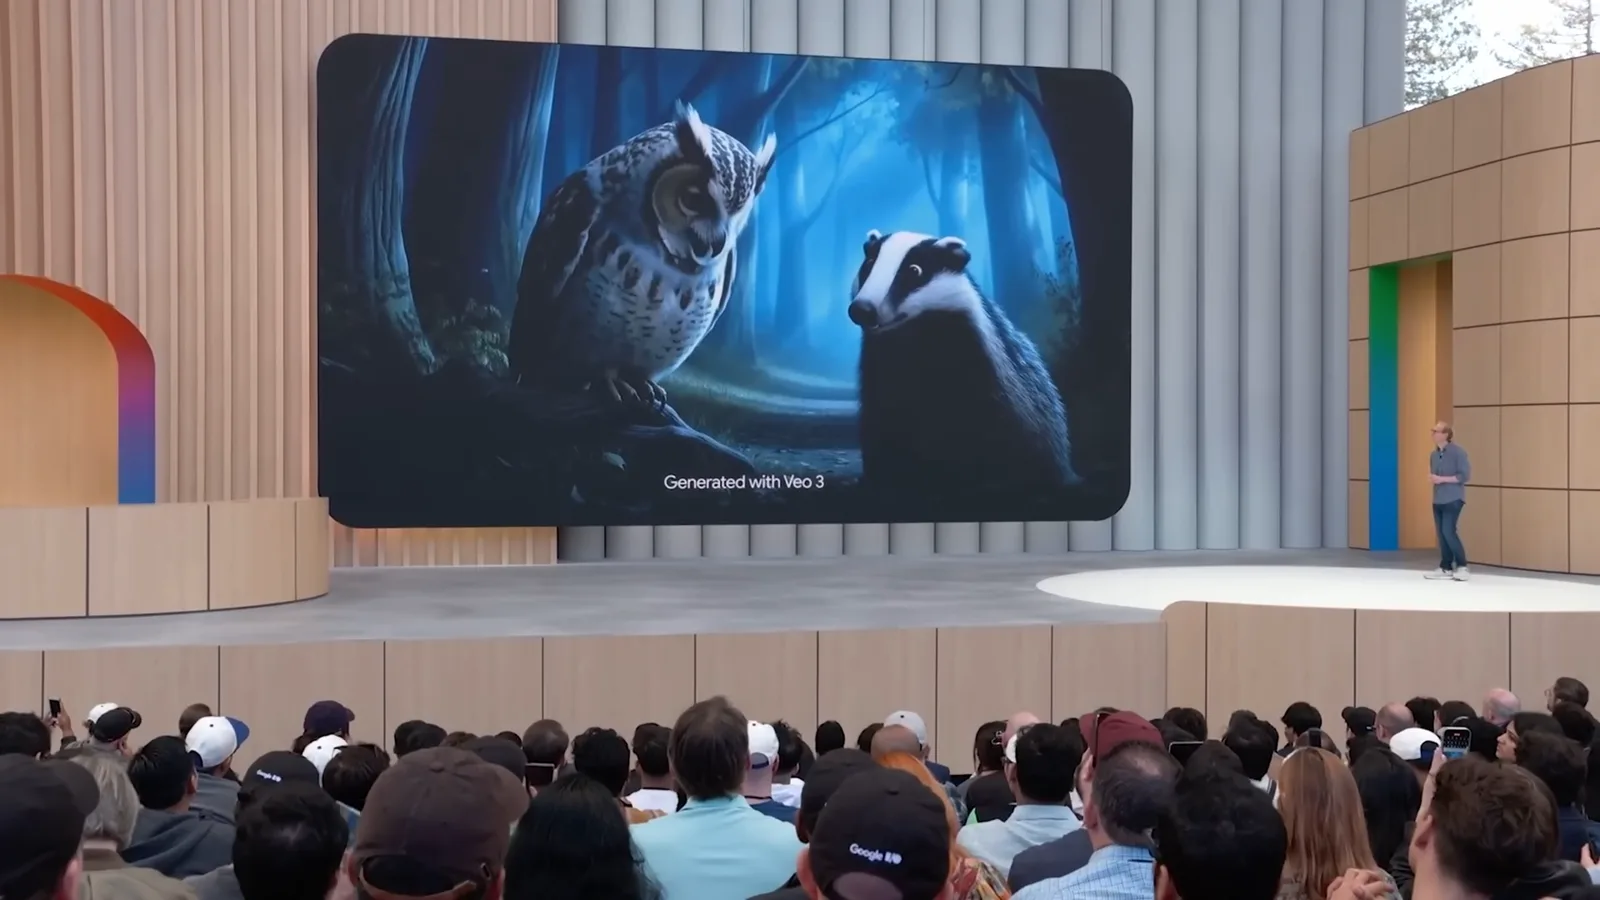
Veo 3 能生成带音频的视频,包括对话和音效,大会上展示了动物和海洋片段。Google 还推出了音乐模型 Lyria 2。我计划亲自测试这些工具;主题演讲中精选的精美示例不能独立证明其典型输出质量。
大会上,Google AI Ultra 宣布在美国以每月 249.99 美元的价格推出,首次订阅者前三个月有折扣,同时提供更高用量限制和功能抢先访问。我觉得价格昂贵,但计划订阅并反馈体验。这是 2025 年发布时的价格和可用范围,不是当前报价。
Flow 将 Google 的生成式媒体模型组合成一个电影制作工具。演示中,创作者生成鸡头形状的换挡杆等素材,输入摄像机角度提示,再组合图像生成片段。界面可以排列和延长片段,比只用一条提示词给创作者更多控制。
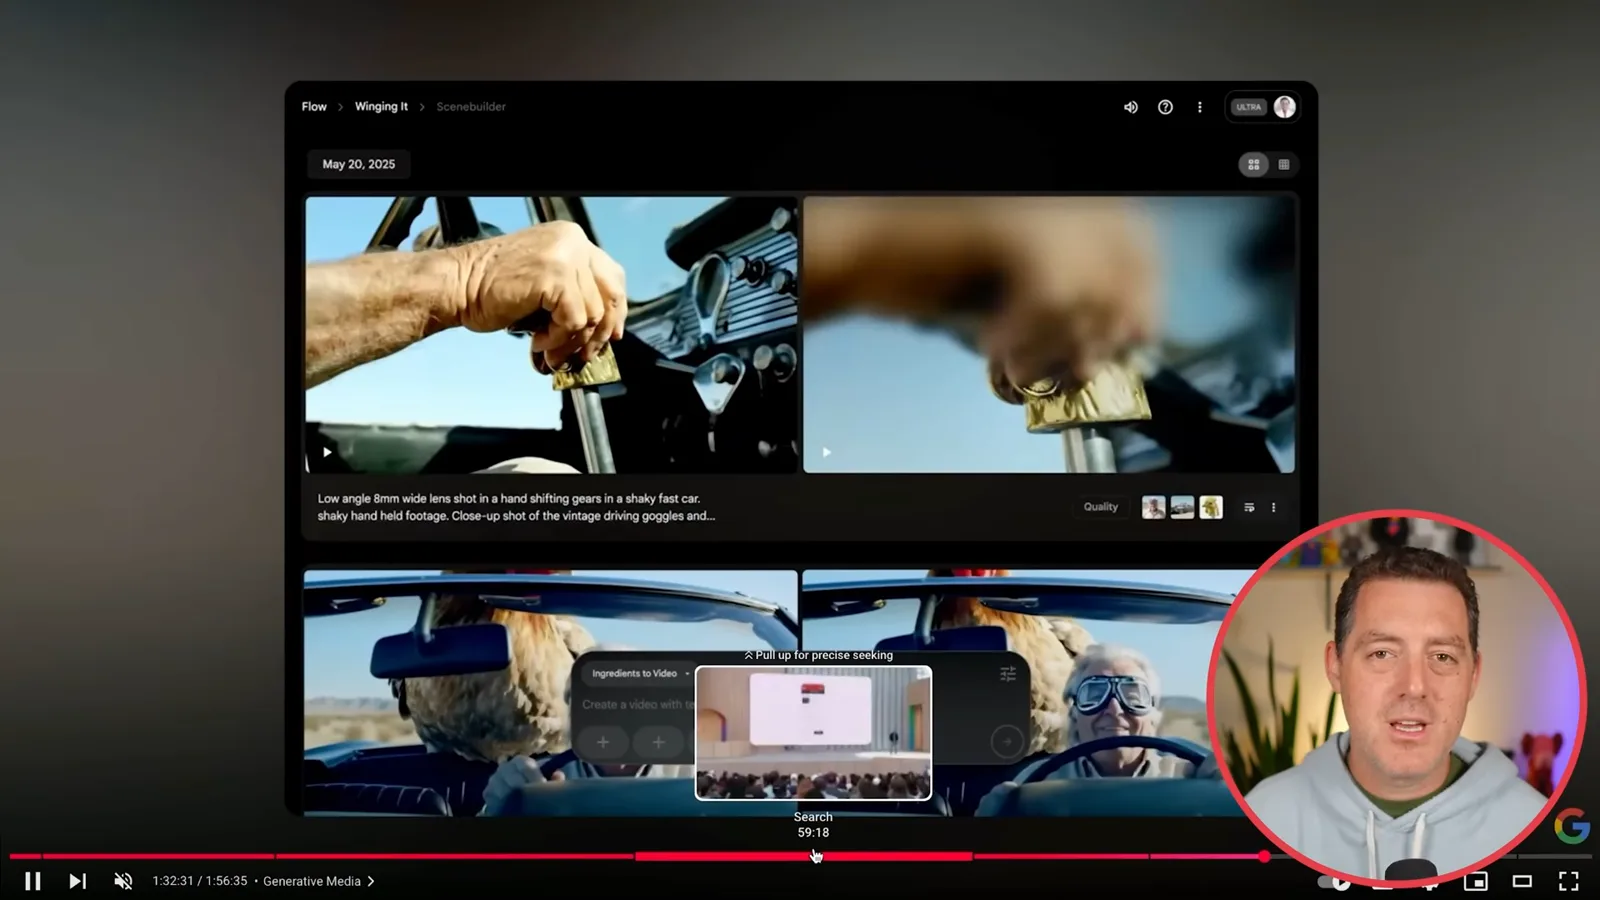
最终片段结合了生成的画面和声音。我将 Flow 与 Sora 的场景构建工具比较,并表达了自己更喜欢 Veo 3 视频质量的看法;这只是我的判断,不是独立基准测试。我打算之后进行更广泛的测试。
Android XR 眼镜
原型的现场演示显示了信息与导航叠加画面。Berman 反思自己愿意在什么情况下佩戴眼镜。
最后,Google 展示了 Android XR 眼镜原型,信息可以显示在镜片上。现场演示中,后台佩戴者接收消息、查看天气和导航。画面出现了一些可见卡顿;我怀疑与网络状况有关,但视频没有证明原因。
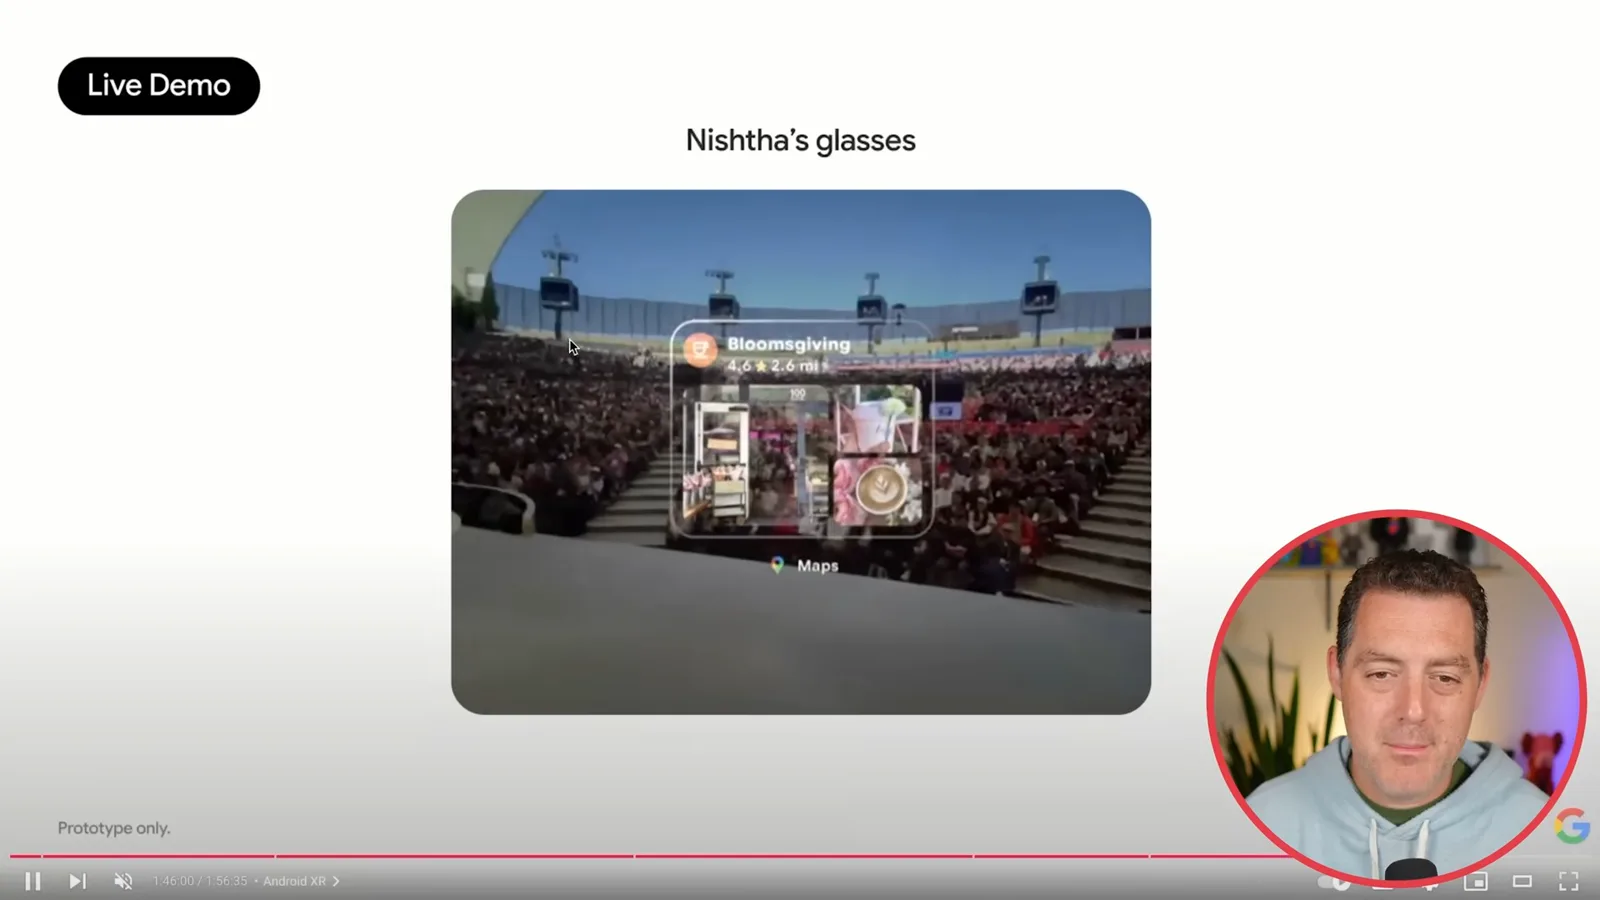
演示在佩戴者的视野中显示了地图推荐和导航方向。我一直怀疑眼镜是否是 AI 的终极形态:我愿意在户外佩戴,但不想在室内整天戴着。这个原型是一次演示,不能保证产品已经发布或日常表现达到同样水平。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。