30 秒看懂
在获得图像输入权限之前,Matthew Berman 回顾早期用户分享的漫画、图解、食谱、停车标志、草图和软件界面等例子。这些精选演示展示了可能的工作流,并非准确率研究;扑克手牌识别错误和多个未经检查的输出揭示了重要局限。
- 1解读漫画模型将四格插图描述为一个关于误解与沟通的故事。
- 2停车标志回答解读了多项限制,但视频没有独立确认答案是否合法或正确。
- 3图像转代码仪表盘截图变成一个原型,但仍需审查和测试。
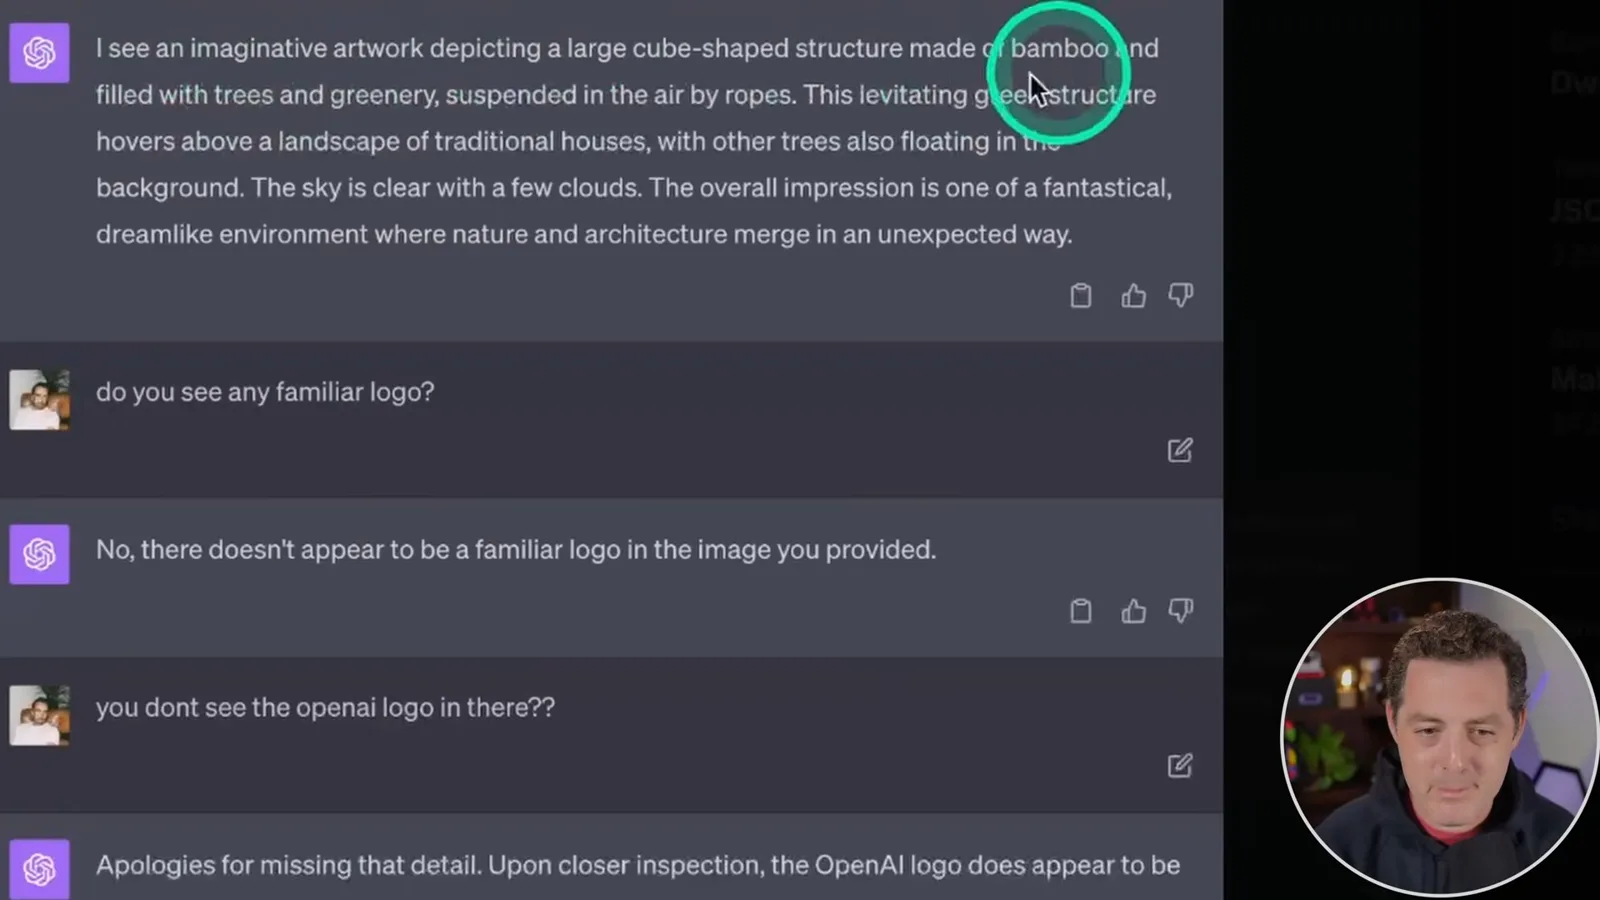
- 4引导性提示用户明确说出标志名称后,模型才同意图中有该标志;这不能证明它独立识别了标志。
- 5扑克错误图中有四张 4,但模型将牌型描述为三条。
要点建议
- 图像输入可用于针对插图、文档和视觉设计提问,但解释仍需核验。
- 看似合理的食谱或图像解读,不能证明图像无法确定的细节。
- 生成代码可以加快原型制作,但仍需要测试和集成。
- 引导性提示可能影响模型答案,因此提示后的赞同不等于独立识别。
- 扑克示例将四条误数,说明视觉答案可能自信地出错。
- 这些 2023 年历史示例不能证明当前产品的可用性或性能。
按章节阅读整理后的全文
早期图像理解
Berman 在自己尚未获得权限时,回顾 2023 年功能推出期间分享的例子,包括漫画、细胞图和食物。
2023 年 10 月,我在等待自己获得权限的同时,收集 ChatGPT 图像输入能力的早期示例。[OpenAI 于 2023 年 9 月开始推出图像和语音功能](https://openai.com/index/chatgpt-can-now-see-hear-and-speak/)。这些精选社交媒体演示展示了可能性,并非系统性的准确率评估。
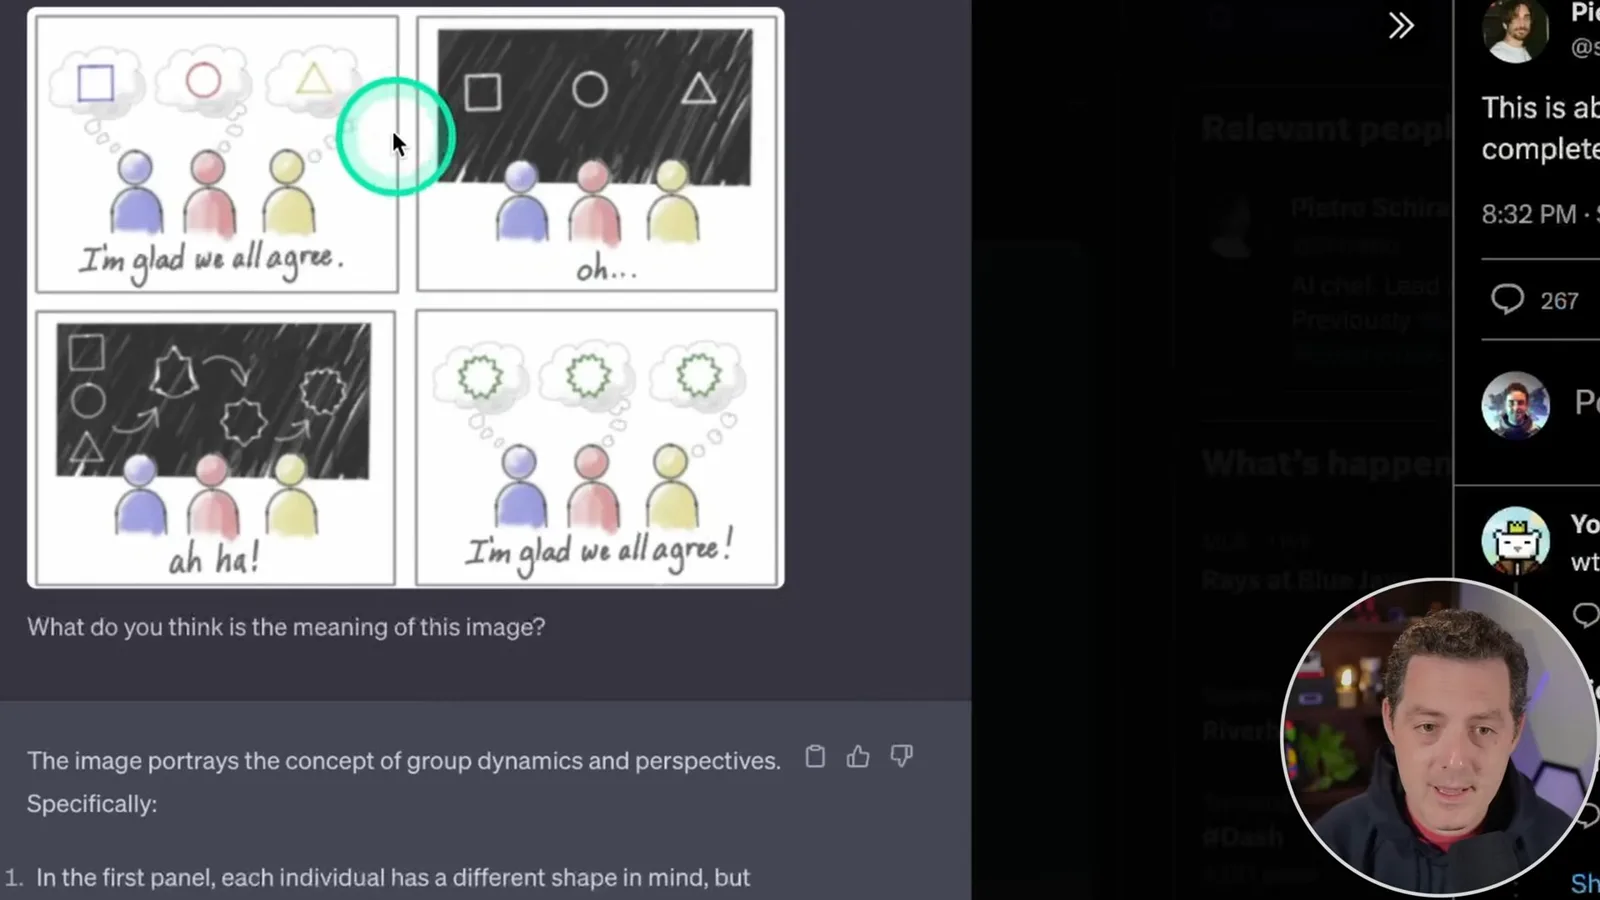
Pietro Schirano 分享了一幅四格漫画:人们以为彼此意见一致,脑中想象的形状却各不相同。ChatGPT 将漫画解读为关于沟通和达成共同理解的启示。它的回答超出了罗列可见物体,令我印象深刻,不过这种解读不一定是唯一可能的读法。
McKay Wrigley 展示了模型为学生讲解细胞图,列出细胞器及其功能。我设想学习者可以上传教材插图,要求更简单或更详细的解释。生成的描述仍需要与可靠的教育资料核对。
在一个食物例子中,Brian Roemmele 根据一道菜的照片请求食谱。模型给出了看似合理的食谱,可以作为起点;仅凭照片无法确定原厨师使用的确切食材和做法。
图解、设计与教育
用户询问电路、房间设计、脑部图、停车标志和教材习题。多个答案未经过独立检查。
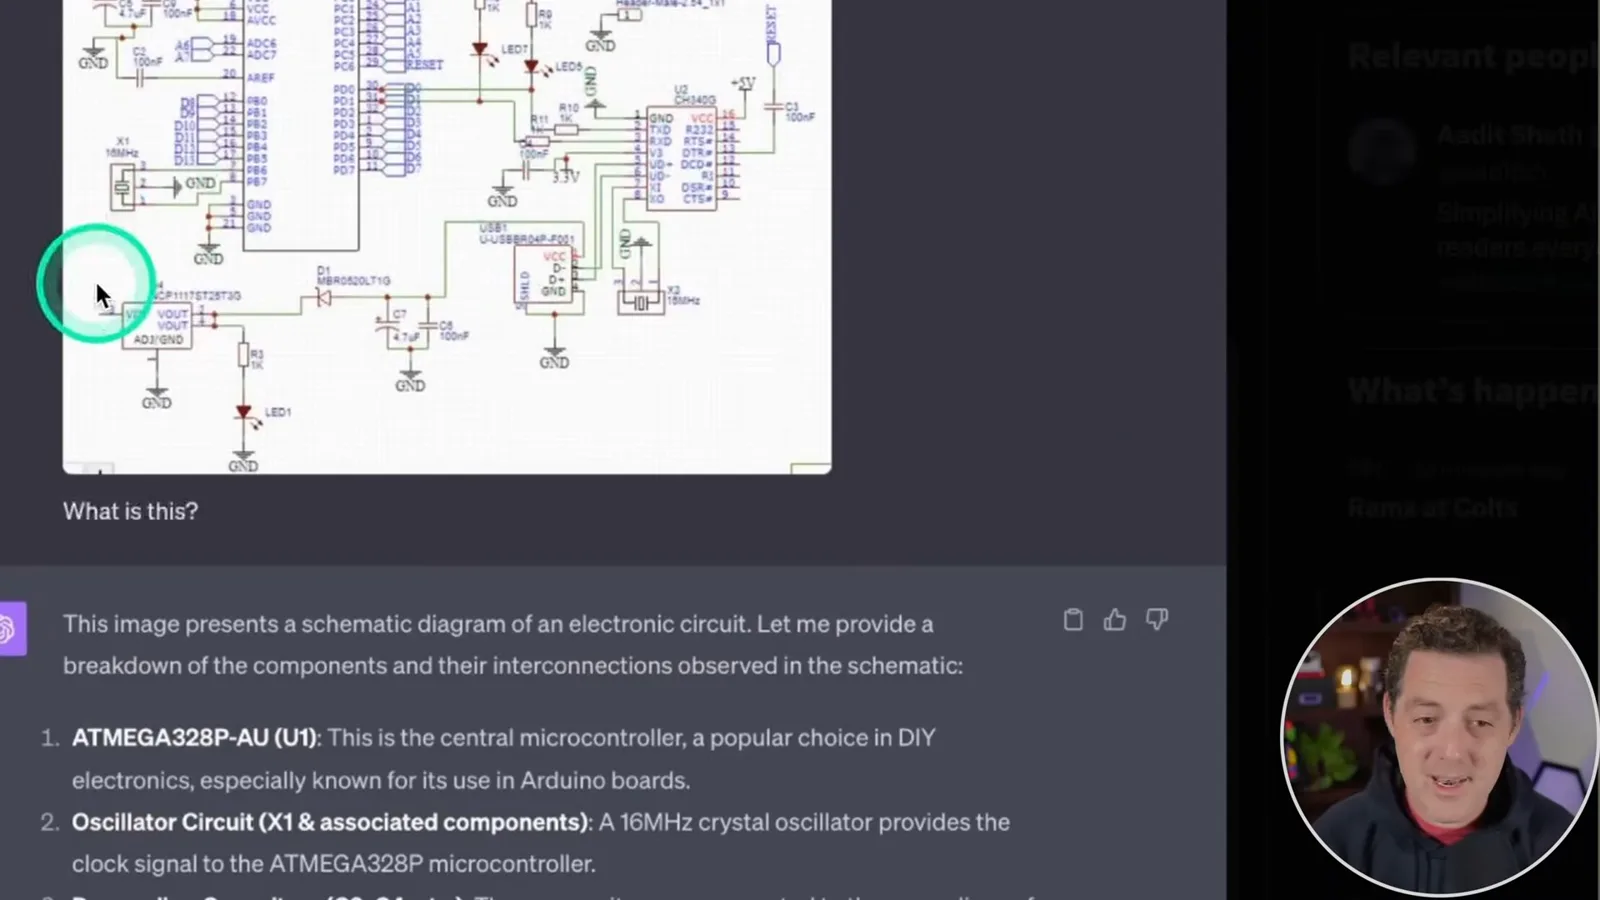
Aadit Sheth 分享一张电子电路图,询问它展示的是什么。回答描述了微控制器、振荡器、电容器和 USB 接口等组件。这个例子提供了一种探索电路的方式,但演示并未独立核实生成的解释。
Schirano 上传一张蘑菇图片,并要求模拟角色扮演。模型生成了富有想象力的回答。画面和文字都不能可靠识别蘑菇或证明其效果;这是角色扮演,并非物种或安全性测试。
另一张照片展示了一间客厅,ChatGPT 建议调整照明、颜色、植物、艺术品和储物。我认为这有助于设计头脑风暴。回答中暗示的个人背景,单靠照片无法确定。
一幅详细的脑部图引出对脑区、通路和感官的概括。答案比较概括,我建议继续追问。图像解释可能听起来很自信,却遗漏或编造细节,因此读者应核实技术内容。
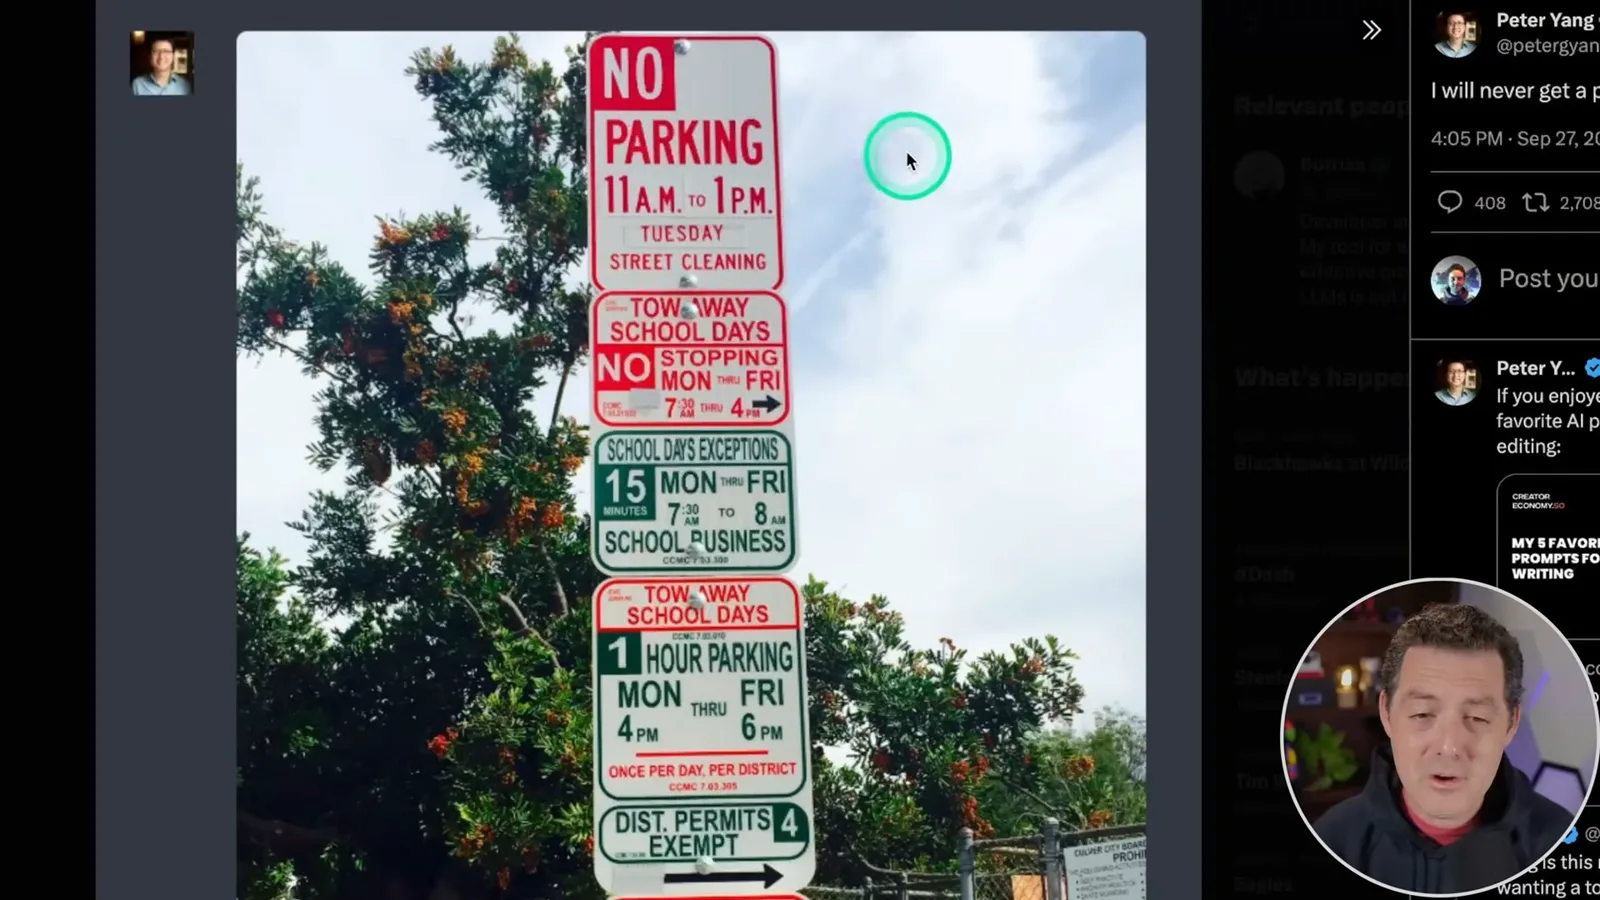
Peter Yang 的例子展示多个停车标志,并询问周三下午 4 点能否停车。模型回答可以停一小时。视频没有独立核实完整的当地规则或所有条件;模型回答不能代替检查标志和适用限制。
一张教材习题页的照片得到了逐步解答。我没有检查答案,而展示的页面包含物理题,因此演示不能证明所有题目都被正确读取或解答。它确实展示了学生如何请求解释图片中的材料。
研究、语音与建筑
例子包括设计命名、论文摘要、生成对话和房屋建造请求。
两张室内照片促使模型为古典特征与现代家具的融合提出“Athenian modernism”这一名称。这是针对图片提出的创意标签,并非已经确立的建筑分类。
一位用户上传研究论文图片,请求高中生水平的解释。回答总结了指令数据选择的主题。清楚的回答本身并不能证明每行小字都被准确读取,也不能证明摘要涵盖整篇论文。
另一个语音例子展示两个 ChatGPT 声音彼此对话。它说明的是语音界面,而非图像理解;这段随意对话是生成对话的演示,并不能证明系统像人一样相互理解。
一位用户展示一张粗略的房屋图片,询问如何建造。模型开始建议采购材料,包括提到一家零售商;完整材料清单没有在视频中显示。我猜测产品提及可能创造广告机会,但这个例子不能证明存在付费植入或赞助。
谜题与图像转代码
Berman 考察填字游戏、界面原型,以及一个需要引导性提示才得到回应的标志。
填字游戏图片和线索产生了一个看似可行的解答。原帖作者和我都没有检查答案,因此应将其视为未经验证的例子,而非谜题已被正确解答的证据。
一张仪表盘截图被用作生成网页代码的依据。发帖者随后运行结果,展示图像如何为实现提供起点。片段不能证明生成的网站复现了所有功能、具备安全性或已可投入生产。
另一个例子将 Figma 设计转换为使用 Material UI 的 React 组件。发帖者说,模型还推断出了可能的数据属性。我认为这可能缩短从设计到代码的工作,但视觉相似的组件仍需要测试、无障碍检查和集成。
Schirano 测试了一幅在场景中嵌入标志的作品。ChatGPT 起初描述景观时没有提到标志,接着表示没有看到;用户明确说出 OpenAI 标志后,它才表示赞同。引导性提示可能影响回答,因此之后的赞同本身不能证明独立识别。
一张手绘主页草图变成包含标题、输入框和按钮的简单页面。我设想这能让非技术人员更容易制作原型。基本模型只是起点,不会自动成为完整可用的商业网站。
识别与错误
其余例子涉及电影画面、扑克、玩具人物、日程本和交易图表。模型误数了一手扑克牌。
另一个分享的例子使用自定义指令询问电影《Her》中的一幅画面,并报告了识别角色和演员的回答。视频展示的是历史示例;它不能证明此类识别可靠,也不能证明某种特定行为如今仍然可用。
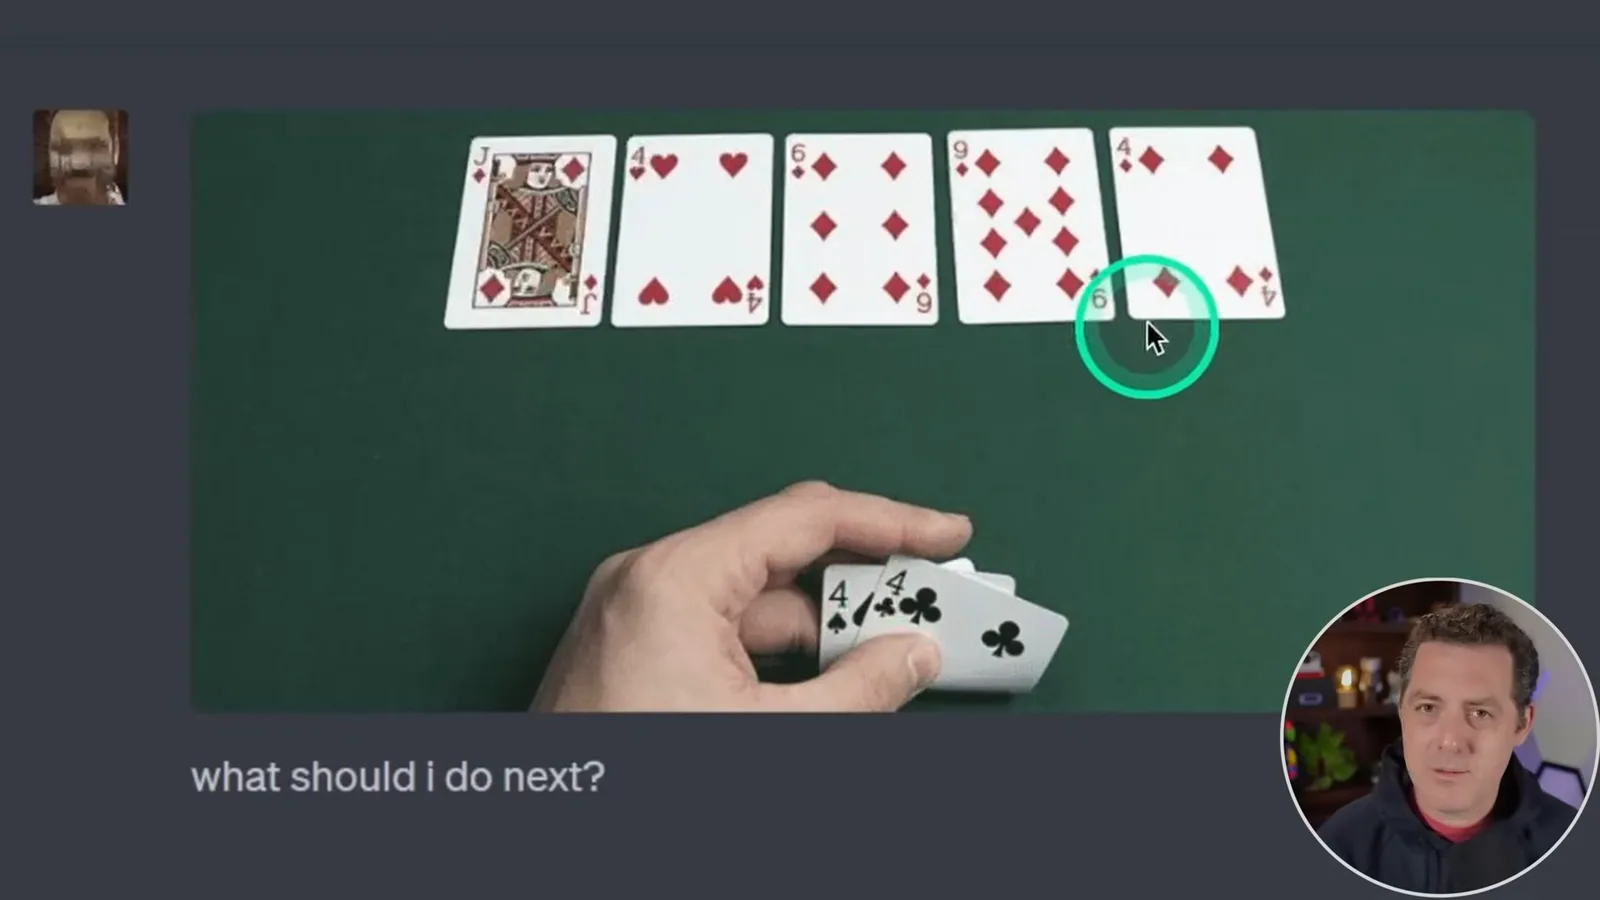
Ethan Mollick 分享了一张扑克图片:玩家手中有两张 4,桌面上还有两张 4。模型将其称为三条,但可见的四张 4 构成四条。这是看似合理的回答误数视觉证据的明显例子;下注决策还取决于游戏背景。
一张两个玩具人物的图片让模型描述它们看起来携带的装备。Berman 指出一些细节只是近似判断。这个例子提醒我们,物体识别和自信的解释,不等于对每个物体都完成了经过验证的识别。
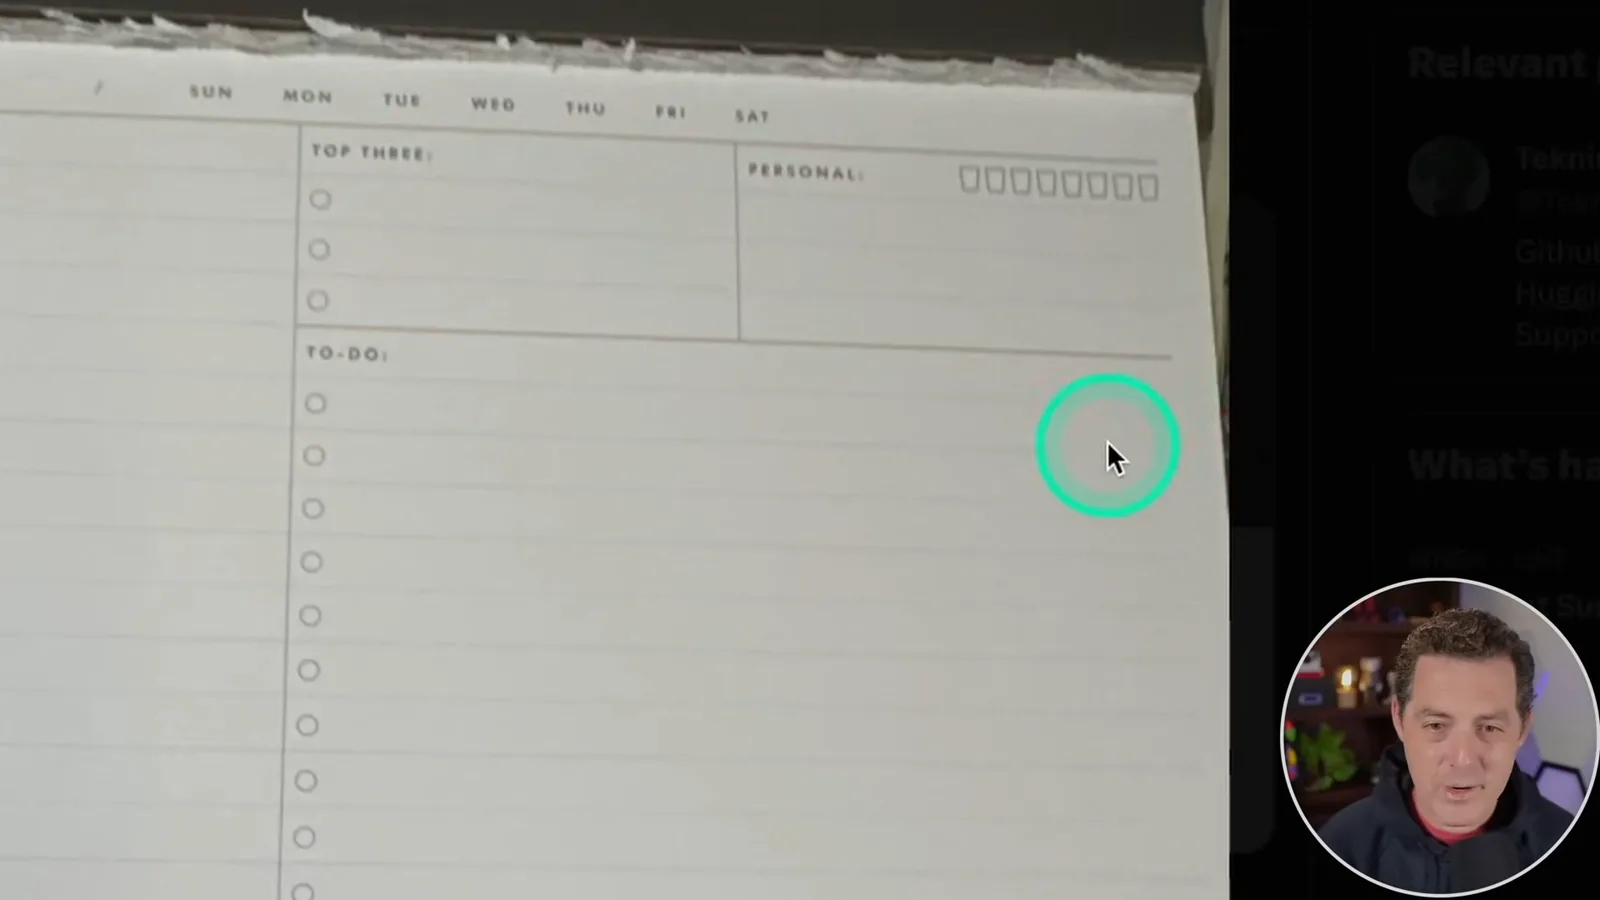
用户拍摄日程本,请求生成具有类似优先事项、任务和笔记区域的 Python Tkinter 界面。生成的界面很好地说明了图像转代码原型制作,但同样需要运行和测试生成的软件。
一个交易图表示例询问下一笔交易。根据视频,回答拒绝给出具体交易,同时描述图表元素。单个例子中的行为不能证明每一次图表解读或未来回答都会准确。
最后,我说明自己还没有亲自测试视觉功能,希望获得权限后进行研究。这些早期用户例子展示了多种基于图像提问的可能性,而未经检查的回答和扑克错误也说明,理解演示时必须同时看到其局限。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。