30 秒看懂
2025 年 10 月,Matthew Berman 通过一组选定的生成片段评测 Sora 2,并介绍当时的人物客串和提示词操作流程。他对部分人物相似度、镜头运动和视觉效果印象深刻,也发现身份混合、物体变形、物理效果不一致和图表不准确等问题。这些是非正式、经过挑选的演示,不是受控评测;视频包含 Lindy 和 Dell Technologies 的赞助。OpenAI 后来表示,Sora 产品自 2026 年 4 月 26 日起不再提供,因此演示中的界面和访问步骤仅具历史参考价值。
- 1创意联动与人物客串Berman 展示虚构角色和生成的人物形象,并介绍当时自己的客串设置。这些例子不能决定版权归属或使用许可。
- 2人物形象可能偏移不同结果中的面部和声音有所变化,一个生成场景还混合了 Berman 与同事的特征。
- 3手与物体洗牌和弹键盘示例暴露出接触不自然及变形问题;相比之下,Berman 认为一段折纸片段效果更好。
- 4物理真实感有好有坏Berman 觉得部分烟雾和液体片段令人信服,其他例子却没有呈现预期的物理交互。
- 5图形可能误导一个生成图表的柱子高度与数字标签不符。
- 62025 年的操作流程Berman 演示了录制形象、标记客串人物和选择画面方向;OpenAI 后来停止提供 Sora 产品。
要点建议
- Sora 2 可生成带音频的视频;推出时支持通过短录制创建人物形象,并由用户控制使用权限。
- 人物相似度和声音会随生成结果变化;Berman 发现过两个人的特征混在一起的例子。
- 片段呈现了令人信服的镜头效果和部分液体画面,但手部、纸牌、物理交互和连续性也会出错。
- 文字可能清晰可读,相关数字图形或旁白却仍不一致。
- Berman 挑选的片段展示了可能性和失败方式,不能衡量可靠性,也不能证明有权使用受版权保护的角色。
- OpenAI 表示,Sora 产品自 2026 年 4 月 26 日起不再提供。
按章节阅读整理后的全文
创意示例与人物形象
Berman 从虚构角色联动和自己的客串开始,随后检查生成的人物与原型有多相似。
Sora 2 是一款视频和音频生成模型,我一直在探索人们能用它创造什么。在这期 2025 年 10 月的评测中,我查看有趣的角色联动、生成的人物形象,以及更系统地测试运动、镜头和视觉一致性的提示词。这些选定片段展示了我的体验,不是受控基准测试。
我先展示虚构角色出现在意想不到的场景中,包括说唱表演和复古游戏风格片段。角色相似度和生成音频让我印象深刻。我把当时的情况称作“版权荒野”,但生成示例不能证明使用获得了授权,也不能证明版权限制不适用。
2025 年的应用还允许用户录制自己的外貌和声音,创建客串人物。我说自己当时允许别人使用我的客串形象,并展示了一段有多人的生成播客。产生的对话是合成的,不是这些人真实说出那些话的录音。
我展示更多想象中的联动片段,涉及可辨认的游戏和动画角色,也包括我的客串形象。重点是创意范围和娱乐性,但这些画面都是虚构的。人物形象或角色能否使用,取决于许可和适用规则,而不只是工具能生成什么。
接下来我更仔细地看人物。一段生成片段把我扫描的形象放在有色面罩后面,我觉得面孔、光线和反射都很逼真。我估计大多数时候都很相似,这只是对自己示例的非正式印象,并非测得的错误率。
人物、运动与手部
更多客串示例既有逼真的面孔,也有身份混合。精细物体操作和部分身体交互暴露出错误。
在另一段片段中,我的队友 Jonah 的客串形象也很接近本人,但我看到皮肤和头发纹理变化。同一提示词多次运行会产生不同结果,我的声音有时很准确,有时偏差明显。重新运行可能得到不同结果,但不能保证修正问题。
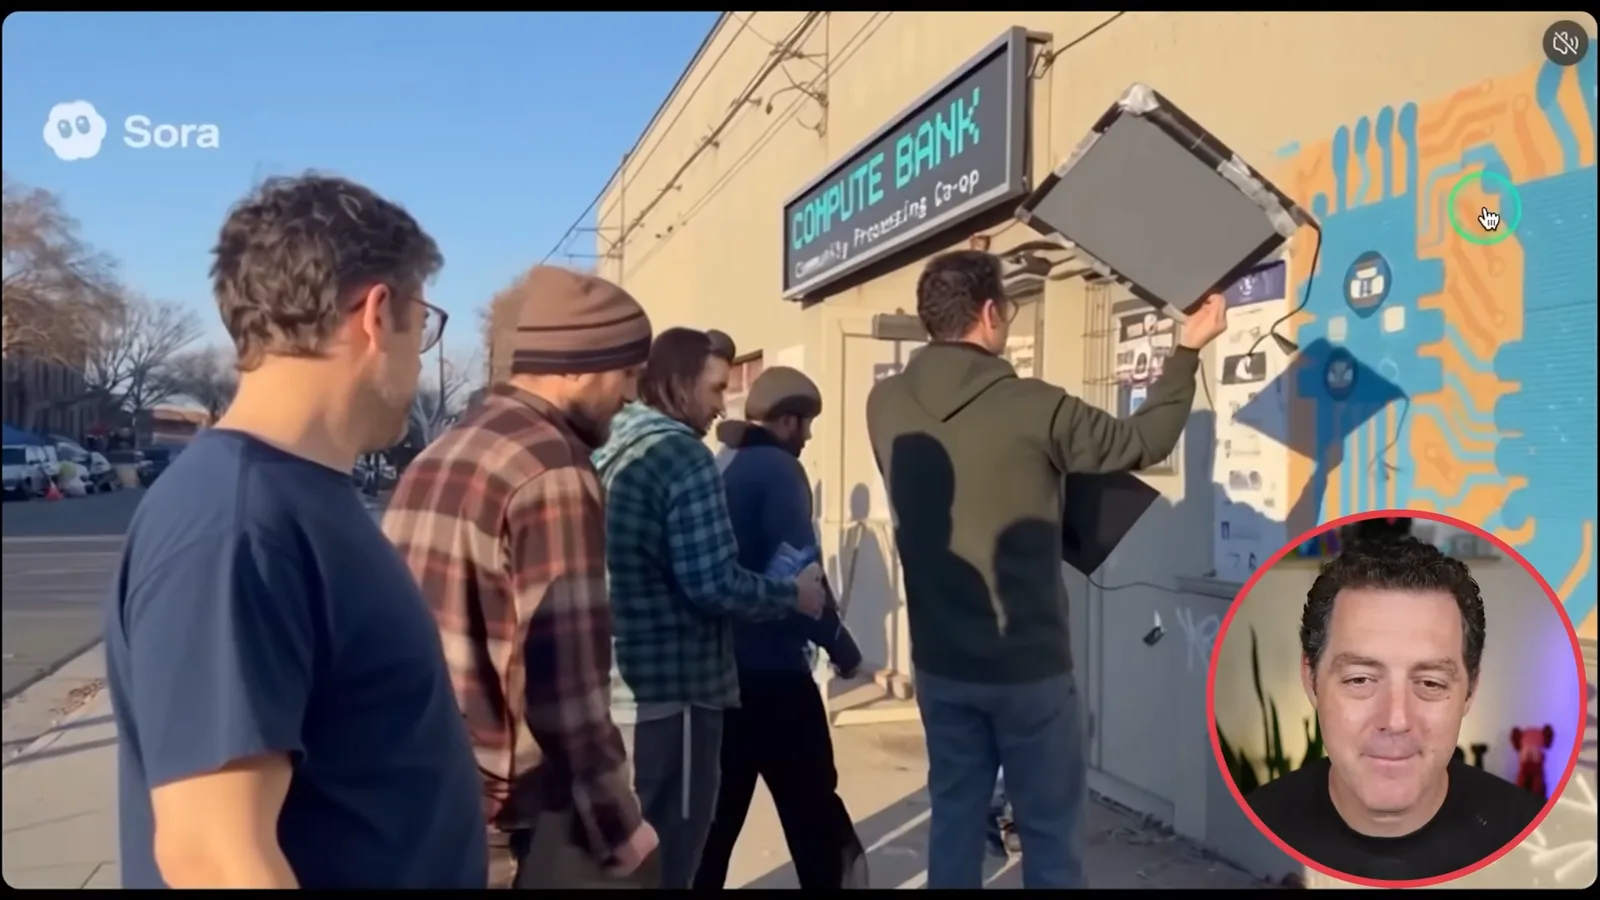
在一个关于虚构“算力银行”的场景中,模型混合了我和 Jonah 的特征。生成的我戴着属于他风格的耳环,而他的面孔似乎也混合了我们两人的元素。这是多个客串人物同时出现时身份一致性失效的一个例子。
在另一个想象场景中,我扮演考古学家,发现金字塔下方的数据中心。面部相当接近,但我注意到形变和声音中的数字伪影。场景和旁白都是生成的虚构内容,并非历史发现。
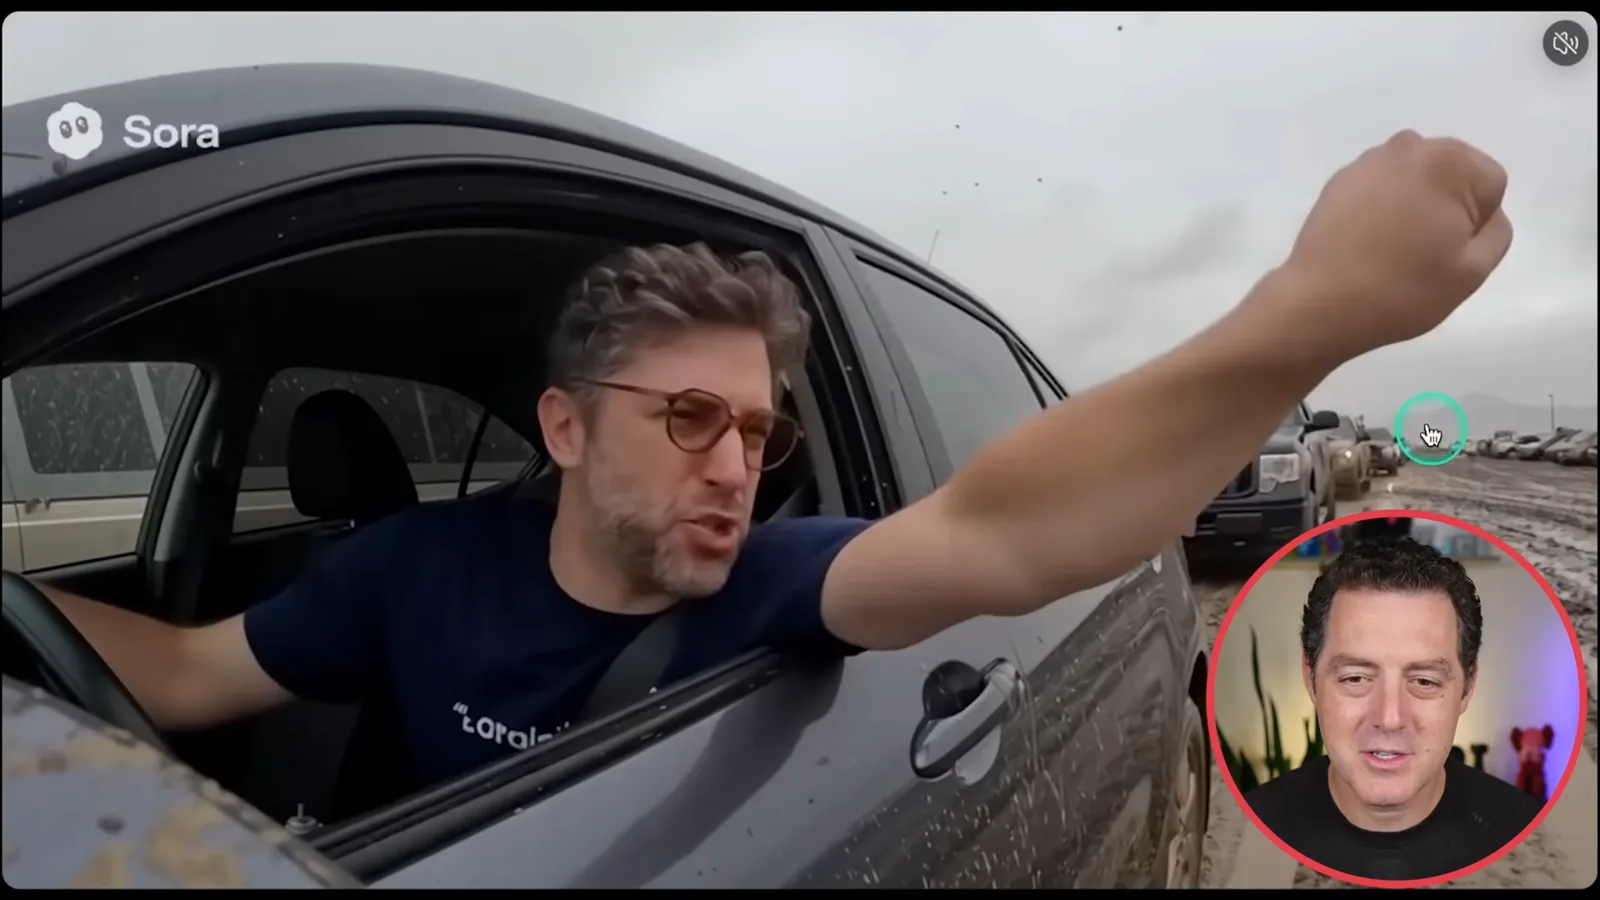
Jonah 身处交通中的场景暴露了更多问题:手会变形,汽车看起来倒着开,车辆也改变形状。在我看来,他的脸仍能较好辨认,说明即便场景其余部分不一致,单个元素也可能看起来不错。
舞蹈课客串和狗狗比赛片段很有趣,单看狗本身也很逼真。但我注意到一条牵引绳似乎没有人握着。另一段接麦片的片段很好地把握了喜剧停顿,而一段说唱对决没能保持我们的相貌。
测试物理效果时,一个球停下来后似乎反方向旋转,尽管周围场景看起来很逼真。这种反差很重要:漂亮的纹理和熟悉的背景并不能保证动作符合物理规律。
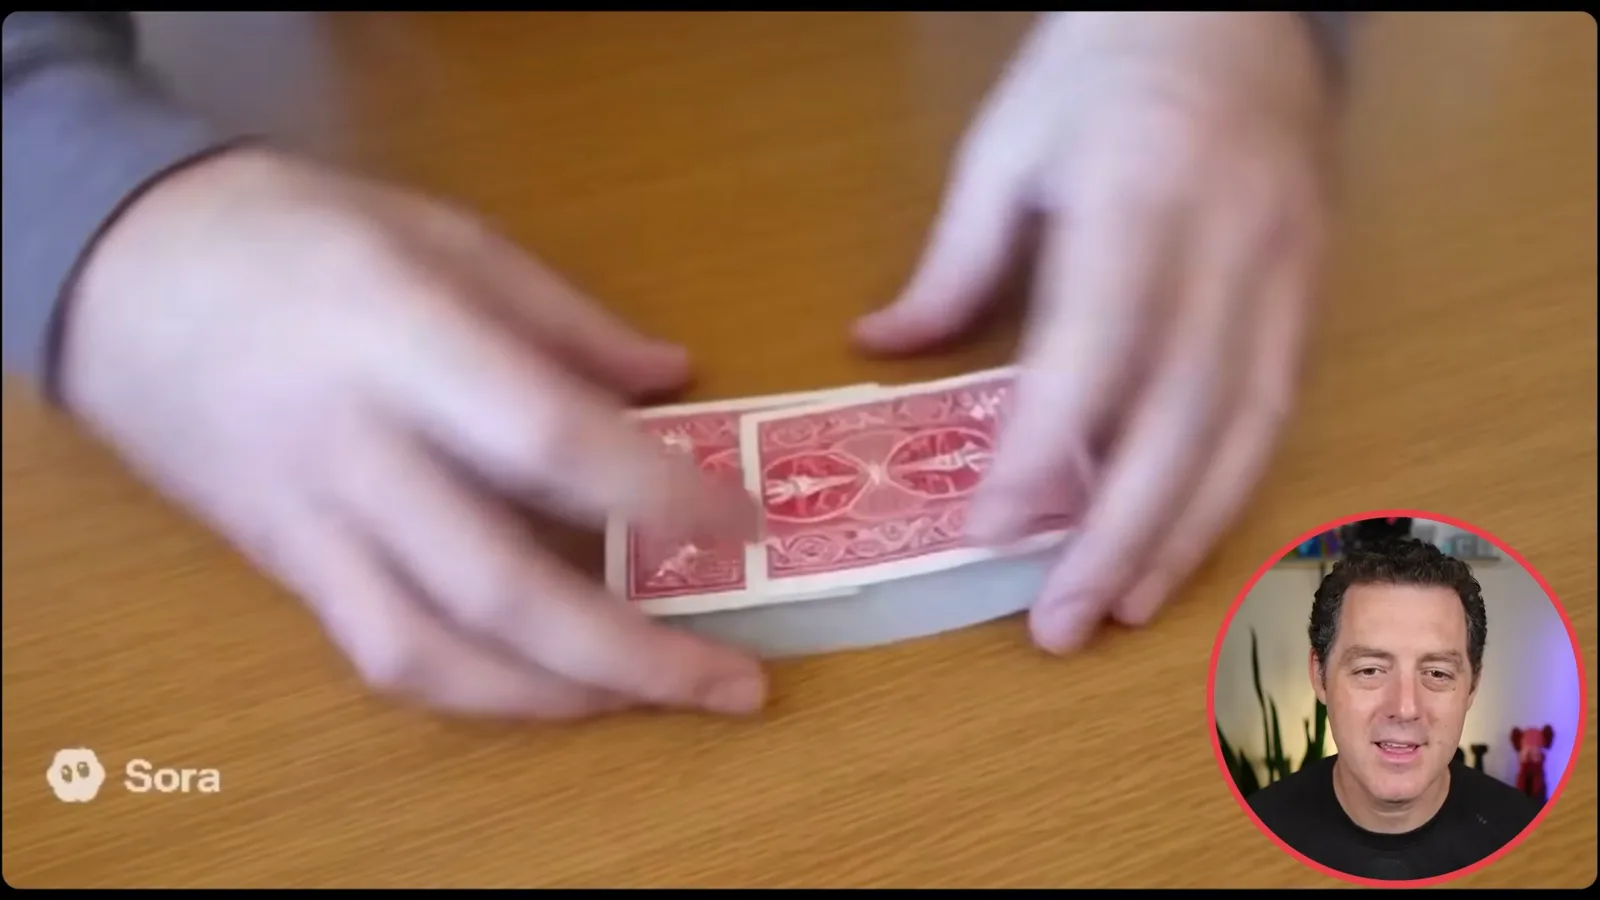
我用键盘颤音和洗牌测试手部精细动作。手指并非总能自然接触琴键;洗牌时,纸牌会融合、变形或突然出现。在这些例子中,静止画面里的手有时看着合理,但操作小物体仍很困难。
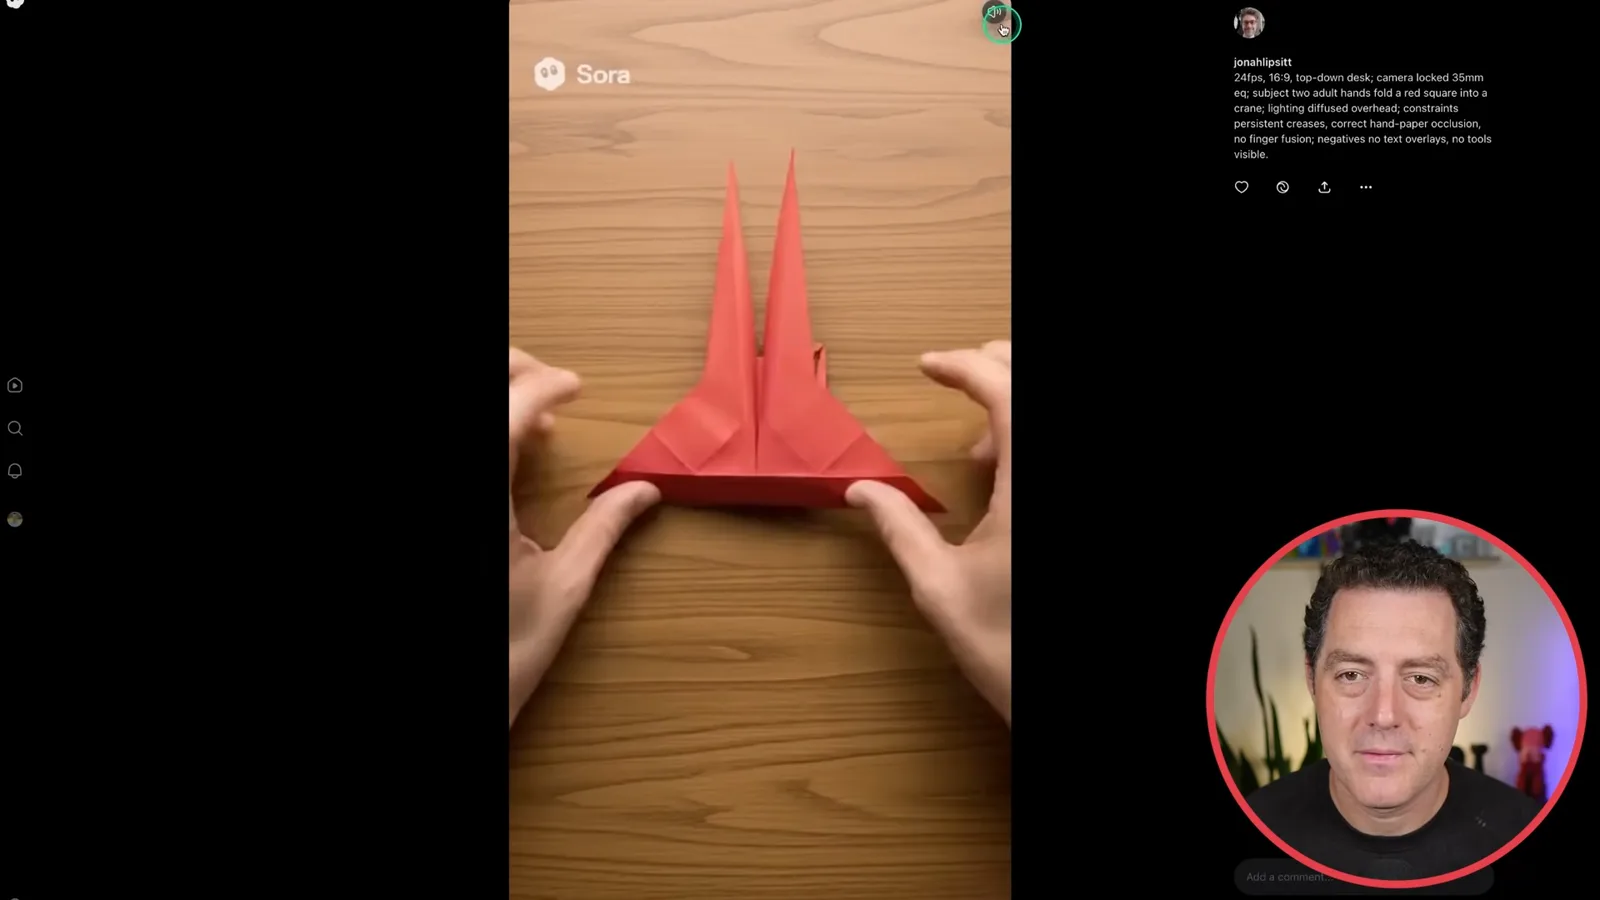
一段与青蛙进行柔术的虚构场景出现了身体部位混杂,包括一只绿色手从我的衣服中伸出。相比之下,折纸提示词生成的红纸鹤和手比我预期的更好,尽管折叠过程本身有些别扭。
厨房提示词生成的食物在静止时很诱人,但我注意到转换问题、意外窜出的火焰和突然出现的食材。我觉得一段风格化现代舞效果不错,不过剪影呈现也让细微身体变形更难察觉。
镜头调度与物理模拟
Berman 测试镜头运动、焦点、流体和光线。结果既有令人信服的画面,也有不一致的交互。
为了测试镜头调度,我要求镜头越过屋顶通风口升向日落天际线,并加入克制的镜头光晕。结果基本遵循了指令,尽管我发现细小的画面形变。另一段从书桌快速摇向城市窗景的镜头,也似乎按要求重新对焦。
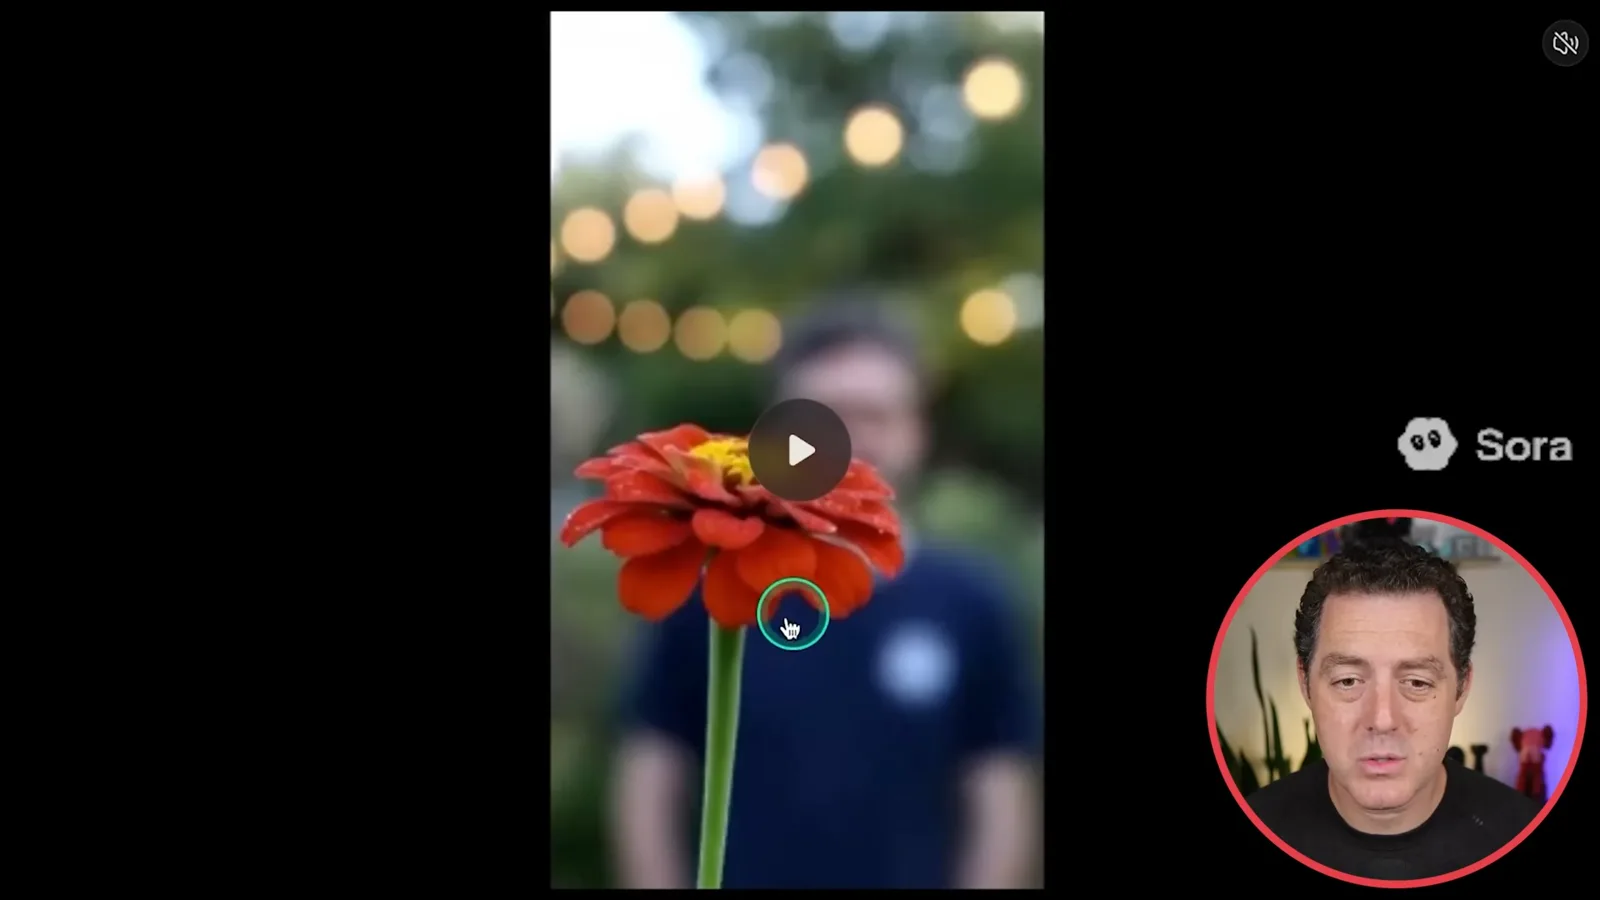
一个焦点转移提示词让焦点从前景的花转到背景中的 Jonah。另一段镜头从昏暗走廊进入明亮房间,并逐渐调整曝光。我认为这些例子的调度效果不错,但也注意到部分片段看起来分辨率较低。
然后我测试液体、烟雾和粒子。蜂蜜和浓缩咖啡在我看来很逼真,一匹马在水中奔跑时溅起水花,尽管可能有些夸张。香烟雾本身看起来很自然,即使背景中的风扇似乎没有影响它。
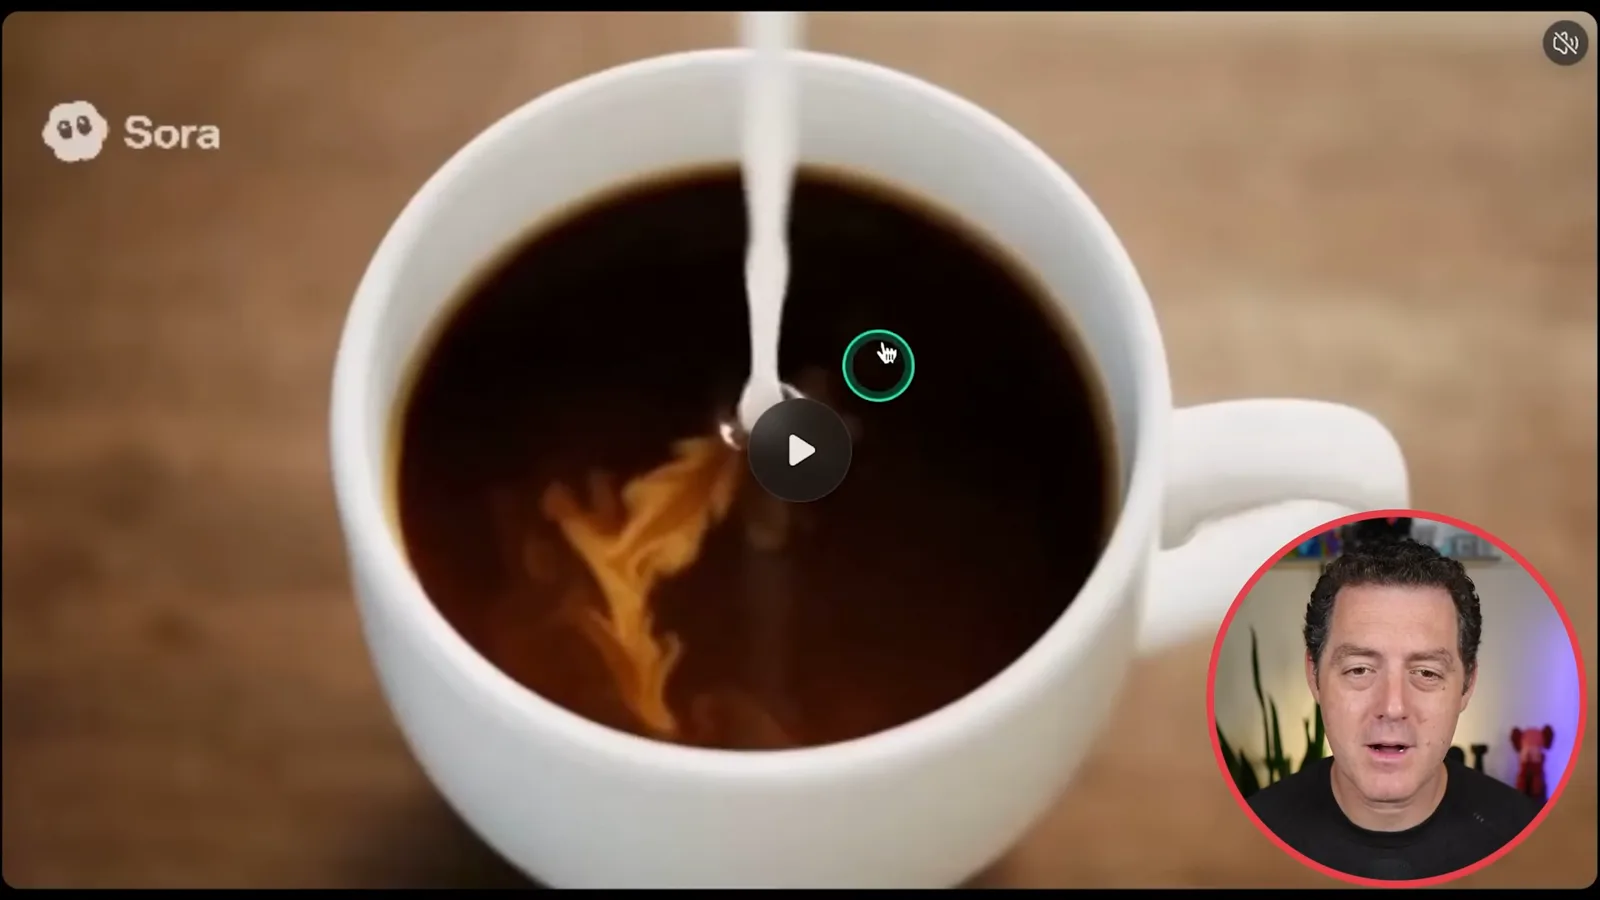
失败例子同样有启发。倒入咖啡的牛奶没有形成我预期的可见羽流,锅中的番茄尽管周围有气泡却保持静止。我觉得汽水片段和绕过玻璃杯的雾气表现更好,但漂亮的样本不能证明流体模拟总体准确。
棱镜生成了彩虹和令人信服的天鹅绒纹理,但我对光线的行为没有那么确定。我还查看了覆盖在图案卡片上的网格,以及火光照亮双手的场景。这些都是视觉观察,而非物理测量。
在选定片段中,旋转的戒指和反光金属球看起来很逼真,尤其是反射效果。这种印象来自观看输出,并不能证明反射几何在所有情况下都准确。
图形与当时的操作流程
生成文字和图表的表现有好有坏。Berman 演示 2025 年输入提示词和添加客串的界面。
测试动态图形时,简单动画短语清晰可读,plan、build、launch 的序列也有效。手写效果更像文字出现,而不是准确写出来。时间线重复日期并与旁白不匹配,说明可读元素仍可能在语义上不一致。
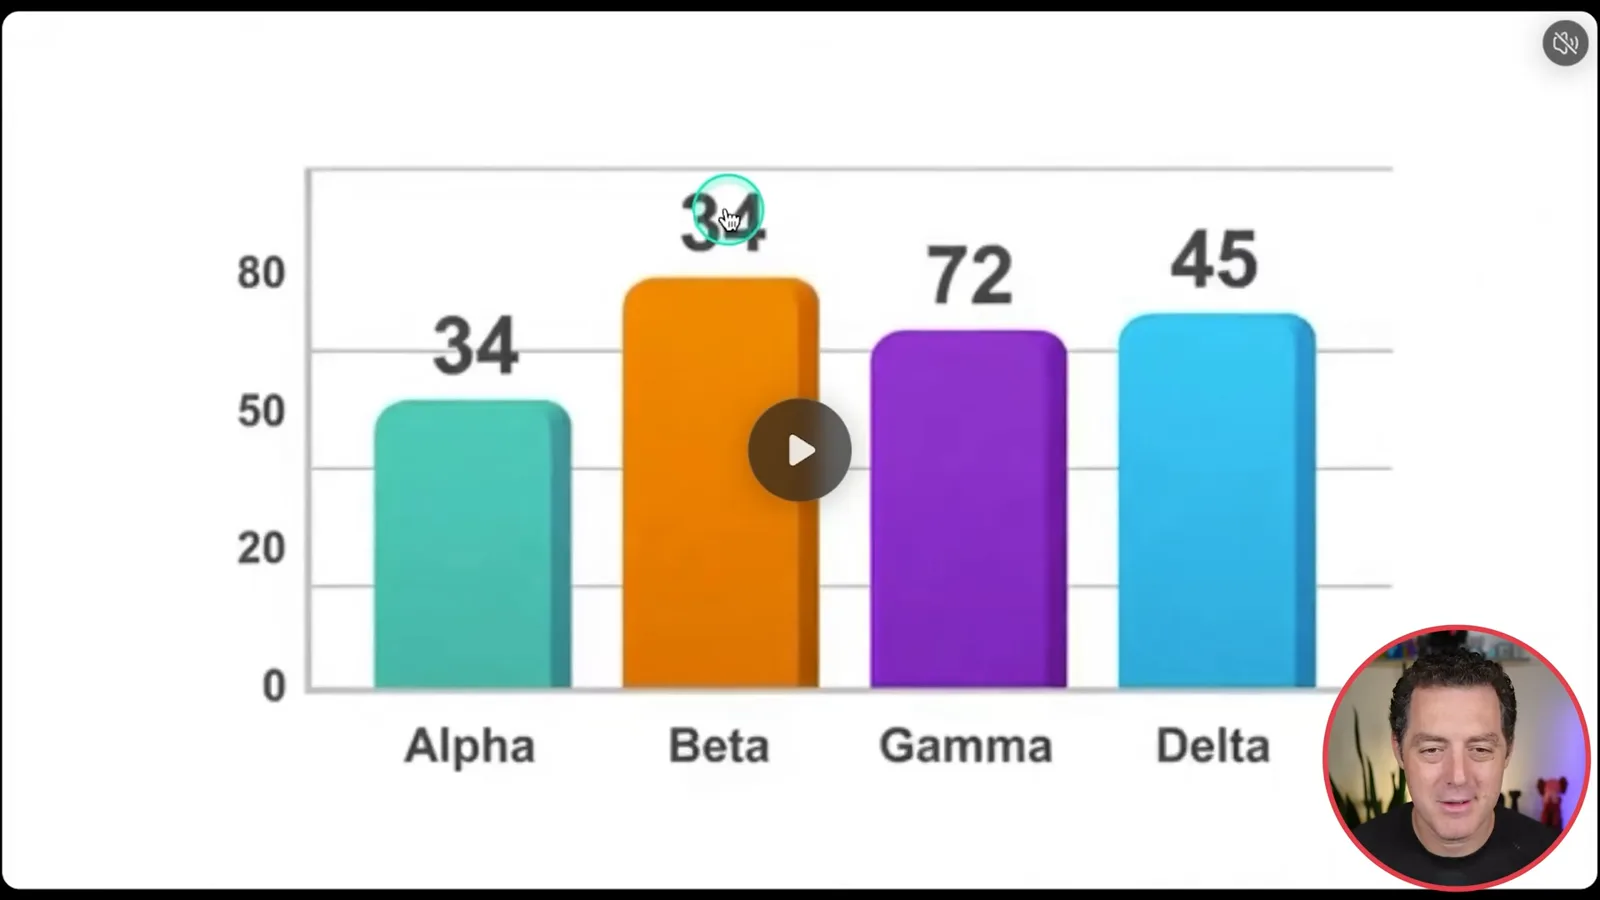
一张生成柱状图尤其容易误导:标注相同数字的柱子高度不同,其他标签也与视觉排序不一致。图表即使看起来精致,仍可能错误表达数字,因此需要核对标签和图形比例。
一段炒面片段在我看来保持了连贯,但它没有声音。公交车窗上的“Next Stop Lakeside”贴纸始终位于移动背景前方,字母没有明显变形。这些是多种结果中的成功例子,不代表可靠性比例。
我演示 2025 年的操作流程:获得访问权限后,用户录制一段简短的面部和声音扫描、编写提示词、标记可用的客串人物,并选择竖屏或横屏。OpenAI 表示人物形象使用权限由用户控制。这是历史说明:OpenAI 后来表示,Sora 产品自 2026 年 4 月 26 日起不再提供。
复杂场景、风格与天气
人群、插画风格和自然现象展示了优势与局限。视频以轻松的角色联动片段收尾。
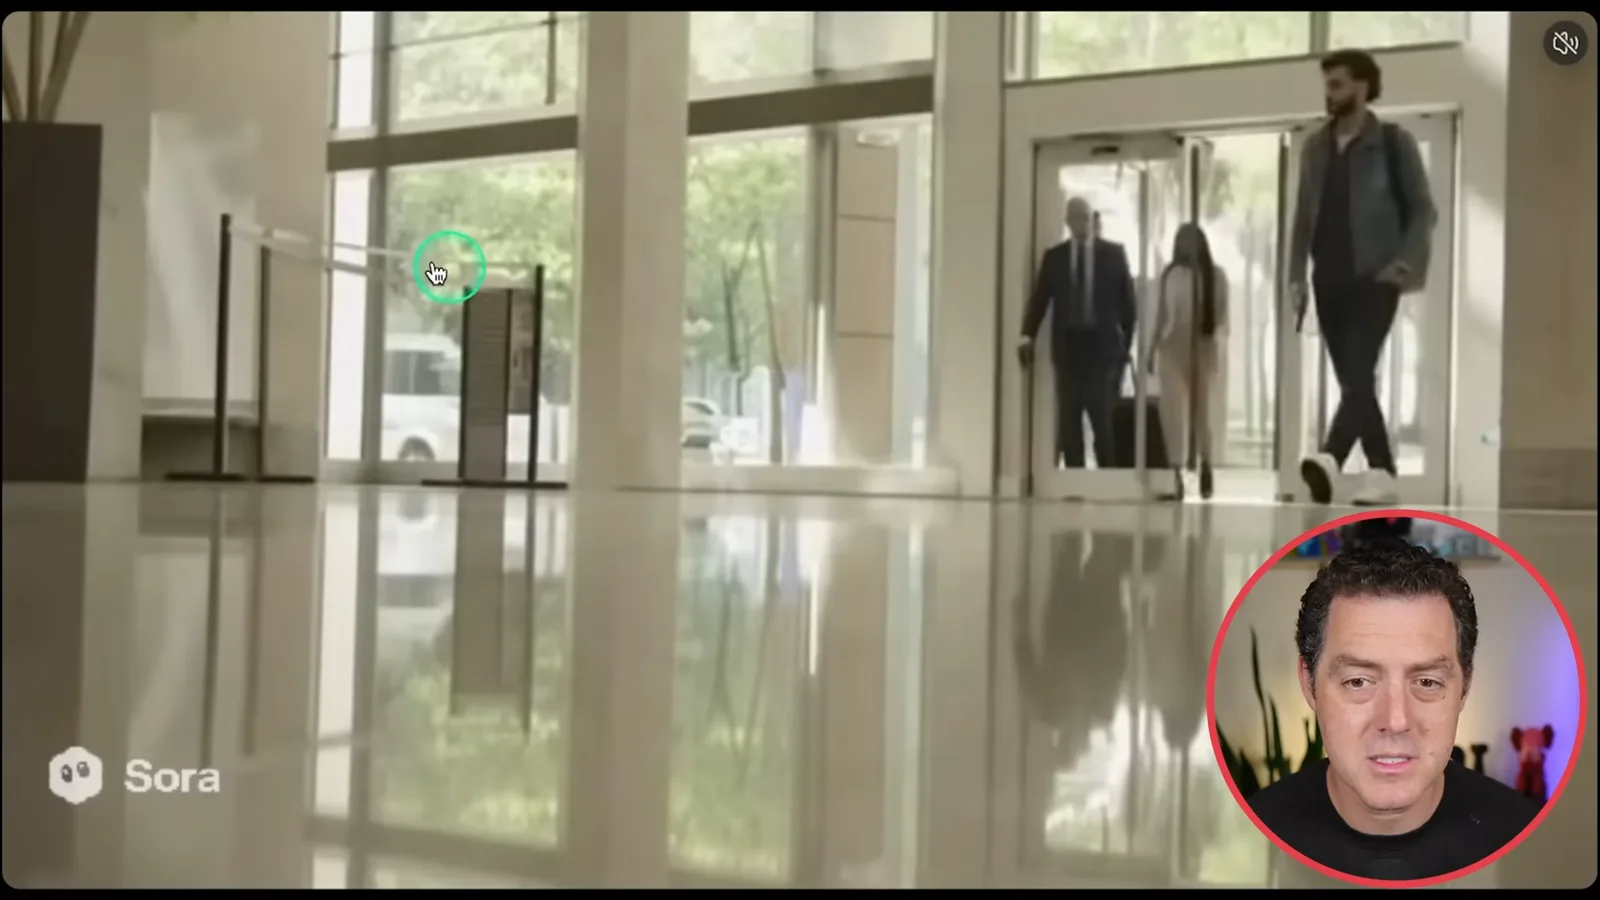
我展示的拥挤露天市场片段较好地保持了许多物体和人物的一致性,但另一段人群进入建筑的画面中,有人穿过门或与栏杆融合。人行横道片段表现更好,但雨伞有一些穿模。因此,即使反射效果不错,复杂场景的结果仍可能差别很大。
对于非照片写实风格,我展示了水彩船只、动画机器人和类似定格动画的场景。我认为风格化可以让结果更有吸引力,也可能让某些逼真画面中的错误不那么显眼;喜好仍取决于观众。
天气和环境示例包括黄昏鸟群、降雪和拍打墙面的海浪。有些鸟消失了,也有少量蒸汽意外出现,但路灯照亮的雪和海浪让我印象深刻。这些是对单个生成片段的主观观察。
最后我展示轻松的生成场景,包括瑜伽和虚构赛车角色联动。我注意到一些点名的作品被接受,其他请求却遭到拒绝。测试结果不一致,并不能确定权利人允许什么,或平台政策保证什么。
最后一段片段想象我成为 20 世纪 90 年代的说唱歌手。总体而言,我很享受这些实验,同时这些例子也说明人物相似度、运动、数字准确性和物理交互仍需要仔细检查。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。