30 秒看懂
2023 年 12 月,Matthew Berman 讨论 Sam Altman 回归 OpenAI、新的初始董事会、有关 Q* 的报道、Elon Musk 关于版权和 AI 时间表的说法,以及 Nathan Lambert 关于合成数据的文章。Berman 推测,一项研究突破以及安全与商业化之间的分歧引发了领导层危机,Q* 则涉及自我改进的合成数据。他展示的来源都没有证实这两项说法。 OpenAI 于 2024 年 3 月总结的一项后续独立调查表示,前董事会的决定并非出于对产品安全、安保或开发速度的担忧。视频中没有确认的赞助环节。
- 1领导层回归OpenAI 宣布 Altman 回任、Mira Murati 回任 CTO、Greg Brockman 回任总裁,并成立新的初始董事会。
- 2关于董事会的一种理论Berman 推测 AI 突破和安全争议导致 Altman 被解职。展示的资料没有证实这一点;OpenAI 后来总结的调查称,该决定并非出于对安全或开发速度的担忧。
- 3有关 Q* 的采访Altman 拒绝讨论相关报道,并提及一次令人遗憾的泄露。他没有确认具体技术说法,也没有确认它与董事会决定有关。
- 4版权与时间表Musk 声称 AI 公司使用受版权保护的材料训练,并预测技术将快速进步;他的采访不能解决版权问题,也不能确定未来能力。
- 5合成数据与反馈Berman 借助 Nathan Lambert 的文章解释生成式训练示例、规模化的潜在好处,以及对质量和对齐的担忧。
- 6自我对弈与评估围棋提供清晰的胜负反馈,开放式语言的评估则更困难,基准污染还可能扭曲结果。
要点建议
- OpenAI 于 2023 年 11 月宣布 Altman 回任 CEO,初始董事会成员为 Bret Taylor、Larry Summers 和 Adam D'Angelo。
- Altman 提及一次“令人遗憾的泄露”,并没有确认所谓 Q* 系统的细节、能力或作用。
- Berman 提出的 Q*、商业化与董事会行动之间的联系属于推测;OpenAI 后来的调查总结给出了不同说法。
- Musk 关于版权的说法和 AI 将快速进步的预测是他个人的表述,并非已定的法律结论或得到证实的预测。
- 合成数据可以大规模提供训练示例和反馈,但质量、多样性、评估及对齐仍是有待解决的问题。
- AlphaGo 同时使用了人类棋谱和自我对弈;不能将 Berman 的讲述理解为自我对弈只在击败人类高手后才被使用。
按章节阅读整理后的全文
OpenAI 领导层与董事会猜测
Berman 回顾 Altman 回归和新董事会,随后提出对前董事会动机的理论。展示的证据没有证实这一理论。
几条新闻交汇在一起:Sam Altman 回归 OpenAI、有关一个名为 Q* 的项目的报道、Elon Musk 对受版权保护训练数据的评论,以及合成数据的潜力。我认为它们可能存在联系,但我提出的联系是假设,不是现有公开证据确立的事实。
OpenAI 2023 年 11 月 29 日的公告称,Altman 回任 CEO,Mira Murati 回任 CTO,Greg Brockman 回任总裁。初始董事会由担任主席的 Bret Taylor、Larry Summers 和 Adam D'Angelo 组成。公司表示,将致力于治理工作,并对近期事件进行独立调查([OpenAI 公告](https://openai.com/index/sam-altman-returns-as-ceo-openai-has-a-new-initial-board/))。
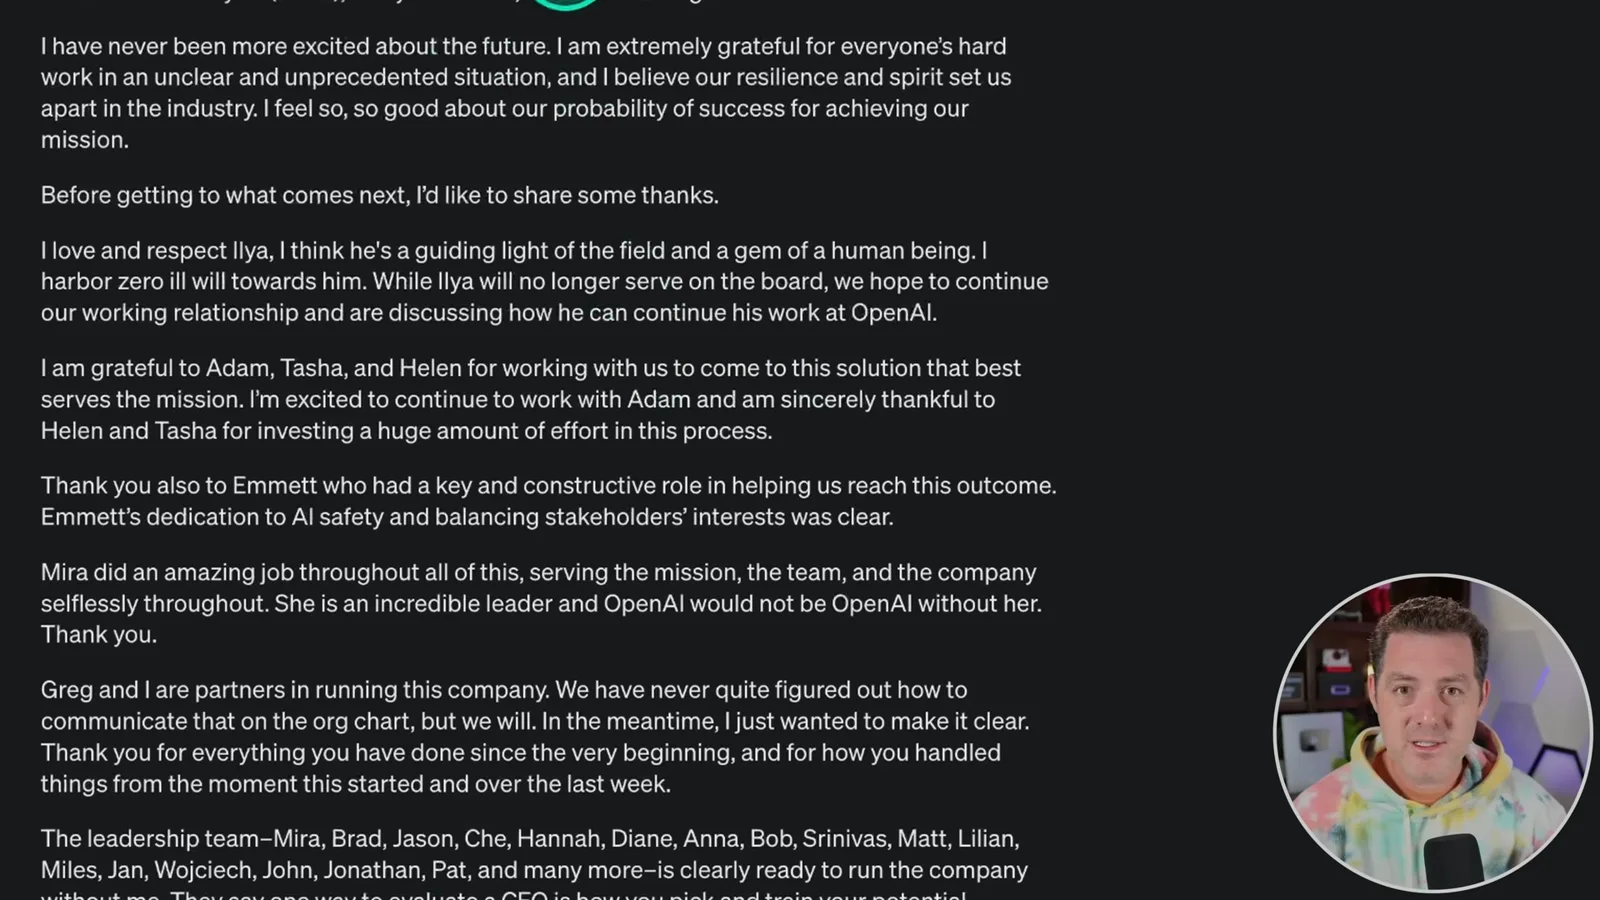
Altman 表示 Ilya Sutskever 将不再担任董事,并称双方希望继续合作。我推测一项重大 AI 发现以及是否将其商业化的分歧引发了解职。公告并没有这样说,Sutskever 离开董事会本身也不能证明他将离开公司。
考虑到 Musk 与 Sutskever 过去的关系,我还猜测 Musk 是否会试图招募他。这是我的猜测,不是存在工作邀约的证据。我将 Altman 的措辞理解为试图修复一段紧张关系,但这份说明并不能确立董事会行动背后的个人动机。
Altman 感谢了离任董事和曾短暂担任临时 CEO 的 Emmett Shear,并强调了他与 Brockman 的合作关系。我讨论了 D'Angelo 继续担任董事以及他与 Poe 的关联。这些观察本身不能确立利益冲突,也不能解释董事会的决定。
公告中的领导团队名单没有 Sutskever,我将其解读为他未来可能离开的迹象。Altman 还赞扬了团队,并表示公司在事件期间没有流失员工。我对缺失名字的解读,并不是已经确认的人事决定。
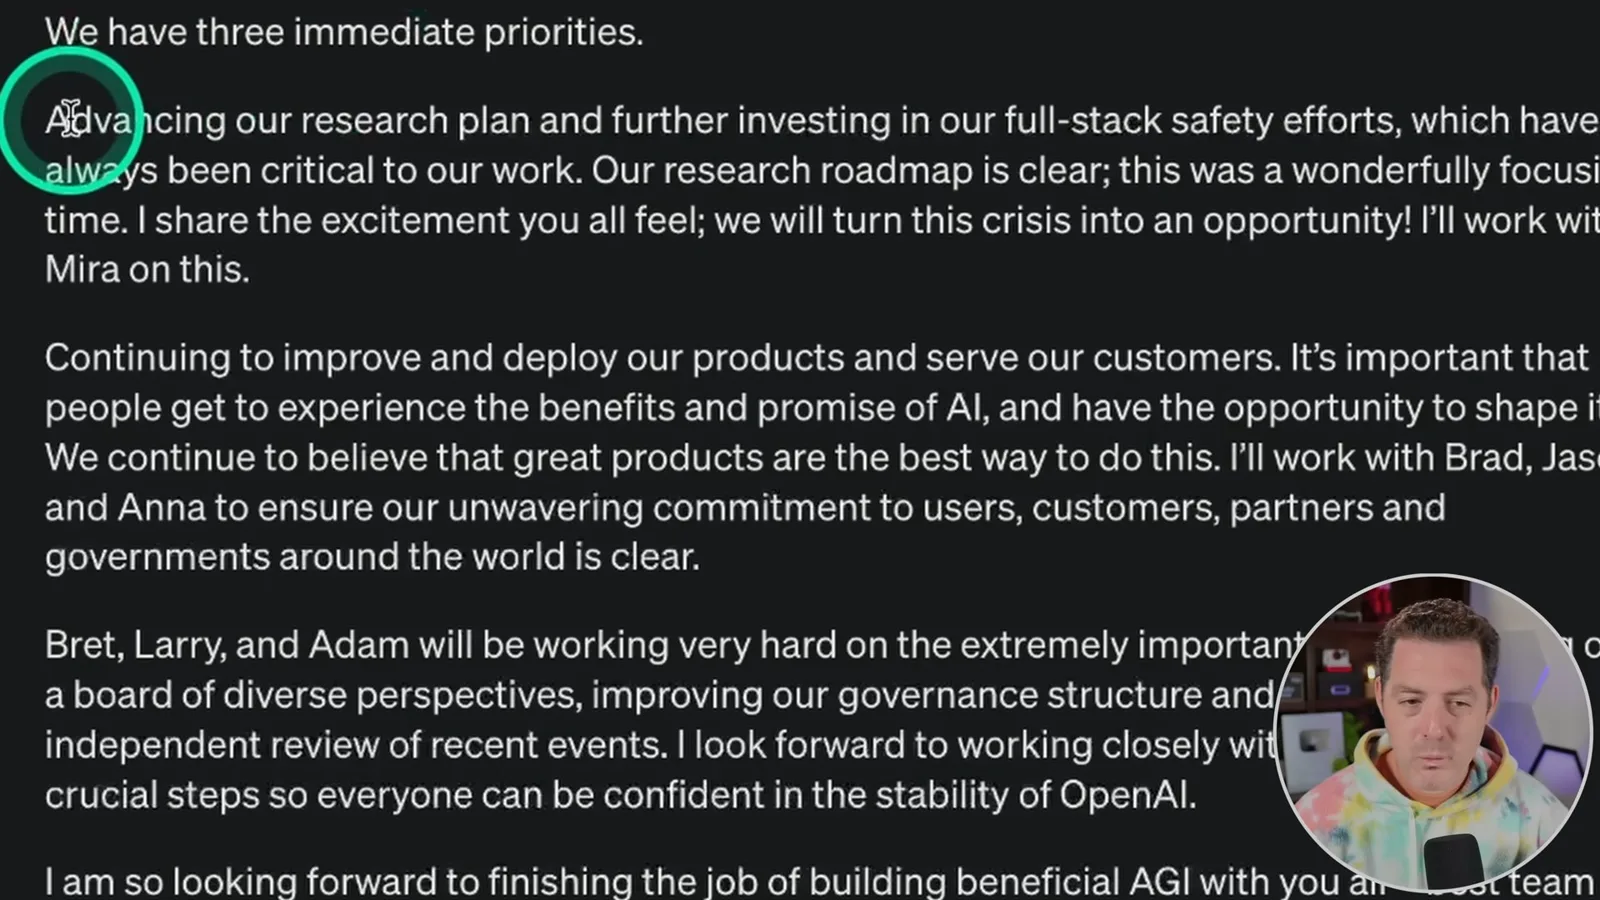
Altman 将研究与安全、产品部署,以及重建董事会和治理列为近期优先事项。我推断安全可能推动了争议,但声明本身并不支持这一结论。2024 年 3 月,OpenAI 对独立调查的总结称,前董事会的决定并非出于对产品安全、安保或开发速度的担忧([调查总结](https://openai.com/index/review-completed-altman-brockman-to-continue-to-lead-openai/))。
Altman 的采访与 Q*
Altman 拒绝解释解职原因,也不讨论报道中的 Q* 细节。Berman 对泄露说法的解读超出了采访所能证实的范围。
在 11 月 29 日接受 The Verge 的采访时,Altman 讲述了被邀请回归的经过,并说起初需要几分钟处理自己的情绪。当被追问为何遭到解职时,他没有给出详细解释,并欢迎独立调查。我仍然好奇,也推测这可能与 Q* 有关,但采访没有证实这种联系。
被问及有关 Q* 突破的报道时,Altman 表示对这次“令人遗憾的泄露”没有特别评论,并笼统谈到快速进步和安全问题。我把这一措辞理解为承认发生了泄露,但他没有确认报道中系统的架构、能力或其在治理危机中的作用。理解视频标题中的更广泛说法时应注意这一限制([The Verge 采访](https://www.theverge.com/2023/11/29/23982046/sam-altman-interview-openai-ceo-rehired))。
Musk 谈版权与 AI 风险
采访片段展示了 Musk 关于 AI 训练的说法及其对快速进步的预测。Berman 补充了自己对 X 数据和未决诉讼的看法。
在 Andrew Ross Sorkin 采访的一段片段中,Elon Musk 声称 AI 公司使用受版权保护的数据进行训练,并质疑相反的说法。这是 Musk 的指控。特定使用是否侵犯版权或适用法律例外,取决于事实和法律,不能仅凭采访解决。
Sorkin 询问上传到 X 的文章和引文,以及汇集这些内容可能对原始权利人意味着什么。我认为 X 使 Musk 能够接触到有价值的用户创作内容流,并推测限制 API 访问反映了其战略价值。这些是我的解读;个别引文被发布在平台上,并不会自动解决其用于训练时的版权问题。
Musk 表示,他预计 AI 进步会快于诉讼的解决,并描述了自己对 AI 风险逐渐采取宿命论态度的过程。采访画面还展示了他的预测:AI 可能在三年内超过最聪明的人。这是他在 2023 年作出的预测,不是已经确定的时间表,也不能因此假定法律争议不再重要。
我将 Musk 的预测与自己的理论联系起来:OpenAI 可能利用合成数据,超越仅用现有材料训练的模型。我认为这可能与 Q* 有关,但采访和展示的公开材料都没有证明这一联系。法律结果将不再重要的说法同样是一项预测,而非法律结论。
合成数据、自我对弈与基准
Berman 解读 Lambert 的文章,讨论生成数据能否让模型超越其来源,并谈到自我对弈、评估污染和开放模型微调。
Nathan Lambert 的[合成数据文章](https://www.interconnects.ai/p/llm-synthetic-data)提供了下一部分讨论。合成数据由机器生成,而非直接由人撰写;生成的指令、偏好和评价可以为训练或评估提供示例。它能够大规模生产,并不意味着天然准确。
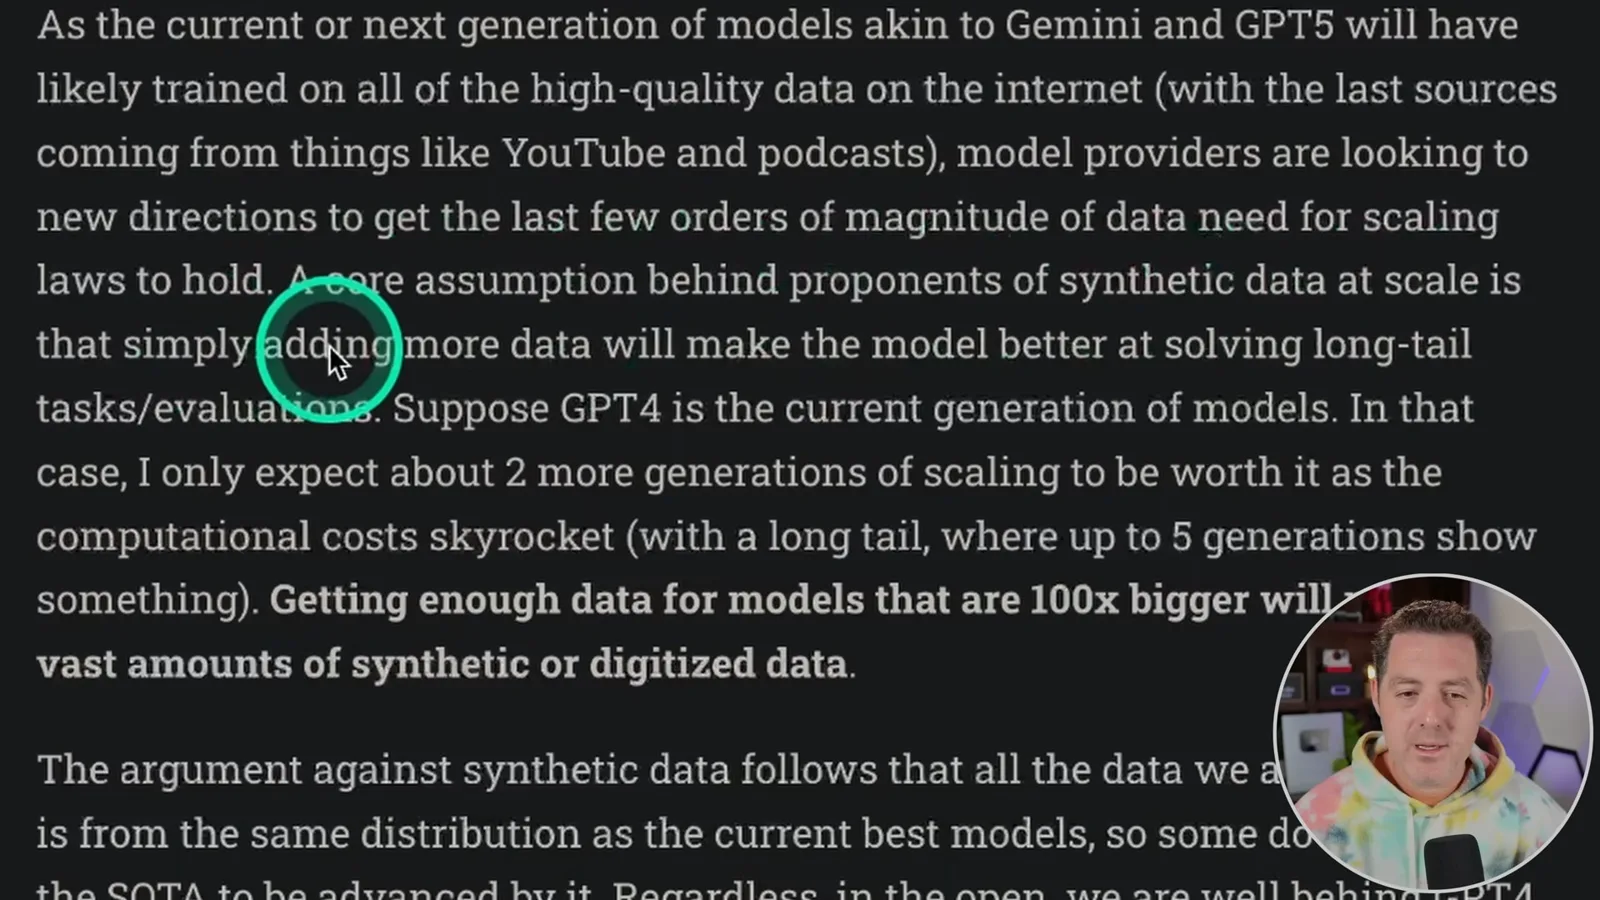
我认为人类创造的文本数量有限,而生成材料可能大幅扩充可供训练的数据量。我推测 Q* 可能生成高质量数据并用其自我改进,但这是展示的来源没有证实的假设。仅仅增加数据不能保证更好的模型或 AGI。
Lambert 讨论了在对齐工作中使用 AI 生成反馈的前景,包括 OpenAI 当时新成立的 Superalignment 项目。我看到了减少人类反馈瓶颈的吸引力,同时担忧交出过多监督权。自动化反馈也带来新的问题:评估者奖励什么,以及错误或偏见是否会被放大。
支持合成数据的一种论点是,更多样的示例可能提高模型在罕见任务上的表现。反对意见则认为,现有模型生成的输出可能带有自身局限和偏见,并不会自动推动最先进水平前进。我倾向于担心生成示例可能只是派生内容,同时也承认结果取决于数据如何生成、筛选和评估。
我将这个问题与 AlphaGo 从自我对弈中学习相比较。围棋有清晰的胜负信号,因此迭代评估比开放式语言更直接。这里需要补充历史背景:最初的 AlphaGo 在著名的李世石比赛获胜之前,就同时使用了人类棋谱和通过自我对弈进行的强化学习;后来的 AlphaGo Zero 则没有使用人类棋谱进行训练([Google DeepMind](https://deepmind.google/research/alphago/))。
对于语言模型,判断哪个答案更好可能困难得多。自动化基准有帮助,但当评估示例或密切相关材料出现在训练数据中时,就会发生污染,使得分对泛化能力的反映变得不那么可靠。我自己的测试提示是一种观察行为的方式,但少量个人测试也无法避免局限。
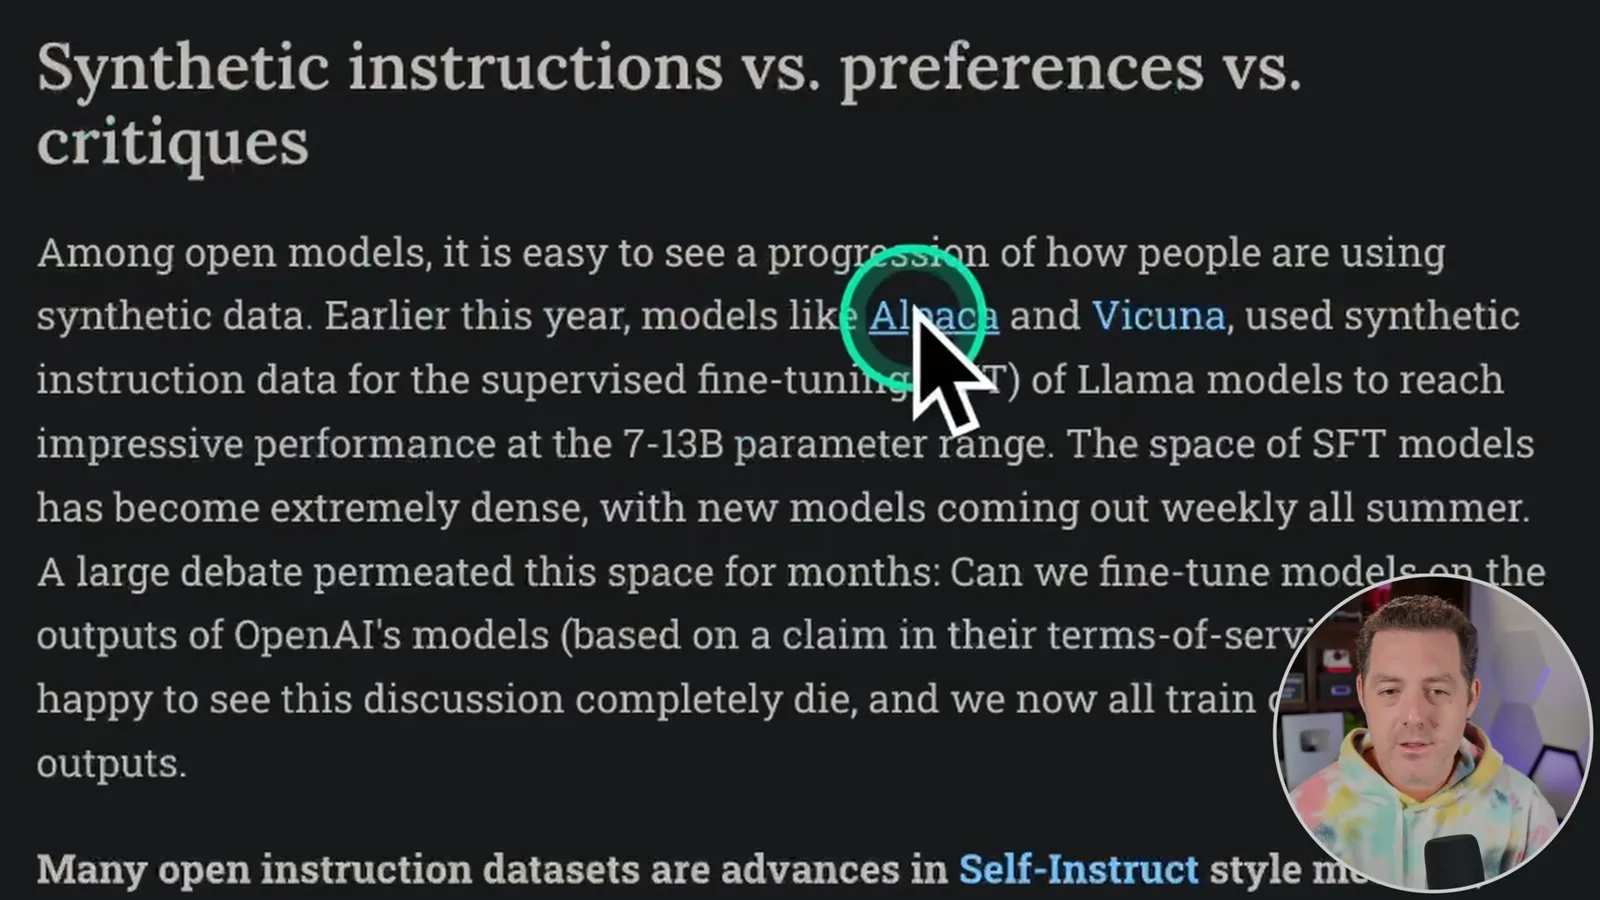
我重新谈到开放模型:没有专有数据来源或充足预算的团队,可能尤其看重生成数据。Lambert 提到 Alpaca 和 Vicuna 等例子,它们使用合成指令数据微调基于 Llama 的模型。这些例子展示了生成示例的一种用途,但不能证明只靠合成数据就能构建任何前沿模型。
我计划更深入地研究合成数据和基准污染。快速进步的可能性让我兴奋,也让我担心安全和监督问题。我对未来的乐观是一种观点,并非某项具体预测或传闻中的突破已经实现的证据。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。