30 秒看懂
2025 年 8 月,Matthew Berman 讨论了 AI 记忆与个性化、开放权重模型发布、Google Opal、编程智能体指令、一项数学证明的说法、Atlas 和 Figure 机器人演示,以及公司和芯片方面的报道。视频由 AWS 赞助。OpenAI 后来的一篇论文澄清,视频重点介绍的 GPT-5 优化结果改进了论文早期版本的界限,但没有超越后来已知的最优界限。
- 1记忆与个性化Berman 探讨模型记忆的用途及其可能带来的迎合和信息茧房风险;没有给出 GPT-6 的日期。
- 2开放权重模型他讨论 DeepSeek V3.1 和 Qwen-Image-Edit,并展示选定的图像编辑示例,未进行受控评估。
- 3智能体指令与 OpalAGENTS.md 为代码仓库提供指导,Google 的实验性工具 Opal 则用于创建可视化 AI 工作流。
- 4重新审视一项证明Bubeck 验证了一个改进早期界限的证明;后来的文献指出,原论文的后续版本已有更强的已知结果。
- 5机器人演示Atlas 展示操作任务,Figure 02 穿越崎岖地面;画面所能说明的范围限于展示的场景。
- 6公司与芯片报道Berman 回顾有关 OpenAI 基础设施、Meta 研究组织及 Nvidia 拟推出的中国市场芯片的报道。
要点建议
- Altman 讨论了对记忆和个性化的期望,并未宣布 GPT-6 的发布日期或确定的功能清单。
- DeepSeek V3.1 和 Qwen-Image-Edit 是 2025 年 8 月讨论的发布项目;模型可用性和硬件要求取决于具体配置。
- AGENTS.md 为项目指令提供共同约定,但支持情况和优先级因工具而异。
- 提到的 GPT-5 证明改进了早期界限,但原论文后来的版本已给出更强的最优结果。
- Atlas 和 Figure 的画面展示了选定的机器人演示,不能普遍证明机器人具有不受限制的自主能力或在所有环境下都能可靠运行。
- 关于 Meta 重组和拟议中的 Nvidia B30A 的内容是当时的报道;细节和未来供货并无保证。
按章节阅读整理后的全文
记忆、DeepSeek 与 Qwen
Berman 讨论 Altman 关于个性化的言论和 DeepSeek V3.1 的发布,并回顾 Qwen 图像编辑示例。
2025 年 8 月,有关 Sam Altman 与记者交流的报道引发了人们对 GPT-5 之后会出现什么的疑问。Altman 讨论了对记忆和个性化的需求,但没有给出 GPT-6 发布日期。我认为未来模型可能拥有更深入记忆的看法是推测,而非已确认的产品规格。
我认为记住偏好、减少重复提示可以让助手更实用。但个性化也有取舍:如果模型一味反映用户的每一项偏好,就可能强化信息茧房或变得过度迎合。如何平衡定制、独立判断与用户控制,仍是一个棘手的产品问题。
DeepSeek 发布了开放权重模型 V3.1;我指出,在本地运行大型模型可能需要大量 GPU 显存或量化。我还提到一则关于 R2 因中国芯片问题推迟的说法,但这是一则未经证实的报道,不能视为发布决定的确定原因。DeepSeek 的[发布说明](https://api-docs.deepseek.com/news/news250821/)称 V3.1 支持思考和非思考模式。
Qwen-Image-Edit 是另一个开放权重产品。其团队演示了双语文字编辑、语义修改和视觉外观变化。我查看了吉祥物、人物及汽车从不同角度呈现的例子;当输入没有展示脸部或表面时,模型必须推断或创造隐藏的细节,而非还原经过验证的真实情况。
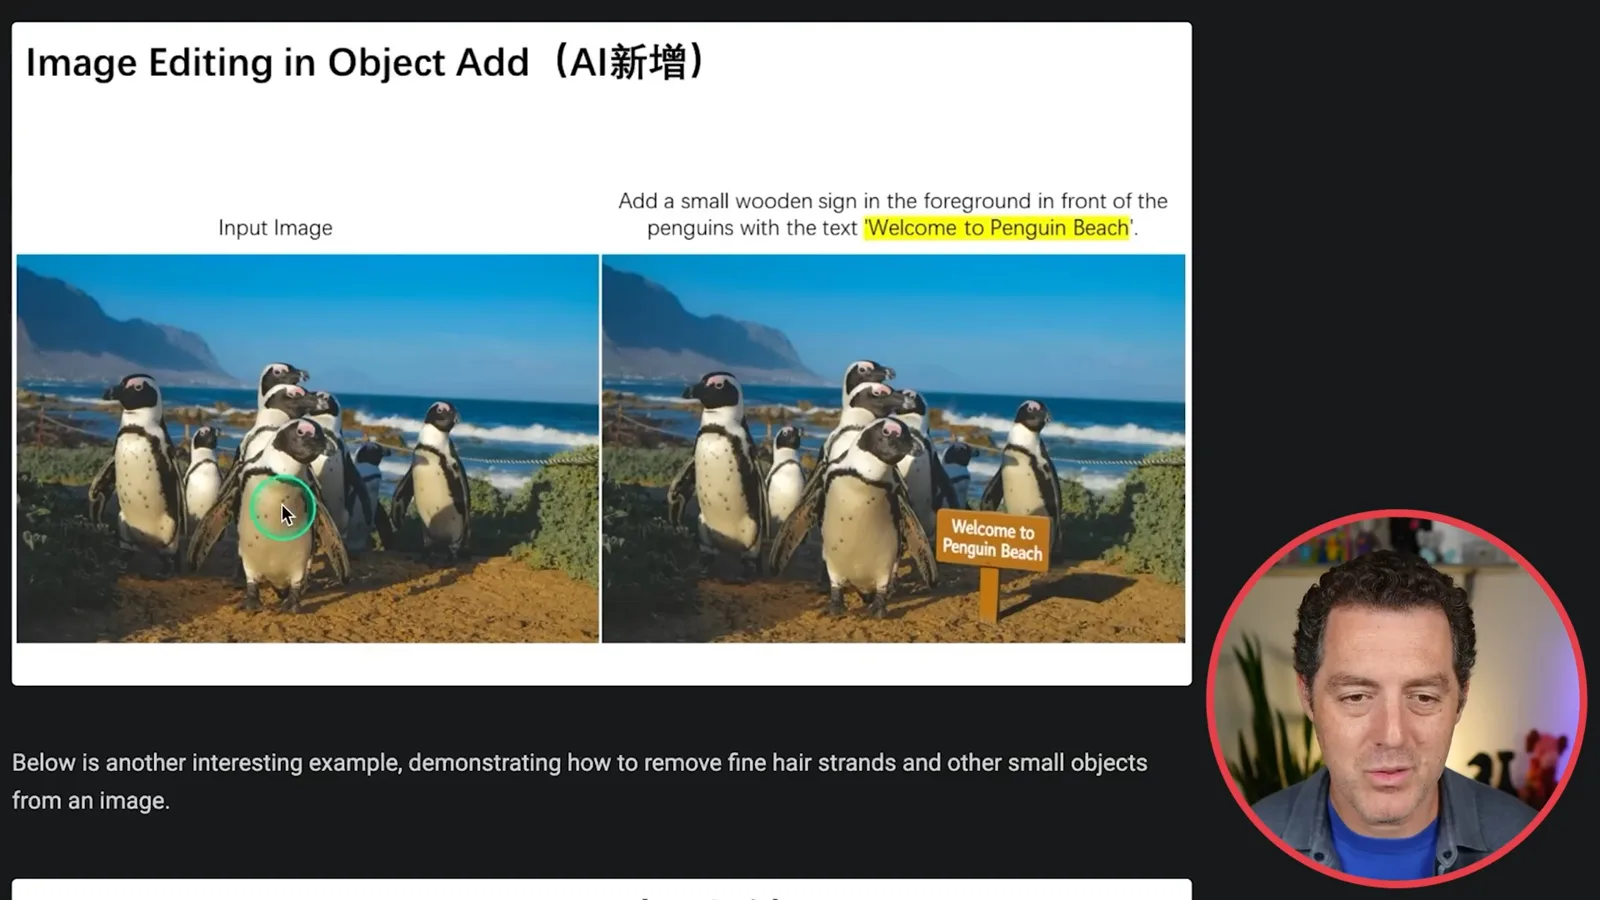
其他选定示例包括改变服装和艺术风格、在企鹅场景中添加标牌、移除菜单上的一根头发,以及给单个字母重新着色。未修改区域和文字似乎得到了保留,这让我印象深刻,背景替换和虚拟试穿也是如此。这些是提供的演示,并非检验模型能否可靠完成这些编辑的受控测试。
AWS、AGENTS.md 与 Opal
AWS 赞助环节介绍 Bedrock 的功能。随后 Berman 讨论代码仓库指令及 Google 的可视化小应用工具。
AWS 赞助了本视频。我介绍了 Amazon Bedrock 的功能,包括提示词管理与优化、模型间路由、提示词缓存和模型蒸馏。具体能力、支持的模型、价格及可用性取决于服务配置;这一环节是赞助商介绍,而非独立基准测试。
多个编程智能体工具采用了 AGENTS.md,用它集中放置项目专属指令,例如编程规范和工作流程。我欢迎这一做法,因为不同工具原本可能各自需要单独的指令文件。这是一种约定,并不保证所有工具都以相同方式解释指令或处理优先级([AGENTS.md](https://agents.md/))。
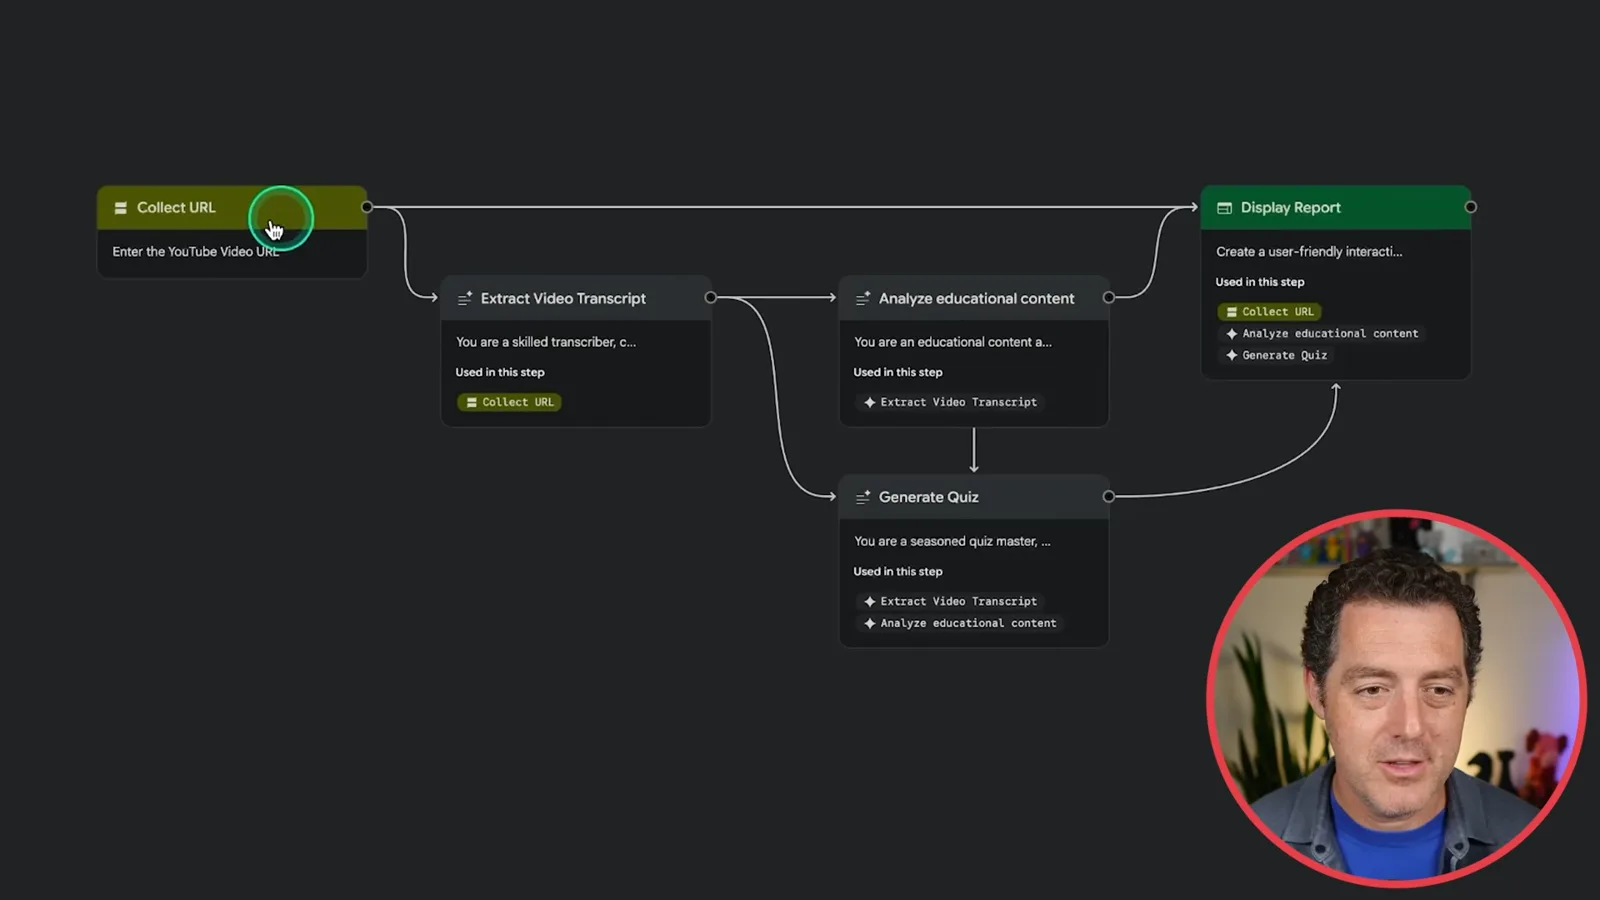
Google 的 Opal 允许用户描述一个小应用,再查看或编辑基于节点的工作流。我体验了一个模板:输入 YouTube URL,提取信息,分析教育内容,生成测验并显示结果;界面支持分享、改编和手动编辑。Google 于 2025 年 7 月在美国推出 Opal 公开测试,早于本视频,因此称测试直到视频发布时才开始是不准确的([Google](https://developers.googleblog.com/en/introducing-opal/))。
家庭助手、记忆与数学
Google 和 Perplexity 宣布或讨论 AI 产品,Bubeck 展示一个 GPT-5 证明示例。理解这一例子需要考虑后来的数学背景。
Google 在 Made by Google 活动上推出 Gemini for Home,作为新的语音助手体验。我对能力更强的助手感兴趣,并将这项发布与自己使用 Pixel 手机的体验进行比较。这是一项产品发布,并不意味着每台家庭设备当时都已获得新助手。
Perplexity 首席执行官 Aravind Srinivas 介绍了正在测试的“超级记忆”功能,并分享一个例子:一句问候引出了一段反映用户先前上下文的回复。我认为记忆可能成为应用层很有价值的一部分。他声称该功能优于其他产品,这是公司高管的评价,并非经过独立验证的比较。
OpenAI 研究员 Sébastien Bubeck 表示,GPT-5 Pro 改进了一篇凸优化论文中的步长界限,且他检查了证明。我觉得这个例子令人兴奋,但也承认数学内容超出我的专业范围。他在 2025 年的说法本身不能独立证明该问题是新近解决的。
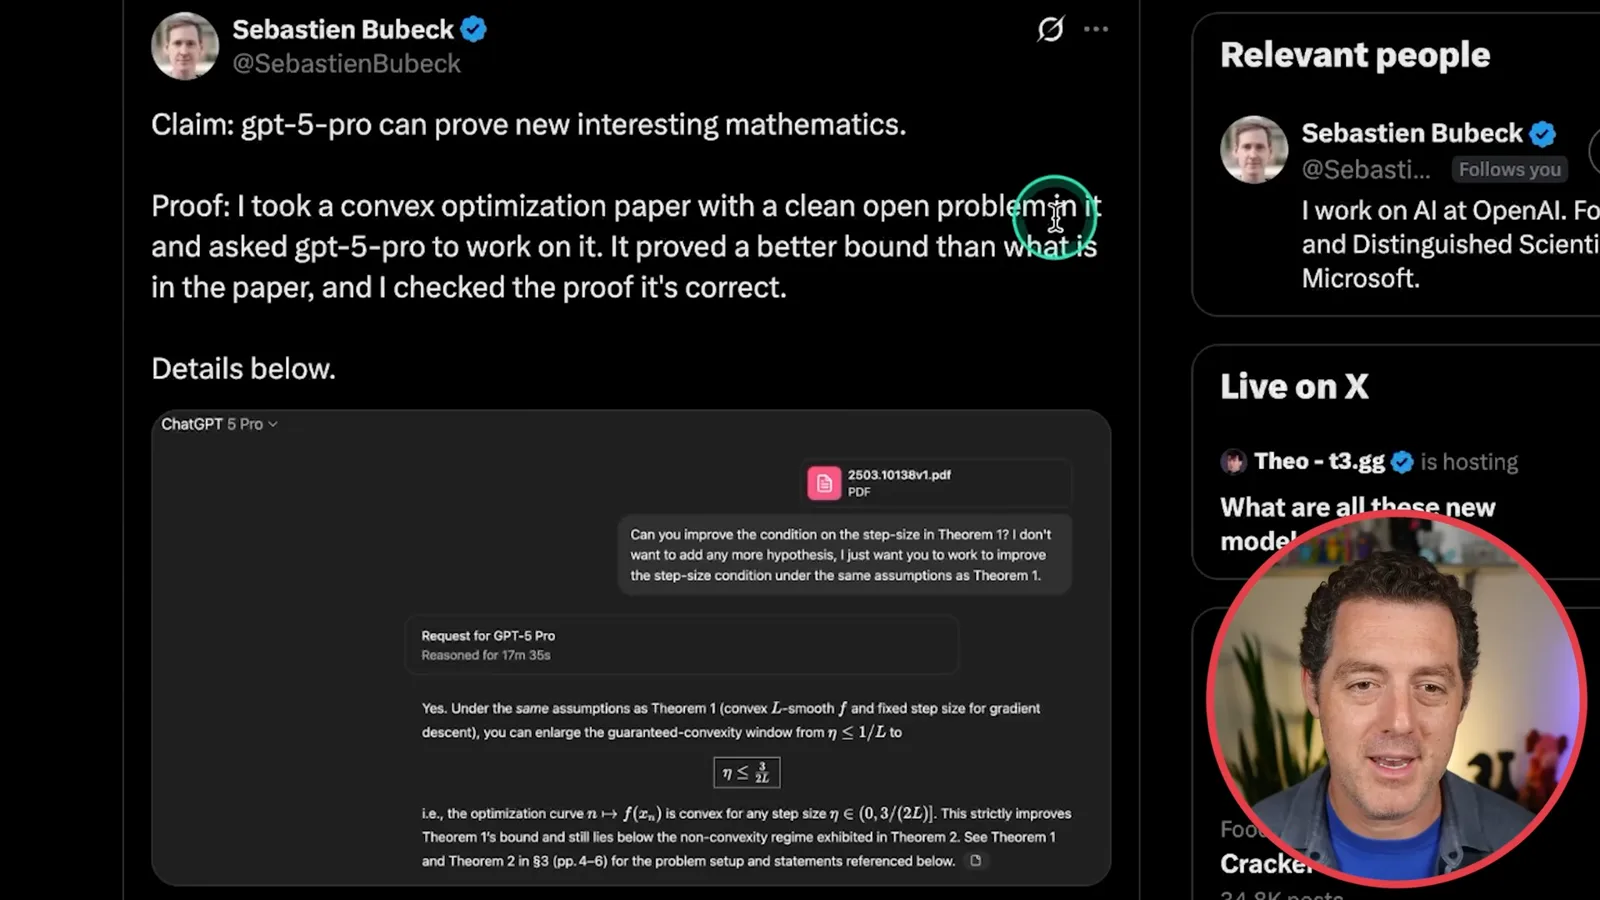
OpenAI 后来的一篇[研究论文](https://cdn.openai.com/pdf/4a25f921-e4e0-479a-9b38-5367b47e8fd0/early-science-acceleration-experiments-with-gpt-5.pdf)将这一具体例子归为独立重发现:给定第一版论文,GPT-5 将界限从 1/L 改进到 1.5/L,而第二版早已确立了最优的 1.75/L 界限。Bubeck 表示自己验证了这个中间结果的证明。这说明研究过程中的一次有用互动,但并非该问题新的最佳已知结果。
我认为包括记忆和工具在内的应用支撑结构,能让现有模型的智能用于更多工作流程。这是我的判断;完整系统的价值与可靠性仍取决于具体实现、评估和任务。
Atlas 和 Figure 机器人
Berman 回顾机器人操作和行走画面。演示展示的是特定条件下的特定任务。
Boston Dynamics 展示了 Atlas 打开箱子、移动物体,以及在有人扰乱环境时作出调整。视频将该片段标为自主、实时进行;我对其操作能力和展示的可视化效果印象深刻。这段选定演示支持对该特定场景的判断,并不能保证机器人在任意环境下都能无需干预地工作。
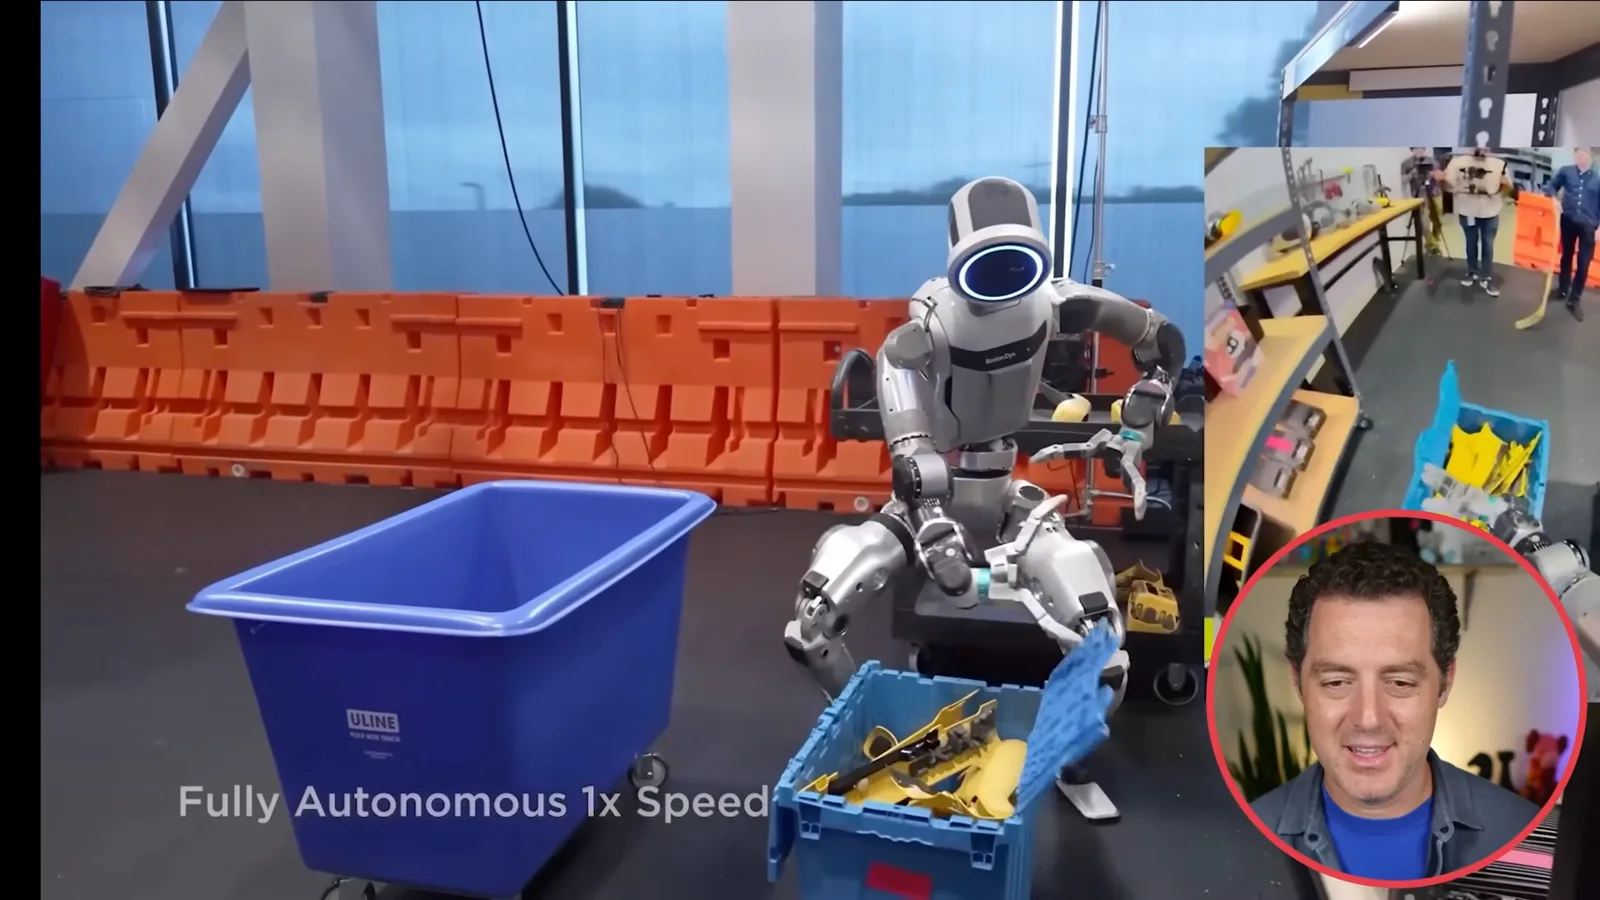
我讨论了报道中使用语言条件化的全身控制,以及包含远程操控示范、数据整理、模型训练和评估的训练流程。公司在其 [Atlas 文章](https://bostondynamics.com/blog/large-behavior-models-atlas-find-new-footing/)中介绍了这些研究方向。仅凭画面无法确定每个展示动作具体使用了哪些组件。
一段 Figure 02 视频显示机器人穿越户外植被和障碍,包括在脚被卡住后调整姿态。动作看起来不够平稳,但我认为它的恢复能力令人印象深刻。我提到强化学习和神经网络控制是一些趋势;这段片段本身不能独立确定具体控制器,也不能证明它在所有地形上的普遍可靠性。
编程、基础设施与重组
视频最后讨论 Cursor 的模型、有关 OpenAI 基础设施和 Meta 团队的报道,以及路透社有关 Nvidia 面向中国芯片的报道。
Cursor 提供一款名为 Sonic 的模型,我提到了它可能与即将推出的 Grok 编程模型有关的猜测。我不知道其身份,因此这种联系仍是传闻。另据 Bloomberg 报道,OpenAI 未来可能出售基础设施容量;我将其视为未来可能的方向,而非立即推出的已宣布服务。
Business Insider 报道,Alexandr Wang 领导下的 Meta AI 再次重组。报道称,备忘录描述了 FAIR 的角色、由 Shengjia Zhao 负责研究领导、前 GitHub 首席执行官 Nat Friedman 负责产品、Aparna Ramani 负责基础设施,以及 AGI Foundations 团队的变化。这些反映的是报道中 2025 年 8 月的组织情况,不一定代表后续结构。
路透社还援引知情人士称,Nvidia 正在开发一款暂称 B30A 的面向中国市场芯片。消息人士描述了单芯片设计,以及相对于 H20 和 B300 的预期性能。这些是报道中的计划,受出口管制约束且可能改变,并非已确认的出货或独立测量的产品规格([路透社](https://www.investing.com/news/stock-market-news/exclusivenvidia-working-on-new-ai-chip-for-china-that-outperforms-the-h20-sources-say-4199124))。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 21:11EN → 简体中文Matthew Berman· 2026年10月28日Matthew Berman 实测 DeepSeek V4.1 Flash:编程、视觉与本地应用Matthew Berman · Forward Future从视觉编程、图像推理到本地应用和服务商价格,实测既展示了模型的能力,也暴露出明显缺陷。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。