30 秒看懂
在这期 2023 年 8 月 18 日的新闻综述中,Matthew Berman 讨论验证码研究、LK-99 室温超导主张未获证实、机器人、OpenAI、医疗和编程模型、AI 视频与音乐、模拟智能体、Google 产品及安全问题。他的预测和当时的产品说法反映的是那个时点的观点,而非对后续结果的保证。 医疗例子涉及研究和开发者主张,不能证明已具备临床应用条件。视频中没有识别出赞助片段。
- 1验证码面临挑战Berman 介绍一项针对特定挑战比较人类与自动求解程序的研究,并认为垃圾信息的经济成本很重要。
- 2LK-99 的争议主张他回顾相关报道,指出样品行为及电阻率转变可以不借助室温超导来解释。
- 3医疗 AI 的希望与局限Berman 讨论 GPT-4 研究和 DoctorGPT 开发者的主张。考试式结果或模型发布都不能证明临床安全性或有效性。
- 4迭代式内容审核政策专家创建带标签的示例,与 GPT-4 的标签比较,再修订含糊的规则。人类审核仍然重要。
- 5生成式智能体模拟Stanford 与 Google 的研究项目模拟了具有日常活动及互动的角色;Berman 设想了未来游戏中的可能用途。
- 6安全与红队测试Berman 回顾有关快速发展模型测试的担忧,认为应认真对待信息安全和安全风险。
要点建议
- 2023 年一项研究发现,自动求解程序在某些受测验证码类型上表现优于人类;这不能证明所有验证码都无效。
- 独立研究为 LK-99 所谓的超导迹象找到了有力的其他解释。
- 医疗问答和考试表现不等于安全且经过验证的医疗实践。
- OpenAI 描述了一种迭代式审核流程,将模型标签与人类政策专家的标签比较,再完善政策。
- 生成式智能体在研究环境中产生了模拟社会行为,不能证明智能体实际拥有与人类一样的生活。
- Berman 看好 AI 工具的收益,同时提醒应关注安全测试、信息安全及对出版者的影响。
按章节阅读整理后的全文
验证码、LK-99 与机器人
Berman 讨论自动验证码测试和反驳 LK-99 超导主张的证据,随后比较 Unitree 与 Boston Dynamics 机器人报价。
在这期 2023 年 8 月的综述中,我先介绍一项验证码研究。验证码包括选图、谜题等测试,旨在区分人类与自动流量。研究人员比较了几类挑战中人类和自动程序的表现,发现机器人在部分受测任务上更快、更准确。这一结果仅涉及受评估的系统和挑战,并不代表所有验证码或反滥用防线。
马斯克认为,订阅付费可以提高在 X 上大规模使用机器人的成本。根据我经营公司的经验,提高垃圾信息成本有助于抑制这类行为。这是经济层面的论点,并不能证明信用卡或订阅本身可以消除自动化滥用。
韩国一个团队声称 LK-99 材料能够在室温下超导,引起了广泛关注。截至视频发布时,Nature 讨论的独立研究已找到充分理由怀疑这一解释。原始演示中的部分悬浮现象本身不足以证明超导。
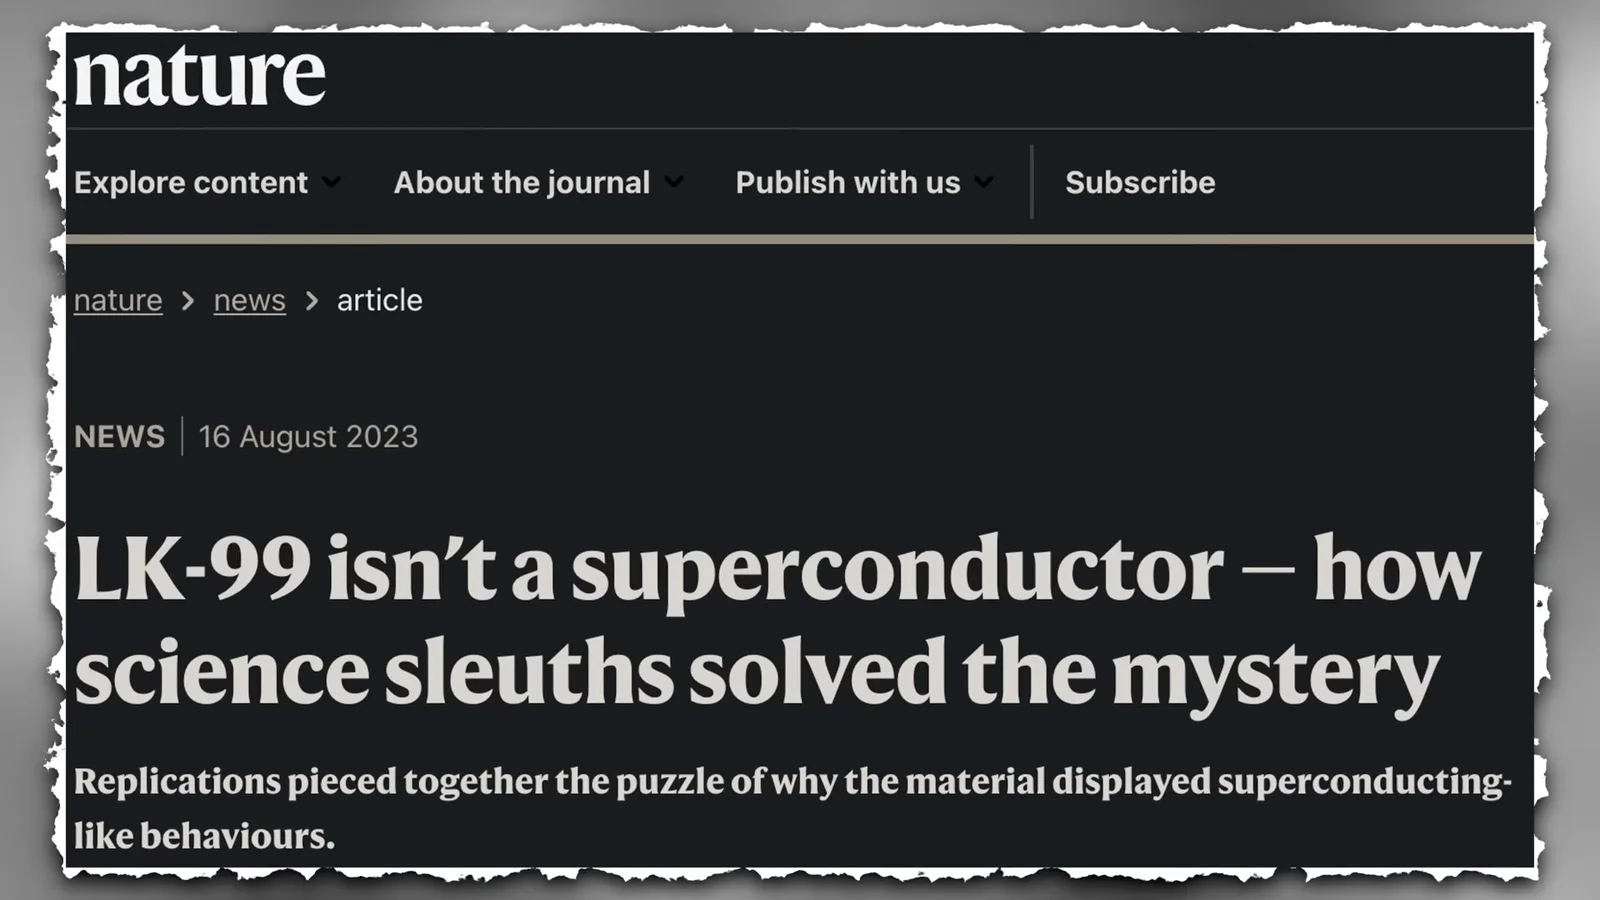
研究人员还检查了报告中的电阻率下降。杂质硫化亚铜会在相近温度发生转变,可以在不需要超导体的情况下解释这一现象。尽管最初的主张令人失望,我还是很高兴看到这么多人对材料科学和检验非凡结果的过程产生兴趣。
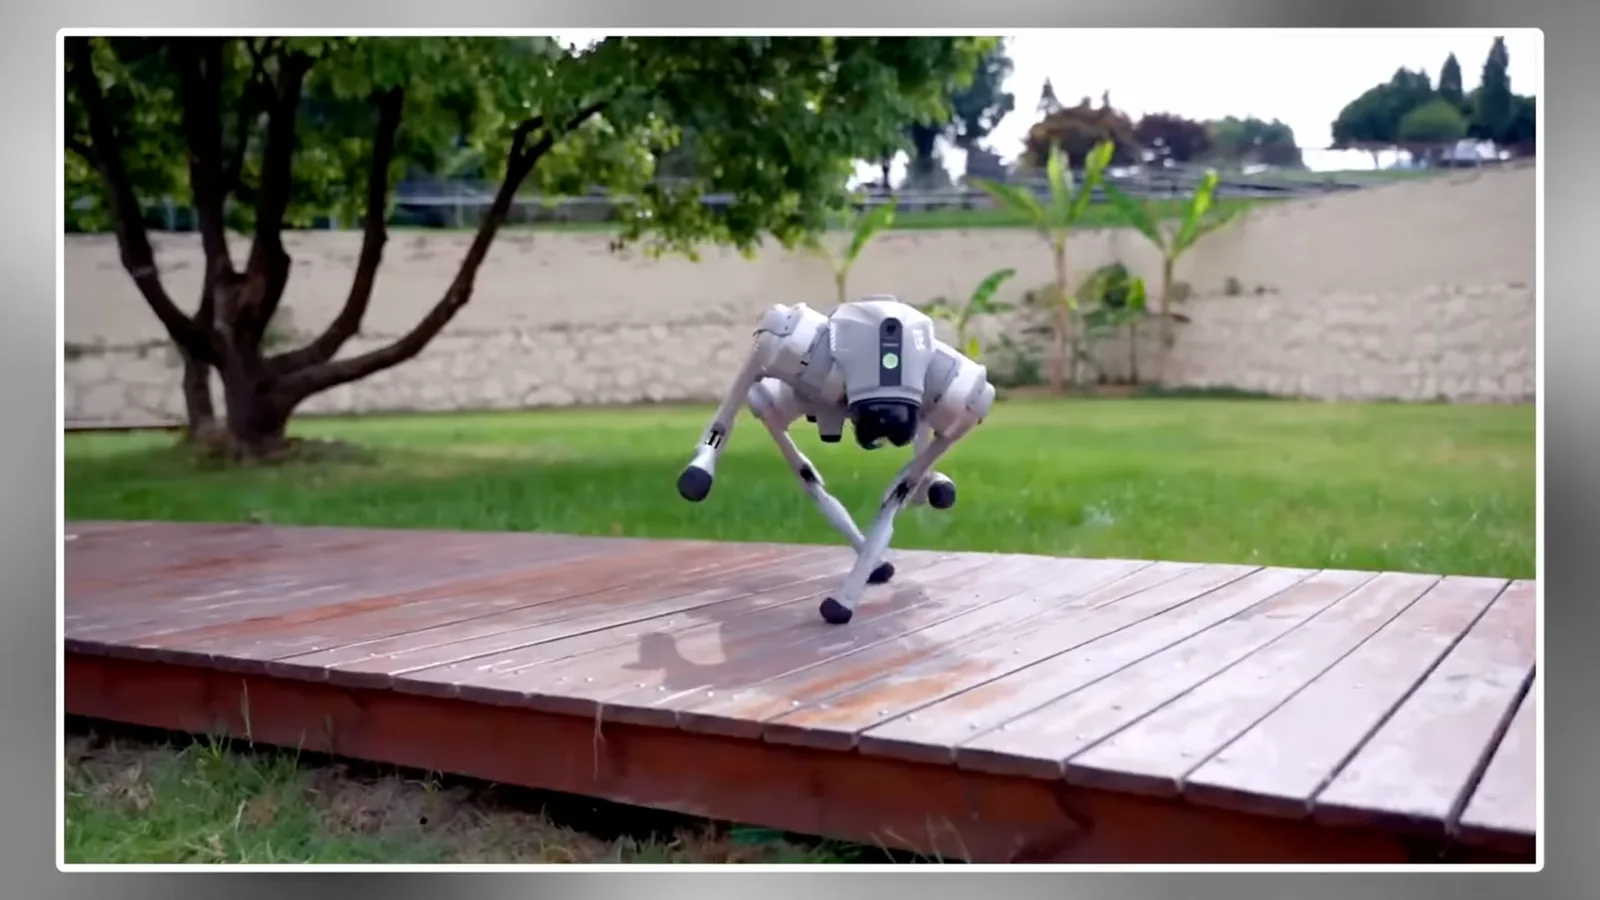
Unitree 推出了一款报价约 9 万美元的人形机器人;我将报价 7.5 万美元的 Boston Dynamics Spot 与起价约 1,600 美元的 Unitree 四足机器人作比较。这些是 2023 年不同产品和配置的价格,并非同等性能的直接比较。Unitree 将部分成本下降归因于自家激光雷达;我不确定这一个因素能解释多少差价。
OpenAI、医疗和编程模型
他谈及 OpenAI 的收购和当时对其财务状况的猜测,再从医疗研究主张和 Stability AI 的编程模型出发讨论潜在生产力收益与局限。
OpenAI 收购了 Global Illumination,这个团队曾开发一款类似 Minecraft 的开源游戏项目。OpenAI 表示团队将参与包括 ChatGPT 在内的核心产品工作。我猜测这次收购主要是为了吸纳人才,或许其游戏开发经验还有更广泛的用途;这是我的推测,并非公司宣布的理由。
当时有报道称运营 ChatGPT 每天需要 70 万美元,并猜测 OpenAI 的财务状况。这一数字是外部估计,本文没有独立证实,也不能证明破产迫在眉睫。鉴于 ChatGPT 的受欢迎程度、OpenAI 的支持者和公司的持续投资,我对破产预测持怀疑态度;这是我的判断,不是可依赖的财务预测。
转向健康领域,我讨论 Microsoft 关于 GPT-4 整理临床试验标准及回答医学问题能力的研究。这类任务未来可能帮助研究人员处理复杂研究或招募工作。在数据集或狭窄研究任务上的表现,并不能证明模型可以安全诊断、治疗患者或取代临床医生。
我还提到基于 Llama 2 7B 的 DoctorGPT 项目,其创建者声称模型能通过美国医学执照考试并在本地运行。这一说法需要独立评估,包括具体使用了哪些题目以及测试条件;它不意味着模型是持照医生。我乐观地认为 AI 可能改善医疗可及性和成本,但这些结果需要真实的临床验证。
Stability AI 推出面向编程的 StableCode 模型,约有 30 亿参数,其中一个版本支持 16,000 token 的上下文。它计划集成到 Visual Studio Code 等开发工具中。我看好提高开发者生产力的可能性,不过生成的代码仍需要检查和测试。
内容审核、国防和企业 AI
Berman 描述 GPT-4 的迭代式审核流程和五角大楼的生成式 AI 工作组,还讨论基于 Azure 的企业部署与隐私问题。
OpenAI 介绍了使用 GPT-4 协助制定和应用内容政策的方法。政策专家先给一个小型参考集打标签,GPT-4 阅读政策后独立标注同一批示例。专家检查分歧,询问模型的推理,澄清含糊规则,再重复这一过程。
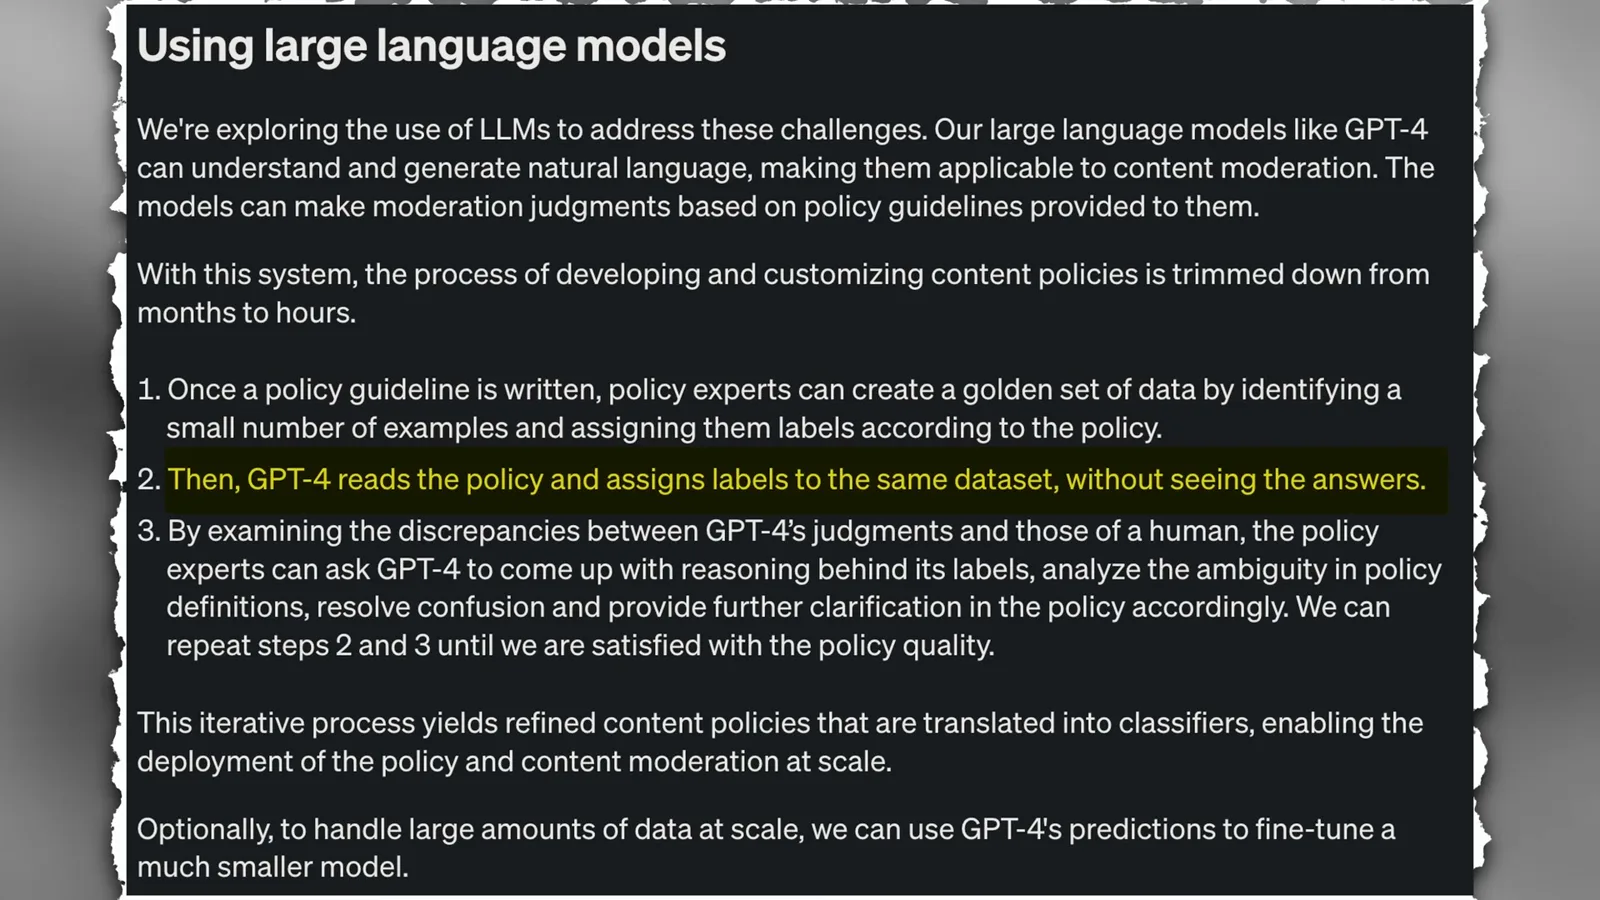
我认为这一方法可能帮助审核团队,但这个例子不能证明它在所有情况下都是最好的工具。OpenAI 自己也指出偏差以及监控、验证和人类参与的必要性;在其报告的比较中,经验丰富的审核员表现优于 GPT-4。这个流程有助于完善政策,并不保证审核结果正确。
美国国防部宣布成立生成式 AI 工作组,评估并支持该部门负责任地使用这项技术。我指出军事应用可能包括防御和进攻用途,但公告本身并不能证明这一个工作组控制所有此类应用。
我讨论 Microsoft Azure ChatGPT,将其作为一种面向企业的部署方式,适用于担心向公共聊天机器人发送私密信息的组织。Azure 托管方案可以配置企业级控制,但它仍属于云部署:隐私和安全取决于架构、访问控制与服务条款,不会仅因产品名称而自动得到保障。
视频、音乐与模拟智能体
Runway 的视频延长功能和 AI 视频示例之后,他介绍有关授权音乐声音的谈判报道,再看两个受生成式智能体启发的项目。
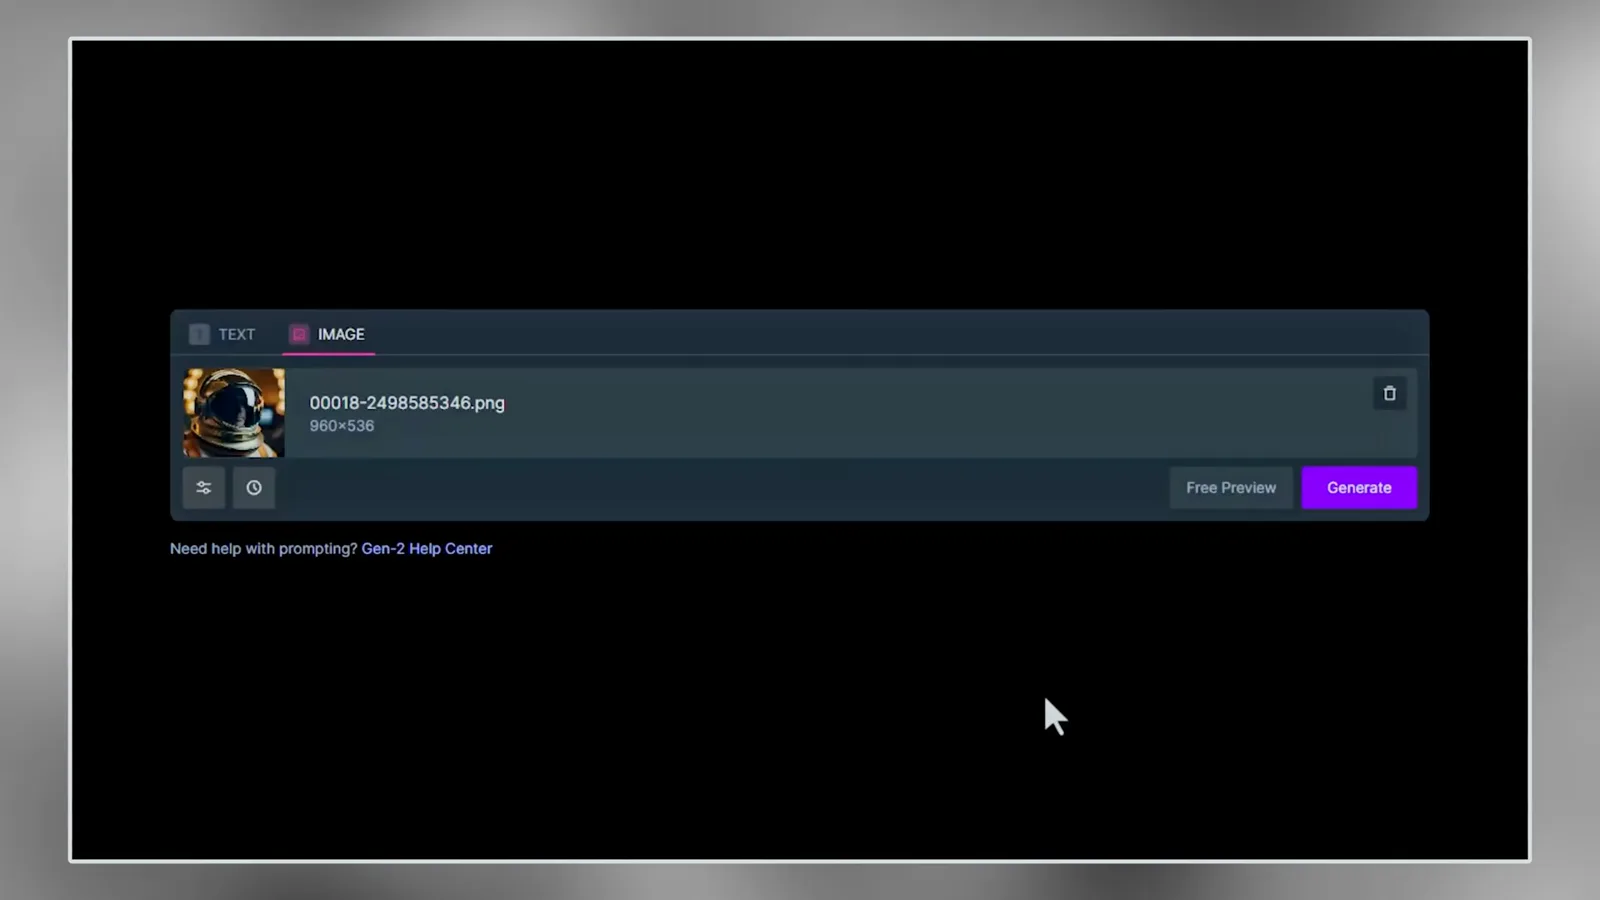
Runway 为 Gen-2 更新了生成视频的延长功能。演示从文字提示、图像或两者开始,每次增加 4 秒。旁白称最长为 18 秒,而嵌入教程说三次延长得到 16 秒;原始内容中的数字并不一致,这些也都是历史产品细节。
本周的 AI 视频由 gingerbot 5000 推荐、fugitive 发布。我认为它可能使用 WarpFusion 制作,但这只是我的推断,并非确认过的制作信息。这个例子展示了当时视频工具开始让更多人接触到的创意效果。
一篇报道称,Google 与 Universal Music 正在就授权艺术家的声音用于 AI 生成歌曲进行早期讨论,可能让粉丝在参与艺术家许可下创作音乐。这只是谈判,并非已经敲定的普遍授权方案。我将其与一首使用 AI 生成的 Drake 和 The Weeknd 人声的热门歌曲遭下架作对比,并希望艺术家能够选择是否参与。
我预计 AI 生成音乐将让更多人能够创作,即使产生的大量作品质量不高。只要其中有少数杰出作品,就可能让这项技术值得使用。这是对新兴创作领域的预测,并非对未来结果的测量。
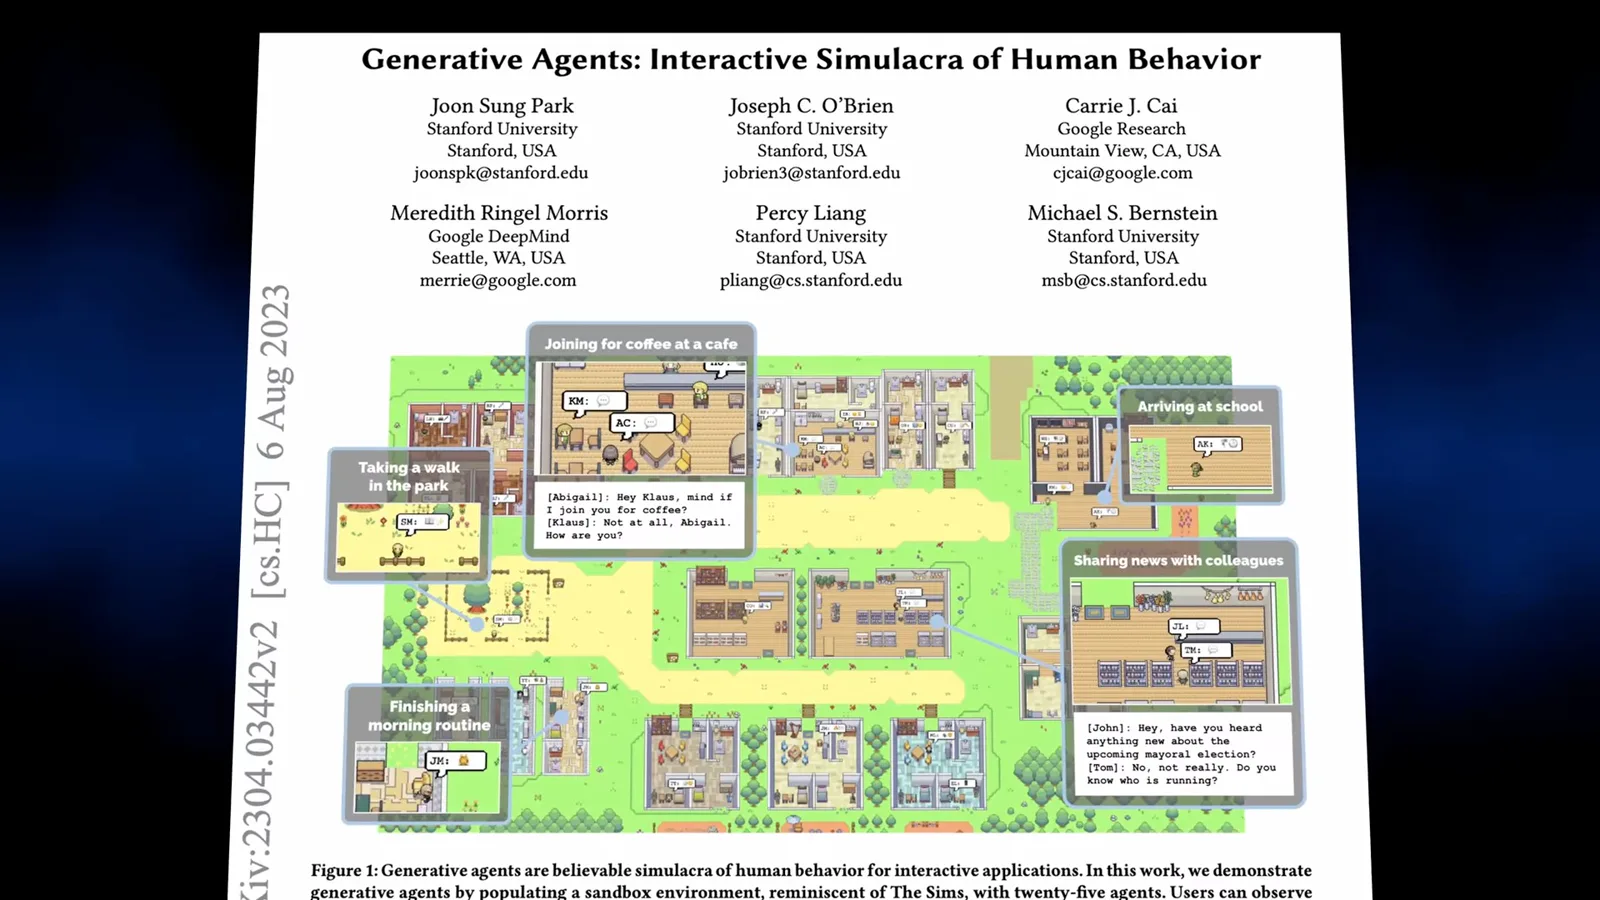
Stanford 和 Google 的 Generative Agents 研究项目在小型虚拟环境中模拟了规划日常活动、互动并形成表面社会关系的角色。作者发布了代码,a16z 也发布了受其启发的相关模拟。这些是经过设计的行为模拟,并不能证明智能体像人一样体验关系。
我可以想象这类模拟让游戏角色更加动态:在 Skyrim 或 Grand Theft Auto 一类游戏中,非玩家角色可能在玩家视野之外继续活动。这是可能的设计方向,而非这些研究演示已经确立的功能。
搜索、ChromeOS 与 AI 安全
他思考 Google 的生成式搜索功能、有关 ChromeOS 写作工具的报道以及对出版者的影响。综述最后讨论红队测试和安全顾虑。
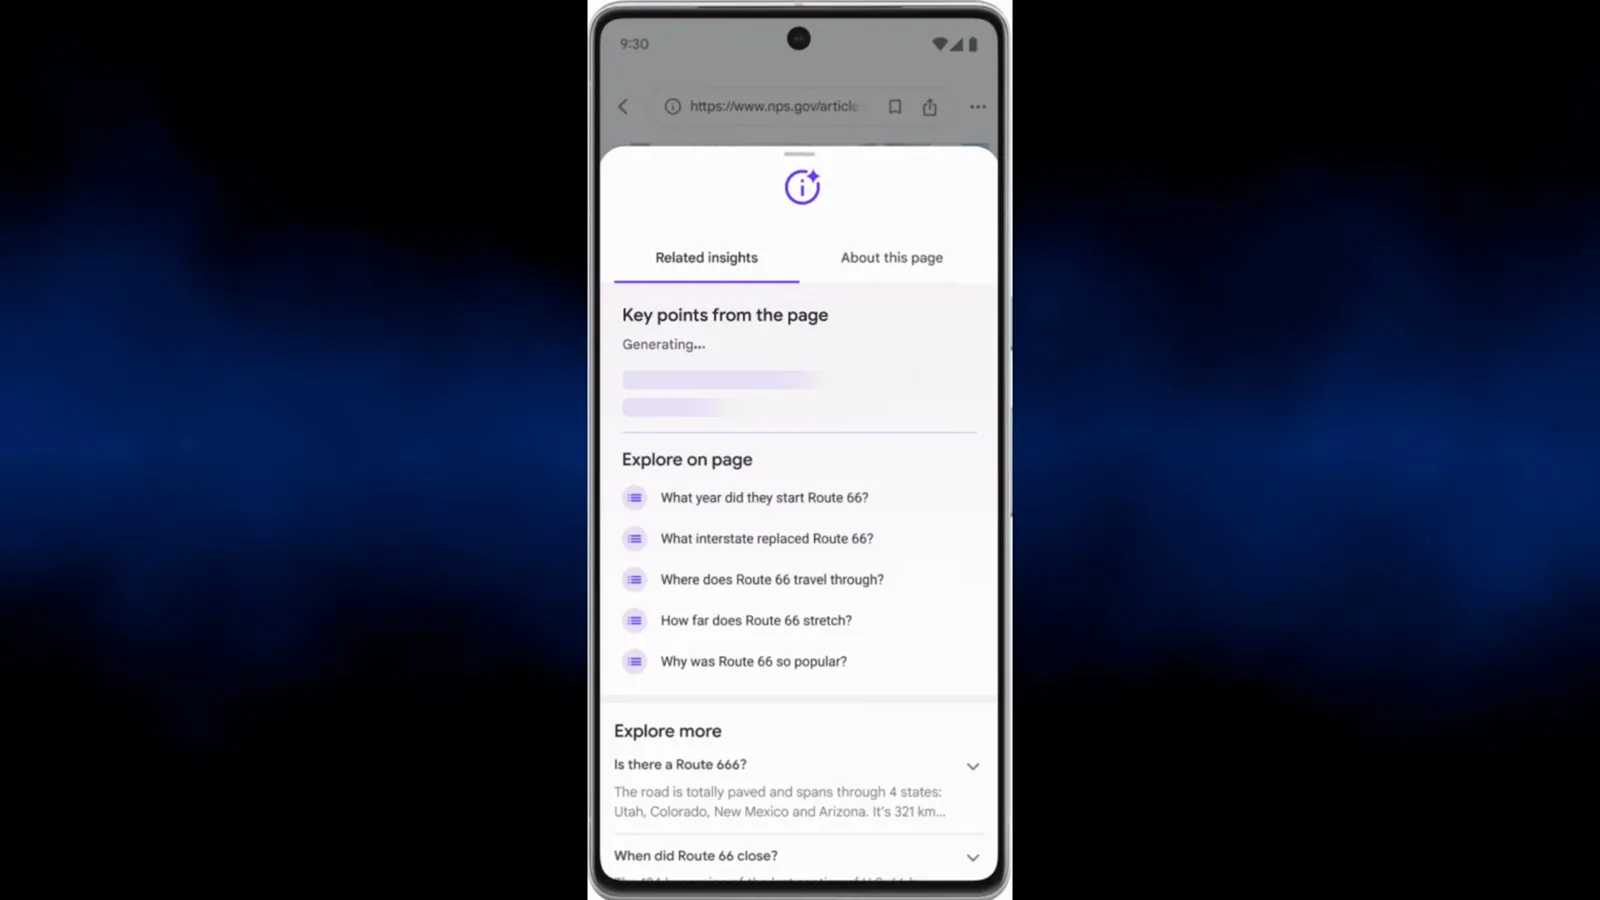
Google 当时正在增加生成式搜索功能,例如解释和总结网页。我能看到它对用户的便利,但担心搜索结果直接呈现答案可能减少出版者的访问量和收入。AI 对 YouTube 视频的摘要也可能带来类似顾虑;实际影响规模需要测量。
另一篇报道讨论了 ChromeOS 可能推出的 AI 写作功能,包括改写选中文本、预设提示和续写用户内容。当时这被报道为尚未公布的产品,因此应视为提议,而非已确认发布或对当前可用性的承诺。
最后,Associated Press 一篇关于红队测试的报道强调了一种担忧:竞争可能迫使 AI 系统在风险得到充分测试前进入市场。语言模型从大型数据集中学习模式,而不是只遵循人工编写的规则,因此难以穷尽地预测其行为。我认为,即使公司正在投资安全防护,信息安全、训练数据操纵及其他安全问题仍值得认真关注。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。