30 秒看懂
2023 年 5 月,Matthew Berman 演示如何使用社区模板部署 Runpod GPU,并通过 Text Generation Web UI 下载和运行 GPTQ 量化的 Guanaco 65B 模型。他介绍了模型设置、生成控制和终止 pod 的操作。视频简介将 Runpod 链接标注为联盟推广链接;价格和界面细节均为历史信息。
- 1租用 GPUBerman 解释按小时租用 GPU 并选择 RTX 6000 Ada 实例。他展示的 2023 年价格是示例,并非当前报价。
- 2社区模板默认模板出现问题后,他选择了 TheBloke 预配置的 Text Generation Web UI 模板。
- 3下载 Guanaco 65B界面下载经过 GPTQ 量化的 Hugging Face 模型;所展示的步骤取决于具体版本和加载器。
- 4调整加载器他依照当时的模型说明选择 4 位权重、无分组大小和 LLaMA 模型类型。
- 5停止计费并保存数据Berman 终止了没有配置卷的 pod。持久存储及其费用需要另行考虑。
要点建议
- 云 GPU 可以在不购买本地加速卡的情况下提供临时算力,但成本和可用性会随实例及时间变化。
- 演示中的 Guanaco 65B GPTQ 使用特定量化格式,需要足够的 GPU 显存;该流程不能保证所有模型都适合所有 GPU。
- 2023 年的示例为所展示的模型版本设置了 4 位权重、无分组大小和 LLaMA 模型类型。
- Guanaco 基于 LLaMA,受许可限制;使用前应检查模型卡及底层条款。
- 没有持久卷的 pod 在终止时可能丢失数据,而独立存储可能继续产生费用。
- 应将 2023 年的模板和界面视为历史教程,并保护任何可远程访问的界面。
按章节阅读整理后的全文
租用云 GPU
Berman 解释租用 GPU 时间的原因、充值并选择硬件。他为网页界面选择了一个社区模板。
我想展示如何使用 Runpod 和 Text Generation Web UI,在租用的云 GPU 上运行大型语言模型。示例使用 GPTQ 量化格式的 Guanaco 65B。本教程录制于 2023 年 5 月:模板、模型加载器和服务商价格可能已经变化,而且单块 GPU 不一定能运行所有模型。
云 GPU 让我可以按小时租用算力,而无需购买昂贵的加速卡。我创建 Runpod 账户、充值并比较可用 GPU。视频显示的价格约为每小时 0.69 至 2.30 美元,初始充值为 25 美元;这些是录制时的示例,并非当前价格或特定成本的承诺。
我选择 RTX 6000 Ada 和一个模板。容量规划取决于模型架构、量化方式、运行开销和可用 GPU 显存;24 GB 显卡并不自动意味着能装下 650 亿参数模型。默认模板遇到问题后,我改用 TheBloke 为 Text Generation Web UI 提供的社区模板。
TheBloke 发布了量化模型文件和预配置模板。我选中它,接受未配置卷的提示,然后部署。没有持久存储时,终止 pod 可能导致其中的文件丢失;在依赖数据能够保留之前,应遵循服务商当前的存储说明([Runpod 存储文档](https://docs.runpod.io/pods/storage/types))。
连接并下载模型
他检查 pod、打开网页界面并下载 GPTQ 版本的 Guanaco 65B。该示例中的 pod 没有持久卷。
pod 控制台提供日志、配置、环境变量和网页终端。随后我通过 7860 端口的 HTTP 连接打开应用。远程可访问的界面需要适当的访问控制,凭据也不应出现在截图、提示或日志中。
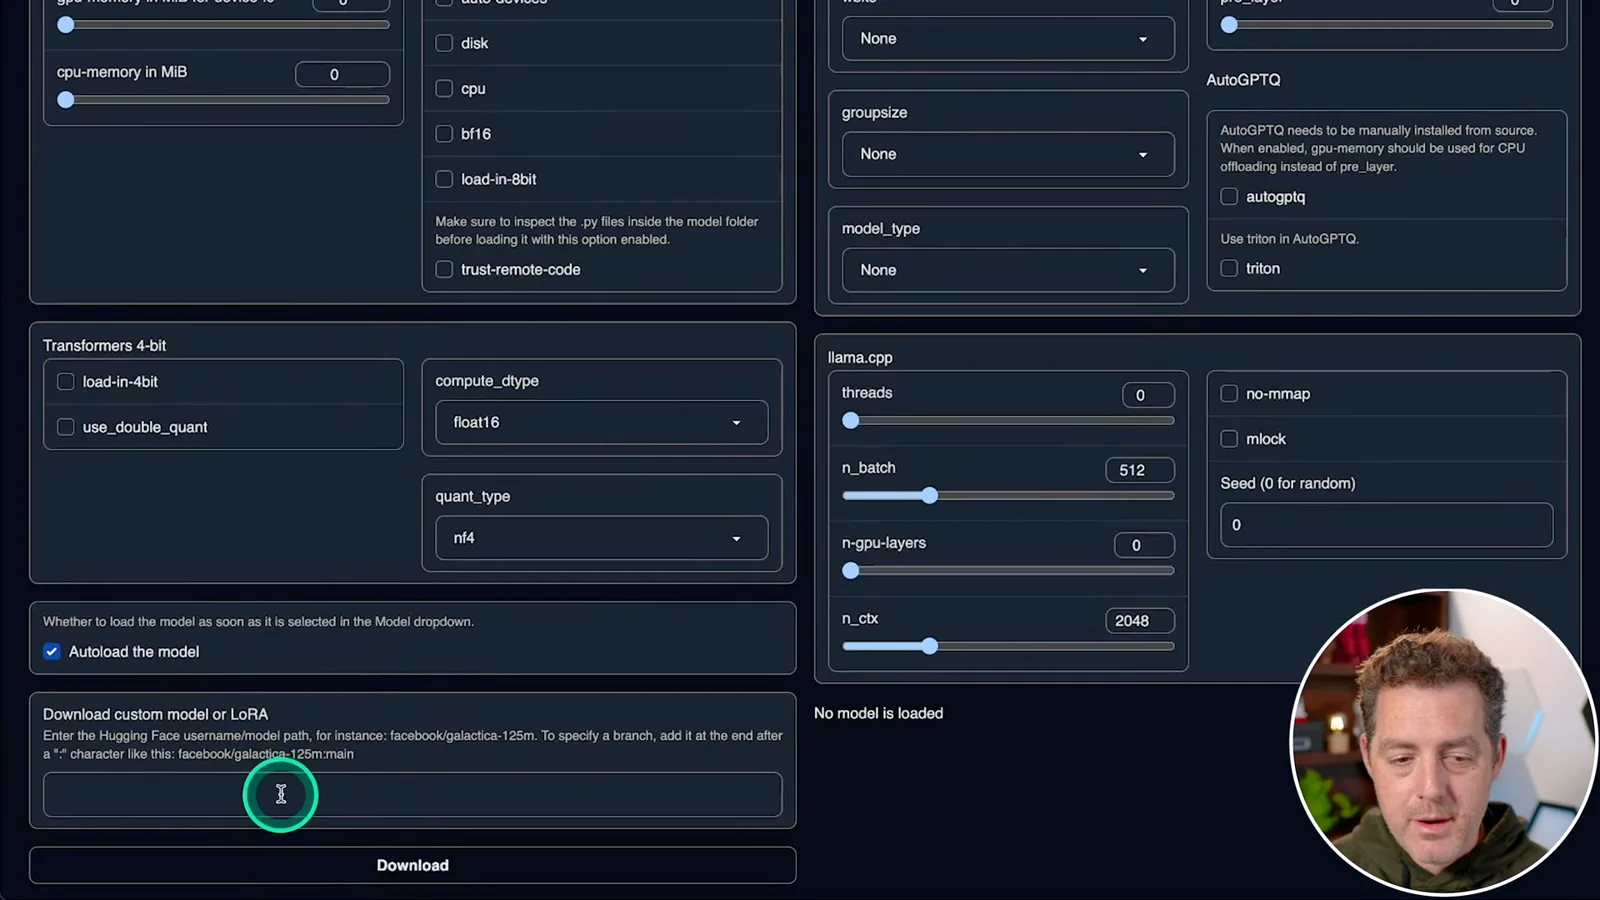
在 Model 选项卡中,我将 Hugging Face 标识符 TheBloke/guanaco-65B-GPTQ 粘贴到自定义模型下载字段并开始下载。模型很大,下载需要一些时间;完成后我刷新列表并选中它。[模型卡](https://huggingface.co/TheBloke/guanaco-65B-GPTQ) 提供可用文件和兼容性详情,可能与 2023 年展示的版本不同。
配置与生成
Berman 应用演示中的加载器设置、运行提示并查看生成控制。他指出训练指南的位置,但没有实际执行训练。
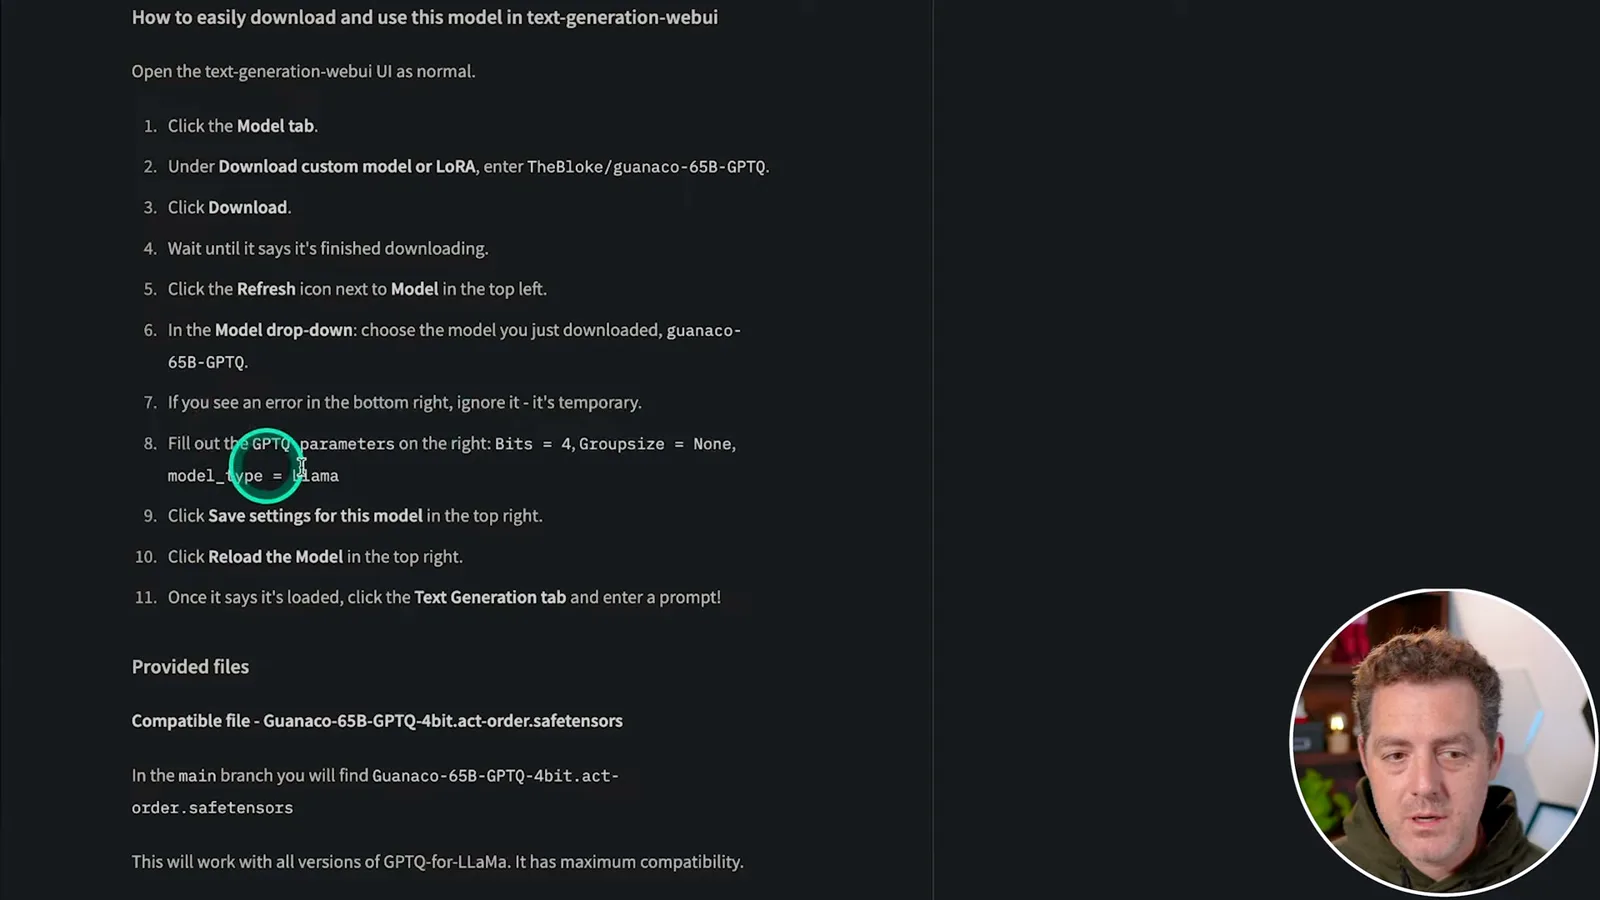
第一次加载出现错误。按照所展示的特定版本说明,我将 GPTQ 权重设为 4 位、分组大小设为 none、模型类型设为 LLaMA,保存设置后重新加载。这些值并不通用:其他 GPTQ 文件、量化分组和较新的加载器可能需要不同选项。
模型加载后,我切换到文本生成,选择 Guanaco 指令模板并要求它讲一个笑话。界面生成了简短回答;成功讲出笑话只是基本连通性检查,不能证明模型准确或适合所有任务。
界面还提供停止和继续控制、保存提示、统计 token,以及 temperature、top-p 和 top-k 等参数。我建议试用这些选项。单独的训练选项卡链接到指南,但我没有在本视频中实际训练模型。
检查用量并终止
Berman 检查磁盘和 GPU 用量并终止 pod。未持久化的数据随之删除。
回到 Runpod 后,我检查磁盘和 GPU 用量,然后终止 pod。由于示例没有配置持久卷,其中的数据会丢失;终止会结束该 pod 的计算费用,但单独保留的存储可能另行收费。完成后应检查实际资源和账单状态。
这是无需自己购买硬件就能试验模型的一种实用方式,但仍受模型显存需求和许可约束。Guanaco 源自 LLaMA,其模型卡要求使用者遵守底层 LLaMA 条款;商业使用前应核实适用限制。视频简介将 Runpod 链接标注为联盟推广链接。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。