30 秒看懂
2024 年 4 月,Matthew Berman 介绍 OSWorld:一个用于评估智能体操作真实桌面和网页应用的开放研究环境。原始基准包含 369 项 Ubuntu 任务,设有配置好的初始状态和可执行评估器;论文报告其测试中最好的智能体得分为 12.24%,人类基准为 72.36%。这些历史成绩只适用于该实验,并非当前的通用性能。视频由 Deepchecks 赞助。
- 1从指令到行动组装家具的类比说明,知道步骤与将步骤落实到环境中并响应反馈是不同的。
- 2智能体循环智能体接收指令和观察信息,选择行动,再观察产生的状态。
- 3真实应用工作流一个记账示例结合了收据图片和电子表格;OSWorld 为此类任务提供环境和评估器。
- 4观察与行动屏幕截图、无障碍树和标记集提供不同视角;智能体可以执行鼠标和键盘操作。
- 5基于执行的评估任务专属脚本检查最终状态,例如 Cookie 或电子表格内容,而不只评价文字回答。
- 6历史基准结果原论文在 2024 年基准条件下报告,最好的测试智能体得分为 12.24%,人类为 72.36%。
要点建议
- OSWorld 在受控虚拟机环境的真实应用中评估智能体;它是基准和环境,而不是能自动掌握计算机操作的模型。
- 原始基准包含 369 项 Ubuntu 任务,包括跨应用工作流;论文还描述了额外的 Windows 子集。
- 每项任务包含初始设置和针对应用或系统最终状态的定制执行检查。
- 屏幕截图、无障碍树和带标记的输入暴露不同信息,没有一种输入模式在所有情况下都最好。
- 论文中的 2024 年基准结果为最强测试智能体 12.24%、人类 72.36%,不是当前成绩。
- 基准分数衡量的是所定义的任务和评估器,不能代表任意计算机上的整体安全性或可靠性。
按章节阅读整理后的全文
将指令落实为行动
Berman 介绍基准,并用家具组装和桌面设置解释落地执行。计划需要转化为行动,并根据反馈进行检查。
我介绍 OSWorld,这是一个旨在互动计算机环境中测试多模态智能体的研究项目。团队发布了论文、代码和数据。它并非首次尝试评估智能体,但着力解决如何依据真实应用状态测试多种桌面任务的问题。
研究人员的演示使用了宜家家具组装的类比。一套说明书和一张成品椅子图片本身不会把椅子组装起来:执行者需要将每条指令对应到实际零件,采取行动并观察结果。
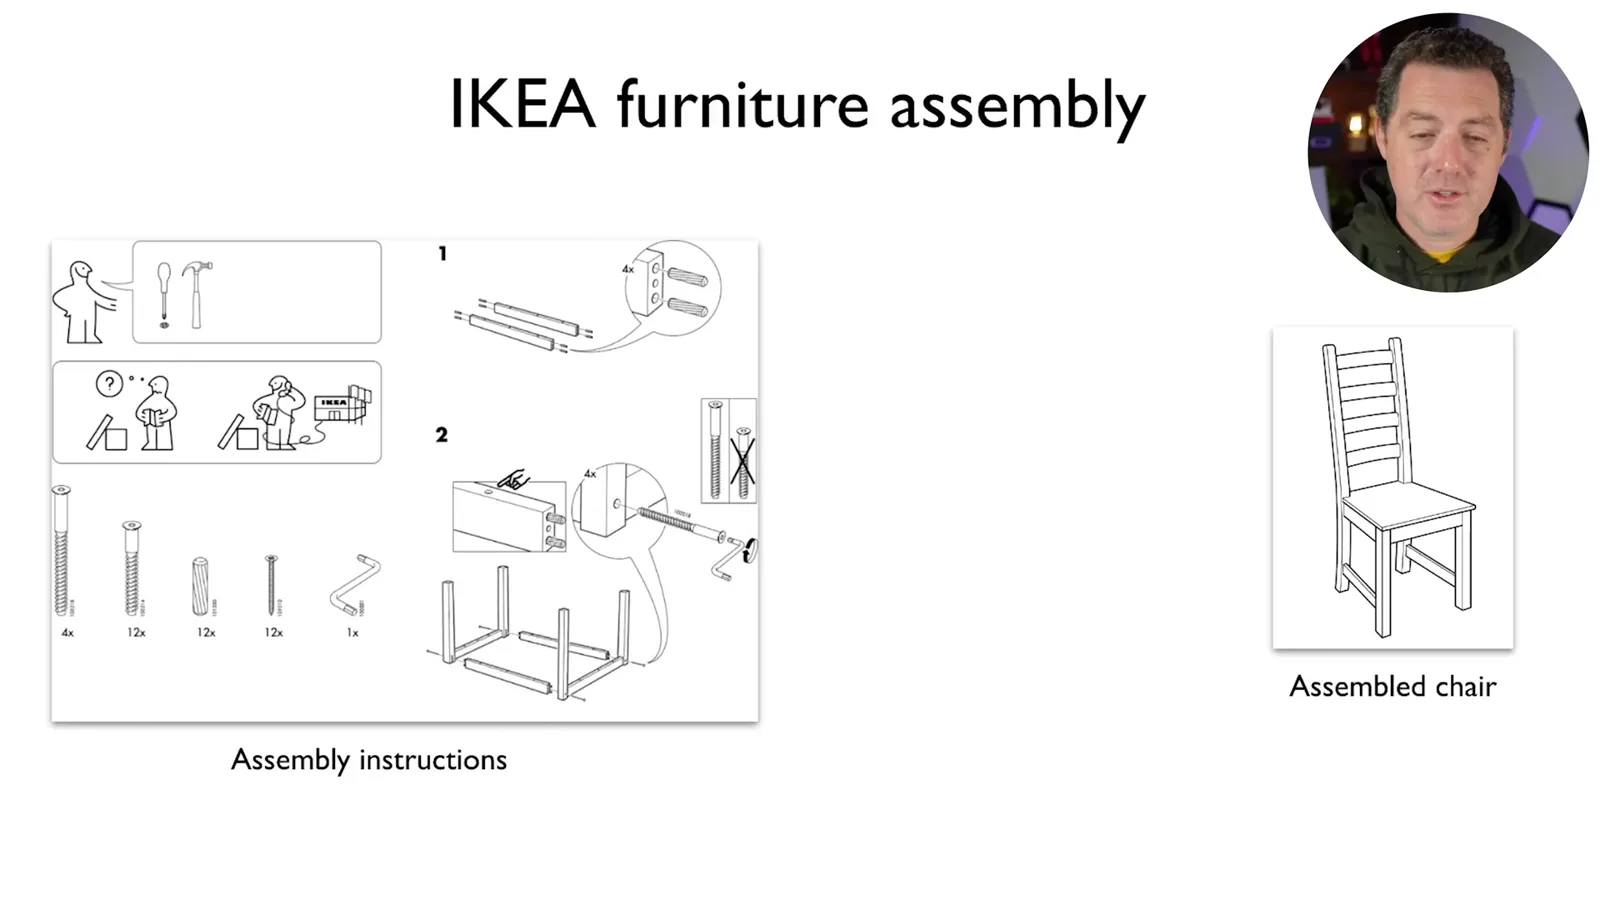
更改桌面背景也有同样的区别。助手可以描述步骤,但要执行就需要结合当前界面,将步骤落实为鼠标移动和键盘输入等操作。
2024 年我发现控制计算机很困难,并讨论了 Open Interpreter 等基于截图的工具。与计算机交互有多种方式,包括无障碍 API、结构化接口和其他工具;截图与网格并非唯一实现方式。
语言模型可以生成有用的指令,而不必连接计算机或物理环境。它能否执行任务取决于所配备的工具和反馈,不能一概而论地说所有模型或系统都无法交互。
智能体、工具与环境
他讨论观察—行动循环和相关研究。视频包含 Deepchecks 赞助片段。
演示描述了智能体接收用户请求、选择行动并观察结果的过程。根据具体设置,行动可以包括代码、API 调用或界面操作。环境可以返回信息,帮助智能体决定下一步。
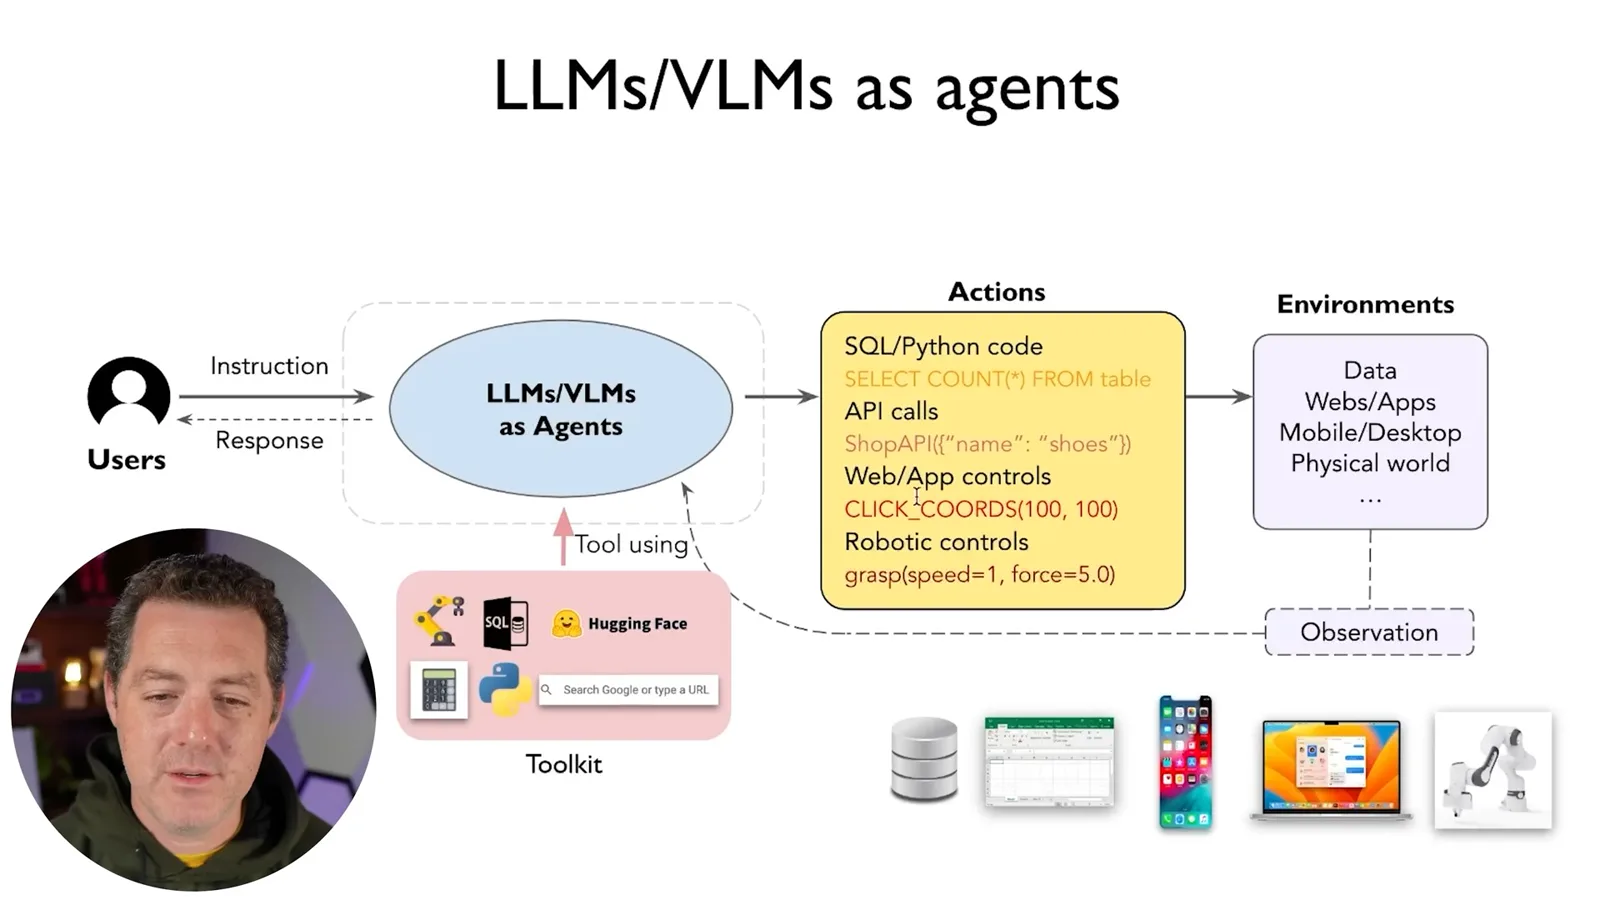
这一通用智能体类比包括传感器、观察和执行器:智能体感知环境,并朝着目标采取行动。关于实体机器人的讨论是一般性类比;OSWorld 评估的是计算机任务,而非实体机器人的操纵能力。
我将这一循环与智能体框架联系起来,举出摄像头、屏幕截图等传感器例子。一个机器人堆叠积木的例子说明,计划必须转化为行动,并根据反馈修正。
演示将理解指令、使用工具、多步规划和响应反馈列为期望的智能体能力。我讨论了 XLang 研究组的相关工作;XLang 是研究组织和项目集合,并非单一的 OSWorld 翻译语言。
视频由 Deepchecks 赞助。该公司提供用于评估和监控语言模型应用的工具。所描述的功能和免费试用属于宣传信息,并非独立测试结果。
我提到了 InstructAgent、Binder、Lemur、OpenAgents 和 Text2Reward 等相关研究项目。它们是不同的项目,而这里讨论的 OSWorld 是计算机操作环境和基准。
OSWorld 任务、观察与评估器
一个示例跨越收据和电子表格。该环境提供任务设置、观察、行动和基于执行的检查。
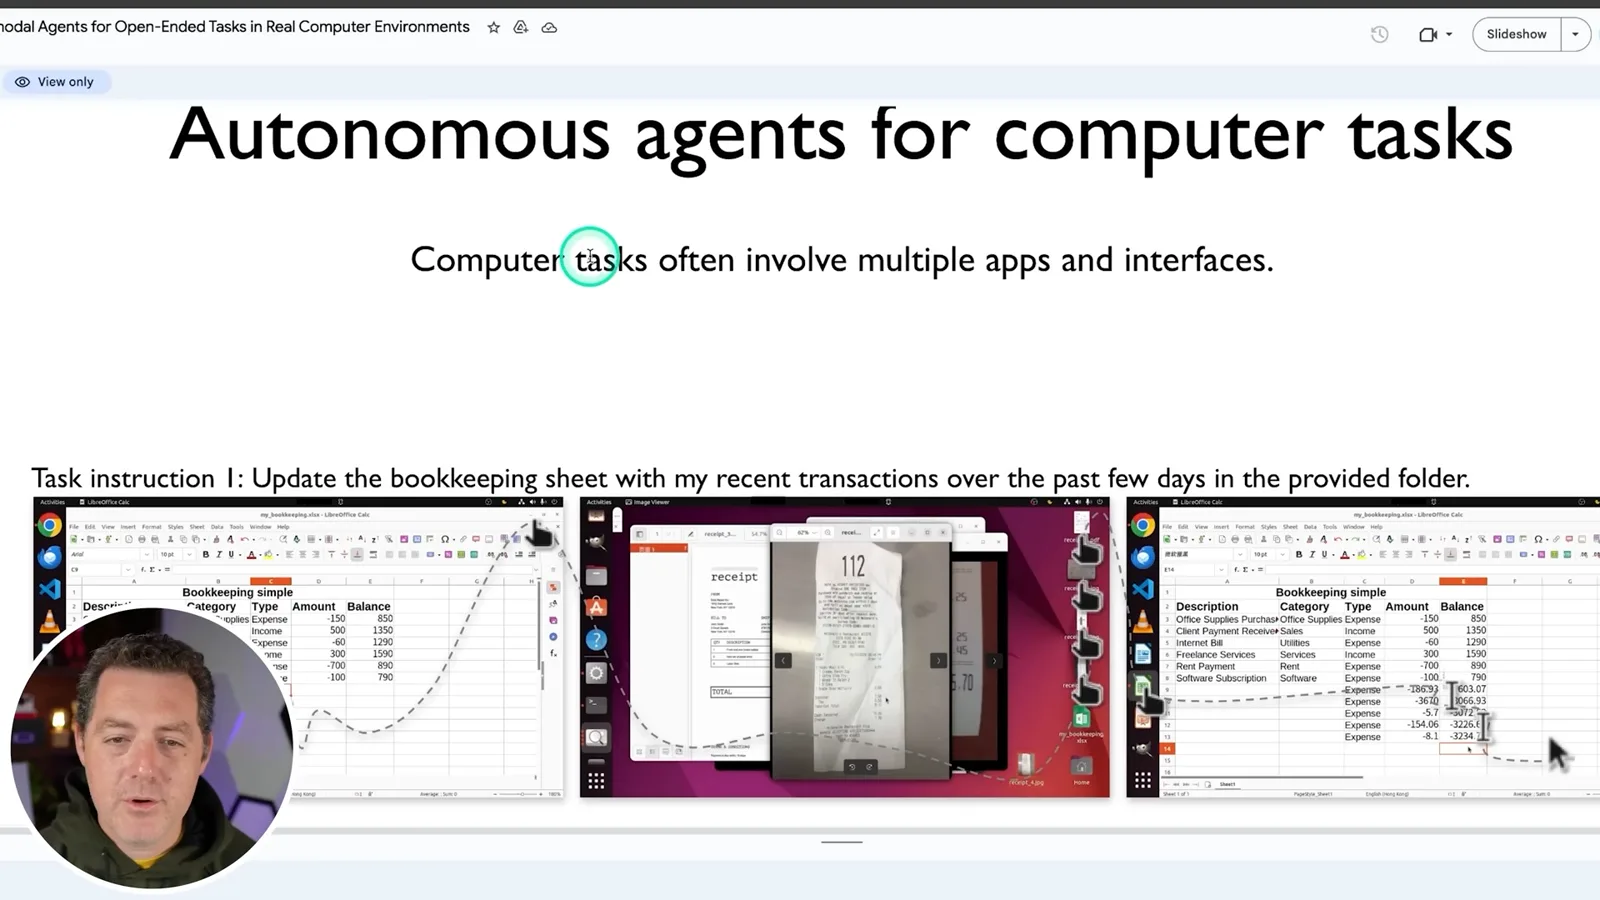
一个示例要求智能体利用以图片保存的近期收据更新记账电子表格。智能体必须找到文件、理解相关金额并跨应用修改表格;这个例子说明任务内容,并不能证明每个测试模型都能完成。
OSWorld 使用运行真实操作系统和应用的虚拟机。该平台旨在支持不同操作系统,但原始主要基准包含 369 项 Ubuntu 任务;论文还描述了额外的 Windows 子集。这并不能证明它对每个操作系统上的所有应用都有同等完整的覆盖。
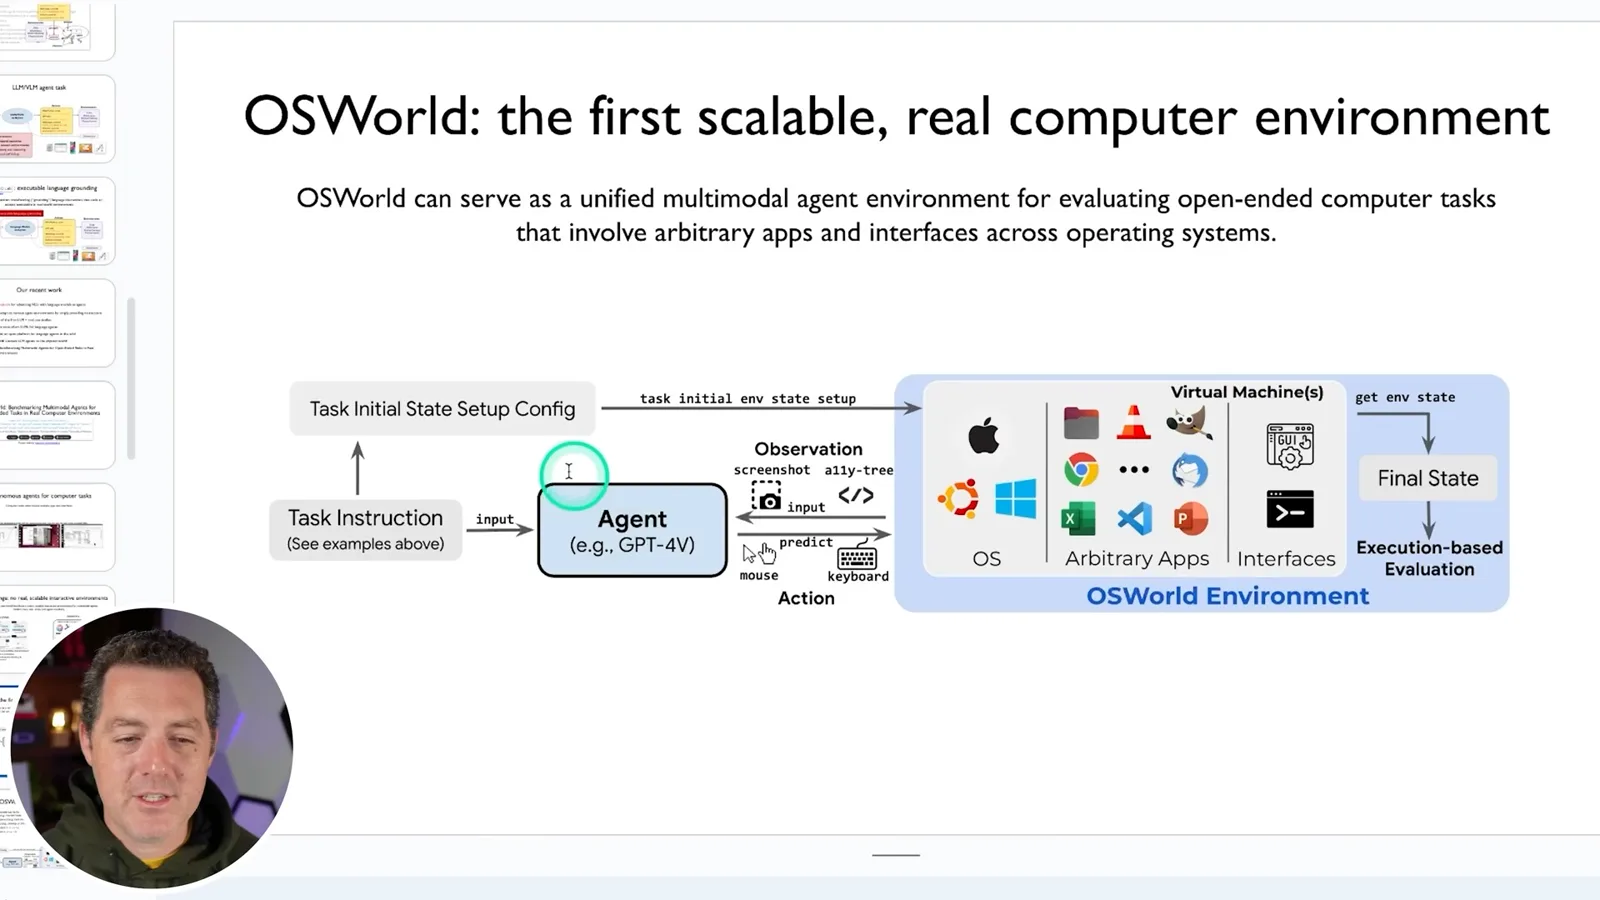
每项任务包含一条指令和初始状态配置。智能体接收观察信息、产生行动,并随着环境变化获得新的观察。研究人员将任务描述为部分可观察马尔可夫决策过程:智能体不一定能看到计算机的全部状态。
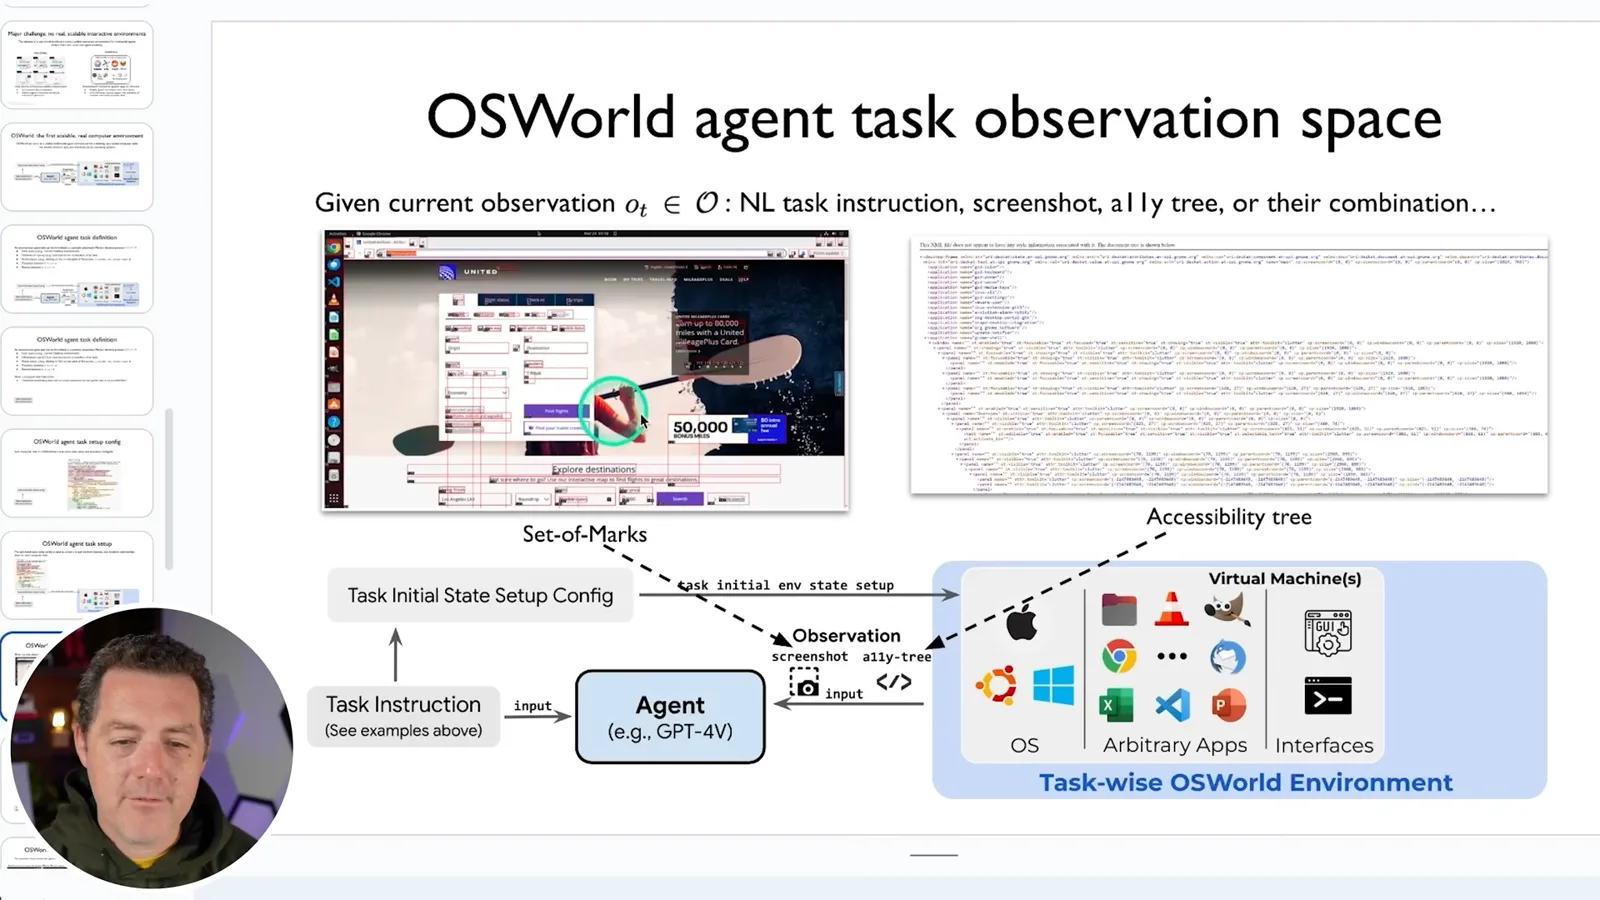
观察信息可以包括屏幕截图、无障碍树信息或两者的组合。在原始标记集设置中,系统利用过滤后的无障碍信息为元素加上编号框;智能体可以选择一个编号,系统再将其映射为行动。它不只是均匀网格,也可能无法显示每个元素。
行动接口包括鼠标移动、点击、输入、键盘快捷键、滚动和拖动,以及等待、完成或失败等信号。基准环境提供这些接口,但本身并不能解决落地执行问题,也不提供通用能力的智能体。
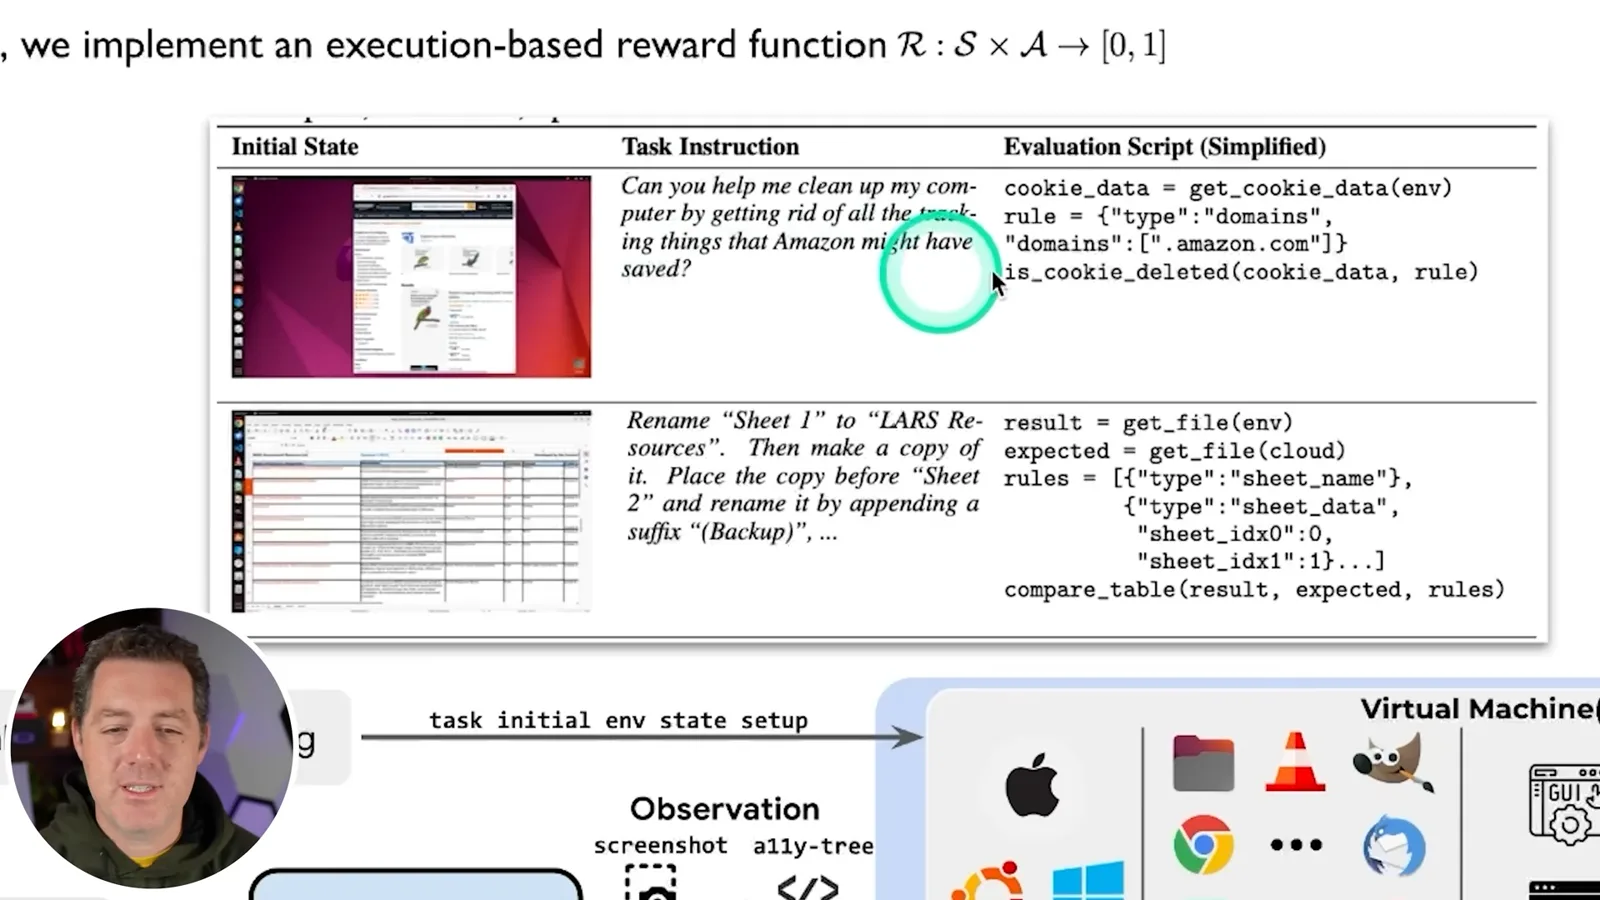
任务专属的基于执行的评估器会检查最终状态。例如,脚本可能检查目标 Cookie 是否仍然存在,或比较电子表格的工作表名称和内容。这些检查衡量的是定义好的条件,也可能存在局限;通过某项检查并不等于全面审计了安全性或所有副作用。
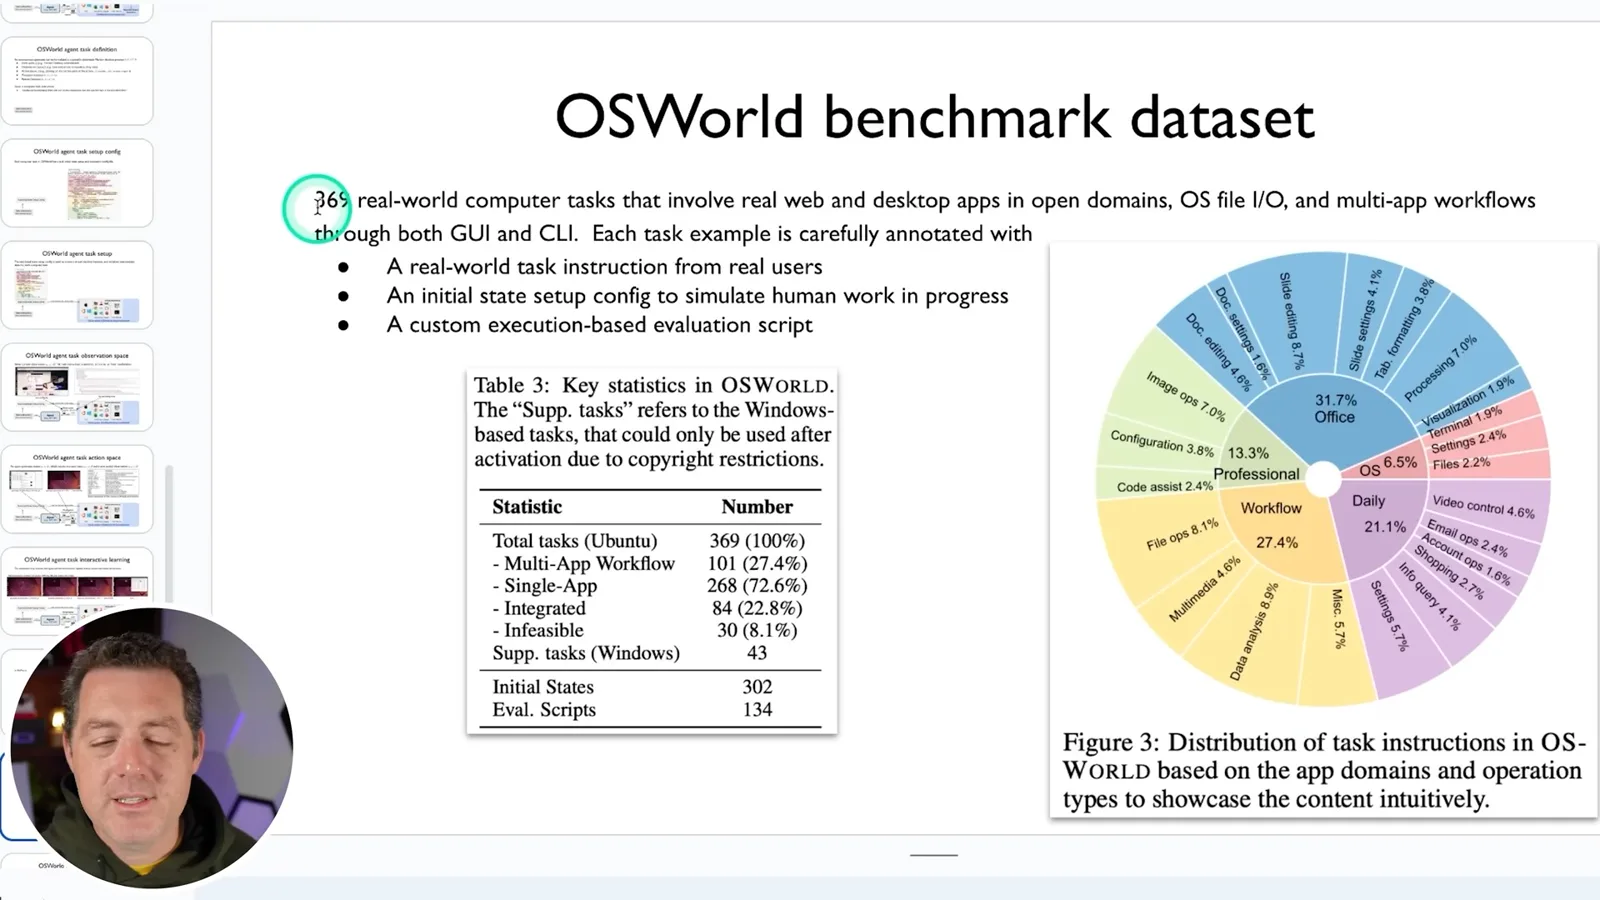
原始数据集包含 369 项 Ubuntu 任务,其中 268 项为单应用任务,101 项为跨应用工作流。研究人员还描述了额外 43 项 Windows 任务用于分析。指令、初始配置和定制检查使这些任务可以在指定条件下复现。
基准模型与结果
Berman 解读原始输入模式和模型比较,包括一项分辨率实验。这些分数描述的是 2024 年研究,而非当今系统。
论文使用不同观察格式测试多个语言模型和视觉语言模型基准。提示要求智能体生成行动,画面中的设置包括 PyAutoGUI 代码,并提供近期行动和观察历史。
我注意到温度设置为 1,并好奇研究人员为何没有将其调低。温度控制采样行为,但在不同模型或 API 中,1 并不必然是创造性最高的设置,仅凭这一观察也无法确定哪种设置表现最好。
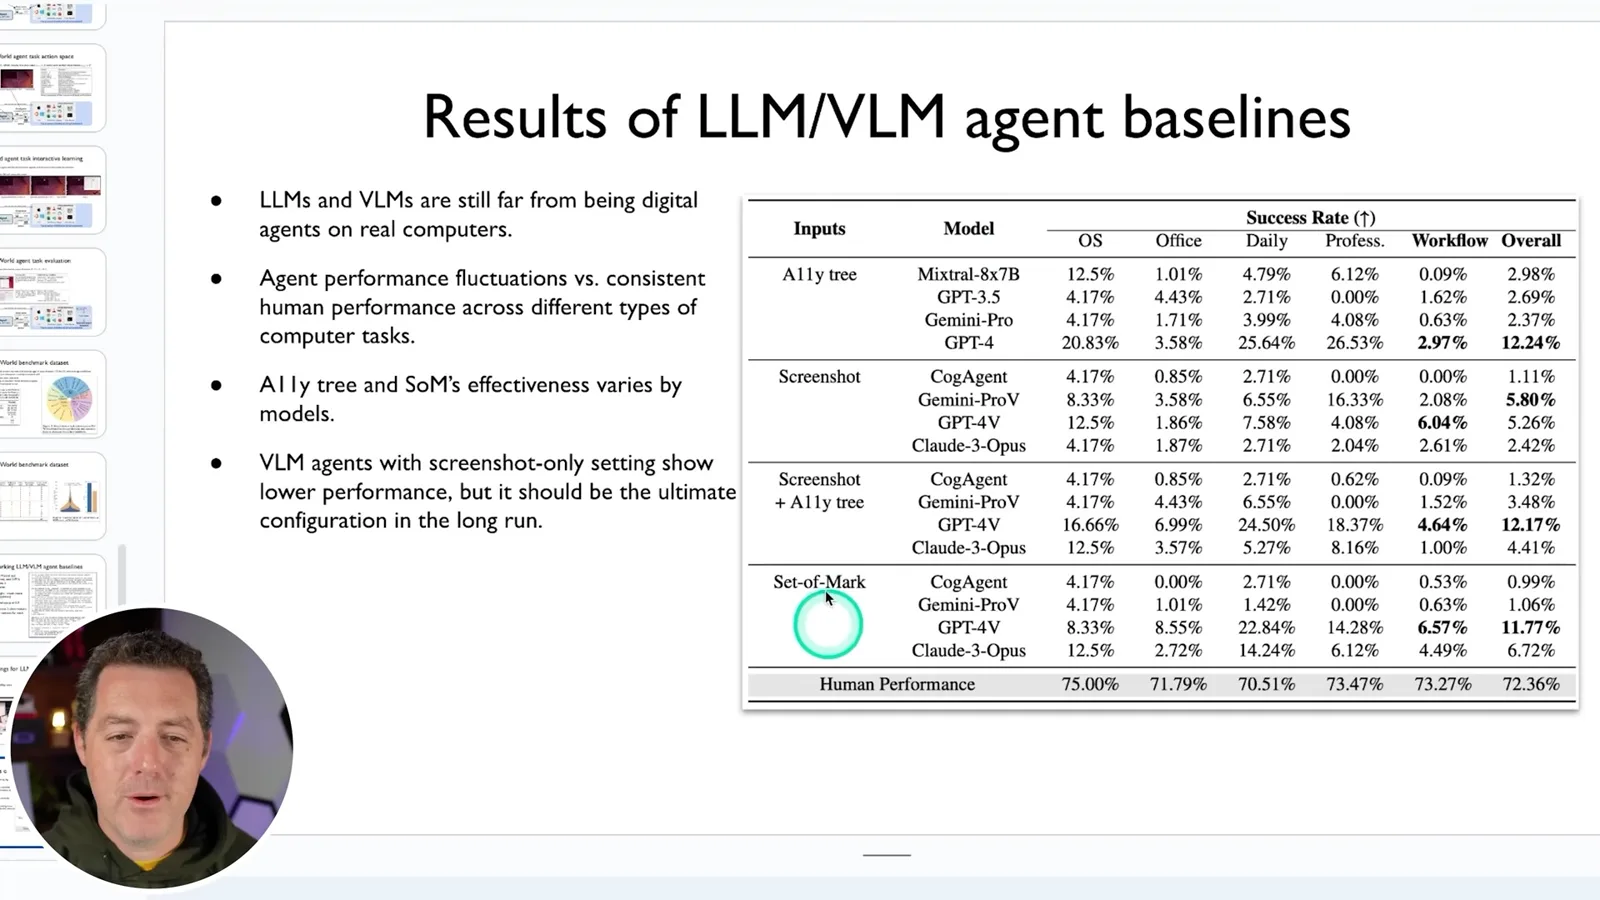
2024 年原始结果显示,测试中最强的配置——使用无障碍树输入的 GPT-4——总体成功率为 12.24%;报告的人类基准为 72.36%。这些数字描述的是论文的基准和评估条件,并非对当前模型或所有计算机工作的判断。
表格中,使用截图加无障碍树的 GPT-4V 以 12.17% 接近这一成绩,而仅使用截图的结果因模型而异。最佳输入取决于系统和任务;表格并不能证明无障碍树总会优于其他方法。
研究人员还在部分示例上测试了屏幕截图分辨率。在展示的实验中,更高分辨率改善了仅截图曲线,但标记集曲线并非单调变化,因此不能将该图推广为普遍规则。
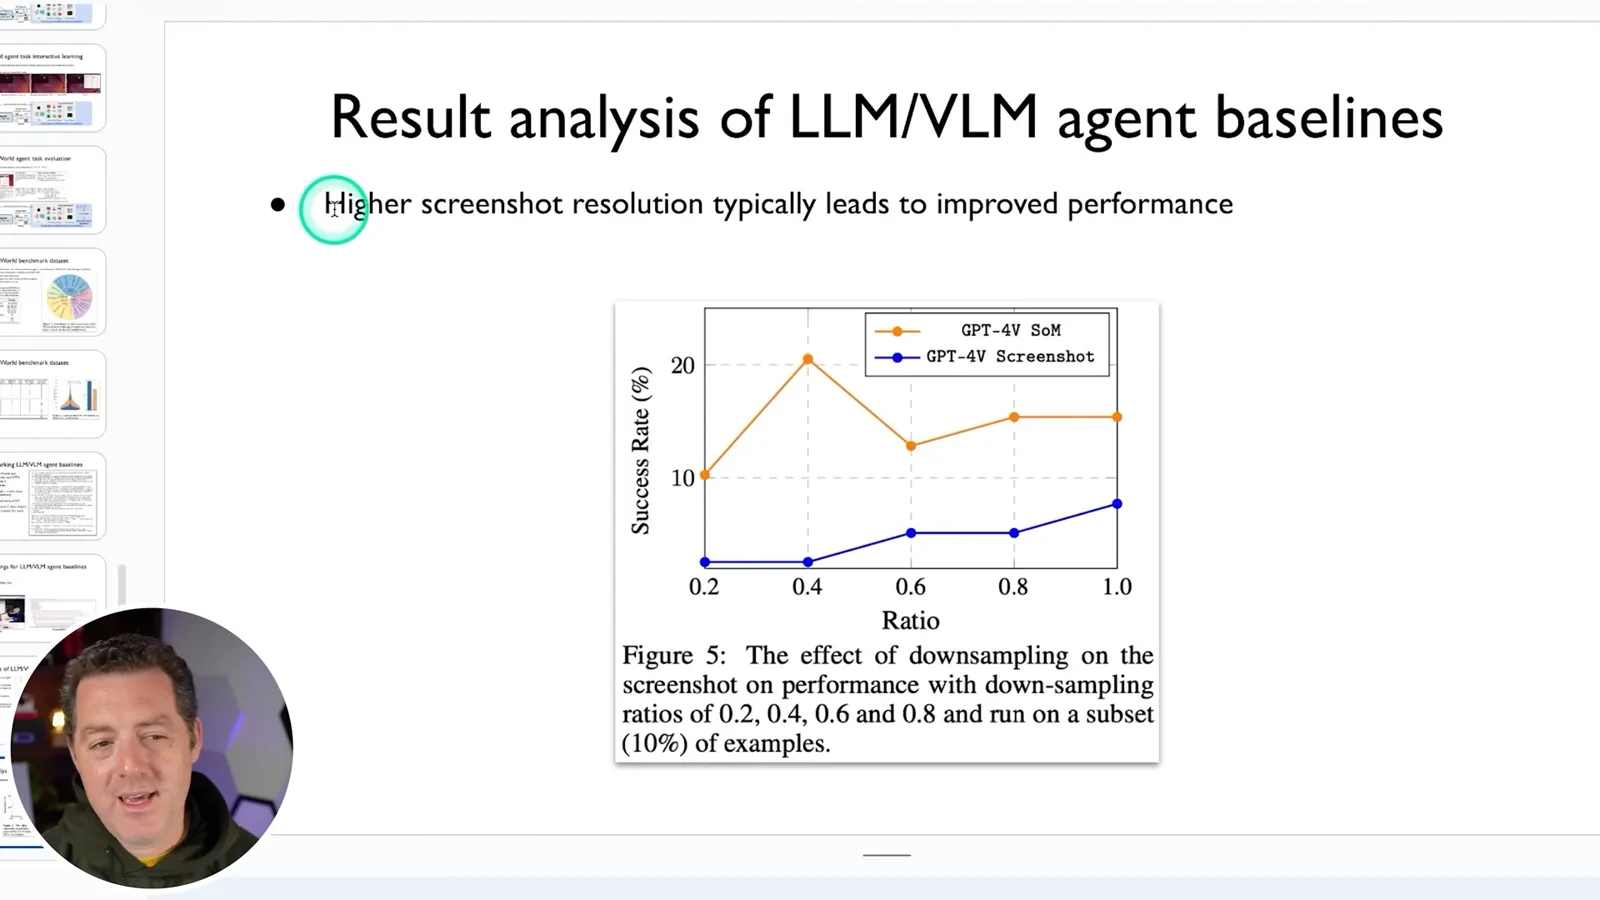
我欢迎 OSWorld 作为衡量智能体执行能力的方法,并考虑制作实操教程。基准测试有助于了解进展,但真实部署仍需要权限控制、适当测试,并评估单一分数之外的失败情况。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。