30 秒看懂
Nathan Lambert 梳理偏好概念的思想史,并介绍人工与合成偏好数据的收集方式。他认为,不完美的代理指标、标注偏差,以及数据规范与模型行为之间的差距,仍是开放的研究问题。
- 1为什么要比较人们通常更容易评价一个回答,而不是自己写出同样好的回答。
- 2效用及其假设偏好建模简化了人类偏好多维且不断变化的现实。
- 3界面影响反馈研究工具和面向消费者的产品会收集不同形式的偏好信号。
- 4数据运营标注需要准备完善的训练流程和详细说明。
- 5缺失的审计Lambert 希望追踪规范如何经过训练数据影响模型行为。
要点建议
- 比较回答通常比写出优质示范更容易。
- 将偏好归结为单一奖励虽然有用,却包含很强的假设。
- 偏好数据的收集方式包括成对比较、评分和结构化合成数据。
- 人工标注需要细致的说明,以及有能力利用数据的团队。
- 偏差和预期价值与最终行为之间的联系值得更透明地研究。
按章节阅读整理后的全文
偏好为什么重要
当正确性难以打分时,比较可以提供学习信号。Lambert 介绍代理指标与下游表现之间的目标错配。
我想重新讨论后训练中的人类反馈和数据:偏好是什么,又该如何收集。这些问题曾是 AI 安全的核心,现在仍然困难,受到的关注却少了。RLHF 要解决的是,当我们无法直接为某种能力打分时,如何让它进步。
通常,判断两个例子比自己创造好例子容易。你可能很难写出一首关于火车在暴风雨中挣扎前行的好诗,却仍能分辨好诗与坏诗。偏好数据流水线利用的就是这种直觉,同时接受这种不精确测量带来的权衡。
我展示了 Claude 3.7 Sonnet 和 GPT-4o 在 2025 年 2 月生成的两首诗。我已不记得哪首出自哪个模型。不同人可能对哪首更好有不同意见,这引出了一个实际问题:如何利用这些判断的分布来改进模型?
没有唯一正确答案时,偏好信号可以取代正确性。包括 DPO 和 RLHF 在内的偏好微调也提升了可衡量的能力:看似微妙的偏好信号,能够改善模型在社区关心的基准上的表现。
本讲结合了偏好的历史与哲学讨论、实际数据收集方法,以及尚待解决的研究问题。了解工具从何而来,有助于看清其社会背景和隐藏假设。
2023 年,我与合作者写了一篇关于 RLHF 历史和风险的论文,追溯经济学、最优控制和哲学中的思想。使用来自复杂学科的工具时,如果不了解它们的问题设定,就可能忽略自身所做的权衡。
我博士期间研究的基于模型的强化学习中的目标错配提供了一个类比。模型学习环境动力学,以便策略采取行动,但最准确的动力学模型未必能产生最好的策略。同样,在数据上最准确的奖励模型,也未必能让下游语言模型表现最好。
奖励模型基准是代理指标,而每个代理指标都有缺陷。这个主题贯穿整门课程。要理解原因,可以追溯偏好和效用如何变成系统能够优化的数字。
历史与理论
哲学、效用理论、社会选择和控制理论共同影响了 RLHF。它们的假设未必完全适合人类偏好。
现代后训练融合了控制理论与电气工程、计算机科学与深度学习、经济学与决策理论,以及更古老的哲学思想。这些学科对决策和优化的不同理解进入了同一套技术实践。
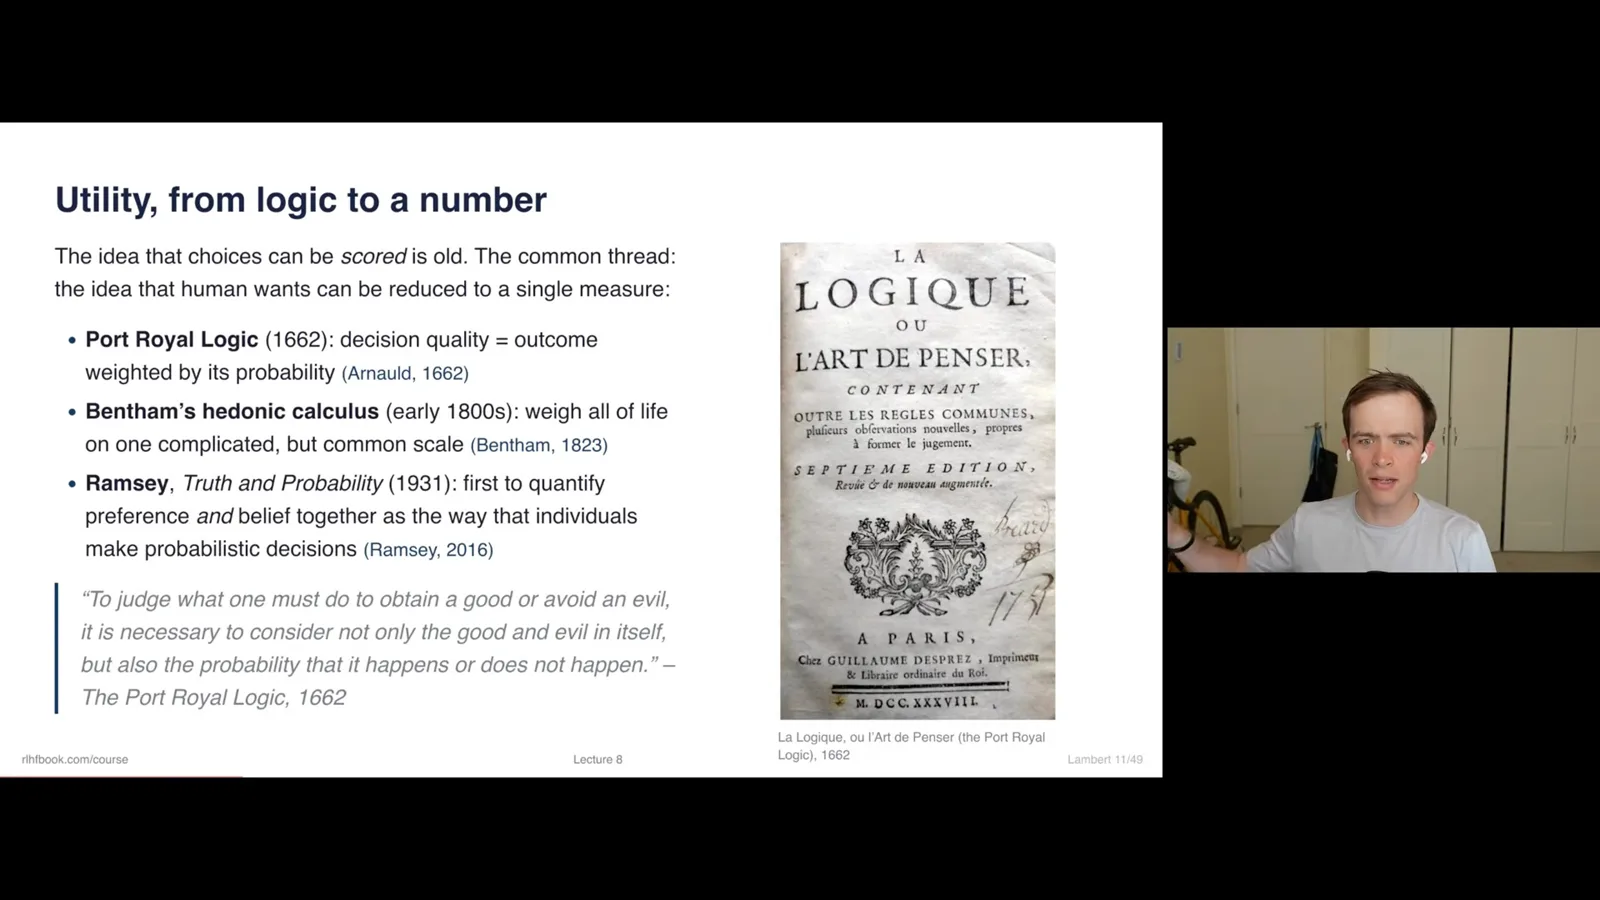
《Port-Royal Logic》讨论了按概率加权结果;Bentham 提出用共同尺度衡量决策;Ramsey 将偏好和信念与概率决策联系起来。Lambert 将这些视为量化效用的思想步骤。
von Neumann–Morgenstern 效用定理指出,满足完备性、传递性、连续性和独立性等假设的偏好,可以用效用函数表示。于是,理性行动者可以被建模为最大化期望效用。
RLHF 中的人类偏好并不总满足这些整齐的假设。偏好会随时间和情境变化,而且有多个维度。把它们压缩为一个数字让问题变得可处理,却也给人类行为的表示带来了权衡。
1952 年提出的 Bradley–Terry 模型将成对比较转化为反映相对质量的分数。但两个开放式回答之间的偏好,可能取决于文本中无数特征,以及给予标注者的说明。任何简化都难免有取舍。
行为经济学和社会选择理论研究了汇总个人偏好时的更多复杂性。我曾探索如何将社会选择思想用于 RLHF。尽管近期注意力转向可验证奖励和迫近的 AI 风险,这仍是一个有趣的方向。
偏好随时间和情境变化,这给静态收集的人类反馈带来限制。与此同时,最优控制和强化学习发展出优化动态系统的方法,包括 Bellman 的动态规划以及后来的深度强化学习。
两条路径的结合很诱人:如果偏好可以用函数表示,而强化学习能优化函数,为什么不把它们结合起来?但成本、奖励和偏好来自不同的思想传统。把偏好当作奖励会收窄问题,也会带入假设。
学习得到的奖励模型并非真实奖励,这有助于解释过度优化。我还觉得有趣的是,逆强化学习通过观察行为推断奖励,虽然和从偏好中学习奖励模型有关,却未在早期 RLHF 中发挥更大作用。
跨学科探索仍有很大空间。较早的强化学习研究追问奖励从何而来,并将奖励和价值函数与动物的初级奖励和条件性奖励作比较。这些问题的哲学内涵远比我们常用的狭窄经验研究框架丰富。
收集偏好数据
界面、评分和合成比较会产生不同类型的反馈。人工标注还需要大量运营准备。
回到实际数据,判断通常比示范更容易大规模收集。人类偏好仍帮助团队理解和改进模型,但标注说明、收集过程、公开数据与最终模型改进之间的关系,很少得到一并记录。
NVIDIA 的 HelpSteer 数据集是将公开的人类偏好与模型开发联系起来的较接近的例子。考虑到偏好数据在 2023 年和 2024 年后训练中的核心地位,我希望能看到更多这样的案例。
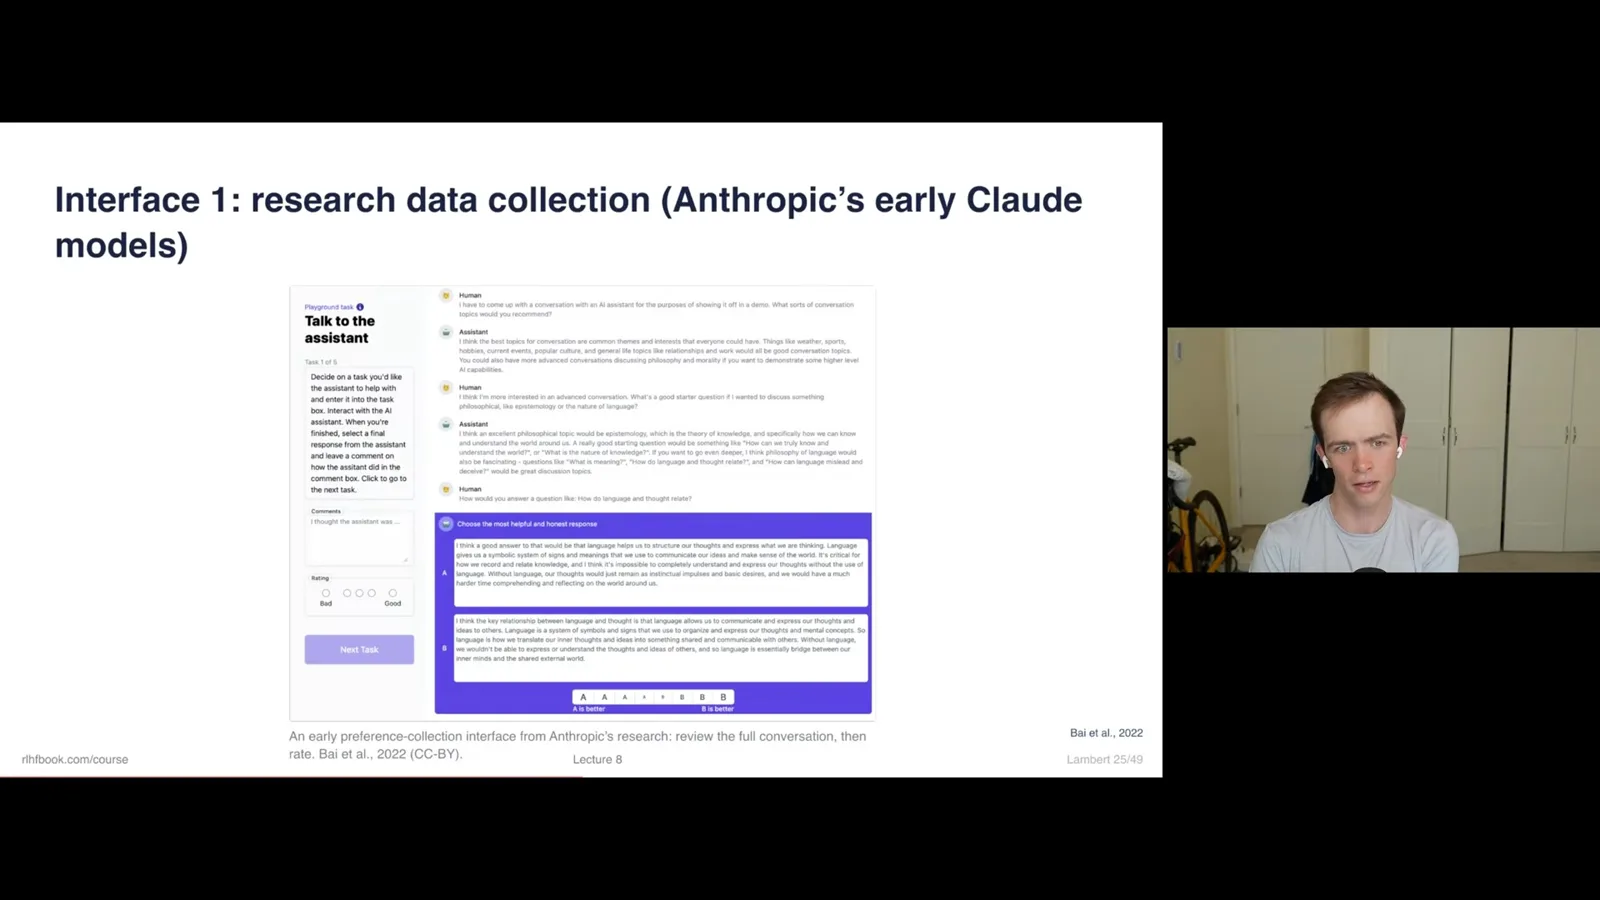
Anthropic 早期研究界面向标注者展示一段对话和两个备选回答,提供用于选择的量表以及填写元数据的空间。ChatGPT 也曾向用户展示 A/B 比较,而 Arena 提供平局或两个回答都不好的选项。
用户的 A/B 选择可以成为评估信号,有时也用于训练。我提到 OpenAI 对一次谄媚事件的说明:基于用户反馈的奖励模型遭到过度优化。点赞和点踩是另一种常见界面。
图像生成器通常展示一组候选图。用户可以很快选出喜欢的图片,这些选择之后可以支持奖励模型或其他对齐方法。图像后训练的具体机制与语言模型不同,但选择界面直观。
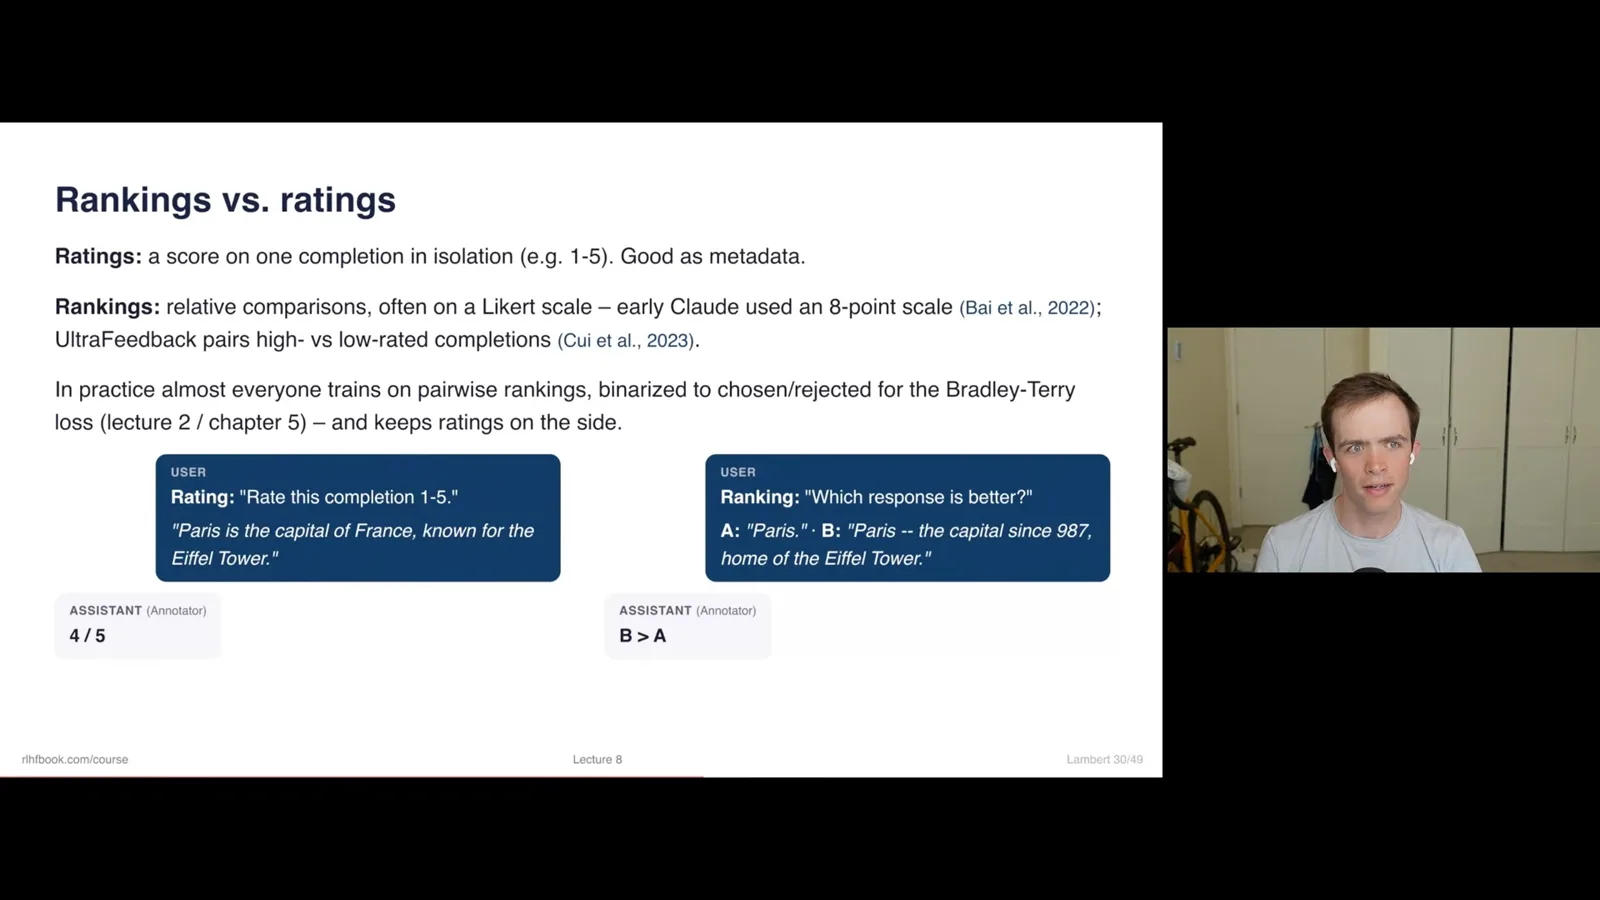
评分是单独给一个回答打分;排序是比较两个或更多回答。训练数据常被简化为成对排序,而单项评分仍可作为有用的元数据。Likert 量表记录偏好的方向和强度,收集数据时曾广泛使用。
当正确性可以检验时,就能构造结构化或合成偏好数据:正确答案优于错误答案,满足格式约束的回答优于违反约束的回答。但困难的约束可能让内容变得牵强,所以这是一种启发式方法,不能完整代表质量。
研究者也探索过成对比较之外的反馈,包括正负标签、token 级反馈和自然语言批评。这些方法有充分的动机,但许多方法在实践中难以收集或扩展,或者扩大规模后没有显示足够的收益。
人工标注昂贵,而且运营难度很高。供应商合同可能先交付小批次数据,随着说明和数据改进逐步扩大规模。团队必须准备好在收集过程中接收数据,并持续改进模型。
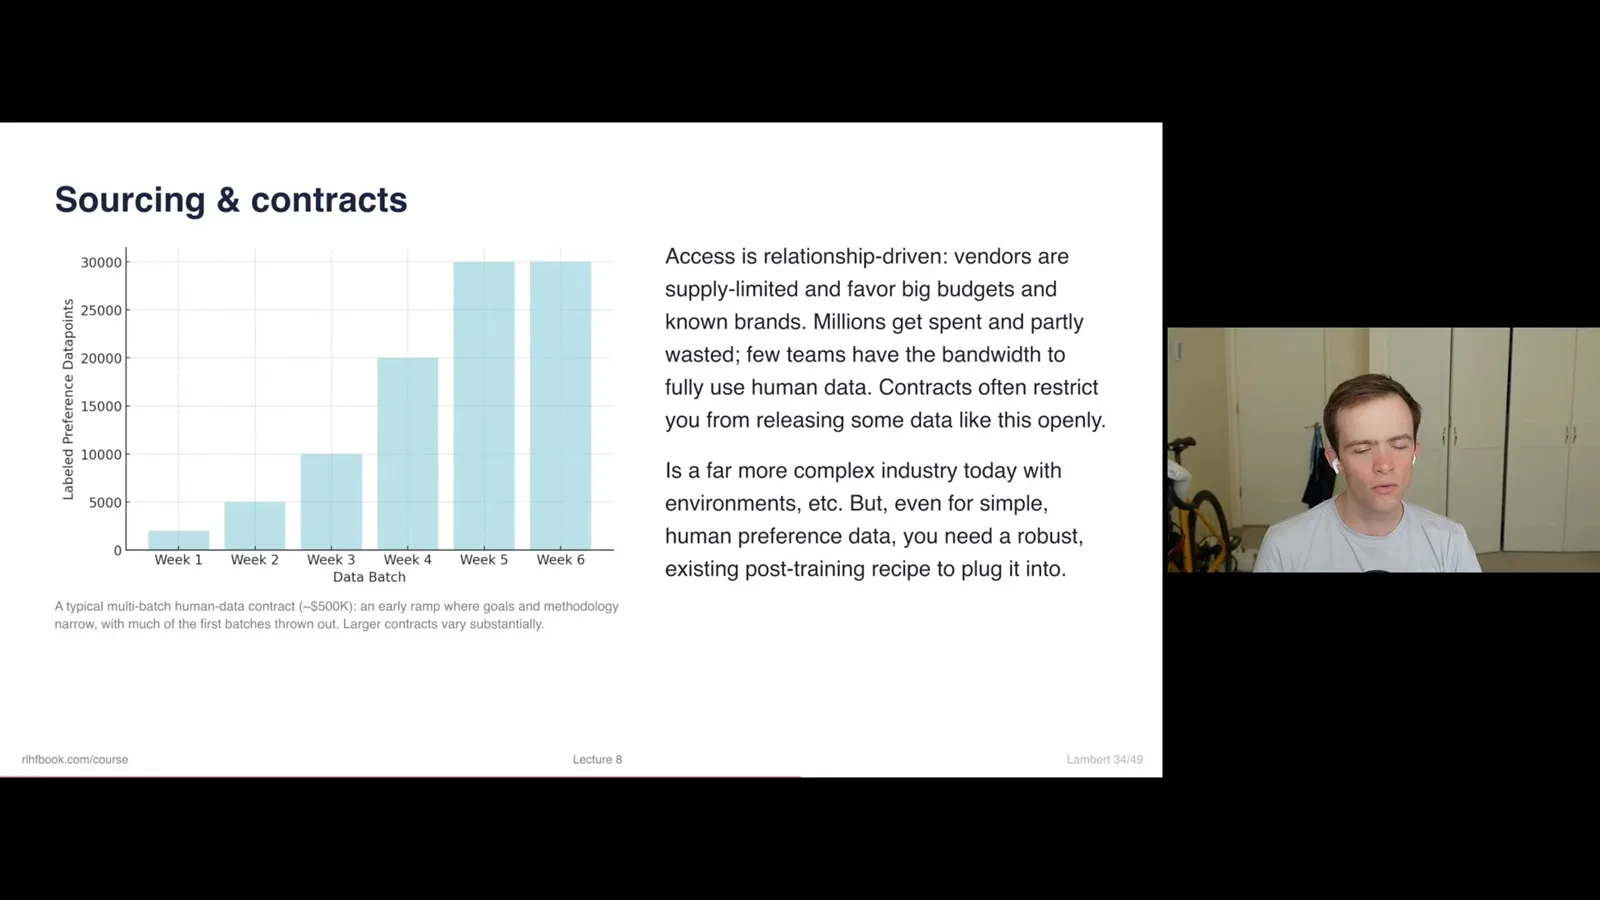
根据我的经验,数据可能来得很快,购买数据也不保证会产生有用结果。购买训练数据前,团队需要成熟的后训练方法和内部使用数据的专业能力。随着预算扩大和智能体环境出现,这些挑战更加复杂。
签订合同还需要详细的标注说明。我找回了公开发布的 InstructGPT 标注说明,并将它放入 RLHF book 仓库。这是一份有助于理解标注者任务的历史材料。
我在 Hugging Face 负责数据采购时,既购买了监督微调数据,也购买了偏好数据。偏好数据对小团队尤其困难,因为同策略比较应该来自相关模型家族;监督示例没有同样的约束。
偏好比较也成了一门生意。Lambert 说,Arena 向企业提供跨领域的模型测试,并提到其年度经常性收入为 1 亿美元。尽管有人质疑用户群体的构成,他认为这些比较仍为行业提供重要信号。
偏差与开放问题
格式、冗长等特征可能扭曲标注。Lambert 呼吁更透明地展示模型规范、数据和实际行为之间的联系。
偏好数据的开放问题包括各种偏差。Lambert 试探性地将前缀偏差描述为回答开头对标签产生过大影响。谄媚则奖励模型说用户想听的话;冗长可能让回答显得更完整、更可信。
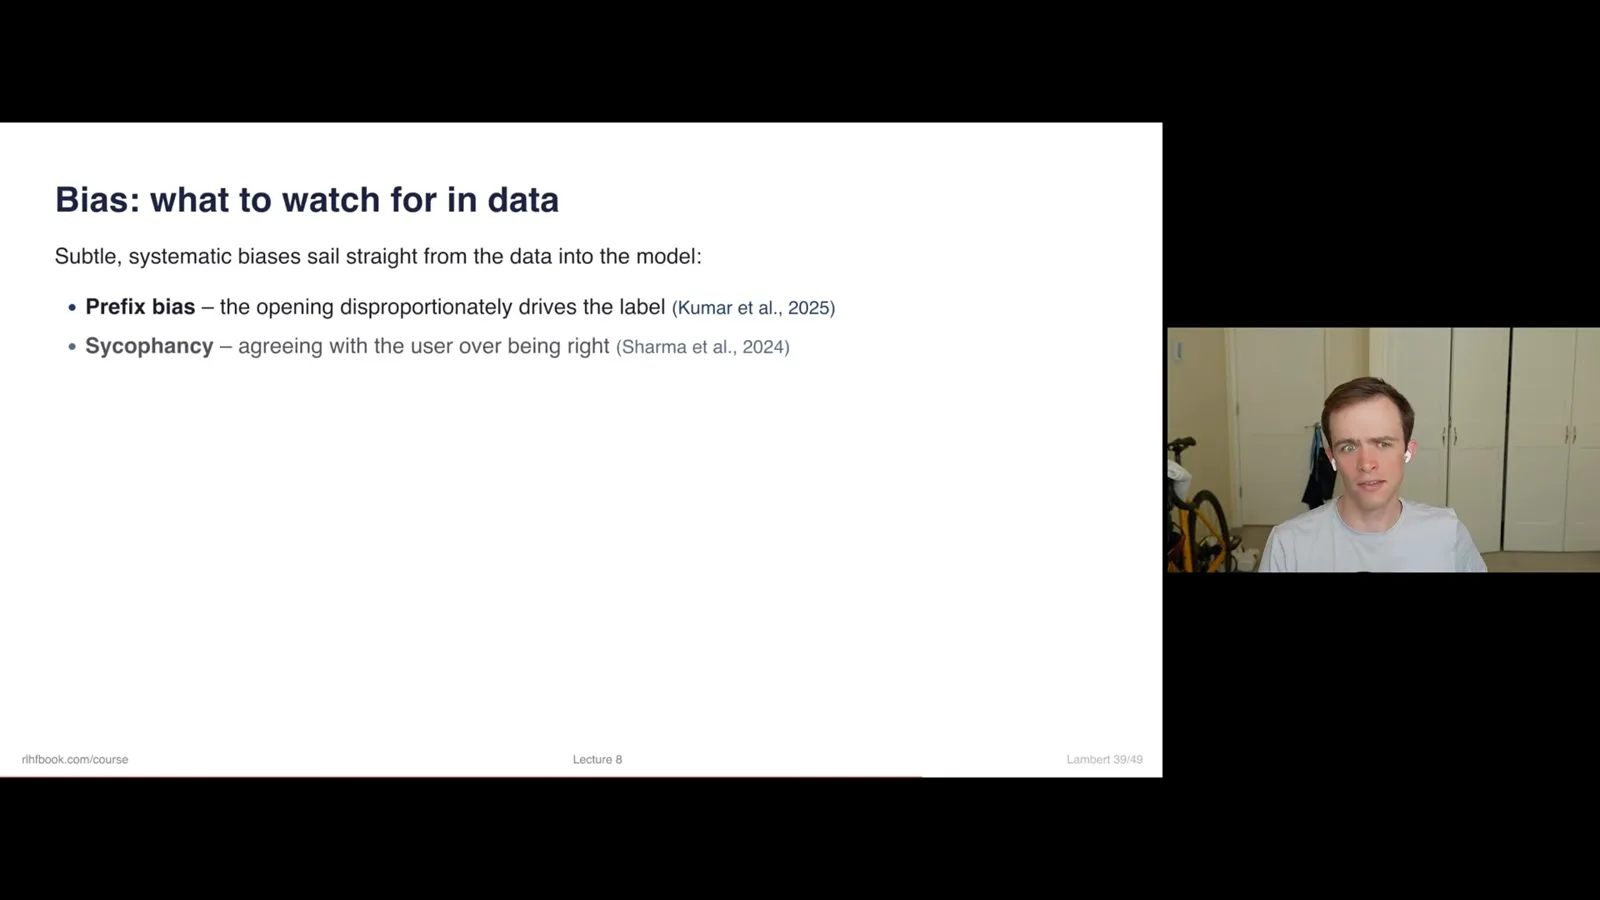
格式和修饰性语言也会影响分数:列表和粗体可能在内容本身之外显得更讨喜。随着领域和模型变化,新偏差会不断出现,因此消除偏差是一项持续工作。
谁来标注也很重要。付费和非付费标注者面临不同的激励和限制。Lambert 怀疑商业模型开发能否让所有人拥有平等发言权,但认为了解谁塑造数据,有助于解释并解决部分偏差。
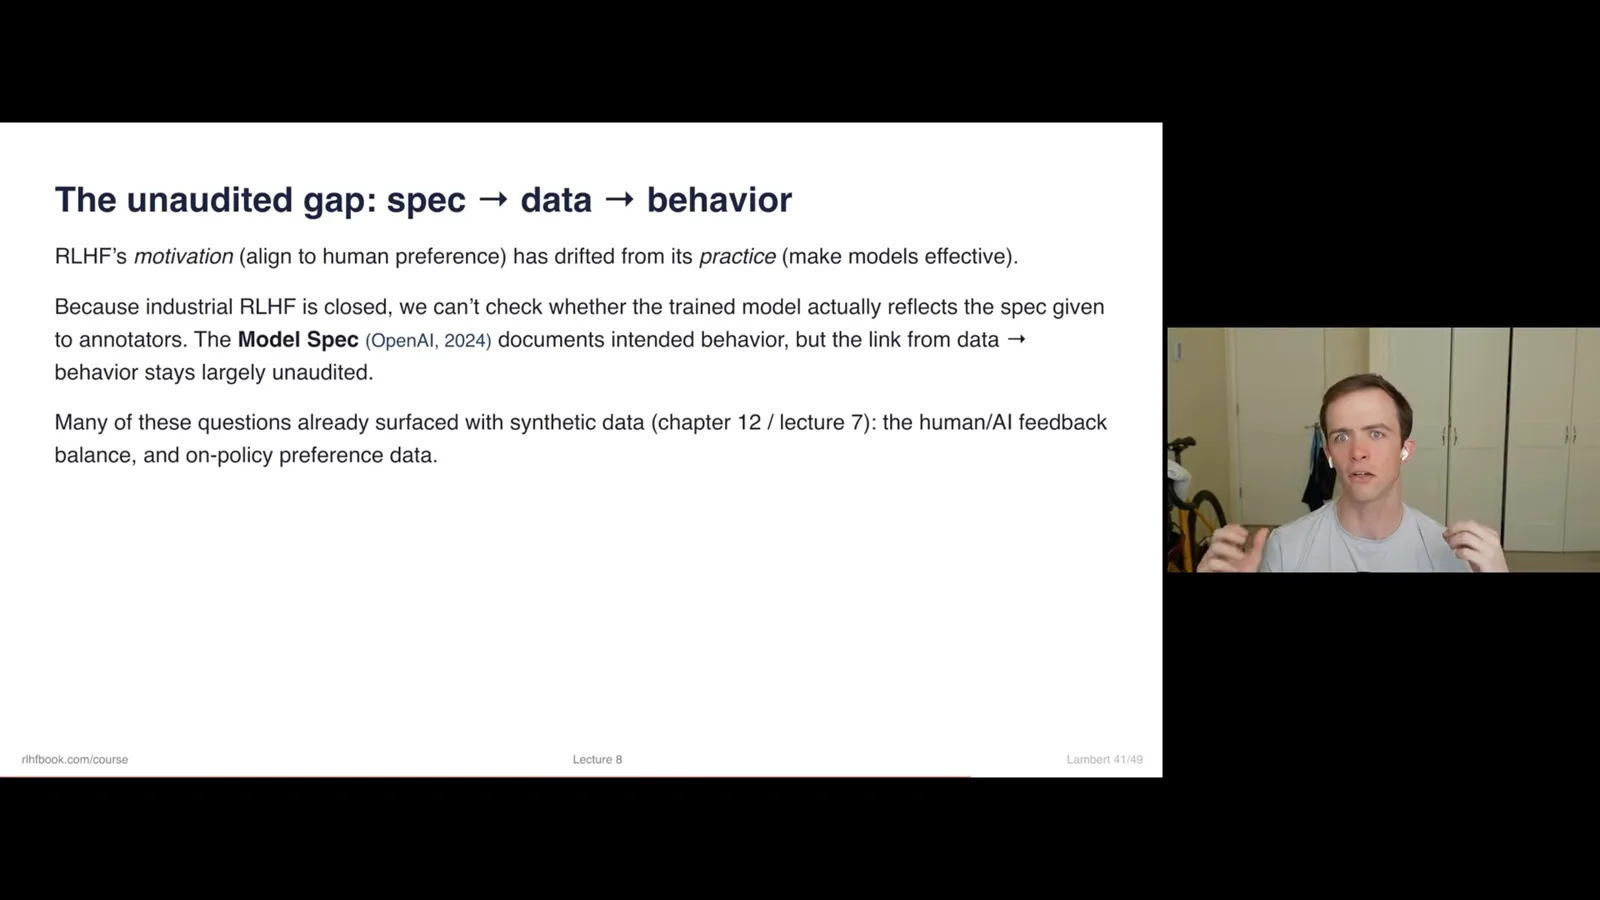
我尤其关心一个问题:标注规范中写下的价值,最终真的出现在模型里了吗?我希望公开模型规范,展示模型在哪些方面符合或不符合规范,并通过透明的数据、意图和结果追踪行为如何变化。
收集偏好、训练奖励模型并将它们整合到更大流水线中,仍存在许多开放问题。这里有已有文献可供借鉴,也有值得学术界研究的机会。下一讲将讨论过度优化和正则化。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。