30 秒看懂
在这期由 Aiven 赞助的 2024 年 1 月教程中,Matthew Berman 使用预训练的 OpenCV 检测器和图像嵌入,寻找与另一张照片相似的人脸裁剪图。他将向量存入启用 pgvector 的托管 PostgreSQL 数据库,并展示一次成功匹配。 该演示组合了现有组件,并未证明生物识别的准确率。最近的结果可能出错,检测器也可能漏掉人脸,视频中的历史云服务额度优惠如今可能已经改变。
- 1组合而成的流程预训练人脸检测和图像嵌入为 PostgreSQL 向量搜索提供输入;教程并未从零训练模型。
- 2检测与裁剪OpenCV 找到候选矩形区域,笔记本保存检测到的人脸裁剪图。
- 3托管向量存储Berman 创建赞助商提供的 PostgreSQL 服务并启用 pgvector;优惠属于历史信息。
- 4按距离搜索查询向量与已存储的向量进行比较。距离最近的候选项并不自动构成已验证的身份。
要点建议
- 这个流程分为人脸检测、图像嵌入、向量存储和最近邻搜索几个步骤。
- 单词指示向量示例用于说明向量比较;实际的图像向量来自预训练模型。
- OpenCV 检测参数会改变哪些候选矩形被保留,并可能影响漏检和误检。
- 最近邻并不能证明身份,仅凭排序无法判断是否存在有效匹配。
- 数据库凭据和人脸衍生数据需要适当的访问控制;云服务也会接收存储的向量。
- 视频由 Aiven 赞助,试用额度数字针对 2024 年的演示。
按章节阅读整理后的全文
人脸、向量与相似度
Berman 介绍工作流,并用简单的单词向量例子解释相似度。实际演示使用预训练的图像组件。
Matthew Berman 演示了一个小型 Python 图像匹配流程:检测合照中的人脸,将裁剪图转换为向量并存入 PostgreSQL,再用另一张照片进行搜索。视频发布于 2024 年 1 月,由 Aiven 赞助,并参考了其[公开教程](https://aiven.io/developer/find-faces-with-pgvector)。配套的 [Colab 笔记本](https://colab.research.google.com/drive/19ulJqMQqk4PfcTx1v3C3cxjvzokrKgZS?usp=sharing)包含演示内容。
这个例子组合了现有的预训练组件,并非从零训练人脸识别模型。OpenCV 检测候选人脸;图像嵌入模型对裁剪图编码;pgvector 根据与查询图像的距离对存储的向量排序。结果是相似度排名,而非经过验证的身份。
为了介绍向量,Berman 用二进制指标表示单词是否出现,比较“I love parks”和“I love croissants”两个句子。它们有两个相同的词,第三个词不同。这是用词袋法直观展示数值比较的简单例子,并不意味着现代学习型图像嵌入一定按这种方式构建。
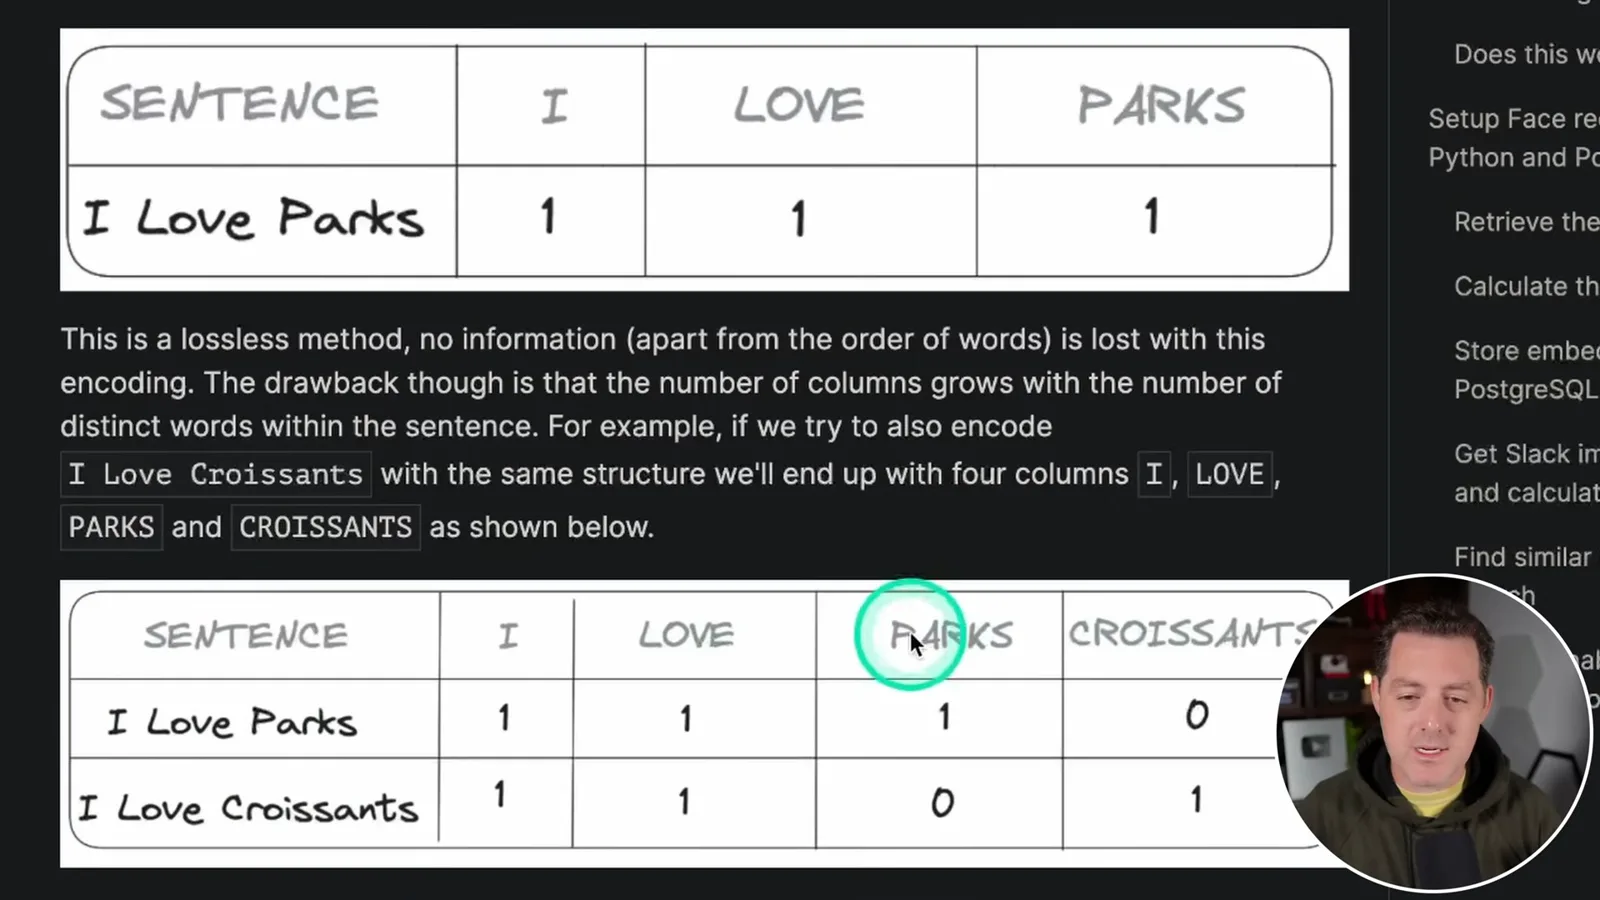
向量之间的距离提供了按相似度排列项目的方法。实际图像流程使用的是视觉内容的学习型表示,而非那四个表示单词是否出现的标记。相似度取决于模型、预处理和距离度量;简短的向量说明只能帮助直观理解这项技术。
检测合照中的人脸
Colab 笔记本加载 Haar 级联分类器并裁剪检测到的人脸。检测参数会影响生成的图像。
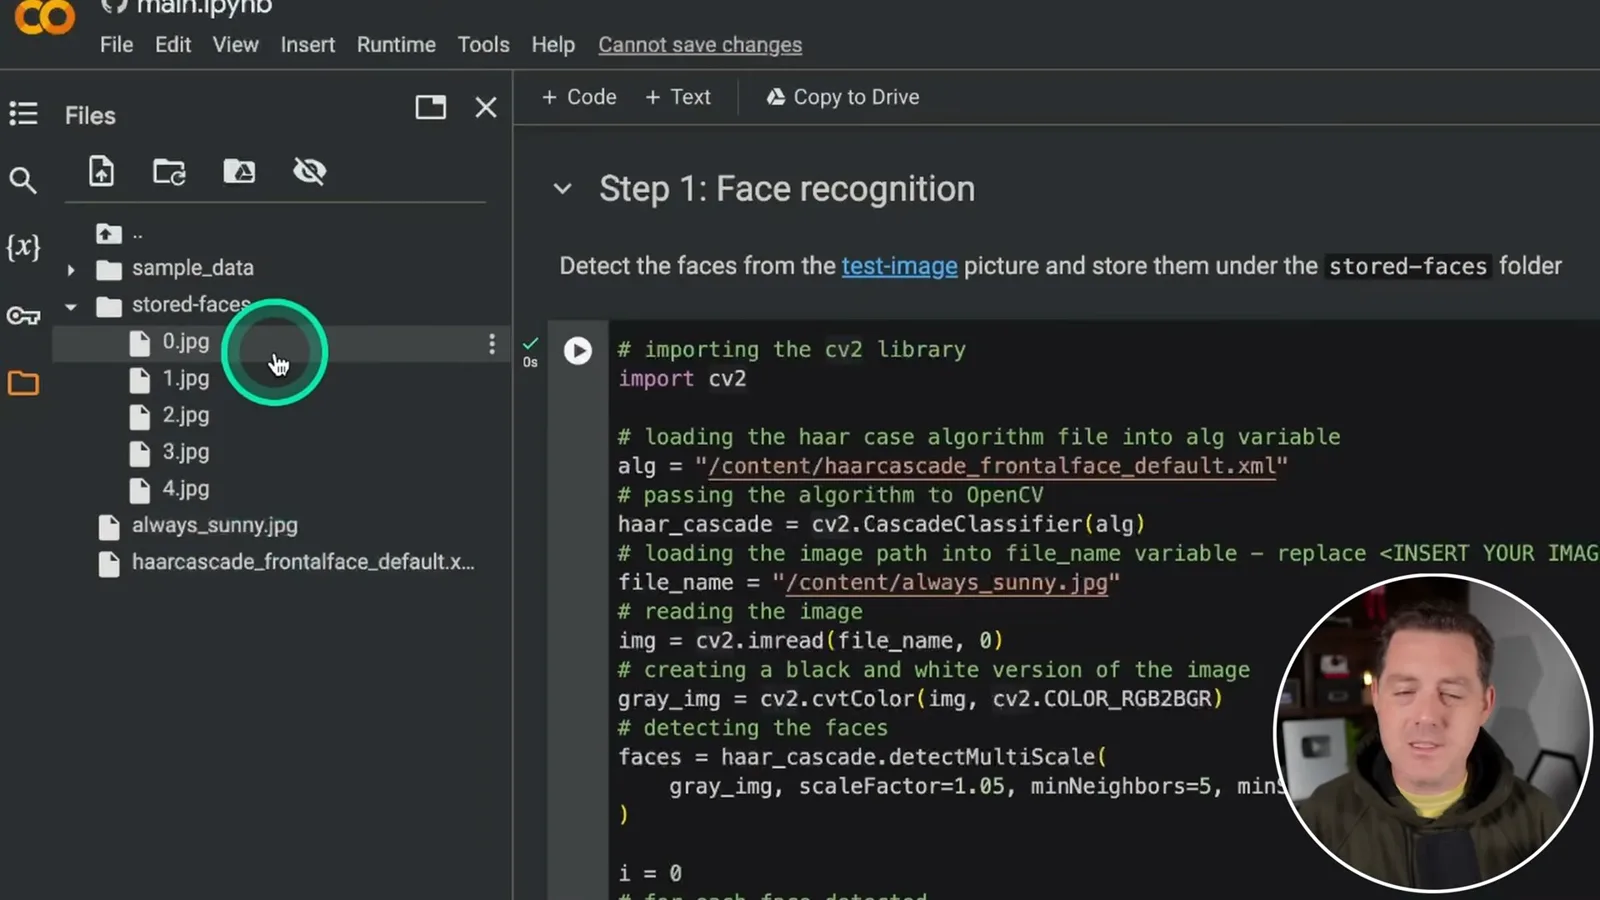
在 Colab 中,Berman 安装所需库,并加载预训练的 OpenCV Haar 级联分类器来检测正面人脸。他下载 `haarcascade_frontalface_default.xml` 分类器,将其上传到笔记本环境并提供文件路径。然后,他上传《费城永远阳光灿烂》演员的合照作为源图像。
笔记本读取图像,准备灰度版本,并调用 `detectMultiScale` 查找人脸矩形区域。演示中,Berman 将 `minNeighbors` 改为 5,最小尺寸设为 100 × 100 像素。OpenCV 将 `minNeighbors` 定义为保留一次检测所需的相邻候选矩形数量,而非附近人数。
代码针对每个检测到的矩形区域裁剪图像,并将 JPEG 文件保存在 `stored-faces` 文件夹中。Berman 先创建该文件夹,重新运行代码单元,得到五张裁剪图。他指出检测并不完美,调整参数会影响结果;后续搜索无法返回漏检的人脸。
PostgreSQL 与嵌入
Berman 创建赞助商 Aiven 提供的服务,启用 pgvector 并存储图像嵌入。凭据和敏感数据需要保护。
下一步使用启用了 pgvector 扩展的 PostgreSQL 数据库。赞助商 Aiven 在演示中提供托管服务。Berman 使用当时的试用额度创建项目和 PostgreSQL 服务;试用优惠和价格可能变化,因此不能假设视频中的 2024 年数字仍然有效。
服务运行后,Berman 使用 `psql` 连接,通过 `CREATE EXTENSION vector;` 启用扩展,并创建包含文件名和 768 维向量列的 `pictures` 表。维度与示例的嵌入输出一致。服务 URI 包含凭据,应避免将其放进共享笔记本、日志或截图。
回到 Colab 后,代码加载每张人脸裁剪图,使用 `imgbeddings` 生成图像向量,再将文件名和向量插入 PostgreSQL。Aiven 教程将其嵌入方式描述为基于 OpenAI CLIP 的图像识别。通用图像嵌入本身并不构成经过验证的生物身份识别系统。
用第二张照片搜索
他为另一张照片生成嵌入,并按距离对已存储的裁剪图排序。这个例子成功了一次,但不能证明一般识别准确率。
Berman 上传演员 Charlie Day 的另一张图像作为查询,加载后使用同一工具计算嵌入。存储的裁剪图和查询图必须使用兼容的嵌入,距离比较才有意义。
查询根据向量距离对存储记录排序,并返回距离最近的候选项。在这次演示中,结果对应合照中的同一位演员。原教程通过 pgvector 使用欧氏距离;除非加入合适的拒绝规则,否则即使不存在正确匹配,最近邻排序仍会返回距离最近的项目。
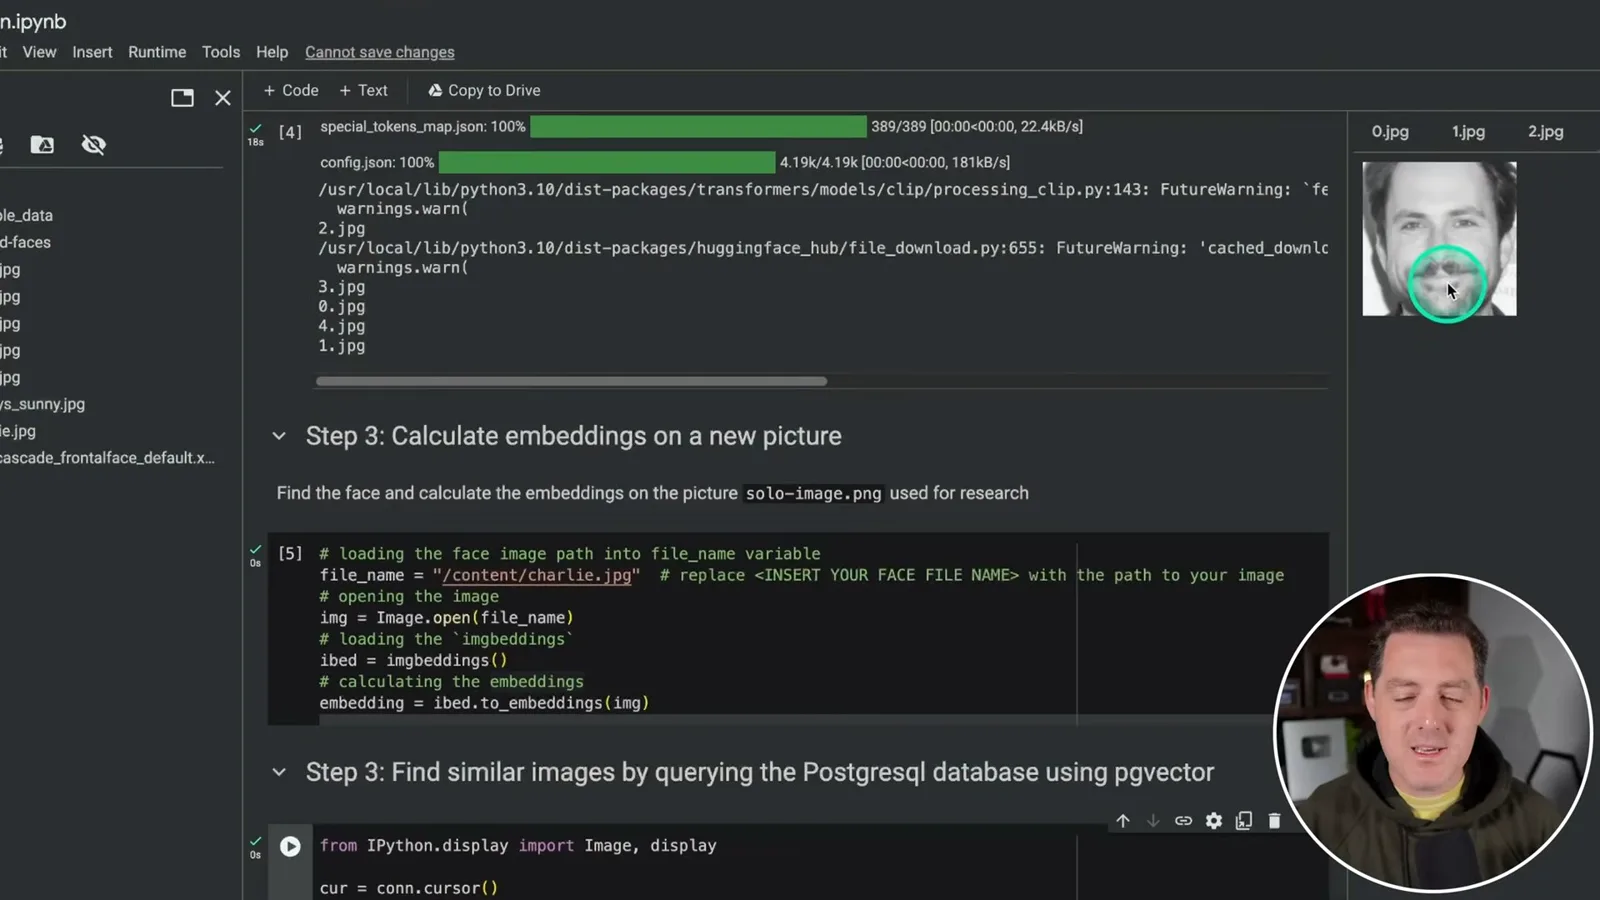
一个小例子中成功匹配一次,并不能证明可靠的准确率、身份验证能力,或在不同光照、姿态和人群中的表现。人脸检测可能漏检或错误定位,图像相似度也可能产生误匹配。在依赖输出结果之前,需要人工审查和具有代表性的评估。
Berman 鼓励观众扩展示例,并感谢 Aiven 赞助视频。他提到了 2024 年的推荐优惠和可用额度;创建服务前应查看当前条款。图像和人脸衍生向量可能涉及敏感信息,因此应在获得适当许可后使用图像、保护访问权限,并在不再需要时删除存储的材料。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。