30 秒看懂
在这期 2024 年 7 月的赞助入门视频中,Matthew Berman 解释检索如何将选定的外部资料加入语言模型的提示。他通过向量数据库流程、汽车手册和多步骤智能体示例说明这一想法。RAG 不要求使用特定供应商或向量数据库,也不能保证准确性;Pinecone 赞助了视频,并是他的频道独家合作伙伴。
- 1检索与微调Berman 区分了添加外部上下文与改变模型行为,尽管微调的用途不止改变语气。
- 2上下文预算模型的 token 预算有限;历史模型的例子说明为什么反复插入整个文档集合可能代价高昂。
- 3相关段落可以为近期财报建立索引,针对问题检索相关段落,而不是每次都加入全文。
- 4嵌入与检索模型将文本转换为数值向量;查询也可以转换成嵌入,并与已索引的段落匹配。
- 5多步骤搜索示例中的智能体先搜索 Apple Remote,再搜索 Front Row,以回答一个多跳问题。
- 6供应商与替代方案Pinecone 提供向量存储和搜索,但搜索也可以使用词法或结构化方法,性能取决于具体实现。
要点建议
- RAG 在生成时检索外部信息并向模型提供选定的上下文,不一定会改变模型权重。
- 上下文限制和重复输入的成本可能使每次提示都包含完整文档集合变得不切实际。
- 嵌入和向量相似度是一种检索策略;关键词、结构化和混合搜索也是可行方法。
- 微调可以改变风格或任务行为,也可以编码知识,但不能可靠地取代持续维护的外部来源。
- 检索到的资料可能不相关、过时或被误用,因此 RAG 可以减少幻觉,但不能消除幻觉。
- Pinecone 是赞助商,也是向量数据库的一种选择,并非 RAG 的必要条件。
按章节阅读整理后的全文
RAG 带来什么
Berman 对比外部检索和微调,并讨论有限的上下文窗口。他披露了 Pinecone 的赞助。
我想解释检索增强生成,即 RAG,以及它为什么能帮助应用使用外部信息。Pinecone 赞助本视频,也是我的频道独家合作伙伴;它的向量数据库是我所描述流程中使用的一种产品,而不是 RAG 的必要条件。
人们常认为微调是将文档加入模型的直接方法。我认为,提供不断变化的信息时,检索往往更合适。我说的“十次中有九次”是个人经验法则,而非实测结果;微调不止可以改变语气,也能影响知识和任务表现。
RAG 检索相关的外部资料,并将其加入回答问题所用的上下文。它可以让应用访问存储的信息或对话历史,但模型权重不会因此自动更新,可靠的长期记忆需要实际的存储和检索设计。
模型无法自动知道训练截止日期之后发生的一切。你可以直接在提示中加入新信息,但反复发送大量资料可能效率低下;检索是挑选较少相关材料的一种方法。
上下文窗口是模型输入和输出的 token 预算,确切限制及计算方式取决于模型和界面。我引用初版 Llama 3 约 8000 个 token 和 GPT-4o 约 12.8 万个 token,作为 2024 年的例子,而非当前限制或所有版本的限制。
即使窗口很大,反复发送大量上下文也可能带来成本和延迟。检索同样有索引和搜索成本,因此是否节省金钱或时间取决于工作负载和实现方式。
对话历史与公司文档
他讨论客服记忆、私有文档和近期财报。检索可以选择段落并将其加入提示。
设想一个需要使用历史对话的客服助手。每轮都发送完整历史最终会占用大量可用上下文,而只有部分先前对话可能与当前问题有关。检索系统可以选择相关记录,同时需要遵守隐私、保留期限和访问控制要求。
私有公司文档也存在同样问题。通用模型可能没有使用这些文档训练,而在每次提示中加入所有文档,在规模扩大后并不现实。经过授权的检索层可以找到相关段落,而不必每次发送整个文档集合。
考虑一份晚于模型训练信息的 Tesla 新财报。应用可以为报告建立索引,检索与问题相关的段落,并将其与问题一起加入提示。文档必须确实可用且已建立索引;如果是季度报告,相关文件可能是 10-Q,而非例子中提到的年度 10-K。
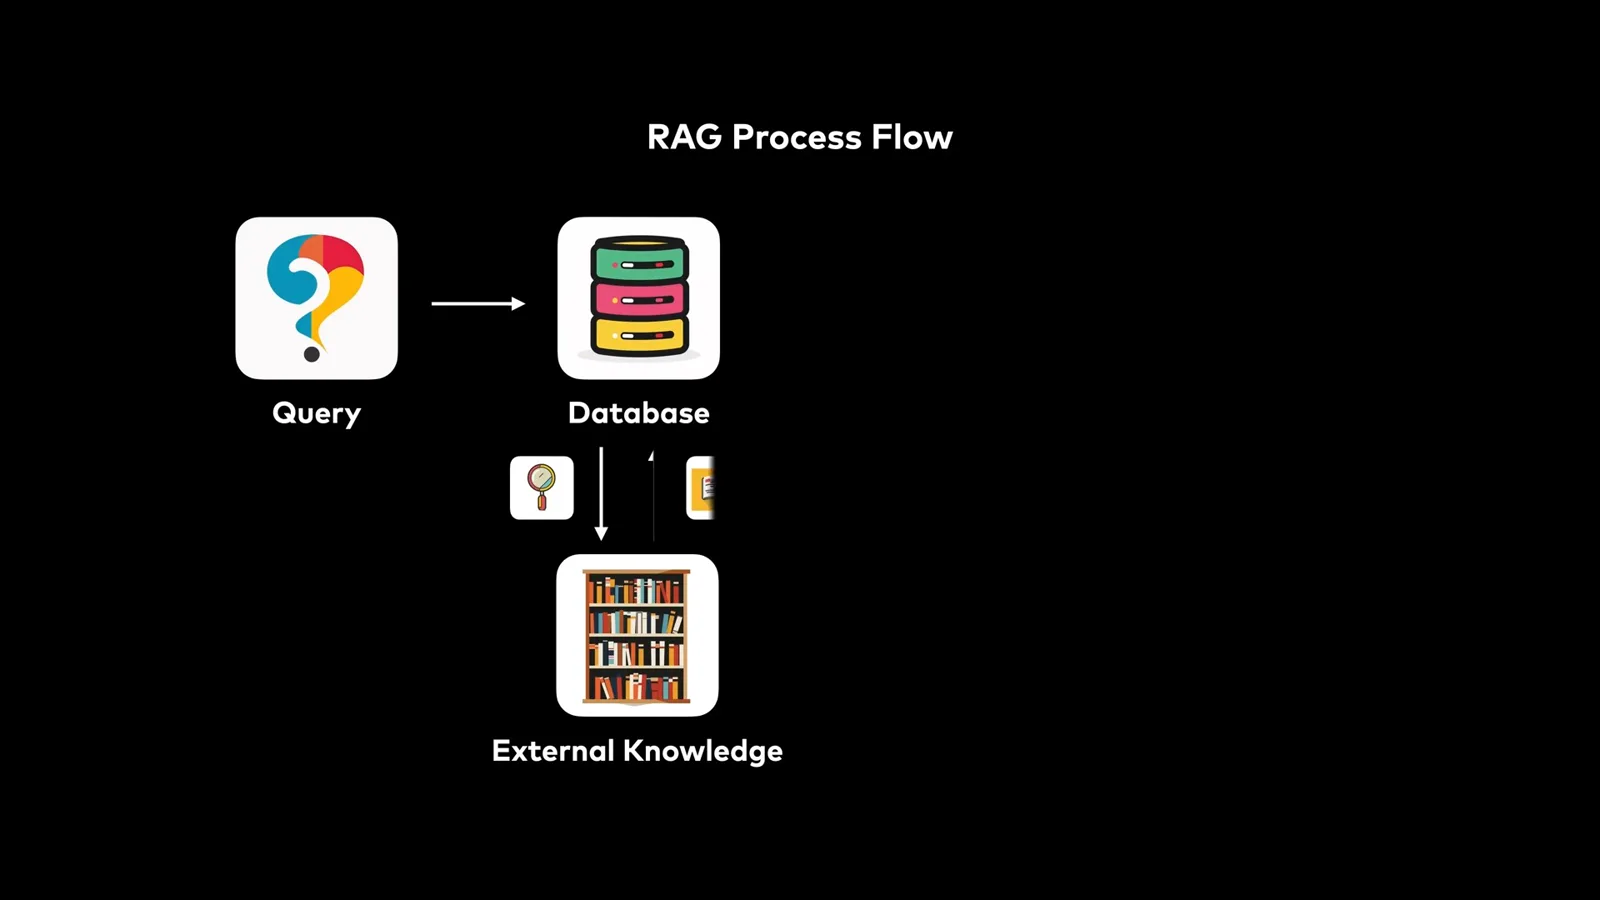
面对多家公司的报告,检索旨在选择所问公司和时期的信息,而不是反复添加所有文件。检索质量和文档时效性很重要:看起来最相近的段落不一定是正确或最新的来源。
从手册到向量搜索
汽车手册示例说明了索引、嵌入和查询时检索。以来源为依据并不能保证正确性。
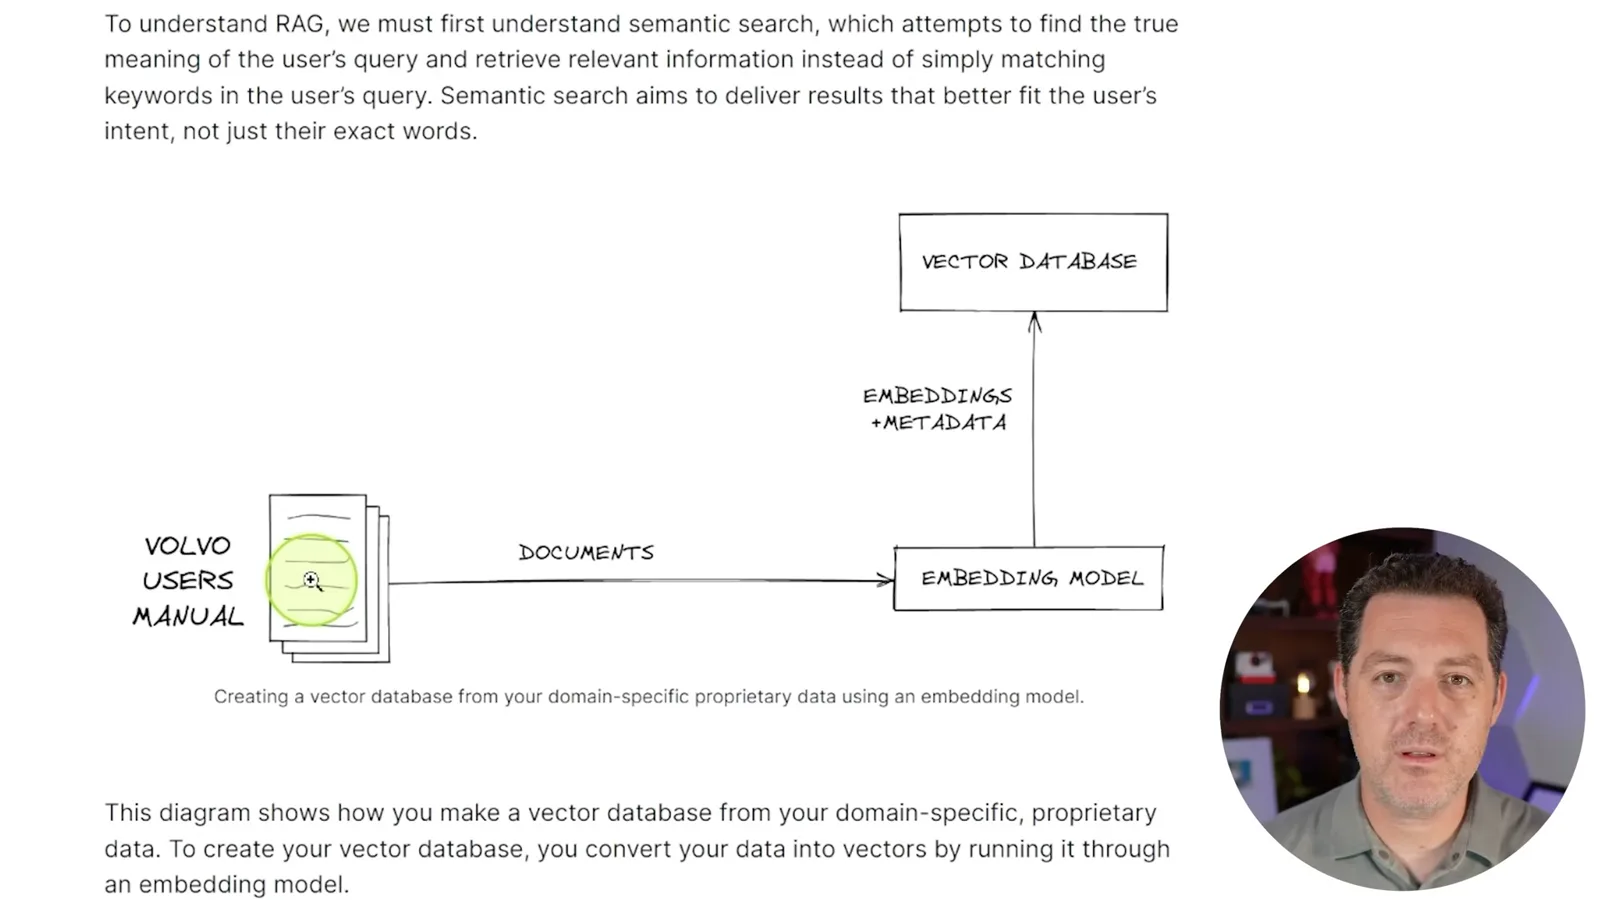
我展示 Pinecone 一个关于 Volvo XC60 手册的提问示例。图示对比了没有依据的答案和使用检索文档生成的答案。没有依据的回答可能产生幻觉,但不一定总是如此;涉及安全功能时,应查阅对应车辆和车型年份的手册。
为了准备图示系统,文档经过嵌入模型处理,并连同元数据存储在向量数据库中。实际实现中,文档通常会被分成段落,原始文本或对它的引用必须保持可用,以便加入提示。
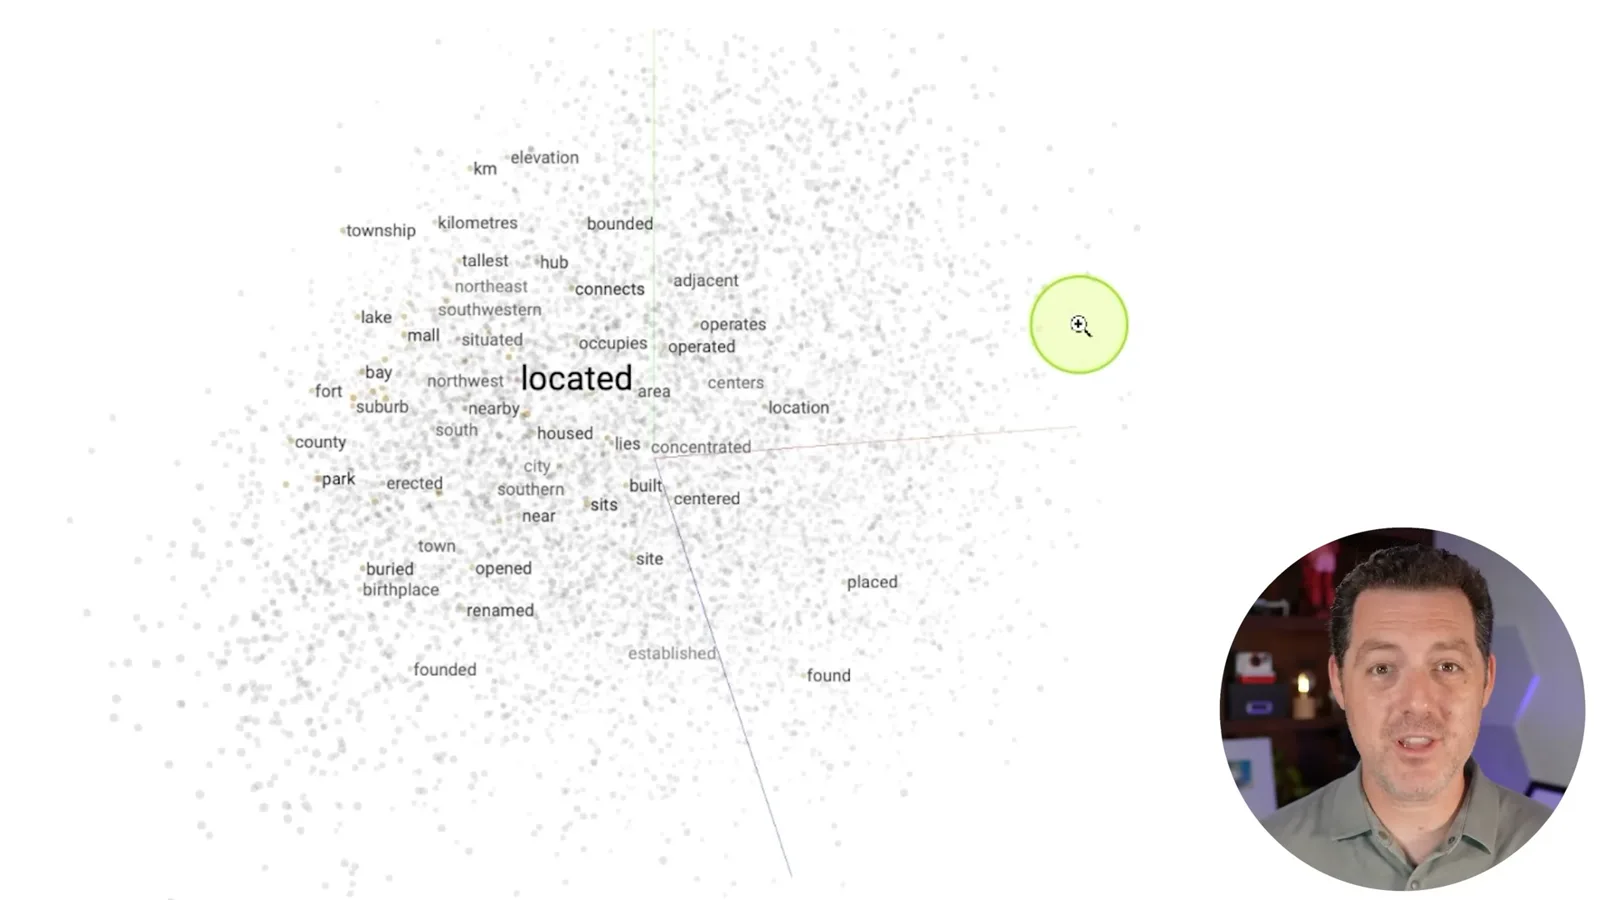
嵌入是表示文本的数值向量。二维图是高维空间的简化表示;嵌入模型和相似度度量决定什么算邻近,而邻近只能不完美地代表相关性或真实性。
查询时,系统将用户问题转换为嵌入,搜索相似的已索引段落,并把选中的上下文与原问题一起发送给语言模型。模型随后可以利用这些段落组织答案,但检索器或生成器仍可能出错。
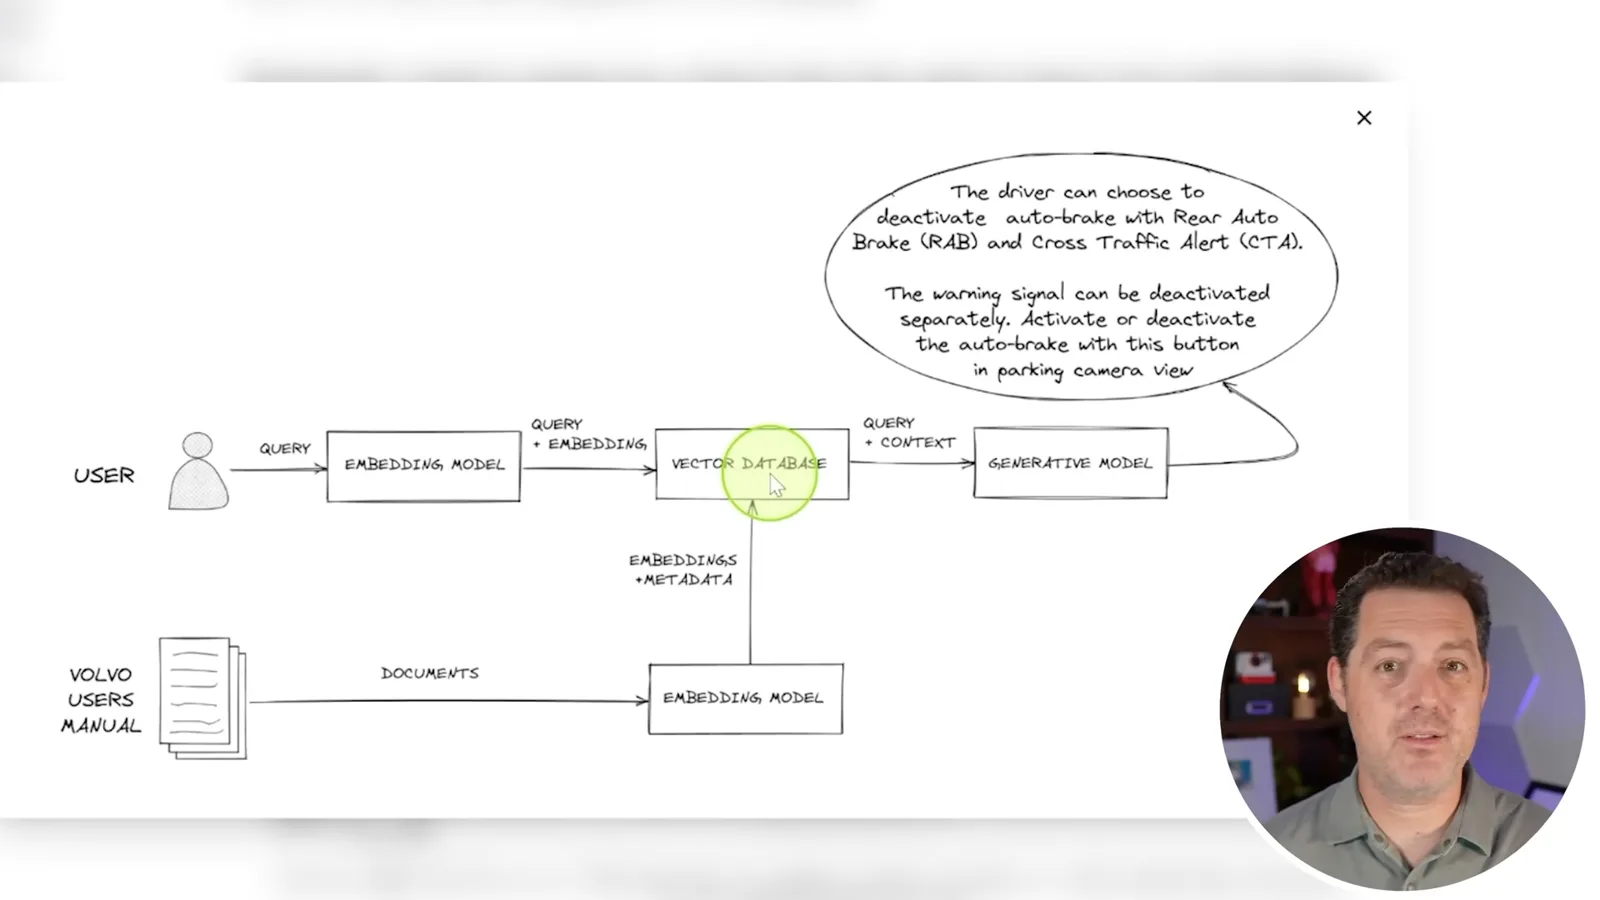
手册示例说明,以来源为依据可能减少缺乏支持的回答;它不能证明 RAG 消除幻觉或保证指令准确。检索段落可能不完整、具有误导性或已经过时,模型也可能误解它们。
智能体与实现
多步骤搜索示例和向量数据库概览展示了检索如何支持应用。主持人重点介绍赞助商 Pinecone。
接着我展示一个涉及 Apple Remote 的多步骤示例。图示中,直接询问模型得到的答案是 iPod;基于搜索的流程先查询遥控器,确定 Front Row,再搜索另一种控制方法,得到键盘功能键。这些步骤只说明一个特定例子,并不保证智能体普遍可靠。
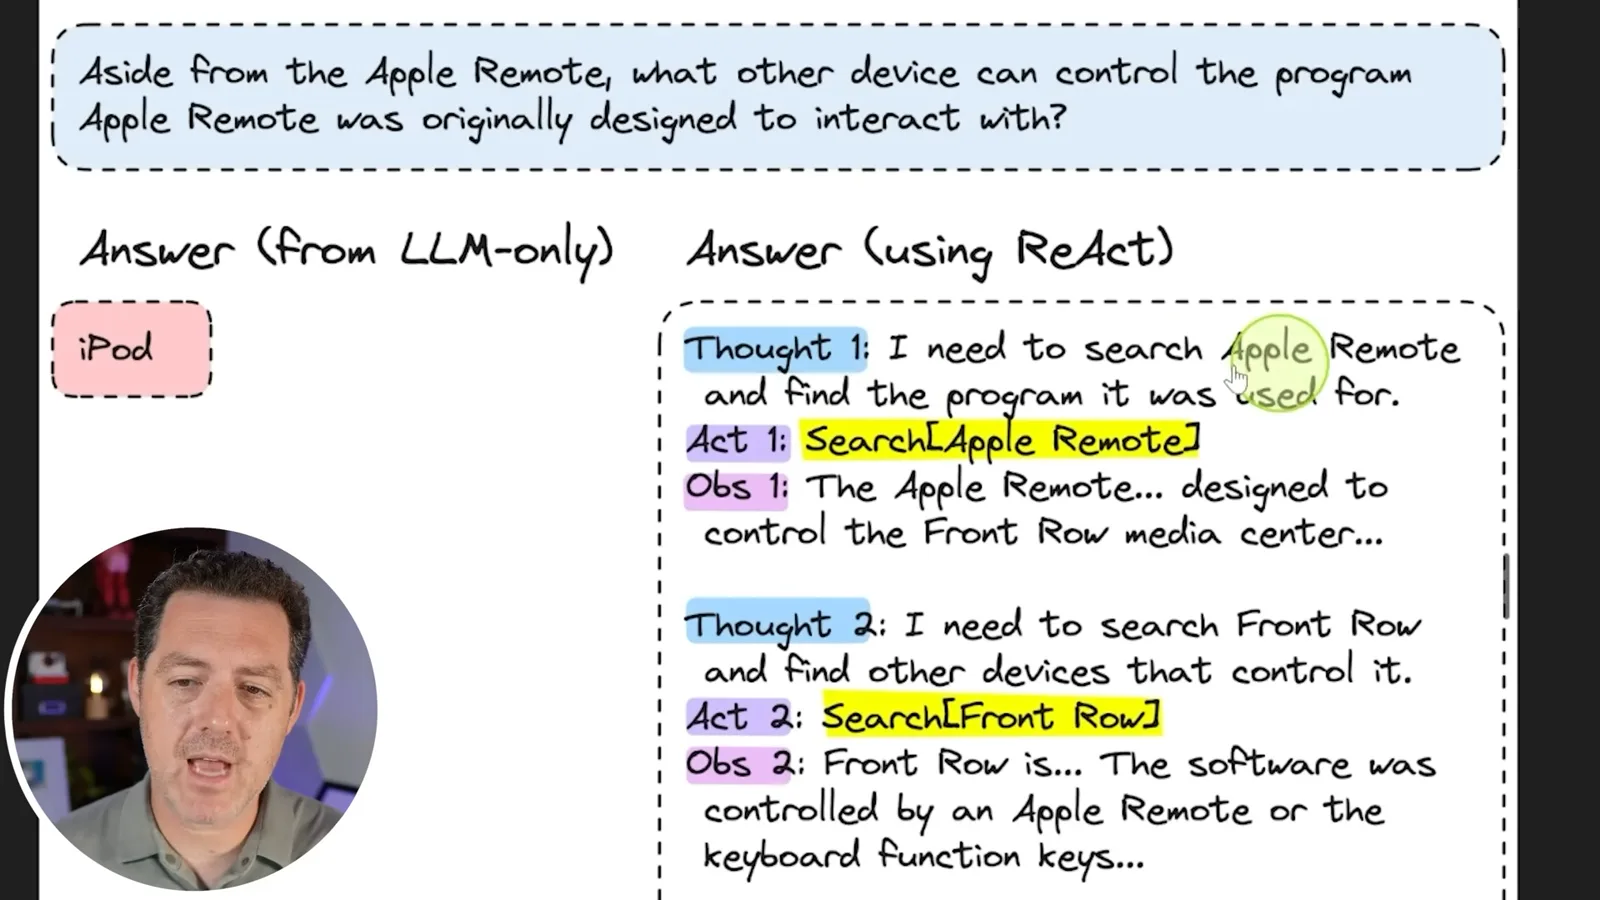
推理和搜索步骤可以通过不同方式组织,包括由一个智能体多次调用工具;每一步不一定是一个独立智能体。此类流程可以迭代检索和合并来源,但仍需要验证结果。
Pinecone 可以大规模存储和搜索高维向量,我称它速度很快。这些是与赞助商有关的产品说法:实际延迟、成本和容量取决于配置和工作负载。向量数据库是一种选择,而非 RAG 的必要条件。
我将向量相似度搜索与普通搜索作比较。许多搜索系统除了嵌入,还使用词法匹配、结构化查询或混合方法;并非所有搜索都依靠向量空间中的邻近程度,邻近本身也不能保证相关性。
基本实现包括为文档创建嵌入,将其与相关数据一起存储,为查询创建嵌入,再检索匹配的上下文。Pinecone 提供一种托管实现;团队仍需选择模型、处理文档更新与权限,并针对自身用途评估检索和答案。
最后,我表示可以制作一份更详细的教程,讲解准备文档、嵌入和 Pinecone 账户,并感谢 Pinecone 赞助视频。这里的核心是检索与生成的工作流程,其实际质量取决于来源和评估。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。