30 秒看懂
Matthew Berman 阅读 GPT-4 的发布声明,考察 Duolingo 和 Be My Eyes 的早期示例,随后使用几个提示词并排测试 GPT-4 和 GPT-3.5。他发现新模型在一道逻辑题上有所改善,并比较了两者对越狱尝试的回答。本文纠正了 OpenAI 所称 82% 安全指标的方向,并结合具体条件解读考试成绩和非正式测试。
- 1日程安排比较发布示例显示 GPT-4 找到了共同可用的时间,而较旧模型的回答未能满足条件。
- 2考试估计成绩OpenAI 报告了在特定评估条件下,模型在律师资格考试和生物奥赛中估计达到的百分位。
- 3纠正安全声明所公布的 82% 是相对于 GPT-3.5 响应不允许请求的可能性下降幅度,而非绝对响应概率。
- 4逻辑测试在展示的例子中,GPT-4 正确排列了三人的步行速度,而 GPT-3.5 回答错误。
- 5越狱比较Berman 尝试了两个提示词;个别示例并非全面的安全评估。
要点建议
- OpenAI 在 2023 年测试条件下报告了 GPT-4 较高的考试估计百分位,这并不意味着取得专业执照或证明了通用人工智能。
- 在 OpenAI 的内部评估中,与 GPT-3.5 相比,GPT-4 响应不允许请求的可能性相对降低了 82%。
- 在 Berman 的小规模非正式测试中,GPT-4 解出了一道 GPT-3.5 答错的步行速度逻辑题。
- 少量提示词和越狱示例不能确定模型的整体可靠性或安全性。
- 视频中的产品可用性和价格描述的是 2023 年发布时期。
按章节阅读整理后的全文
发布声明与评估
Berman 回顾 OpenAI 的示例、考试估计成绩和安全声明。这些数字都有特定的评估条件。
GPT-4 刚刚发布,我想阅读 OpenAI 的公告,并将它与 GPT-3.5 比较。OpenAI 表示新模型具备更强的通用知识和解决问题能力;我将这些视为发布声明,然后尝试几个例子。
公告展示了涉及三个人日历的日程安排问题。在展示的例子中,较旧模型提出的时间并非所有人都有空,而 GPT-4 找到了共同可用的半小时窗口。这是一个说明性示例,而非全面比较。
OpenAI 还报告了估计考试百分位:GPT-4 在统一律师资格考试中约处于第 90 百分位,具备视觉能力的 GPT-4 在生物奥赛中约处于第 99 百分位;GPT-3.5 的所报告成绩较低。这些是公司测试条件下的基准估计,并非取得专业执照或具备普遍专业能力的证据。
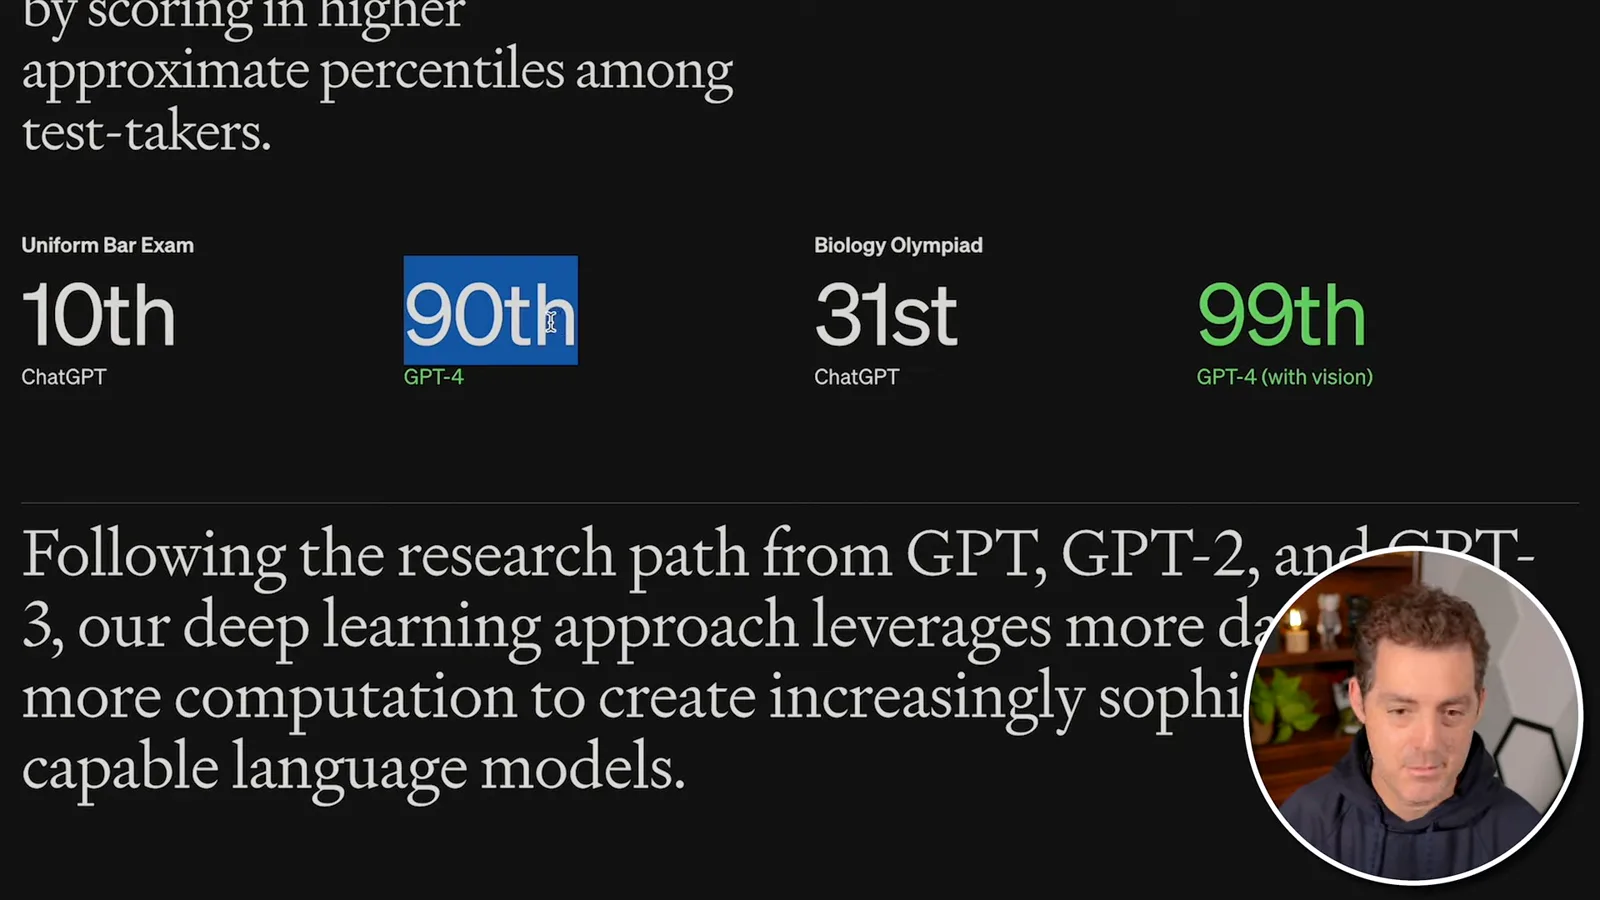
OpenAI 表示,在其内部评估中,与 GPT-3.5 相比,GPT-4 响应不允许请求的可能性降低了 82%,生成事实性回答的可能性提高了 40%。前一个数字是相对下降幅度,而非 82% 的响应概率。公司还介绍了人类反馈及 50 多位专家提供的意见。
早期应用
他讨论 Duolingo、Be My Eyes 的示例和其他发布合作伙伴。
我回顾早期集成。Duolingo 介绍了付费语言学习服务中的角色扮演和答案解释功能。AI 对话伙伴的可能性吸引我,但产品公告本身不能证明学习效果。
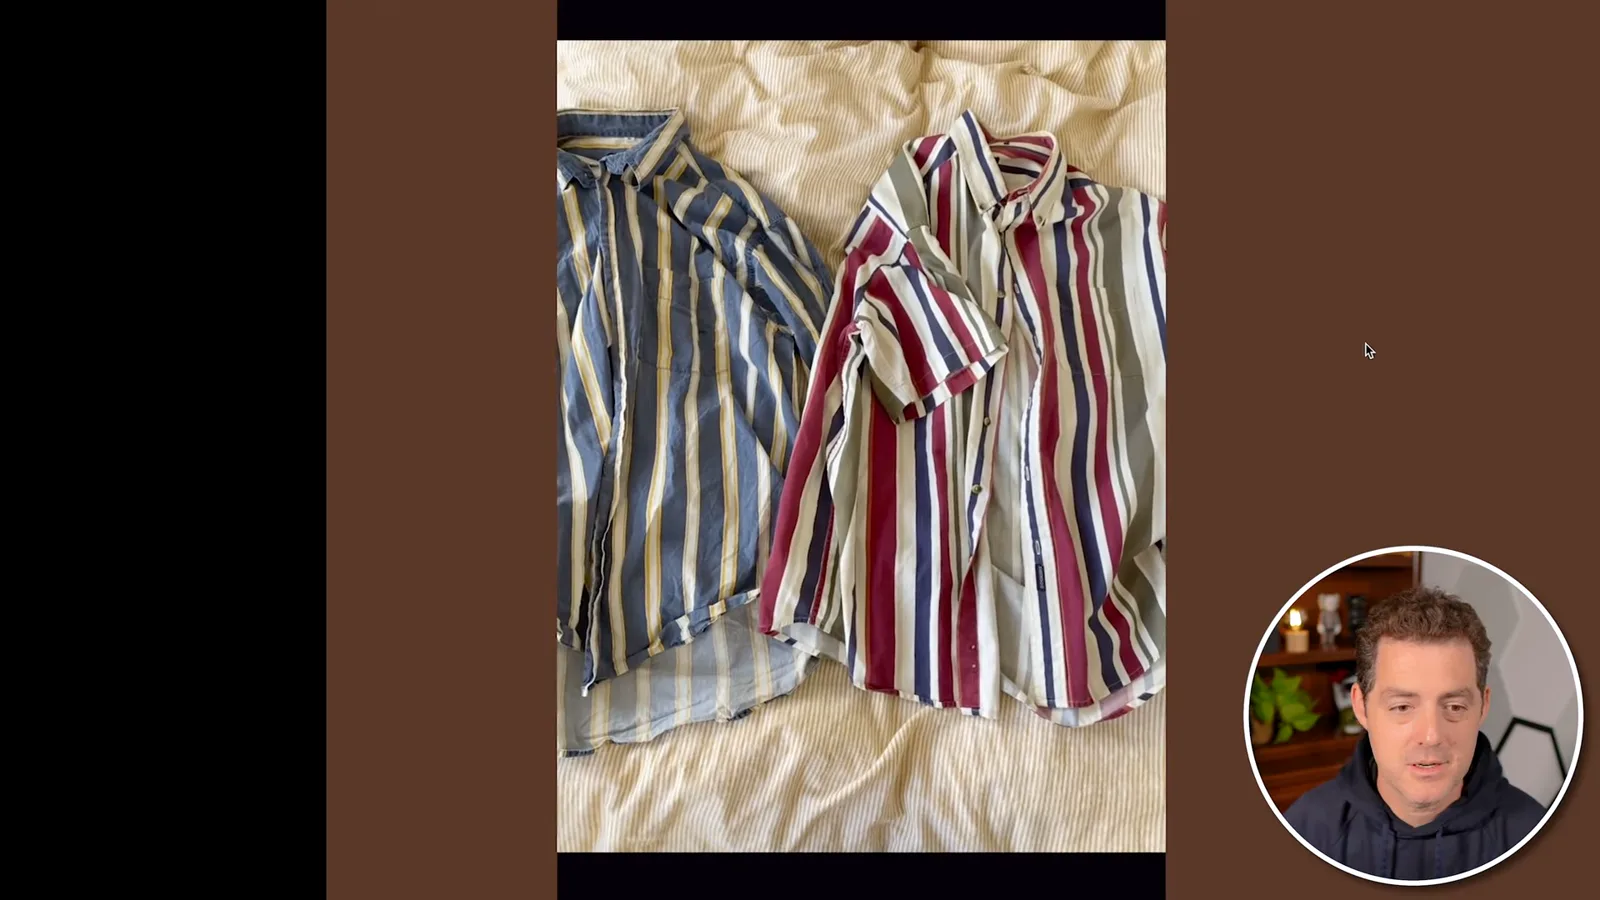
Be My Eyes 展示了一个视觉辅助示例:用户询问两件衬衫中哪件有红色条纹,GPT-4 指出了其中一件。该公司通常将盲人用户与人类志愿者联系起来;这个例子展示了一种可能的自动化辅助,并不保证图像描述始终正确。
并排测试
Berman 测试推理、越狱提示词和旅行规划。少量示例具有说明性,但不能证明通用人工智能已经实现。
OpenAI 列出的其他合作伙伴包括 Stripe、Morgan Stanley、Khan Academy 和冰岛政府。接着我在 ChatGPT 中并排打开 GPT-4 和 GPT-3.5。当时,这项演示中的 GPT-4 访问需要 ChatGPT Plus;可用性和价格可能变化。
在最初的比较中,两个模型都报告其知识截止于 2021 年 9 月。我尝试一个数列问题,两者都给出了相同的正确答案。这只是小规模非正式测试,并非统计评估。
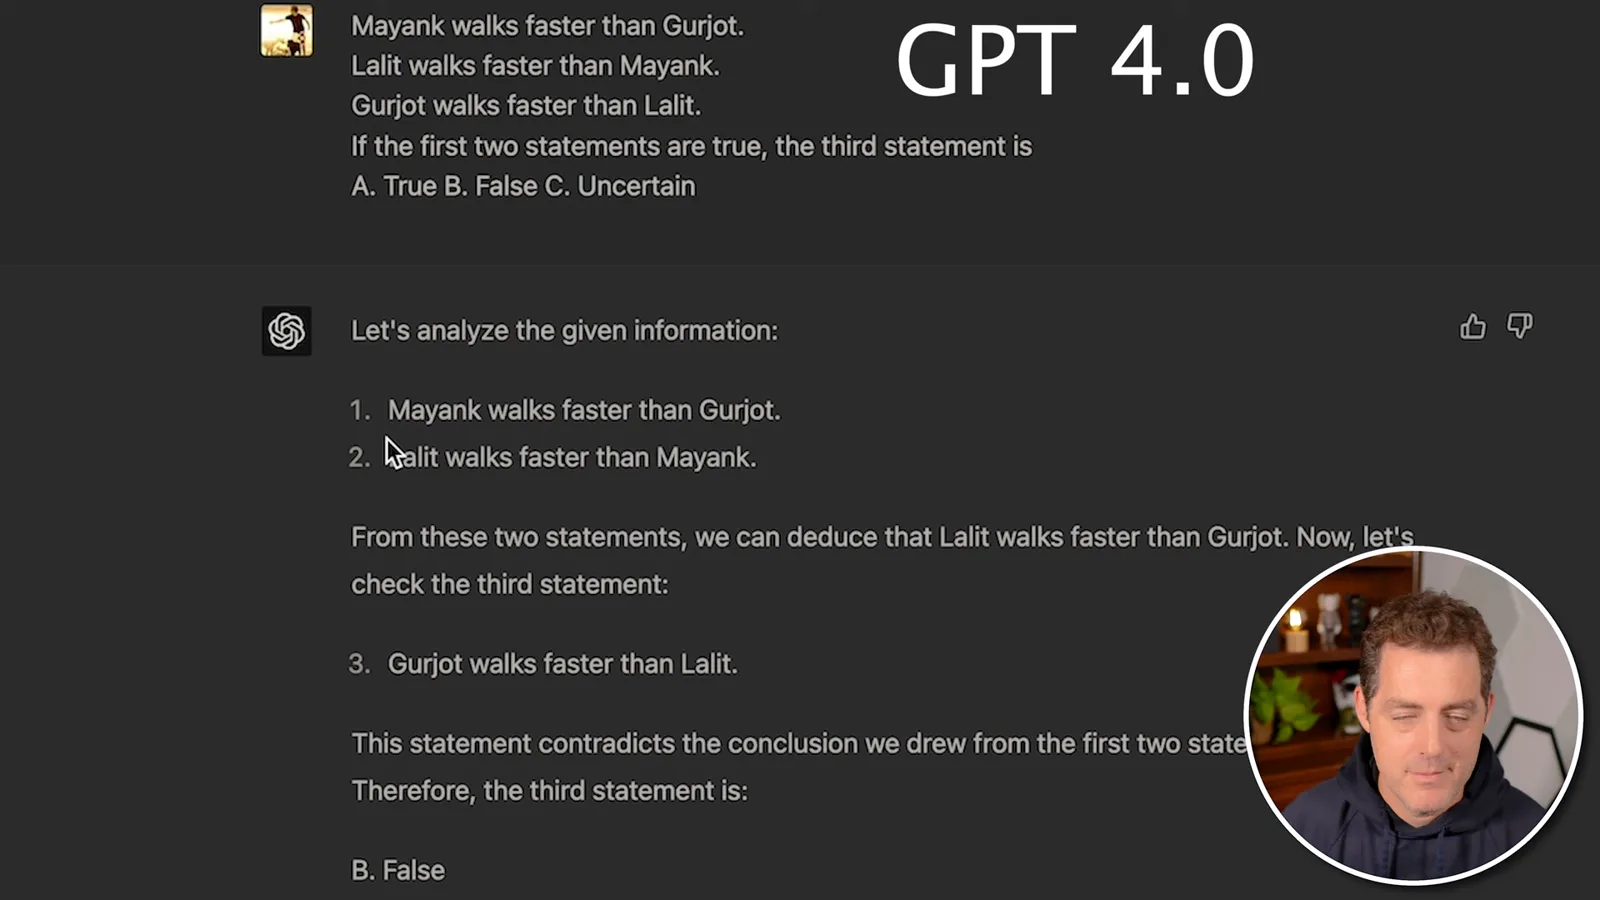
第二道逻辑题中,Mayank 比 Gurjot 走得快,Lalit 比 Mayank 走得快。因此“Gurjot 比 Lalit 走得快”这一说法是错误的。在展示的例子中,GPT-3.5 回答错误,GPT-4 回答正确。
接下来我用涉及不法行为的请求比较越狱提示词。两个模型都展示了常规拒答,但在其他角色设定下的回答有所不同。这些个别回答说明措辞可以影响行为;它们不能确定模型的整体安全性,也不能可靠衡量抵抗越狱的能力。
我尝试了另一个越狱提示词,观察到两个回答尽管有警告和虚构设定,仍提供了不当内容。少数尝试只是个案,不应与 OpenAI 报告的内部评估结果混淆。
ChatGPT 界面用不同指标展示模型能力和速度。界面中可见的标签描述的是简洁程度,并非对意识的测量。随后我测试一个旅行规划问题:从美国西海岸飞往欧洲,途中在东海岸停留。
两个回答都建议搜索并比较多城市行程,而非给出唯一确定路线。我认为两者大致相似,其中一个更简洁。我计划进一步测试 GPT-4;这组简短示例不能证明通用人工智能已经实现,也不能证明它在各项任务中都可靠。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。