30 秒看懂
2025 年 3 月,Matthew Berman 测试 Inception 的 Mercury Coder 交互平台,讨论扩散语言模型、编程速度及其潜在应用。所报告的数据取决于模型、硬件和工作负载;生成更快本身不能证明推理更好或成本降低十倍。Mercury 之前已有扩散语言模型研究。视频包含 GrowthSchool 赞助内容。
- 1从粗到细的生成Berman 比较了逐步自回归解码与迭代式并行细化。文本扩散与图像扩散类似,但处理的是离散文本表示。
- 2理解速度的条件Inception 报告称,在指定配置下,模型在 H100 上每秒输出超过 1000 个 token;这并不保证所有 Mercury 版本或任务都能达到这一速度。
- 3交互平台演示主持人尝试了粒子动画、二元语法模型和贪吃蛇示例;这些简单演示不能评估生产环境中的可靠性。
- 4速度与质量展示的 Artificial Analysis 图表比较了 2025 年初特定模型和任务,Mini 与 Small 的速度及得分各不相同。
- 5推理能力主张需要测试迭代细化本身不能证明它比自回归模型产生更少幻觉或具备更强推理能力。
- 6更早的扩散研究视频发布前,LLaDA 已是经过训练的 8B 扩散语言模型,并发布了研究代码;这与早期论文没有可用模型的说法相反。
要点建议
- 扩散语言模型可以迭代细化多个文本位置,而传统自回归解码逐个生成 token。
- Inception 报告称,在其指定配置下,Mercury Coder 在 NVIDIA H100 硬件上每秒输出超过 1000 个 token;速度因模型和工作负载而异。
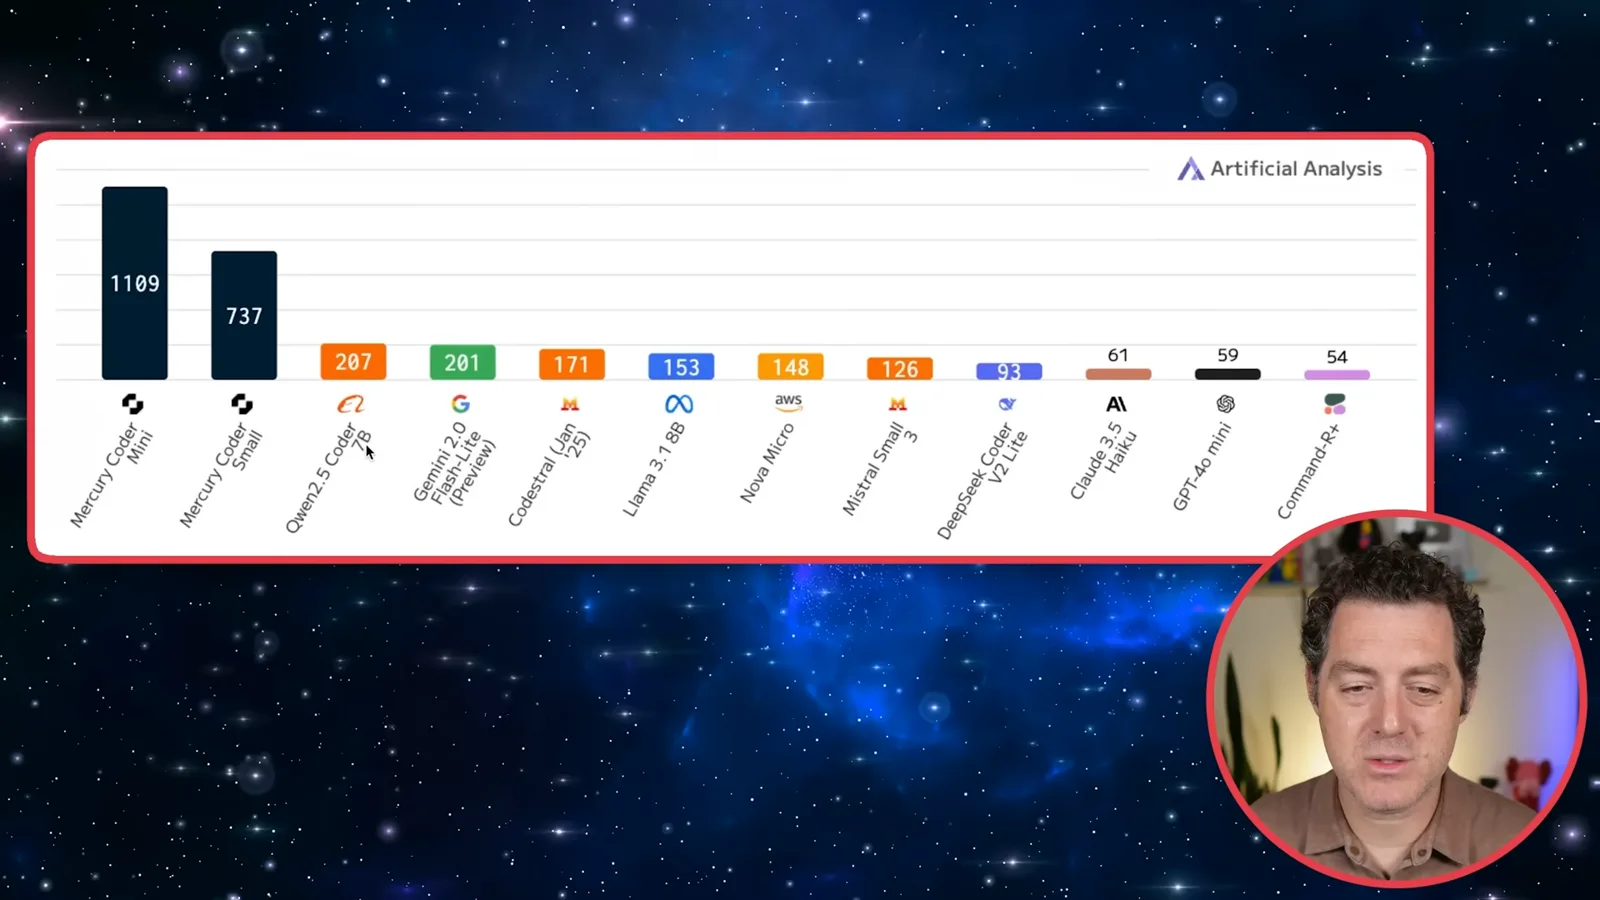
- 展示的历史图表显示,Mercury Coder Mini 每秒约输出 1109 个 token,Small 约输出 737 个。
- 快速演示或一项基准比较不能证明普遍适用的编程质量、更低的幻觉率或端到端成本降低十倍。
- 在 Mercury 商业规模发布之前,2025 年的 LLaDA 论文已经描述了一个经过训练的扩散语言模型。
- 视频提到的本地设备和测试时计算收益只是有待实现和测量的可能性,并非已经展示的成果。
按章节阅读整理后的全文
Mercury 如何生成文本
Berman 介绍扩散并将其与逐步生成作比较。文章对首创及速度方面的说法作出限定。
Inception Labs 推出了 Mercury Coder,一种用于编程、基于扩散的语言模型。我对公司所称的速度以及它不同的生成方式感到兴奋。视频中“全球首个扩散大语言模型”的说法过于宽泛:此前的研究已包括经过训练的扩散语言模型,而 Inception 将 Mercury 称为商业规模的模型。
传统自回归模型通常根据之前的序列生成下一个 token。扩散语言模型则可以从受损或掩码表示出发,经过多个细化步骤更新多个文本位置。这不意味着答案瞬间就正确;不同实现也可能分块生成,而非一次生成整个回复。
我将其与图像扩散作比较:图像扩散通过迭代将噪声转化为图像,而不是逐像素绘制。这个类比有助于说明从粗到细的生成,不过离散文本模型使用的表示和过程与连续图像生成不同。
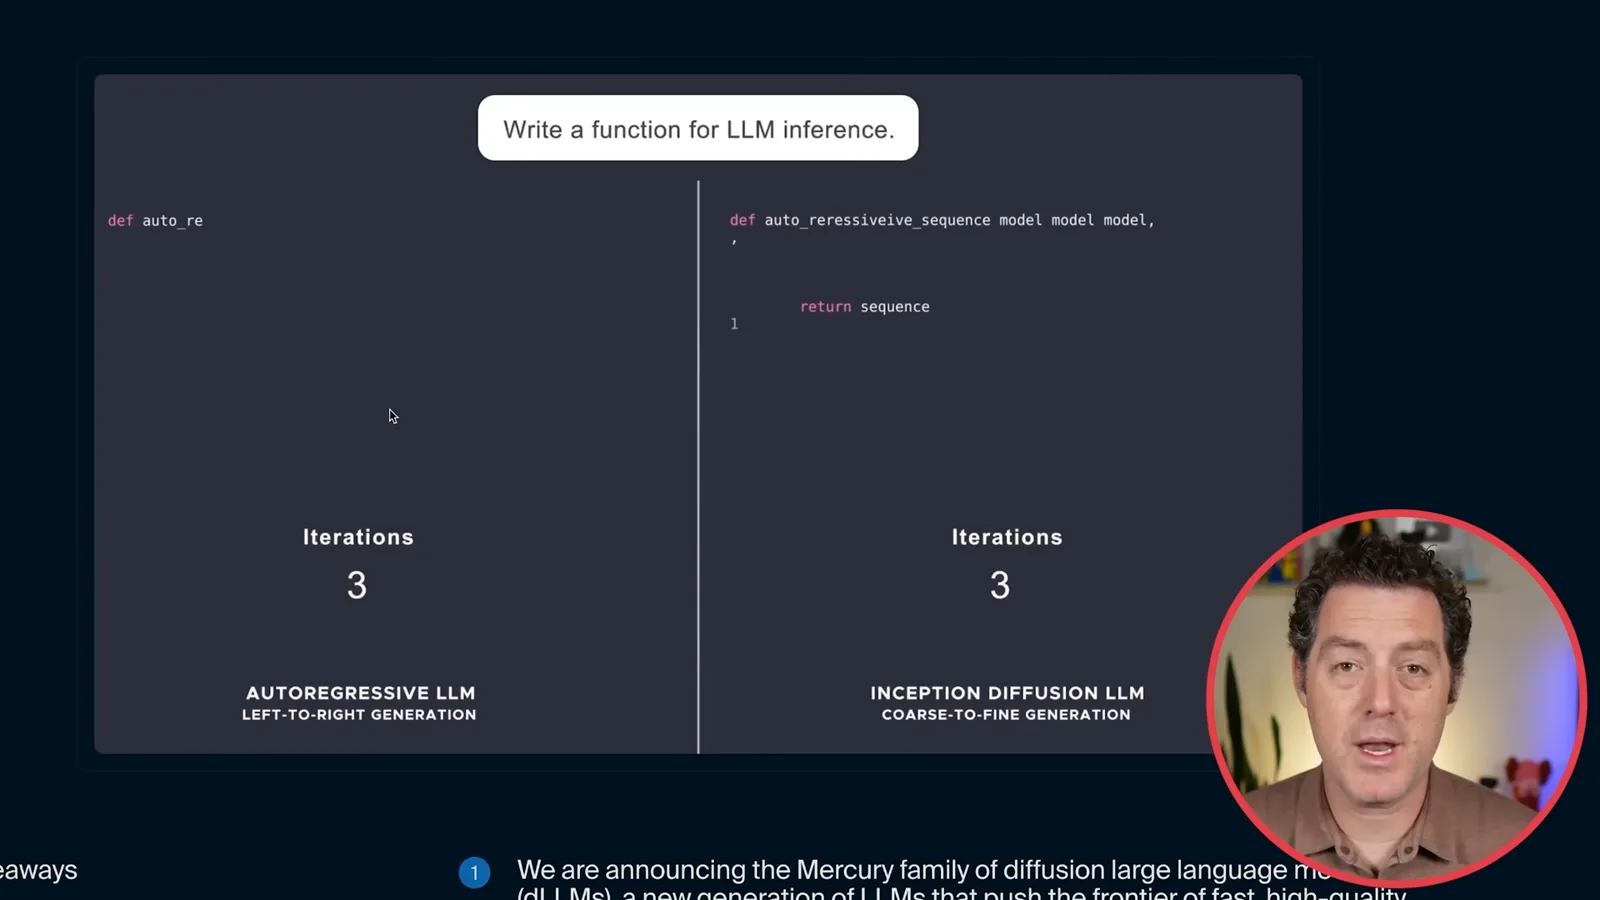
Inception 的动画对比了逐步输出和对代码回复的并行细化。我讨论了图示中的 14 次与 75 次迭代,但那是该示例的属性,并非适用于所有输入或部署的通用比例。公司的说明和动画用于示意,并非独立测量结果。
我认为,更快的生成可能让编程和测试时计算的响应更迅速。但 token 吞吐量只是总延迟的一部分:提示处理、网络、工具调用、模型质量、任务长度和重试都会产生影响。生成更多 token 或增加细化步骤,不会自动带来更好的答案。
Inception 报告称,在其指定配置下,Mercury Coder 在 NVIDIA H100 硬件上每秒输出超过 1000 个 token;公司还称,相比选定的速度优化前沿模型,速度最高可提升 10 倍。H100 是商用加速器,并非为 Mercury 定制的硬件。这些是与历史时点和具体配置相关的比较。
编程演示与赞助
他在交互平台上尝试简单的编程提示。视频包含 GrowthSchool 赞助的培训推广。
在交互平台中,我要求生成跟随鼠标的粒子动画,并提供大小、速度和颜色控制。生成的简单演示能够响应这些控制。随后我请求一个 Python 二元语法模型并查看代码;这两个例子都不能证明其在大型软件项目中的可靠性。
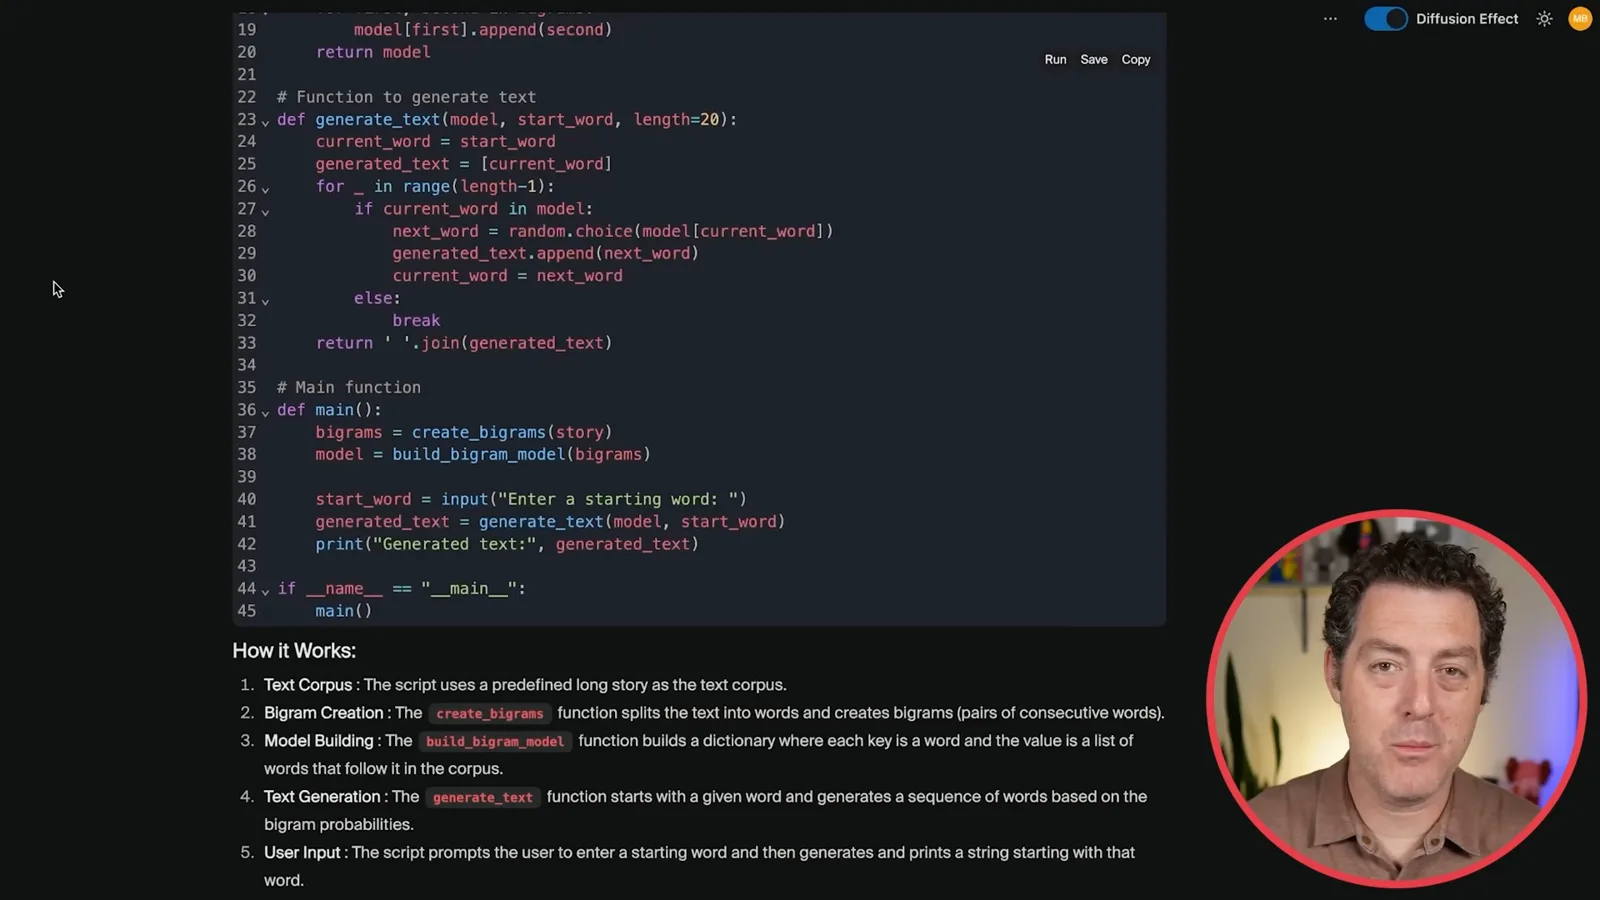
交互平台还提供扩散过程的可视化效果。我放慢一个示例,观察粗糙的文本逐渐变得连贯,并展示一个运行中的简单贪吃蛇游戏。可视化有助于说明这一过程,但仅凭界面无法了解全部内部实现细节,也不能保证每个生成的程序都能运行。
视频包含 GrowthSchool AI 培训的赞助内容。其中关于课程收益、受众覆盖和免费优惠的说法属于宣传,优惠也仅针对视频发布时的情况。
基准测试与潜在应用
Berman 回顾历史速度和编程能力比较,再讨论推理、智能体与边缘设备应用。这些可能性需要针对具体工作负载的证据。
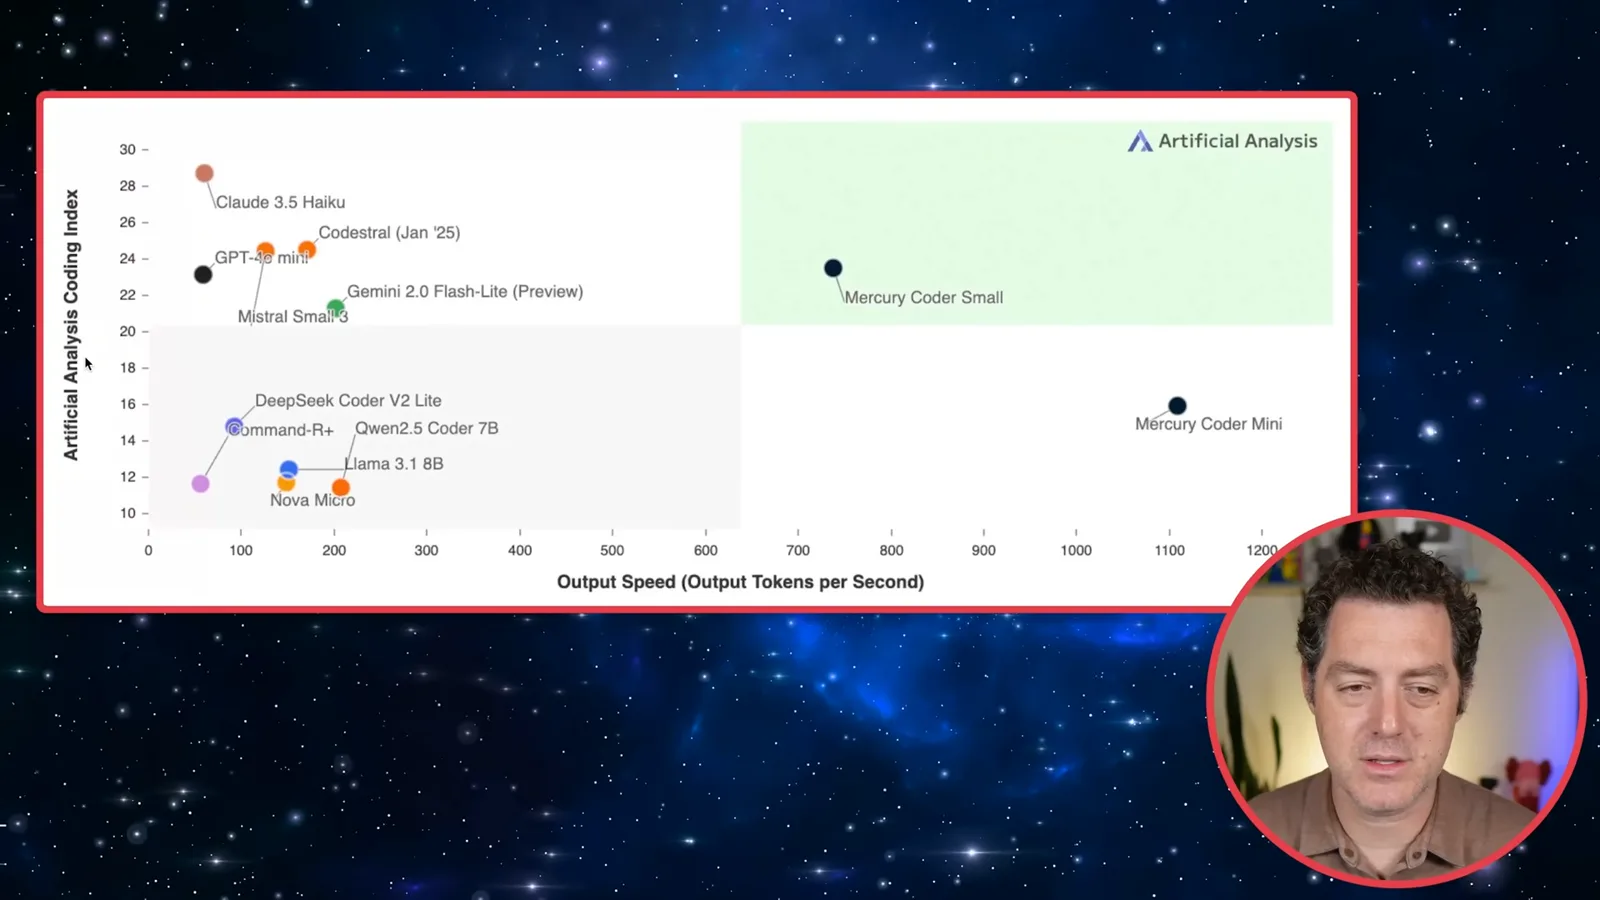
展示的 2025 年初 Artificial Analysis 图表比较了编程得分与输出速度。图中 Mercury Coder Mini 每秒约输出 1109 个 token,Small 约为 737 个;Small 在图表上的位置接近 GPT-4o mini,而 Mini 更接近较小的编程模型。结果适用于该评测方的特定测试和服务条件。
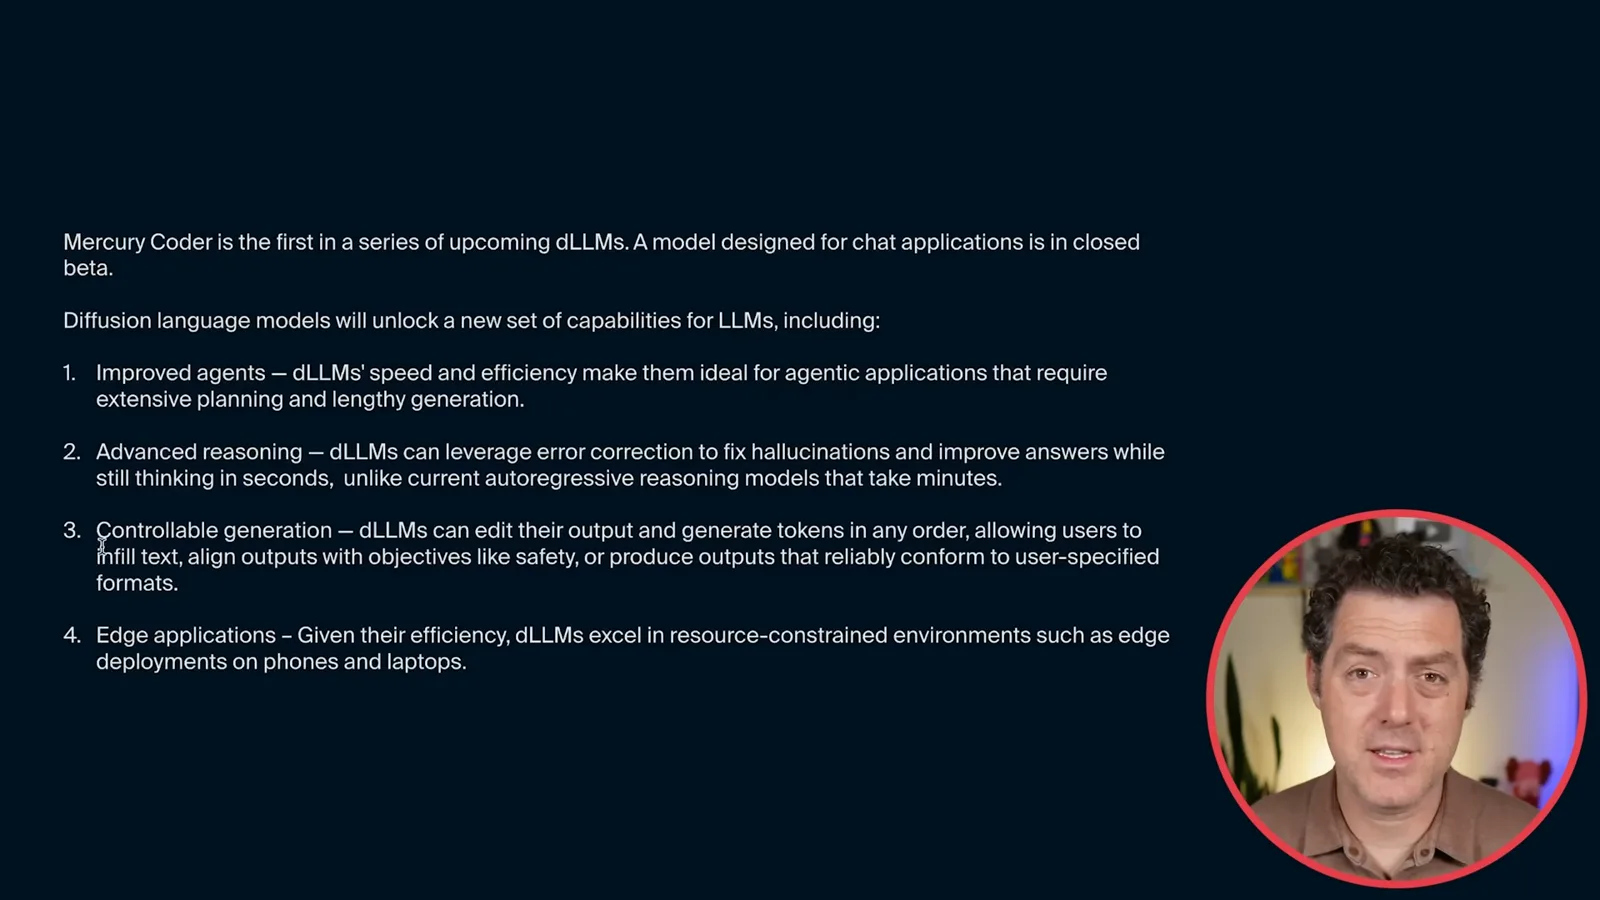
Inception 的演示提出,输出更快可能使模型在固定时间内完成更多测试时计算。我认为这很有前景,但开头声称成本降低十倍,此处没有完整的同等条件价格或单任务成本比较来支撑。更快的模型也可能需要不同的工作量,或产生不同质量的结果。
公司提出,迭代修订有助于组织答案和纠正错误。这是一个合理的研究方向,但不能证明扩散模型天生更擅长推理或能消除幻觉。准确性和纠错能力需要与合适的基线直接比较。
另一项宣传性的速度比较显示,Mercury 完成某个示例的速度快于 Claude 和 ChatGPT。单次演示用时取决于模型版本、提示、输出长度、基础设施和界面条件,不能证明普遍适用的速度比例或回答质量相当。
我考虑了智能体、更长的推理、结构化生成和边缘应用等潜在用途。速度很有价值,但智能体系统还面临工具延迟、可靠性、权限和成本限制。要宣称任务结果更好或能够安全地本地部署,需要测试实际模型和硬件。
研究背景与展望
他引用 Andrej Karpathy 的评论及更早的扩散研究。文章纠正了 LLaDA 没有可用模型的说法。
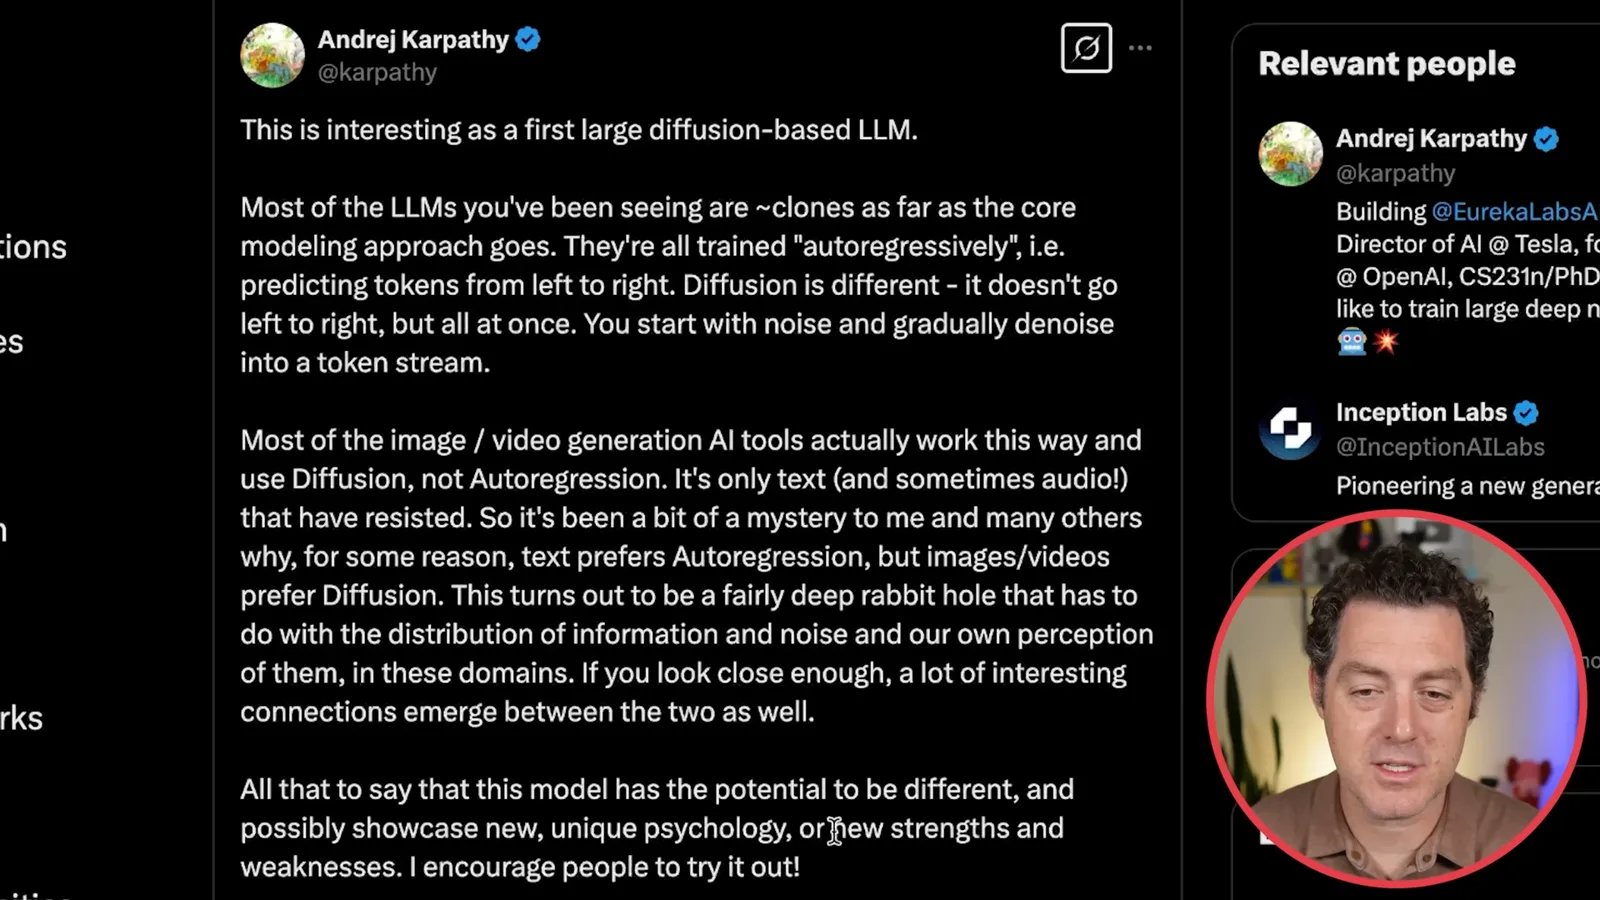
Andrej Karpathy 评论称,扩散方法常见于图像和视频生成,而自回归模型长期主导文本生成。他认为信息、噪声与感知方面的差异可能带来不同的优势和弱点;这是一个研究问题,并非已证明在所有任务中都存在优势。
我提到较早的论文《Large Language Diffusion Models》,但说它没有可用模型。更正:2025 年 2 月的 LLaDA 论文描述了一个从头训练的 80 亿参数模型,并发布了研究代码和项目页面。Mercury 的商业规模发布并不是首个可用的扩散语言模型。
我希望继续在编程工具中测试这一方法。它的价值取决于实测任务质量、延迟、部署要求和成本,而不只是速度。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 21:11EN → 简体中文Matthew Berman· 2026年10月28日Matthew Berman 实测 DeepSeek V4.1 Flash:编程、视觉与本地应用Matthew Berman · Forward Future从视觉编程、图像推理到本地应用和服务商价格,实测既展示了模型的能力,也暴露出明显缺陷。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。