30 秒看懂
Michael Ryan 解释智能体构建者为何需要理解应用底层的语言模型。标准注意力让长上下文成本升高,而替代和混合架构在检索能力上有不同取舍。预填充、解码和键值缓存影响延迟与上下文处理。Ryan 建议检索相关材料、避免不必要的上下文并评估设计,同时提醒压缩可能丢失重要指令。
- 1注意力架构改变长历史的处理成本Ryan 对比全注意力、压缩状态和混合方法。
- 2预填充与解码有不同瓶颈键值缓存避免重复计算,但全注意力的缓存会随上下文增长。
- 3更多上下文不仅增加成本,也可能降低准确率一个长上下文基准展示文档增加时性能下降。
- 4压缩可能丢弃智能体仍需遵守的指令Ryan 讲述一个删除前确认要求丢失的例子。
要点建议
- 采样设置会改变模型选择下一个词元的方式。
- 注意力架构影响长上下文的成本和检索取舍。
- 预填充与解码对推理资源的压力不同;键值缓存影响上下文更新。
- 有意识地检索和测试上下文,并在压缩时保护重要指令。
按章节阅读整理后的全文
语言模型与采样
Ryan 介绍模型技术栈、下一词元概率和解码策略。
斯坦福讲师 Michael Ryan 介绍 CS329Z 的第二讲。他将讲解足够多的语言模型设计知识,帮助学生在模型之上构建智能体。
他把技术栈分为模型工程、模型适配和应用。本课程侧重应用,但当底层影响设计选择时也会涉及底层知识。
目标是把训练和推理中的选择与实际限制联系起来,例如长上下文表现和模型选择。
语言模型为词元序列分配概率。Ryan 把序列概率解释为每个词元在先前词元条件下的概率之积。
实际计算中,通常使用对数概率之和来保持数值稳定。也可以从模型中采样,生成后续文本。
Ryan 对比区分类别的判别模型和建模可能序列分布的生成模型,并指出术语之间的边界有时并不清晰。
生成文本时,模型为词表中的候选项分配概率并选择下一个词元;新词元随后进入下一步的上下文。
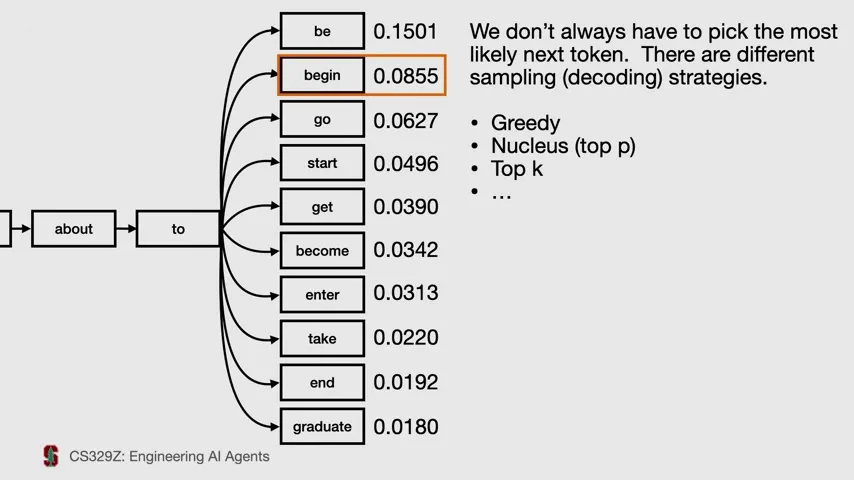
贪心解码总是选择最可能的词元。Top-k 把选择限制在固定数量的候选项内;top-p 选择累计概率达到设定值的一组候选项。
温度会改变采样分布:较低值通常让概率更集中于最可能的选项,较高值则让分布更分散。
束搜索会探索多个候选续写,但需要额外时间和内存。Ryan 说合适的解码策略取决于任务和预算。
在问答中,他解释词元是固定词表中的文本片段,温度也会影响生成的推理。
Transformer 与注意力的取舍
课程解释注意力、序列长度,以及线性和混合变体。
Ryan 简要回顾语言模型的发展史,随后聚焦现代系统常用的仅解码器架构。
词元被映射为向量,并加入位置信息,使模型能够表示顺序。这些表示随后进入注意力层。
注意力层把表示投影为查询、键和值。查询与键之间的分数决定如何组合先前位置的信息。
因果掩码阻止某个位置在训练时使用未来词元,使其与逐个生成文本时可获得的信息一致。
得到的注意力输出经过投影并与残差连接相加。Ryan 回答了有关掩码和位置信息作用的问题。
多头注意力使用不同的学习表示执行多次注意力操作。一个 Transformer 块结合了注意力、前馈组件和残差连接。
标准注意力在训练时允许大量并行,但其注意力计算随序列长度呈平方增长,导致长上下文成本较高。
Ryan 概述线性注意力:它以另一种方式维护压缩状态。在他展示的形式中,其内存占用可以不随序列长度增长。
代价是较早文本的细节必须保存在压缩状态中。他展示的长上下文检索结果中,所示线性模型的退化幅度大于全注意力基线。
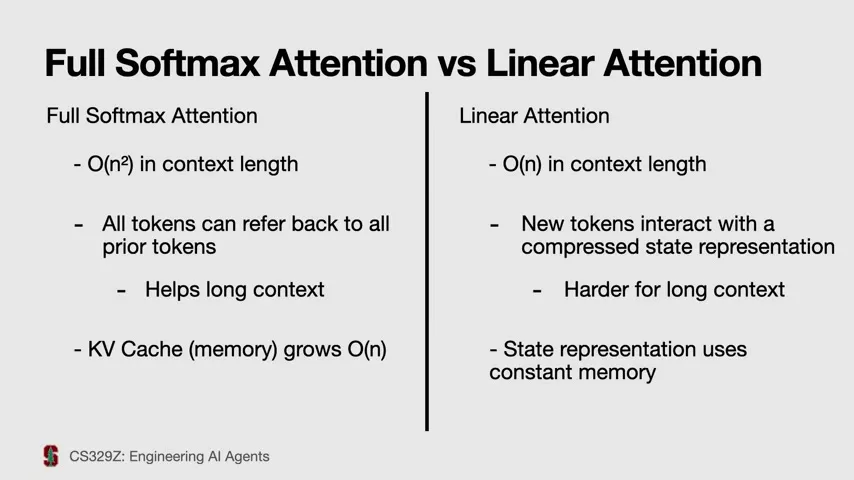
混合架构组合不同注意力类型,在部分层使用全局或局部注意力改善检索,同时在其他层保持效率。
对智能体构建者来说,模型架构很重要,因为长历史和推理效率会影响哪种模型与运行框架适合任务。
训练语言模型和智能体
Ryan 介绍数据准备、指令微调和强化学习。
训练需要损失函数。Ryan 通过下一词元交叉熵说明:模型给实际下一词元的概率越低,受到的惩罚越大。
预训练数据可以从网页开始。流水线提取文本、按语言和质量过滤、去除重复和重复文档,再与其他来源混合。
他展示一个只保留原始材料少部分的过滤流水线。即使经过过滤,训练示例仍覆盖非常广泛的主题。
团队会根据目标调整数据混合比例。Ryan 介绍中间训练或冷却阶段,它可以提高与后续用途相关领域的权重。
监督式指令微调使用提示和期望答案的例子,让模型更像助手那样回应。
人类偏好训练可以比较回答并训练奖励模型,但偏好因人而异,标注也可能不一致。Ryan 还提到激励机制和数据工作者工作条件方面的问题。
可验证奖励强化学习使用答案能够检查的任务,例如代码测试或数学答案,而不只依赖偏好模型。
针对编程智能体,他介绍如何从代码仓库创建环境、引入或还原缺陷,并奖励通过测试的解决方案。
讨论中 Ryan 指出,长上下文扩展和真实感较强的智能体环境可以成为后续训练的一部分。他也讨论了合成数据的潜力和限制。
推理与推理能力
预填充、解码、缓存和额外推理计算会影响成本与延迟。
推理大致有两个阶段:预填充处理提示,解码生成回答。这两个阶段可能受不同硬件资源限制。
Ryan 对比计算吞吐量和内存带宽。预填充可以一起处理许多提示词元,而逐词元解码可能受数据移动速度限制。
键值缓存保存后续词元所需的注意力信息,避免重新计算先前工作;但在全注意力中,其内存占用会随序列增长。
首词元时间是衡量预填充的有用指标;每个输出词元的时间则描述解码。优化一个阶段不会自动优化另一个。
推测解码让小型草稿模型提出多个词元,再由较大模型检查。接受的候选可以减少大模型串行执行的步骤。
推理时扩展指为任务投入更多计算。思维链提示和推理模型可以在答案前生成中间过程,但需要额外成本。
Ryan 介绍推理强度设置,以及在正确性与词元预算之间取舍的训练方法。用户可以选择为任务投入多少计算。
其他策略包括生成多个答案,再使用验证器或多数一致结果。其效果取决于任务和答案检查方式。
结构化输出与上下文工程
最后介绍工具约定、检索、压缩和递归模型。
智能体经常需要结构化输入和输出,使工具与模型调用共享可预测的约定。受约束解码可以把输出限制为 JSON 等指定结构。
Ryan 用 DSPy 举例:声明输入和输出,再从消息中提取姓名、邮箱和意图等字段。
他还介绍当系统需要在有限输出中选择时,可以把模型用作分类器或动作评分器,例如选择工具调用。
上下文工程关注提供给智能体的整套信息:指令、对话历史、记忆、工具结果和文件。
把所有内容都放入上下文可能成本高昂,也可能降低长上下文任务表现。Ryan 展示一个检索与计数基准,随着文档增多,准确率下降。
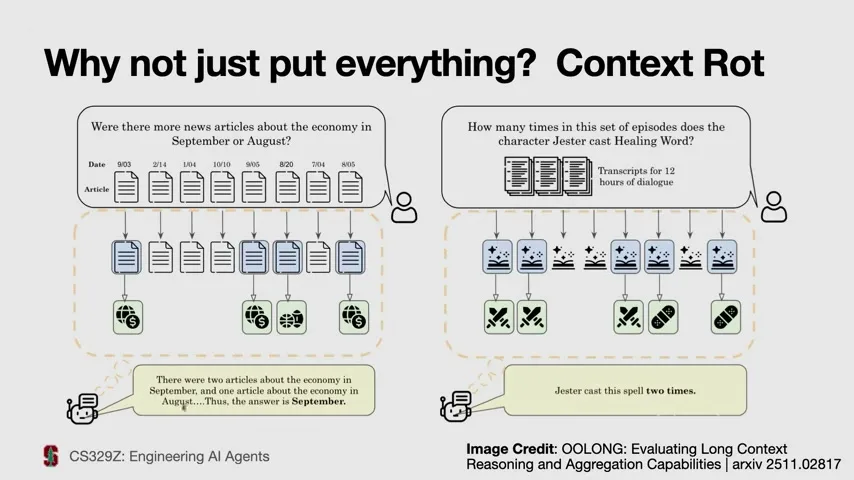
他建议避免不必要的工具与上下文,在需要时检索相关材料,并针对实际任务测试上下文设计。
在连续轮次中追加新信息可以保留更多现有键值缓存;在开头插入内容则可能使先前缓存失效。
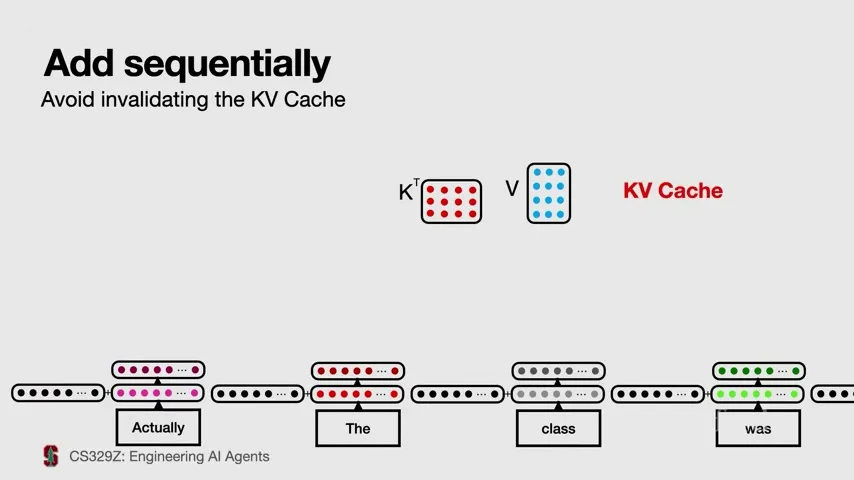
Ryan 建议通过实验评估格式和工具选择等决定,而不是假定某种上下文布局总是最好。
当上下文过长时,压缩会总结或移除材料。他讲述一个案例:压缩丢失了重要的删除前确认指令,导致不希望发生的删除。
递归语言模型提供另一种方法:把长提示保存在环境中,让模型检查其中部分内容,并对选出的片段调用子模型。
Ryan 总结说,即使应用主要使用现有模型,理解模型架构、训练和推理仍能帮助设计上下文。
同频道的其他文章
 1:16:16EN → 简体中文
 Stanford Online· 2026年11月10日Cynthia Bailey:清楚提问、核验证据,保留独立判断Cynthia Bailey · Stanford University斯坦福讲师介绍实用提示方法、上下文管理,以及防止技能悄悄退化的方法。
 1:04:32EN → 简体中文Stanford Online· 2026年11月6日粒子滤波 SLAM 如何分离机器人的路径与地图Marco Pavone · Stanford UniversityMarco Pavone 推导使粒子建图算法可行的条件独立性。
 1:47:01EN → 简体中文Stanford Online· 2026年11月5日大模型如何装进硬件并更快地生成回答Afshine Amidi, Shervine Amidi · Stanford University斯坦福讲师从显存搬运、分布式训练到推测解码,解释大模型系统如何兼顾容量与速度。
 1:11:12EN → 简体中文Stanford Online· 2026年11月4日用动态规划处理不确定条件下的决策Marco Pavone · Stanford UniversityMarco Pavone 从最优性原理推导马尔可夫决策过程,并解释精确求解为何昂贵。