30 秒看懂
直接对机器人的完整轨迹和所有地图特征联合使用粒子滤波,会随着维度增长变得难以计算。在这堂 2019 年的 Stanford 课程中,Marco Pavone 解释:在模型假设下,给定一条候选路径,各特征条件独立,因此每个路径粒子可以携带更小的扩展卡尔曼滤波器来估计各个地标。他推导后验分解和更新步骤,并比较粒子方法与高斯滤波的优势和局限。
- 1直接对联合分布使用粒子滤波会遇到高维问题Pavone 说,随着维度增加,同时表示完整路径和每个地图特征所需的粒子会过多。
- 2给定路径后,地标估计条件独立在所述模型下,后验可分解为路径分布与各地标条件分布的乘积。
- 3每个粒子都携带路径假设和每个特征的滤波器算法根据控制量预测路径、更新特征估计,再按与测量的相容程度重采样粒子。
- 4测量决定重采样权重Pavone 推导出基于似然的重要性权重,使符合最新观测的路径获得更多样本。
- 5不同粒子可以保留不同的数据关联历史不匹配的假设可以失去权重,而不必迫使整个估计器跟随一次错误关联。
- 6高斯滤波与粒子滤波各有取舍高斯近似在单峰附近较高效;粒子方法可表示多峰,但仍需要足够的样本。
要点建议
- 在课程的模型假设下,给定机器人路径后,地图后验可分解为各个特征的估计。
- 每个轨迹粒子携带自己的地标估计和数据关联历史。
- 先根据控制量预测路径,再用测量更新地标滤波器,最后按测量似然重采样路径。
- 粒子方法能表示多个假设,但仍面临扩展性和粒子匮乏问题。
按章节阅读整理后的全文
为什么直接粒子滤波难以扩展
Pavone 定义完整 SLAM,并说明联合采样路径与所有地图特征为何会遭遇高维问题。
Marco Pavone 对比了两种实际表示信念分布的方法:高斯分布等参数近似,以及非参数的粒子集合。粒子能够处理多峰分布以及高度非线性的状态转移或测量模型。
课程已经使用粒子滤波进行机器人定位,也使用扩展卡尔曼滤波器(EKF)进行同步定位与建图。本讲将粒子方法应用于 SLAM,主要材料来自 Thrun、Burgard 和 Fox 的教材。
完整 SLAM 问题是在给定控制和测量历史的情况下,求机器人完整轨迹与地图的概率分布。Pavone 将其与之前讲的在线 EKF 表述比较,后者估计当前状态和地图。
一种直接方法是对机器人轨迹和每个特征位置的完整联合后验采样。地图增大时维度随之增长,为表示分布所需的粒子数可能高得难以承受,这就是维数灾难的一种表现。
SLAM 的关键性质是条件独立性:在模型假设下,如果知道机器人真实路径,各地图特征的位置就可以独立估计。这样便能把建图问题拆成维度更低的子问题。
通过给定路径分解后验
课程使用条件独立性、贝叶斯法则和归纳法,将路径分布与各地标估计分离。
粒子滤波 SLAM 用粒子表示可能的机器人路径,并在给定每条路径时为每个特征使用一个 EKF。因此它是混合方法:路径采用非参数近似,地标位置采用高斯近似。
Pavone 引入记号:轨迹是机器人到当前时刻的状态序列,地图向量包含 N 个特征的位置。完整后验可分解为路径后验,乘以给定路径时各特征后验的乘积。
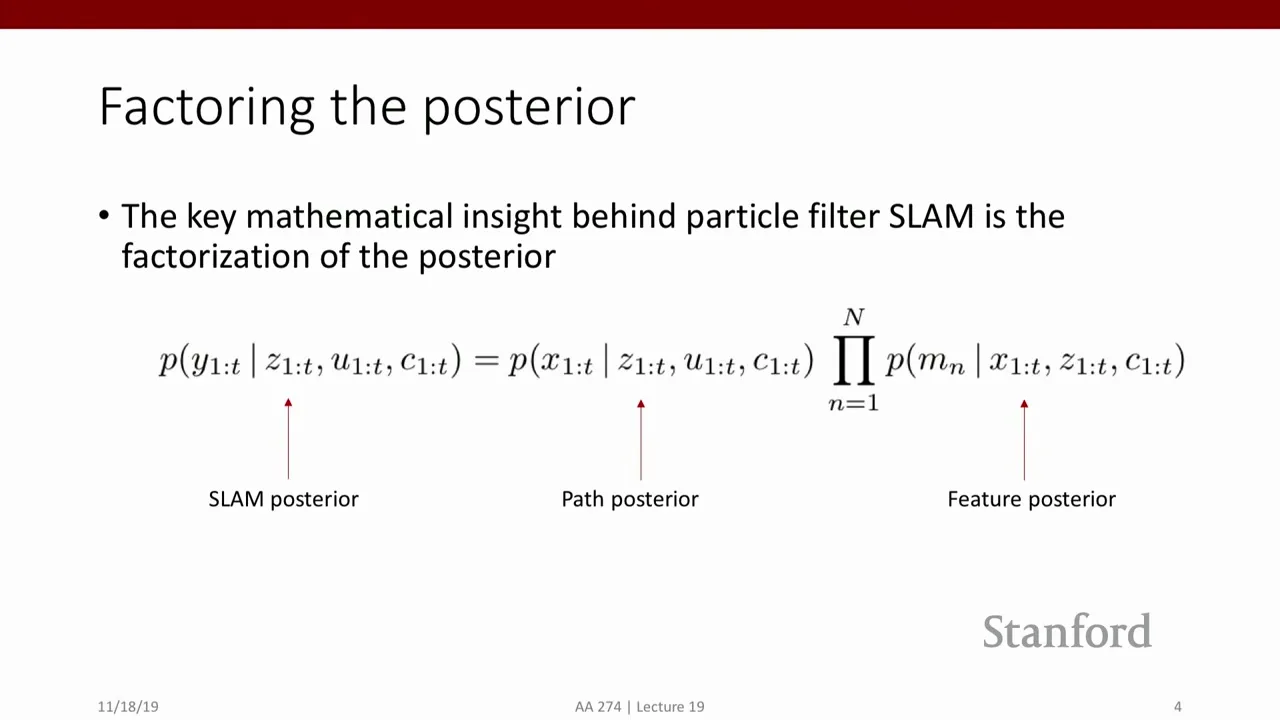
各特征分布可以相乘,是因为它们在给定路径的条件下独立,并不意味着特征无条件独立。如果机器人路径不确定,各特征的估计仍可能通过这一共同不确定性相关。
M 个粒子中的每一个代表一条轨迹假设。每个假设携带 N 个独立的特征滤波器,因此除了路径的粒子表示外,方法还包含 M 乘 N 个小型 EKF。
一名学生问,粒子表示的是历史还是当前位置。Pavone 说,它表示一条逐步构建的完整路径假设;后面会说明,实现时可通过回溯指针重建之前的状态。
虽然成千上万个小滤波器听起来比一个滤波器更糟,Pavone 说它们的维度低,更新更容易。后验分解利用的是 SLAM 模型中精确的条件独立性质;EKF 表示本身仍然是近似。
他用贝叶斯网络说明独立性。有噪声的观测取决于机器人状态和被观测的特征。如果有一个预言者提供精确轨迹,就能消除使不同特征估计相关的共同路径不确定性。
推导的第一步使用条件概率分离轨迹与地图的联合后验:路径后验乘以给定路径的地图后验。其他可用变量在适当的位置继续作为条件。
接着,在路径和测量已知后,他从特征估计的条件中移除控制量。接下来的难点是证明整个特征向量的后验也能分解成各特征后验的乘积。
作为中间步骤,他比较某个特征在 t−1 和 t 时刻的估计。如果新观测对应另一个特征,在该模型中它不会为当前特征提供新信息,因此这个特征的后验保持不变。
如果观测确实对应当前特征,其后验就会变化。贝叶斯法则将测量似然与之前的特征估计结合,并用观测概率归一化。
这一化简依赖马尔可夫模型:给定当前状态和观测特征后,当前测量不再依赖完整状态历史。此前的测量仍通过上一时刻的后验发挥作用。
一名学生问,为什么某个先验项可以省略当前状态。Pavone 解释,该项尚未纳入连接状态与特征的新测量;关于特征的相关信息由之前的测量携带。
Pavone 使用数学归纳法证明这种分解会随时间保持成立。作为单独的例子,他先验证前 n 个整数之和的起始情况,再证明 n−1 成立会推出 n 成立。
在 SLAM 证明中,他假设到 t−1 时刻特征后验可以分解。贝叶斯法则和马尔可夫假设将 t 时刻的后验写成新测量与之前特征估计的组合。
在示例中,只有一个特征对应最新观测。其他特征的后验不变;将被观测特征更新后的表达式代入,便重新得到所有 N 个特征后验的乘积。
Pavone 在完成归纳时指出并纠正了幻灯片中的记号错误。有了起始情况和更新步骤,就能在模型假设下证明分解在各时刻成立。
每个路径粒子携带各特征滤波器
每条轨迹假设都带有高斯地标估计。控制量延伸路径,测量则更新关联特征。
建立分解后,路径后验由粒子近似,每个地标后验由给定路径的 EKF 近似。M 个路径粒子和 N 个特征对应 M 乘 N 个地标滤波器。
每个粒子都携带每个特征高斯估计的均值和协方差。因此,不同路径假设可以拥有不同的地图,而不必共用一个估计。
一名学生问是否需要知道特征数量。Pavone 说,最初的讲解假定对应关系已知:算法知道每项测量来自哪个特征。他稍后会讨论对应关系未知的情况。
核心更新使用上一组粒子、新控制量和新观测。Pavone 将其分为三步:预测每条路径、更新特征估计,再使用测量修正路径分布。
第一步利用运动模型和新控制量延伸机器人路径。这是贝叶斯滤波的预测阶段;新测量此时尚未影响路径样本。
Pavone 澄清实现细节:当前粒子不一定要把完整轨迹直接存成一个长向量。随着滤波进行,指向早期状态的回溯指针可以重建其历史。
传播粒子时,根据以前的状态和当前控制量,从状态转移分布中采样新状态。即使从同一位置出发,模型也可能产生不同的下一位置。
接下来更新与每条路径假设关联的特征滤波器。如果最新观测不对应某个特征,就不改变该特征高斯分布的均值和协方差。
对于被观测的特征,将之前的高斯估计与测量似然结合。测量模型经过线性化后,得到对特征均值和协方差的标准 EKF 更新。
卡尔曼增益在先前特征估计和修正量之间取得平衡;修正量取决于实际测量与预测测量的差。其代数与课程之前讲的 EKF 定位相同。
学生询问哪个协方差属于哪个量。Pavone 强调,每个路径粒子都有自己的高斯地标协方差;机器人路径分布由粒子表示,而不是由单个高斯协方差表示。
示意图展示了多个可能的机器人位置,以及附着在各粒子上的不同高斯特征估计。同一个地标在两条路径假设下可以有不同均值和不确定性。
利用测量似然重采样路径
重要性权重纳入最新测量;重采样偏向相容的路径假设,并可能丢弃不相容的假设。
到目前为止,路径样本只利用控制量传播,还没有考虑最新测量。重采样通过给预测观测与实际观测更吻合的粒子更高权重,修正这一表示。
与测量高度不相容的路径可能连同其附带的地标滤波器一起被丢弃。重采样采用有放回抽样,因此更相容的假设可能出现多次。
Pavone 将重要性权重写成目标后验与提议分布之比。应用贝叶斯法则后,共同项抵消,剩下的量与该路径假设下新测量的似然成正比。
直觉与蒙特卡洛定位相同:观测会偏向能合理解释观测的假设。反复抽到同一个假设可能导致粒子匮乏,因此采样策略很重要。
为高效计算似然,可以将测量模型线性化,并用高斯分布表示结果,这与之前的 EKF 和蒙特卡洛定位内容相同。
尽管记号复杂,最终循环很紧凑:对每个粒子传播路径、更新相关特征滤波器并计算权重,然后按权重重采样粒子。
一名学生问测量更新使用哪个估计。Pavone 指出,它使用相关特征的先前均值,并说明这部分采用了课程此前讨论的 EKF 机制。
未知关联与滤波方法的取舍
不同粒子保留不同关联历史。Pavone 比较粒子与高斯方法,并介绍后续 SLAM 方法。
对应关系未知时,滤波器必须判断观测来自哪个地标。Pavone 介绍最大似然关联:对某个粒子选择使该观测最可能出现的特征。
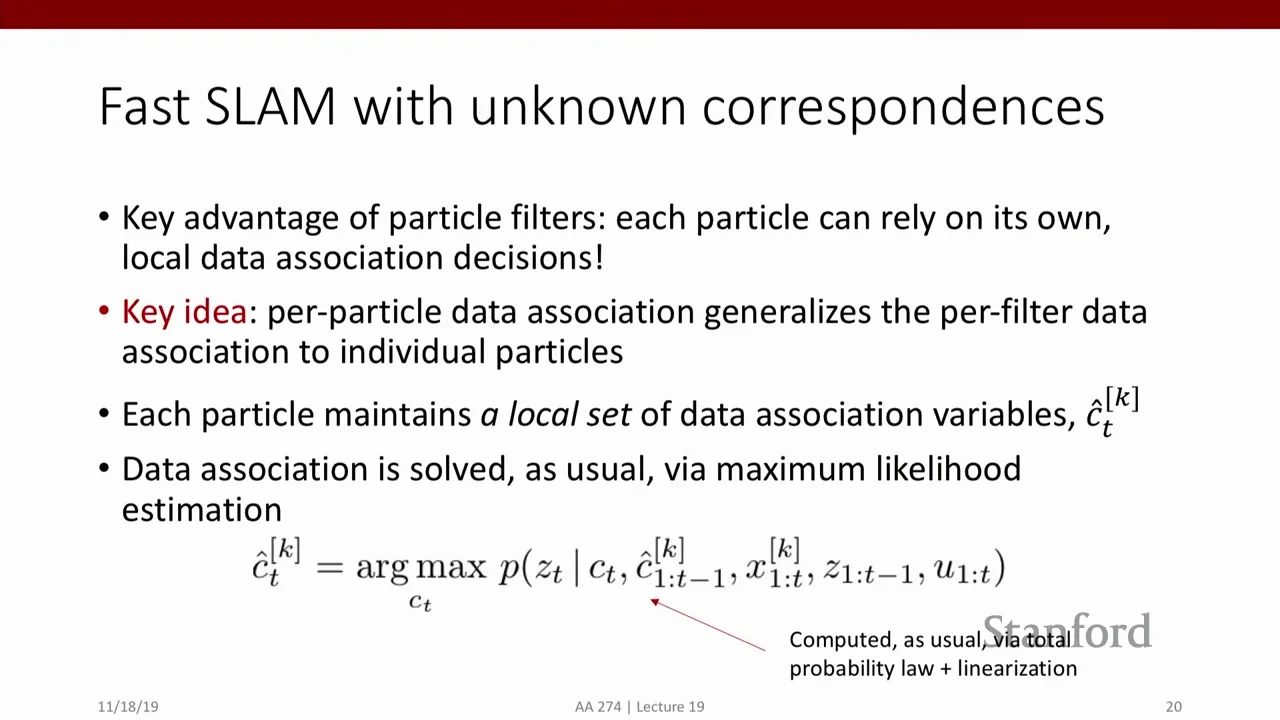
一名学生问,这是否只选择一个对应关系,而不是保留多种可能性的信念。Pavone 解释,决策以粒子为条件:不同粒子可以保留不同的关联决策历史。
如果错误关联让某个粒子走向不合理的路径,后续测量可能降低它的概率,并在重采样时将其移除。相比之下,标准单假设 EKF 在错误关联后可能发散,需要重置。
Pavone 比较两类方法。高斯滤波用高斯近似表示不确定性,并将转移和测量模型线性化。它相对快且容易理解,但存在多个可能位置时,单峰表示并不合适。
他说,不确定性较低或机器人受限于狭窄环境时,高斯方法可能足够。需要考虑多个可能模式的全局定位问题,可能需要粒子方法或其他方法。
粒子滤波可以表示多峰信念,并通过样本传播非线性动力学。各自独立的关联历史也使它对某些数据关联错误更有韧性。
代价仍然不小:即便分解了后验,状态增长时仍可能需要很多粒子。重采样也可能导致粒子匮乏,因此需要更谨慎的采样方法。
Pavone 将 SLAM 放在更长的研究历史中,从 EKF 方法讲到粒子滤波和基于图的方法。他说图 SLAM 使用图优化,但这门课没有讲授该方法。
他推荐一篇综述,将 SLAM 历史分为经典滤波、算法正确性分析,以及面对失效的稳健感知等阶段。他还介绍 OpenSLAM、视觉 SLAM 实现和用于比较算法的基准数据集。
在定位与建图模块结束时,Pavone 回到贝叶斯滤波共同模式:先预测,再修正。课程讨论的主要计算工具包括线性化、粒子表示和后验分解。