30 秒看懂
大模型不仅受显存容量限制,数据搬运也会拖慢计算。斯坦福讲师 Afshine Amidi 推导 FlashAttention 如何分块计算精确注意力,避免保存完整的注意力矩阵,并比较分布式训练方法。Shervine Amidi 区分提示词预填充与逐词生成,说明缓存、分页注意力和推测解码如何应对不同的内存与速度瓶颈。
- 1千亿参数模型的权重可能已经超出单张显卡容量每个参数占两字节时,权重需要约 200 GB;训练还要保存激活值、梯度和优化器状态。
- 2不保存完整分数矩阵也能累积注意力结果讲师推导分子和分母的递推计算,并使用动态最大值进行缩放,保持数值稳定。
- 3反向传播时重算中间结果可能比保存它更快FlashAttention 用额外计算换取更少的高带宽内存读写。
- 4五种并行方式分别切分数据或模型工作讲师比较数据、张量、流水线、上下文和专家并行的通信代价。
- 5预填充和解码对延迟与硬件的要求不同提示词可以并行处理,生成则需要逐词推进;讲师介绍延迟指标和屋顶线模型。
- 6推测解码让目标模型验证草稿词元接受与剩余概率采样恢复目标分布,减少部分串行步骤。
要点建议
- FlashAttention 改变计算次序和位置,减少内存读写,同时计算精确注意力。
- 数据、张量、流水线、上下文和专家并行可以组合,但通信和设备空闲会抵消部分收益。
- 分别测量首个词元延迟和每个输出词元耗时:预填充与逐词生成的瓶颈不同。
- KV 缓存、分页分配和减少键值表示分别解决不同的内存问题。
- 推测解码通过草稿和验证加速生成,同时保留目标模型的概率分布。
按章节阅读整理后的全文
GPU 显存和注意力瓶颈
Afshine Amidi 说明显存与带宽限制,以及标准注意力计算产生的大型中间矩阵。
Afshine Amidi 从大语言模型的规模化训练和服务讲起。解码器式 Transformer 的注意力和前馈运算主要依赖矩阵乘法,适合利用 GPU 并行计算。
GPU 拥有大量计算核心和专门的矩阵乘法运算单元。矩阵乘积的不同元素可以并行计算,从而利用硬件的并行能力。
他区分浮点运算次数与每秒浮点运算次数:后者衡量硬件吞吐量。GPU 的规格还包括内存容量和数据传输带宽。
以每个参数两字节估算,千亿参数模型仅权重就需要约 200 GB,超过他提到的 H200 显存容量;训练还需要存储激活值、梯度和优化器状态。
课程围绕两个实际问题:怎样让模型装进现有硬件,以及怎样让它运行得更快。FlashAttention 首先优化单张 GPU 内的计算,随后再讨论分布式训练和推理。
在因果自注意力中,每个词元关注自身和之前的词元。长度为 N 的序列,其查询与键的乘积可能产生 N×N 的分数矩阵,序列越长,中间结果越难存储。
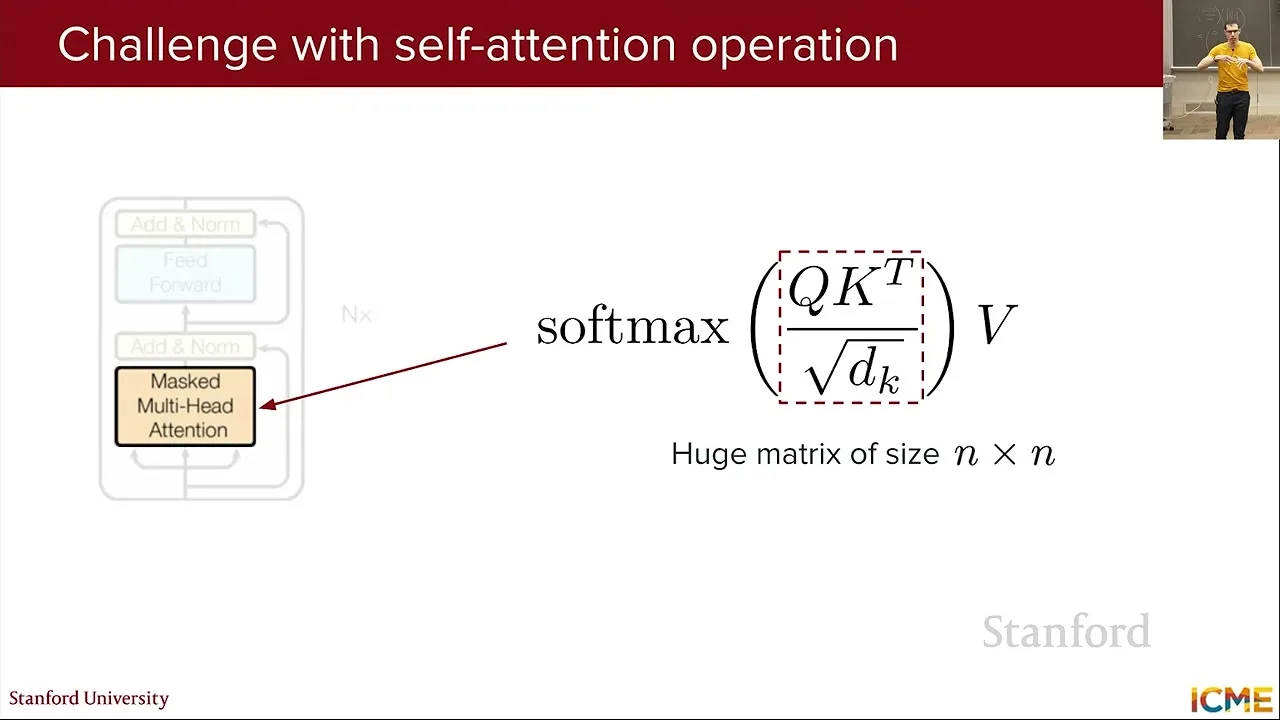
GPU 的内存层级也很重要。高带宽内存 HBM 容量相对较大,但访问速度低于计算单元附近容量较小的片上 SRAM。
朴素实现会在计算分数、应用 softmax、乘以值向量时,把大型中间结果写入 HBM 再读回来。目标是减少这些传输,而不是把内存访问当成免费操作。
Softmax 用一行所有分数共同构成的分母归一化每个分数。乍看之下,似乎需要先保存完整的一行才能得到结果。
推导 FlashAttention 的在线 softmax
动态累加和与最大值让注意力可以逐步计算,减少高带宽内存传输。
Amidi 将单个查询的注意力输出写成加权分子除以分母:分子是分数取指数后与对应值相乘的总和,分母是指数值的总和。
随着新的分数和值到来,可以逐步累加这两个和。他用三个元素的例子说明如何更新分子和分母,而不必先存下整行分数。
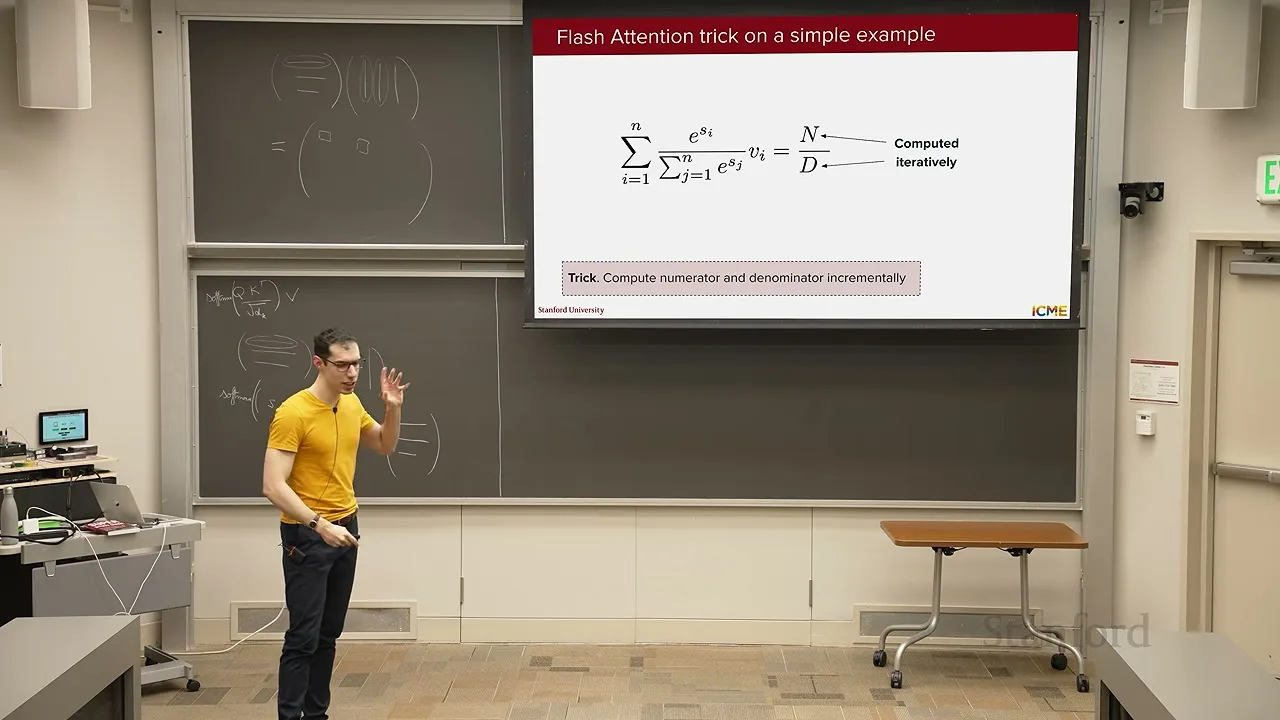
直接计算指数可能溢出或造成数值不稳定。分子和分母乘以同一个缩放因子不会改变比值,因此可以用目前见到的最大分数作为参照。
处理第一个元素时,动态最大值就是该分数。计算指数前先减去最大值,可以避免先生成一个可能极大的指数值。
当后续分数改变动态最大值时,之前累积的分子和分母必须按新的参照重新缩放。新旧项使用相同尺度后才能计算比值。
重新缩放的因子是旧最大值减去新最大值之后取指数。Amidi 通过替换归一化常数推导这个关系;极小的贡献可能下溢,而他的讲解重点是避免大数溢出。
有了这种在线更新方法,就可以将查询、键和值的小块载入快速 SRAM,更新累积量后再换下一块,无须把完整的 N×N 注意力矩阵写入 HBM。
在这里的数学形式中,注意力计算仍然精确:算法改变的是运算顺序和位置,而不是目标公式。实际数值计算仍受有限精度影响。
训练时,反向传播需要与前向计算有关的数据。FlashAttention 可以利用保存的较小信息重新计算这些数据,而不必把巨大的中间结果保存在 HBM。
重新计算增加了运算次数,却仍可能缩短时间,因为大型中间数据的读写很昂贵。这个例子说明,运算次数最少不一定意味着运行时间最短。
Amidi 说,后续 FlashAttention 版本针对不同 GPU 架构进一步优化。核心做法是融合增量计算、稳定归一化,并在重算与内存传输之间取舍。
将训练分配到多张 GPU
课程比较五种并行方式及其同步通信和设备空闲代价。
即使注意力计算更高效,模型及训练状态也未必能装进单张 GPU。除了参数,还要容纳前向传播的激活值、梯度和优化器状态;激活值也会随批次和序列长度增长。
数据并行将一个批次分给不同设备。每台设备处理自己的部分,之后需要同步梯度更新;简单实现会在每台设备上复制模型和训练状态。
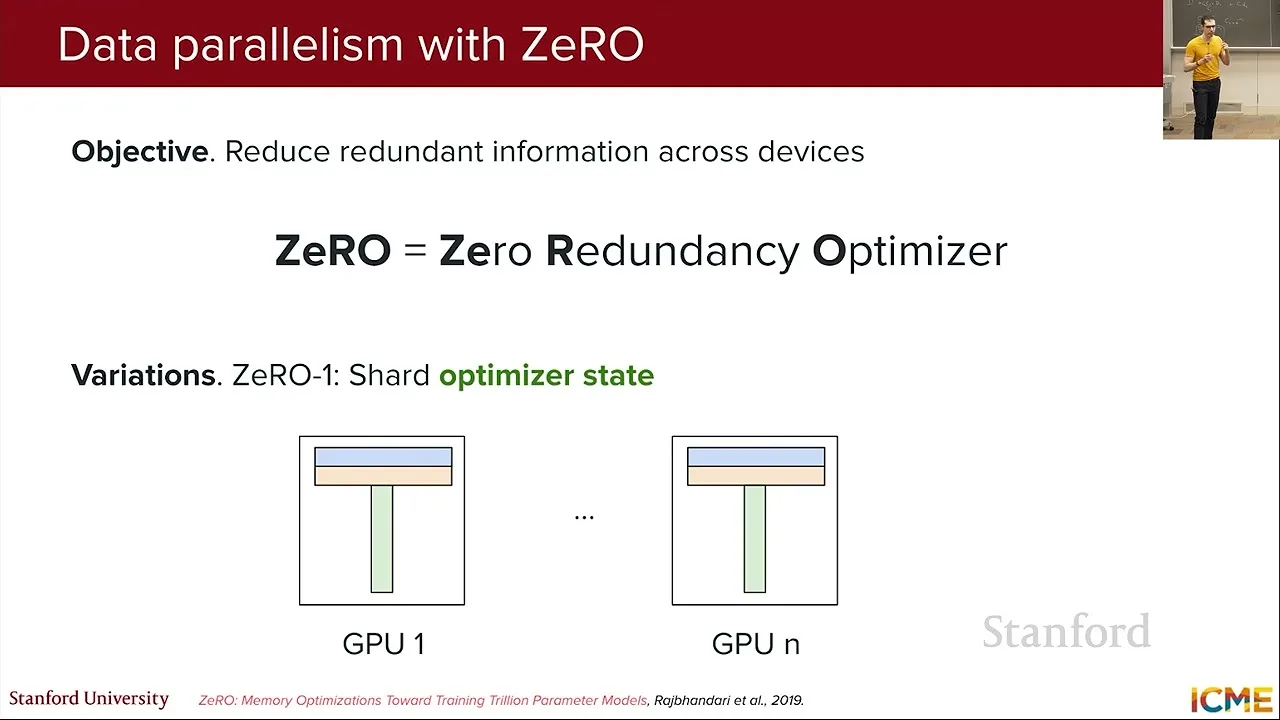
ZeRO 即零冗余优化器,将重复的优化器状态、梯度,甚至参数分片放到不同设备上。每张 GPU 占用更少显存,但计算时需要通信取回所需部分。
Amidi 将其与模型并行区分开:在他的数据并行例子中,每台设备为自己的子批次计算整个模型,并按需取得分片状态。通信有代价,但能让无法容纳完整副本的设备参与训练。
张量并行将矩阵运算等模型计算分到多个设备。例如,可以切分注意力头或前馈层的一部分,再合并结果;它可以与数据并行结合。
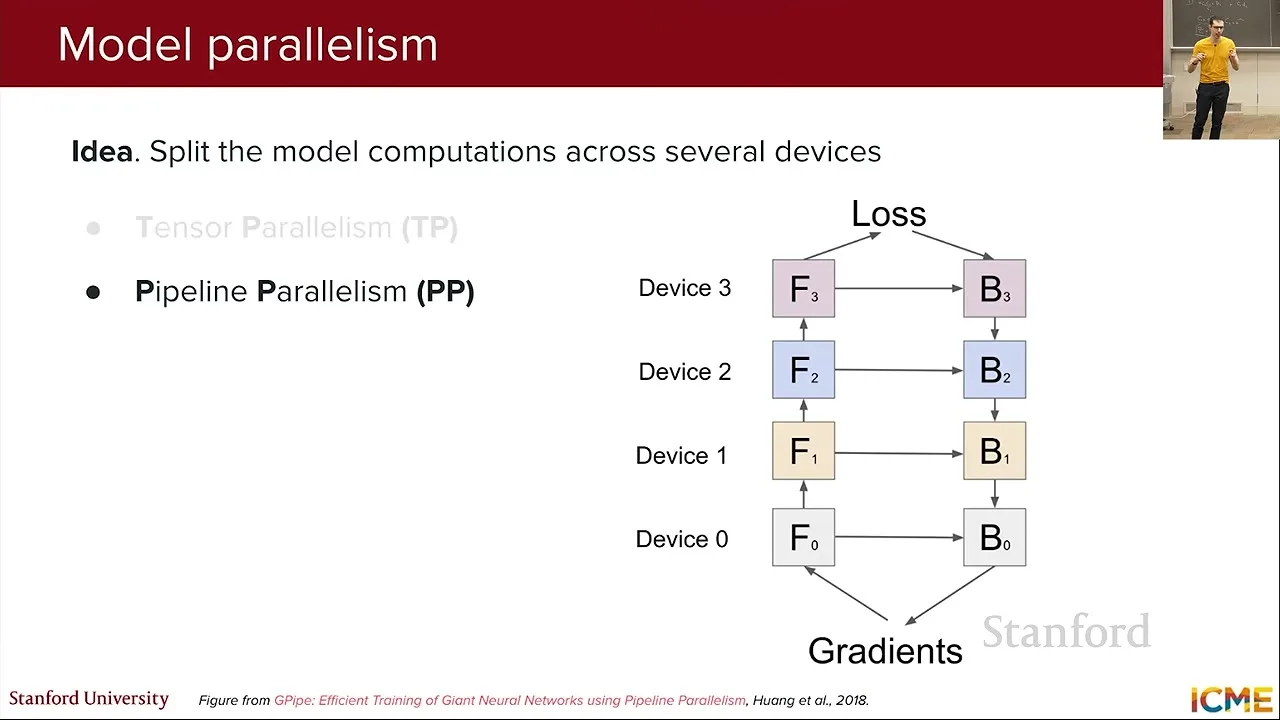
流水线并行将不同的层或阶段交给不同设备。训练时激活值沿流水线向前传递,梯度信息向后传递。
设备等待其他阶段时可能空闲,形成所谓的流水线气泡。调度策略试图减少这类空闲时间,课程没有展开推导。
上下文并行将长序列的工作切分到不同设备。例子中,不同设备负责不同查询组,同时交换键和值块,使每组能够关注相关上下文。
专家并行用于混合专家模型。不同专家放在不同设备上,词元被路由给选中的专家完成前馈计算,再按需送回。
这五个维度分别是数据、张量、流水线、上下文和专家并行。组合使用有助于容纳和加速训练,但通信、同步和硬件空闲会限制收益。
衡量并优化推理
Shervine Amidi 区分预填充和解码,并解释屋顶线、KV 缓存与分页注意力。
Shervine Amidi 转向推理。长提示词配短输出与短提示词配长输出的表现可能不同:预填充能并行处理多个输入词元,自回归输出则逐个生成。
他区分排队时间、预填充时间和解码时间,并介绍首词元延迟、每个输出词元耗时以及最后一个词元的完成时间。最后一项也取决于输出长度,包括生成的推理内容。
学生问为什么说预填充快。他说这是相对处理的词元数量而言:单步输出可能很短,但多个输出词元需要反复串行执行;缓存上下文也可能改变预填充工作量。
推理服务的速度和成本可以用可测量的限制来分析。Amidi 介绍计算吞吐量、内存带宽和算术强度,即每单位数据搬运对应的计算量。
屋顶线模型将算术强度与可达到的吞吐量联系起来。强度较低时,内存带宽可能成为限制;超过转折点后,计算能力可能成为瓶颈。
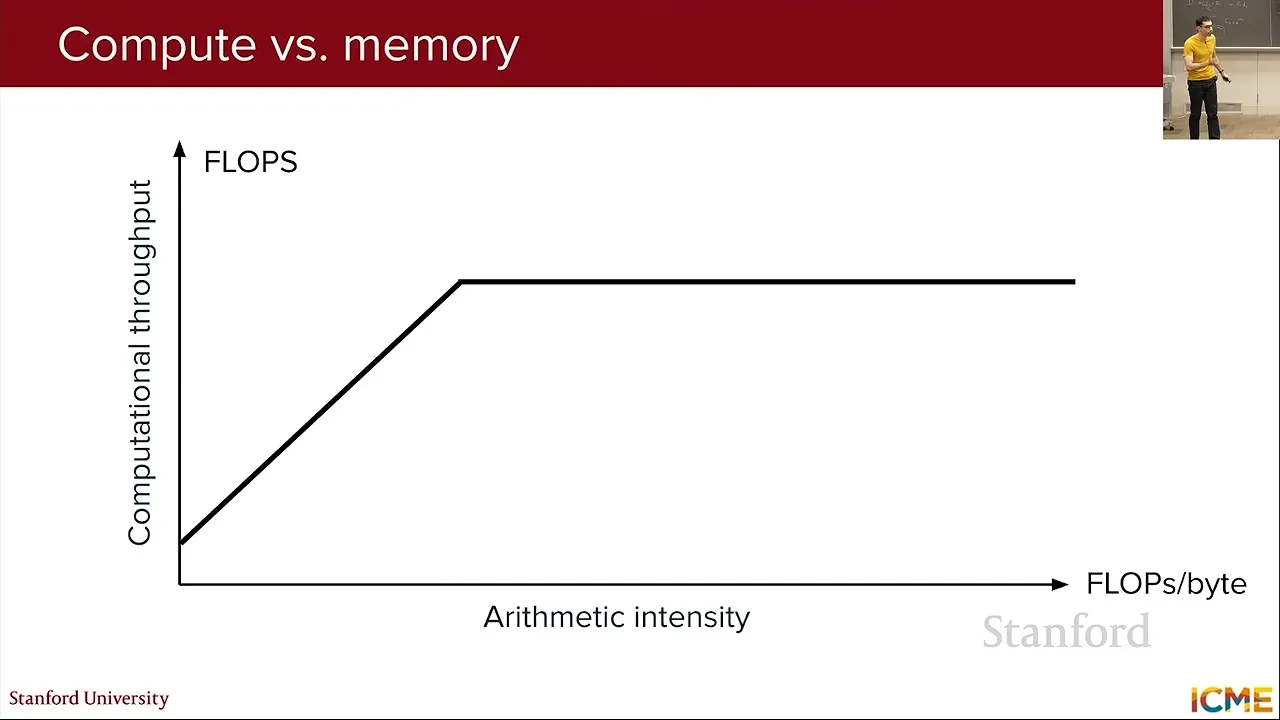
在所示工作负载中,逐词解码通常需要搬运大量模型数据,计算量相对较少,因而可能受内存带宽限制。优化后的预填充可并行处理更多词元,并可能转为受计算能力限制,具体取决于工作负载和硬件。
KV 缓存让解码重复使用先前计算的键和值表示,避免每生成一个词元就重算。他将这种内部缓存与服务商对多轮对话中复用提示词前缀的计费区分开。
如果简单地为每个请求预留其可能使用的最大 KV 缓存空间,当实际输出较短时,部分预留内存会闲置。请求量大时,这种碎片会减少可同时服务的请求数。
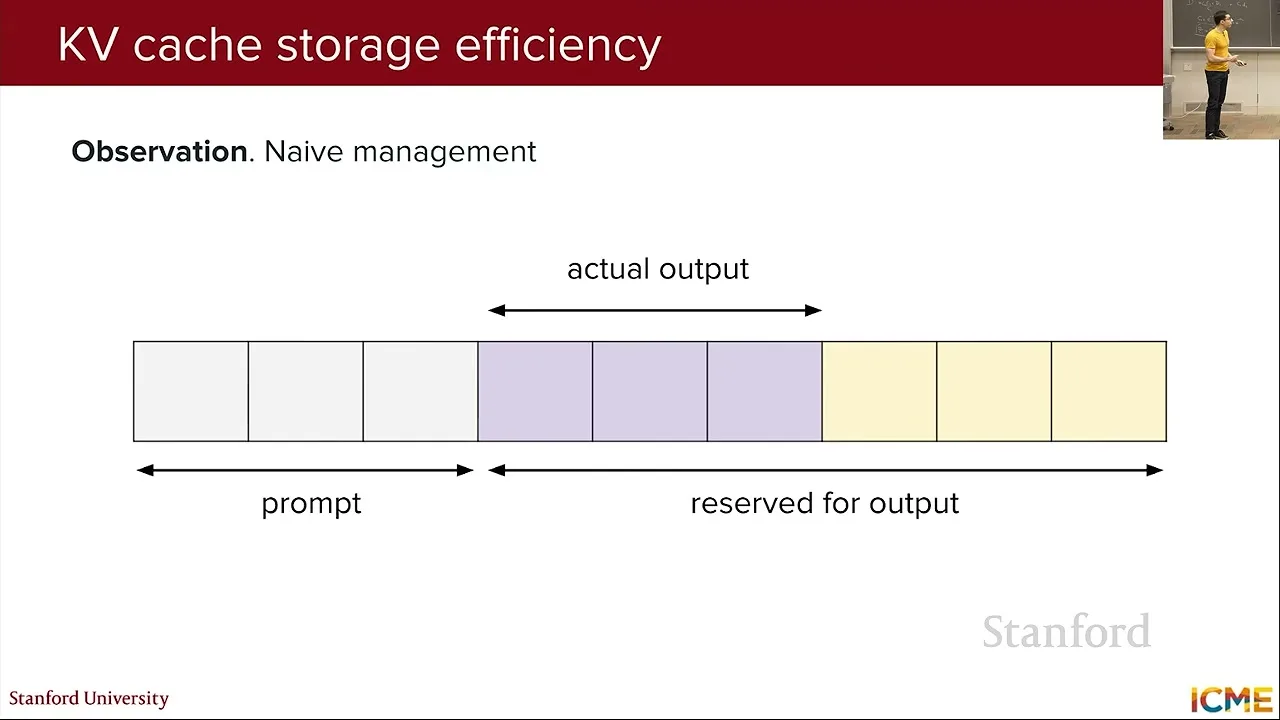
分页注意力把缓存分成块,并用元数据将逻辑词元位置映射到物理块。较小的块减少闲置空间,但需要更多元数据;较大的块则相反。
减少缓存表示并验证草稿
分组查询和潜在注意力减少键值存储;推测解码与多词元预测针对串行生成。
分组查询注意力让多个查询头共享较少的键和值头。若查询头数为 H、键值组数为 G,G=H 对应普通多头注意力,G=1 对应多查询注意力。
减少键值组数可以节省缓存,但会改变模型容量,因此设计者需要测试取舍。在课程的算术例子中,24 个查询头使用两组键值,可使相应存储量减少约 91%。
多头潜在注意力提供另一种压缩键值信息的方式。课程介绍先投影到较小的共享潜在表示,再重建注意力所需表示,因此缓存的是紧凑表示。
推测解码针对逐词串行生成:较小的草稿模型先提出多个词元,目标模型并行检查候选结果,利用并行验证与逐步生成之间的速度差。
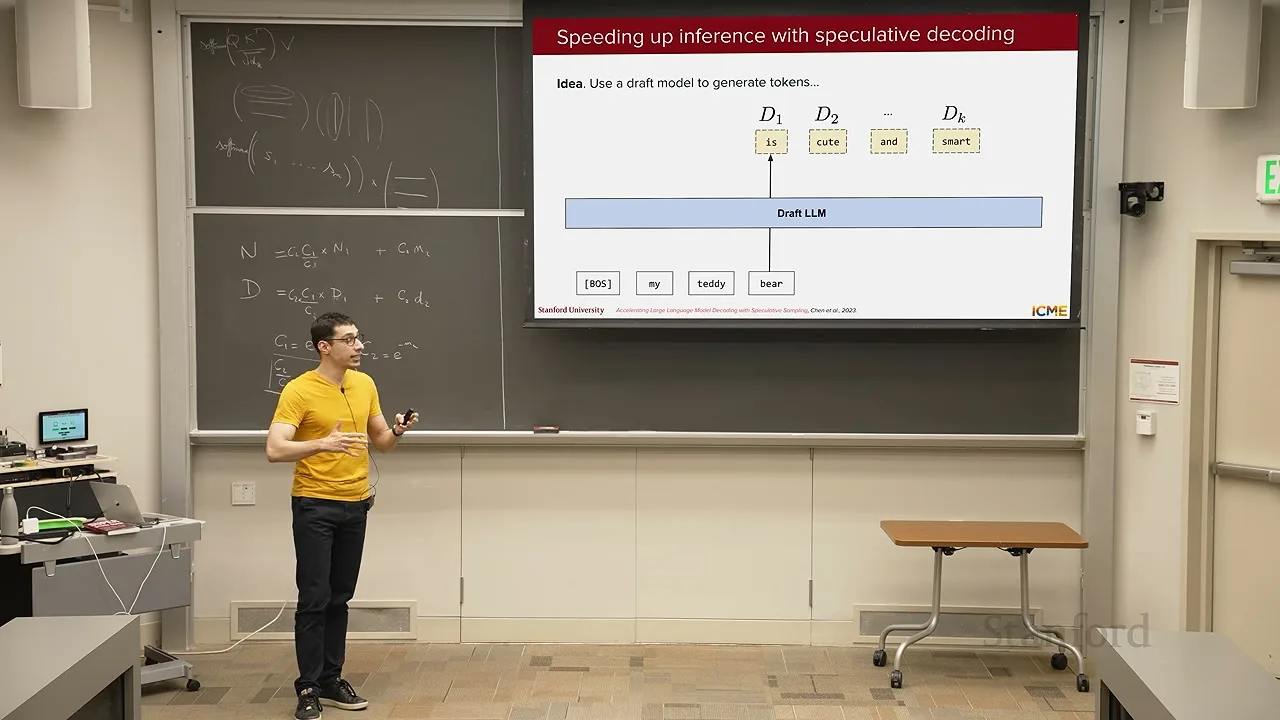
讲师给出的候选词元接受概率,是 1 与目标概率除以草稿概率两者中的较小值。如果拒绝,则根据目标概率减去草稿概率的正值部分,归一化后重新采样。
Amidi 推导这种采样为何能恢复目标分布:某个词元被接受的贡献是草稿概率和目标概率中的较小值;拒绝分支贡献目标概率超过草稿概率的剩余部分。
无论两个概率谁大,两个分支的贡献相加都等于目标概率。这证明了所述方法的分布结果,而非仅依赖草稿通常足够准确。
验证接受的候选词元后,还可以得到下一个词元的分布。拒绝会浪费该位置之后的草稿工作,因此草稿分布越接近目标分布,效率可能越高。
知识蒸馏是一种训练较小草稿模型以匹配目标模型预测的方法。课程还介绍多词元预测头,利用模型自身的表示提出多个词元。
两位讲师最后回到最初的问题:分页和紧凑键值表示有助于解决显存容量限制;并行、减少内存传输以及一次验证多个候选词元可以提高速度,具体取舍取决于工作负载和硬件。