30 秒看懂
序贯决策可以通过向后计算求解:最优计划的剩余动作,也必须是剩余问题的最优解。在这堂 2019 年的 Stanford 课程中,Marco Pavone 用这一原理建立动态规划,再加入随机扰动和依赖状态的策略。一个小型库存例子展示了贝尔曼递推;最后,他讨论促使人们使用近似方法和强化学习的计算与建模限制。
- 1最优计划的尾段也是剩余问题的最优解Pavone 用反证法说明,成本可加时更便宜的剩余路径也会产生更便宜的完整路径。
- 2向后计算,复用未来决策的成本小型路线例子展示了动态规划如何避免枚举所有完整路径。
- 3随机扰动使求解对象从固定序列变成策略随机模型优化期望成本,并根据当前状态选择动作。
- 4库存例子让贝尔曼递推具体化课程用有限存储、随机需求和订货成本计算最后阶段的动作。
- 5精确动态规划面临多种计算限制Pavone 讨论维度、未知模型和时间限制,并介绍价值空间与策略空间中的近似方法。
要点建议
- 在成本满足所需可加结构时,用最优性原理复用未来子问题的解。
- 存在不确定性时,优化将观测状态映射到动作的策略,而不是只确定一条开环序列。
- 贝尔曼递推权衡即时成本与期望未来成本。
- 精确动态规划受状态空间、建模和时间限制;近似价值函数和近似策略是两种替代方向。
按章节阅读整理后的全文
建立序贯决策模型和可加成本
Pavone 从确定性动力学、控制约束和有限时域成本入手,比较开环序列与反馈控制。
Marco Pavone 介绍机器人是否穿过路口、是否变道等高层决策。这类选择必须考虑感知、重建环境以及对他人行为预测中的不确定性。
课程将建立不确定条件下序贯决策的数学模型和基础求解方法。Pavone 将本课程下一主题强化学习视为与这些决策问题相关的一类近似方法。
他推荐 Dimitri Bertsekas 的著作,将最优控制与强化学习置于共同框架中,尽管两者常使用不同术语。
Pavone 从确定性的离散时间系统开始。时刻 k 的状态和控制量决定下一状态;每个状态下只有部分控制可行,例如需要遵守道路限速。
有限时域目标将每个时间步的阶段成本与终端成本相加。最初的问题是从给定初始状态出发,选择一组控制序列以最小化总成本。
一名学生指出这是开环控制:序列选定后,某个时刻的控制不取决于实际到达的状态。因此干扰或模型误差可能使原计划动作不再合适。
Pavone 举例说,车辆可能比预期走得更远,进入较低限速区域。由于开环计划不响应观测状态,它仍可能发出原先计划的较高速度指令。
离散时间设定适合本讲讨论的高层动作。成本的可加结构尤其重要:它允许将总目标拆为当前成本和剩余成本。
直接枚举所有可能的控制序列会导致组合爆炸,尤其是在约束非线性或成本非凸时。关键是如何利用结构,避免从头求解每一条完整序列。
最优性原理
反证法说明,最优轨迹的尾段为什么也是剩余子问题的最优解。
最优性原理提供了这种结构。假设从 A 经 B 到 E 的路径是最优的,那么从 B 到 E 的尾段本身也必须是从 B 出发的子问题的最优解。
Pavone 用反证法证明:如果 B 到 E 有另一条成本更低的路线,将它与原来的 A 到 B 路段组合,就能得到成本更低的 A 到 E 路线。
由于成本可加,这条替代尾段会与原完整路线最优的假设矛盾。关键并不是最优解一定唯一,而是最优路径的尾段不可能比另一条可行尾段更昂贵。
在离散时间表述中,从已知初始状态应用最优控制序列会产生最优状态轨迹。从该轨迹经过的一个状态开始,剩余最优控制解决剩余的有限时域问题。
被问及轨迹前段和尾段时,Pavone 说随机情况需要谨慎处理:向后求解尾部子问题的视角仍然重要。存在不确定性时,表述将使用期望和策略,而不是固定序列。
假设从 C、D、E 到终点的最优成本已经知道。从 B 出发时,只需比较到每个后继状态的即时成本加该状态已知的成本到达终点,而不必重新计算所有尾段。
向后求解未来子问题
路线例子和贝尔曼递推展示如何复用最优成本,而不必枚举每条路径。
Pavone 用一张有向路段网络举例。从终点开始,留在终点的成本为零;他向后计算,将每条边的成本与终点节点已算出的最优剩余成本相加。
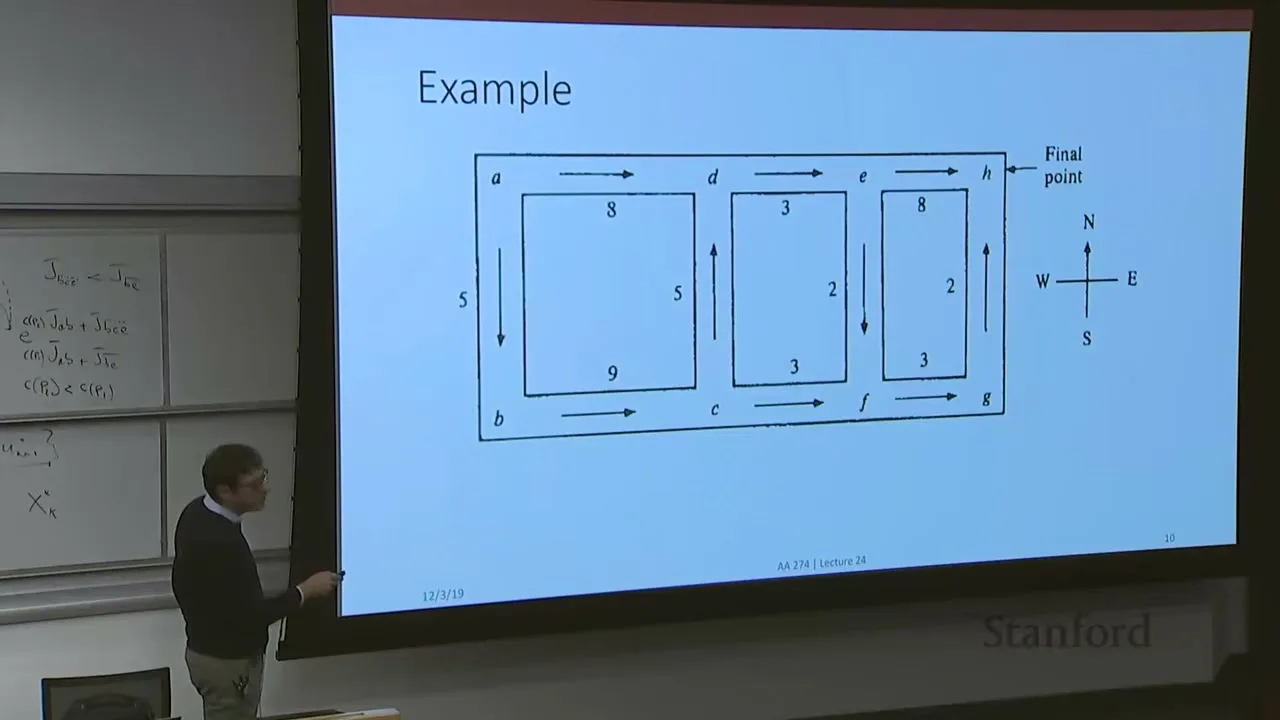
一个节点只有一个可选动作时,计算就是该边成本加后继节点的成本到达终点。有多个动作时,则比较备选项并保留最小值。
一名学生指出例子中的算术错误。Pavone 纠正后继续,并强调可以利用向后计算的值,从起点向前重建最优路径。
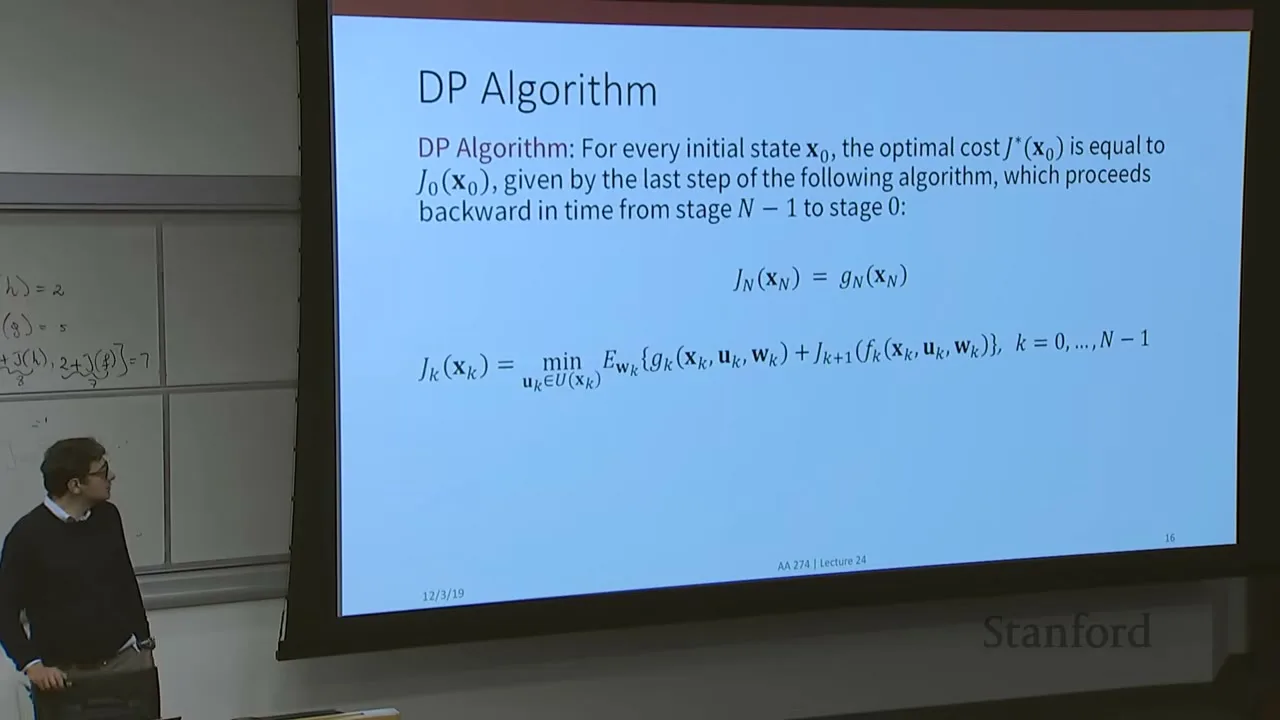
形式化的动态规划算法从终端成本开始。对每个更早的时刻和每个可能状态,最小化即时成本加下一状态的最优成本到达终点。
Pavone 将这一递推解释为权衡即时收益或成本与未来后果。尽管计算向后进行,得到的动作仍按时间向前执行。
一名学生询问部分可观测状态。Pavone 说,大体方法仍可在信念分布而不是已知状态上建立,但求解递推会困难得多。
该模型在时间上是离散的;连续时间问题可以离散化,连续时间动态规划也有自己的表述。状态取值很多或连续时,也需要近似、量化或插值。
如果精确算法能在其假设下完整运行,它给出的是所建模问题的全局最优解。控制约束可以减少需要检查的候选动作数量。
被问及不可加成本时,Pavone 指出,某些涉及整条轨迹的概率或风险指标会把不同阶段耦合起来。这类目标可能需要重新表述或近似,才能应用简单递推。
加入不确定性和依赖状态的策略
随机扰动和马尔可夫假设引出期望成本表述与随机贝尔曼递推。
在随机情况下,状态转移还取决于随机扰动。其概率分布可以依赖当前状态和动作,但马尔可夫假设排除了在给定这些量后对更早历史的额外依赖。
存在不确定性时,Pavone 寻找闭环策略,即将每个可能状态映射到动作的函数。固定的开环序列不能对随机扰动产生的不同状态作出响应。
阶段成本和终端成本可能是随机的,因此该表述按总成本的期望对策略排序。它是风险中性的:优化平均表现,而不直接控制方差或最坏情况下的分位数。
马尔可夫性质和可加目标允许建立随机版最优性原理。从一个已到达的状态出发,尾部策略仍是剩余问题的最优解,只是推理中要纳入概率。
贝尔曼递推仍然从终端成本向后进行。增加的操作是:比较即时成本与下一状态的成本到达终点之和时,对当前扰动取期望。
库存控制与精确方法的局限
小型仓库例子展示计算过程;维度、建模和时间限制促使人们使用近似方法。
Pavone 介绍一个小型库存问题。状态是当前库存,动作是订购数量,随机需求决定下一时刻的库存;库存不会低于零。
仓库订货后最多容纳两单位。需求为零、一和二单位的概率分别为 0.1、0.7 和 0.2;例子结合订货成本与二次项,使用三个时间步。
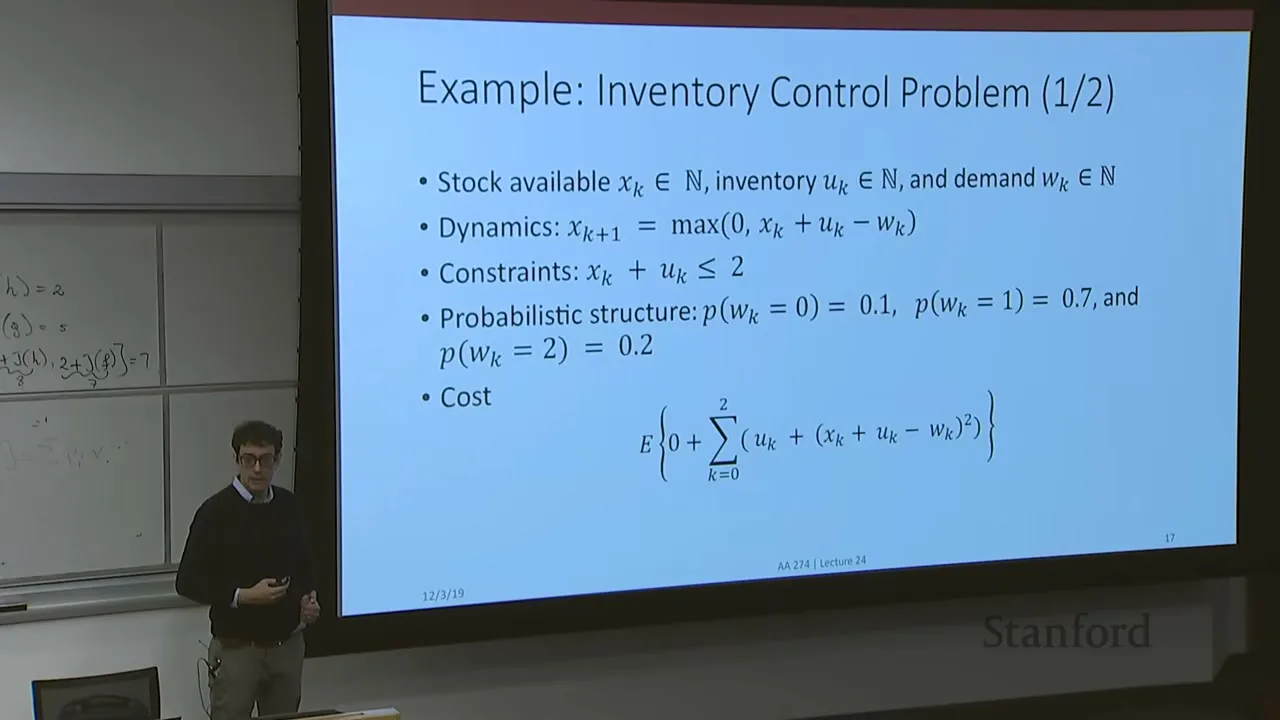
终端成本设为零。动态规划从终点开始,先计算前一时刻每种可能库存的最优成本到达终点,再继续向前一个时刻回推。
在展示的最后一次决策中,库存为零,可订购零、一或两单位。Pavone 对三种需求结果计算期望成本,得到订购一单位最优,该状态的最优成本到达终点为 1.3。
例子展示了如何为每个状态和时刻建立策略,但精确动态规划仍面临维数灾难:状态变量数量增加时,状态组合数量迅速增长。
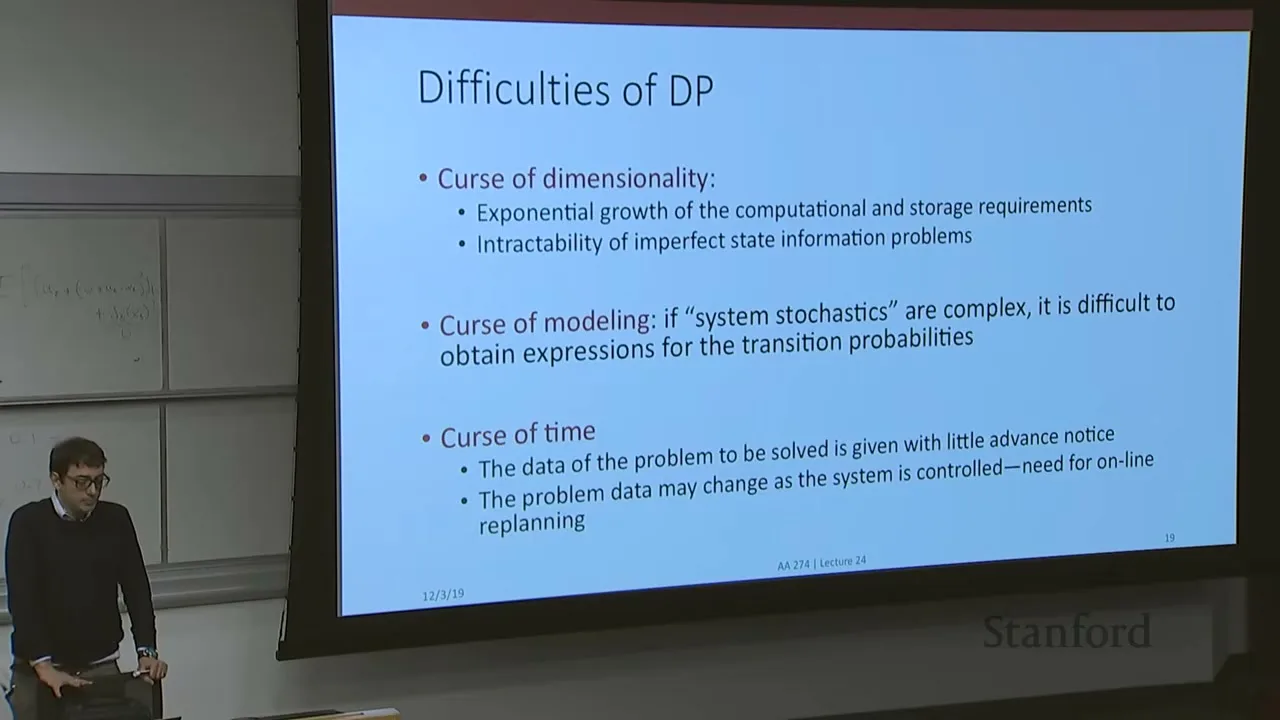
部分可观测性可能使优化的状态变成信念分布,进一步增加计算难度。另一个限制是建模:转移概率,例如人对机器人的反应,可能未知,需要通过数据学习。
第三个限制是时间。系统运行时,数据或条件可能变化,导致没有足够时间重新计算完整的精确策略。
近似动态规划用于应对这些限制。一种方法是用替代函数近似最优成本到达终点,例如求解更简单的问题、使用近似优化器、学习神经网络等函数,或聚合状态。
另一种方法将策略限制在参数化的函数族中,优化参数,而不是搜索所有可能的函数。Pavone 说下一讲将深入讨论这些近似和基于学习的方法。