30 秒看懂
在这段 2026 年 2 月的视频中,Matthew Berman 讨论了 Anthropic 的指控:DeepSeek、Moonshot AI 和 MiniMax 利用账号网络获取 Claude 输出,用于开发模型。他解释了蒸馏,回顾 Anthropic 对相关活动的描述,并探讨质疑声音以及有关该公司自身使用版权作品的问题。 Berman 还讨论了另一项关于 DeepSeek 获取 Nvidia 芯片的指控,并推测中美 AI 竞赛的走势。关于特定实验室、用户动机及未来能力格局的说法,应视为指控或评论,而非已经确立的事实。
- 1Anthropic 点名三家实验室公司指控存在超过 2.4 万个欺诈账号和 1600 万次 Claude 交互。其报告利用元数据、基础设施等指标对活动作出归因。
- 2蒸馏与访问Berman 解释较小的模型如何向较强的模型学习。Anthropic 认为,未经授权的提取可能转移能力,却不保留原模型的安全防护。
- 3三项被指控的活动公司报告称,DeepSeek 的交互超过 15 万次,Moonshot 超过 340 万次,MiniMax 超过 1300 万次,任务和账号模式各不相同。
- 4版权批评网上批评者将 Anthropic 的投诉与其自身使用版权材料所涉诉讼相比较;这些法律问题和指控不能混为一谈。
- 5对推论的质疑Theo 认为,所报告的 DeepSeek 交互数量可能可以用基准测试解释。Berman 指出,外部观察者看不到底层请求数据。
- 6另一项芯片指控Berman 讨论了一篇转述美国官员指控的帖子,称 DeepSeek 获取了受限制的 Nvidia Blackwell 芯片。他随后推测这些指控可能对中美 AI 发展意味着什么。
要点建议
- Anthropic 指控三家实验室通过超过 2.4 万个欺诈账号与 Claude 进行了超过 1600 万次交互;其公开报告呈现的是公司的归因,而非独立裁定。
- 蒸馏使用一个模型的输出训练另一个模型,可以是合法的技术;具体使用是否获得授权取决于实际情况。
- Anthropic 描述了 DeepSeek、Moonshot AI 和 MiniMax 不同的活动模式和目标任务,批评者则质疑观察到的交互数量是否足以证明所指控的目的。
- 对 Anthropic 自身处理版权材料的批评有不同的法律背景:2025 年一家法院区分了用于训练的复制行为与保留盗版图书的行为。
- Berman 对各国相对能力的结论,以及另一项关于芯片的指控,属于推测或有特定来源的说法,不能证明实验室的实际做法。
按章节阅读整理后的全文
Anthropic 的指控
Berman 介绍 Anthropic 于 2026 年 2 月对 DeepSeek、Moonshot AI 和 MiniMax 提出的指控,并概述公司报告及其引发的批评。
Anthropic 点名 DeepSeek、Moonshot AI 和 MiniMax,指控它们通过所谓的工业规模蒸馏攻击从 Claude 提取数据。这些实验室推出的开放权重模型受到广泛关注,但事情比一项指控复杂:网上的反应也质疑了 Anthropic 自身的训练做法。
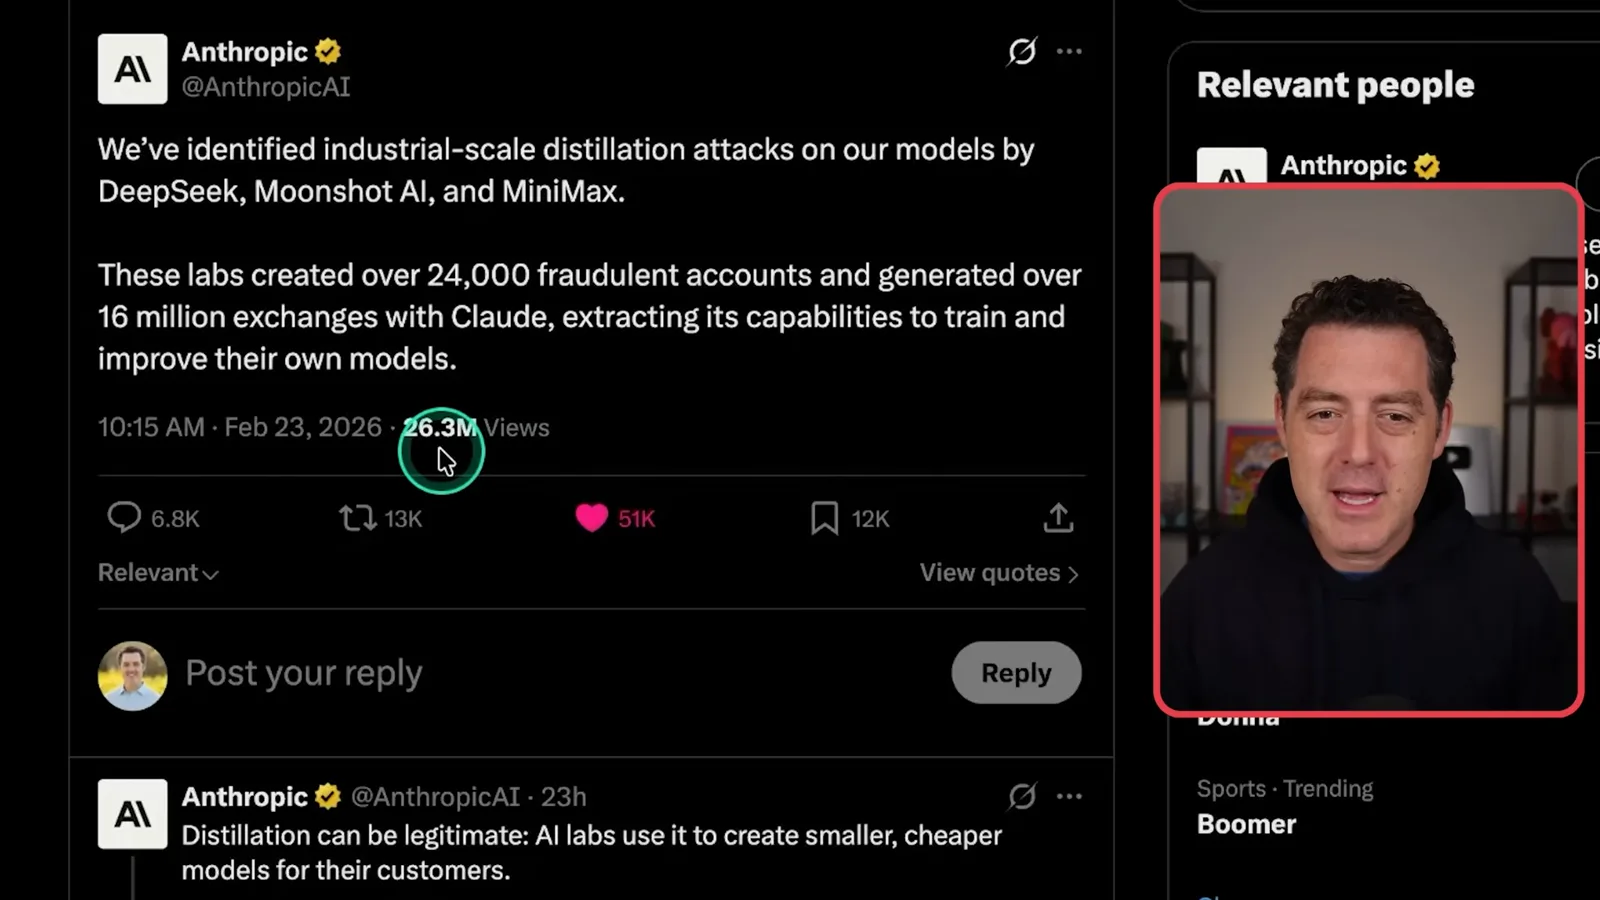
Anthropic 在 2026 年 2 月 23 日的公告中表示,这三家实验室创建了超过 2.4 万个欺诈账号,与 Claude 进行了超过 1600 万次交互,以便为自己的模型提取能力。这是 Anthropic 的叙述和归因;公开公告并非法院认定这些实验室按指控使用所得数据的判决。
蒸馏如何运作
他解释蒸馏及其常见用途,然后介绍 Anthropic 对安全防护和国家安全的警告。这些是公司的风险论点,并非特定下游用途发生的证据。
蒸馏是一种常见技术:用较强模型的输出训练较小的模型。它可以用部分质量换取速度和更低的成本,使模型适合本地部署或作为前沿服务的更快版本。蒸馏本身并不天然不正当;争议在于如何访问和使用另一个模型。
Anthropic 认为,一家实验室可以利用另一个模型的答案更快、更便宜地获得能力,并警告用这些输出训练的模型可能不会保留原有安全防护。公司提出了潜在的军事、情报、监视、生物和网络风险。这些是公司表达的担忧,并不能证明这些特定用途已经发生。
我的理解是,竞争对手可能不必独立收集和准备一次训练所需的全部数据,而是从现有模型获取高质量的问答材料。Anthropic 还认为蒸馏可能削弱美国芯片出口管制的效果;我认为它担心的是,即使硬件访问受限,模型仍可能通过另一条路径获得能力。
被指控的活动有何不同
Berman 回顾 Anthropic 宣称的归因,以及它与各家实验室关联的任务和流量,并讨论公司提出的应对措施。
Anthropic 表示,相关活动使用了欺诈账号和代理服务,其模式不同于普通使用。公司称,它利用 IP 关联、请求元数据、基础设施指标,以及某些情况下行业合作伙伴提供的信息,以高度信心对这些活动作出归因。这些是 Anthropic 报告的指标;外界仅凭公告无法独立查看底层证据。
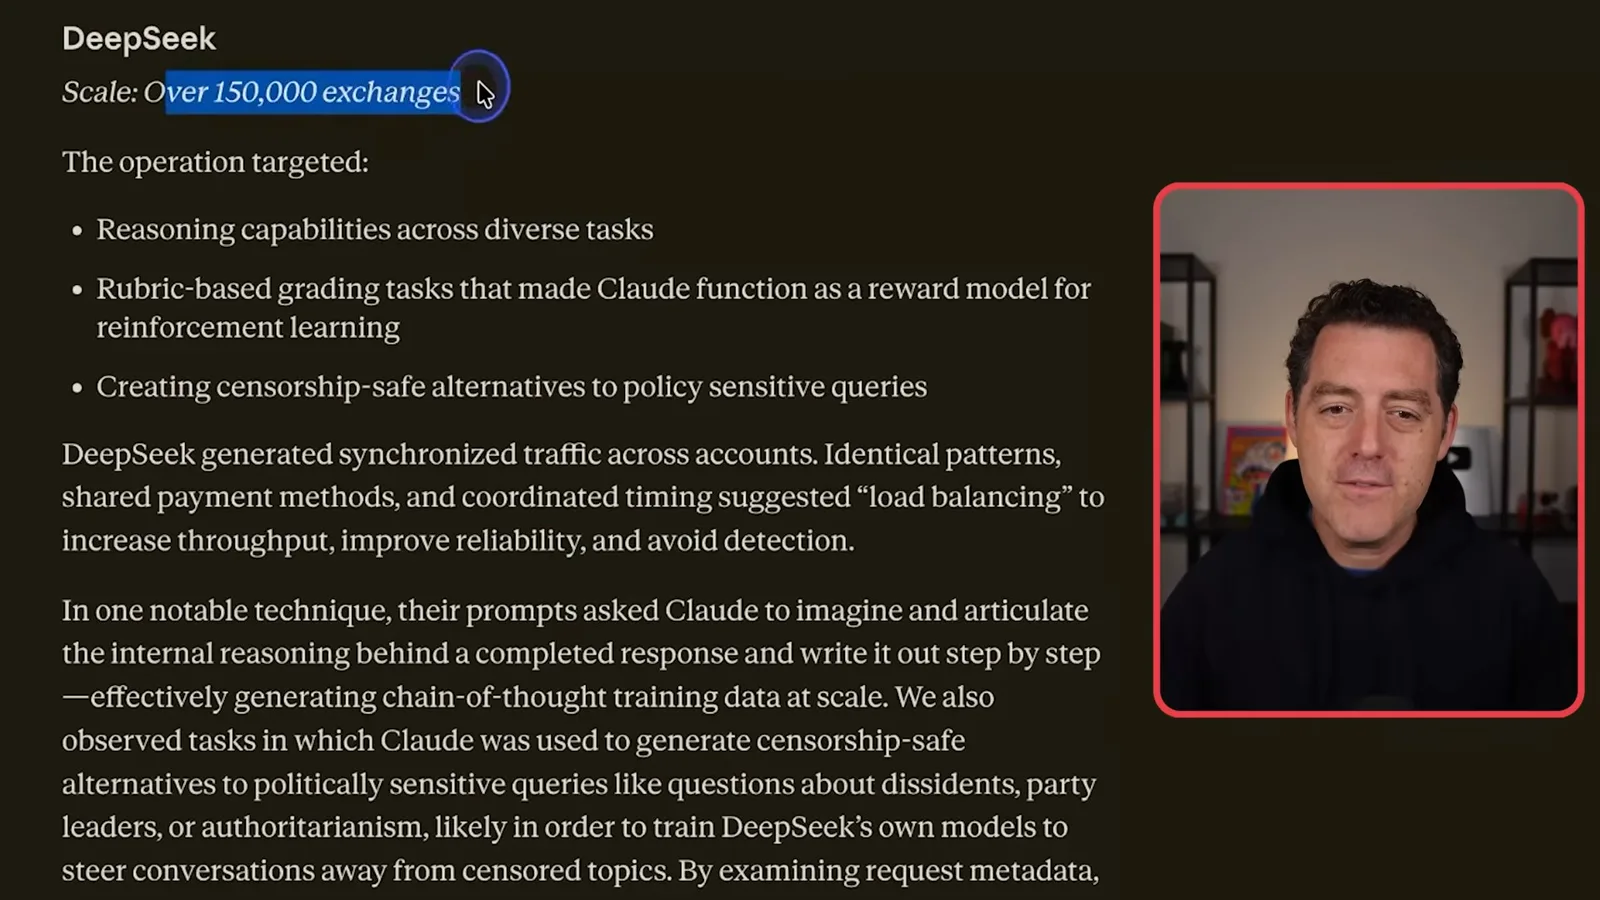
关于 DeepSeek,Anthropic 报告了超过 15 万次交互,我最初觉得这个数字出奇地小。公司表示,请求针对推理、可充当奖励信号的量规式评分,以及政治敏感问题的替代表述。它还将同步账号流量和共享支付方式描述为协调进行负载均衡的迹象。
Anthropic 特别指出,有些提示词要求 Claude 想象并逐步阐述已完成答案背后的推理。这类回答可以提供合成的推理式训练材料,但模型想象出的解释并不能证明它揭示了真实隐藏的内部推理。Anthropic 根据观察推断存在训练目的;公开描述本身并不能独立证实后续训练及其效果。
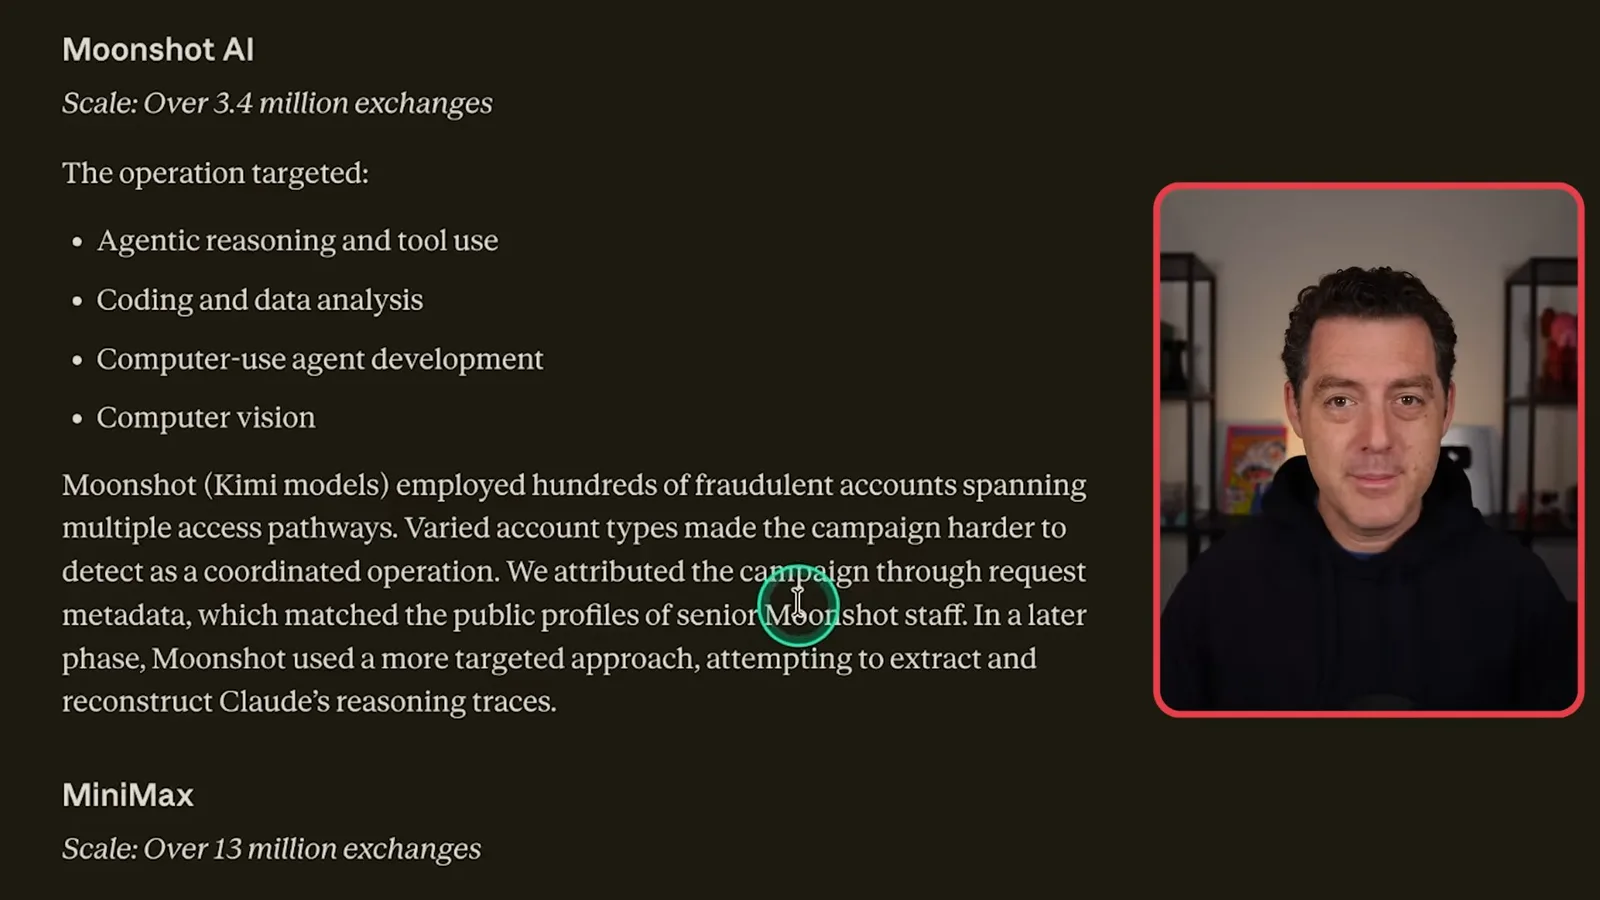
Anthropic 表示,Moonshot 的活动涉及超过 340 万次交互,目标包括智能体推理、工具使用、编码、数据分析、计算机操作和视觉。公司描述了跨访问渠道的数百个账号,并称请求元数据与 Moonshot 高级员工的公开资料相符。我想知道蒸馏是否有助于解释某些模型出色的工具使用能力,但这种联系是我的推测,并非经过测量的因果结果。
对于 MiniMax,Anthropic 报告了超过 1300 万次交互,重点涉及智能体编码、工具使用和编排。公司表示,它在活动进行期间观察到了相关行为,并看到请求转向更新的 Claude 模型。公司称其应对措施包括改进检测、情报共享、访问控制和其他对策。
版权与各方反应
网上批评者提出 Anthropic 自身使用版权作品的问题。Berman 还讨论了对 DeepSeek 流量的一种质疑性替代解释。
网上反应转向了 Anthropic 自身的训练数据。一条拟议的社区注释指控它使用了被盗材料,人们还提到了涉及书籍和歌曲的诉讼。这些案件需要仔细区分:2025 年,一位联邦法官认定案件中使用书籍训练模型属于合理使用,但认定 Anthropic 保留集中盗版图书库的行为不属于合理使用。图书案提出了 15 亿美元的和解方案;另一起音乐出版商诉讼要求损害赔偿,那是诉讼指控,并非 30 亿美元的和解。
埃隆·马斯克也批评了 Anthropic,而有人则就他自己的公司 xAI 的训练做法向他提出质疑。我看到的是一场更广泛的争论:AI 公司是否未经许可依赖版权材料。不过,我笼统地声称每家前沿实验室都使用被盗数据,只是一种观点,不能由这种概括推断版权状态、授权、盗版和法律责任。
我提到一项研究:研究人员通过提示让较早版本的 Claude 复现了大量《哈利·波特》文本,并将其视为训练数据争论中的证据。文本复现可能引出有关记忆的严肃问题,但它本身不能确定准确的训练语料,也不能解决其来源的法律地位。
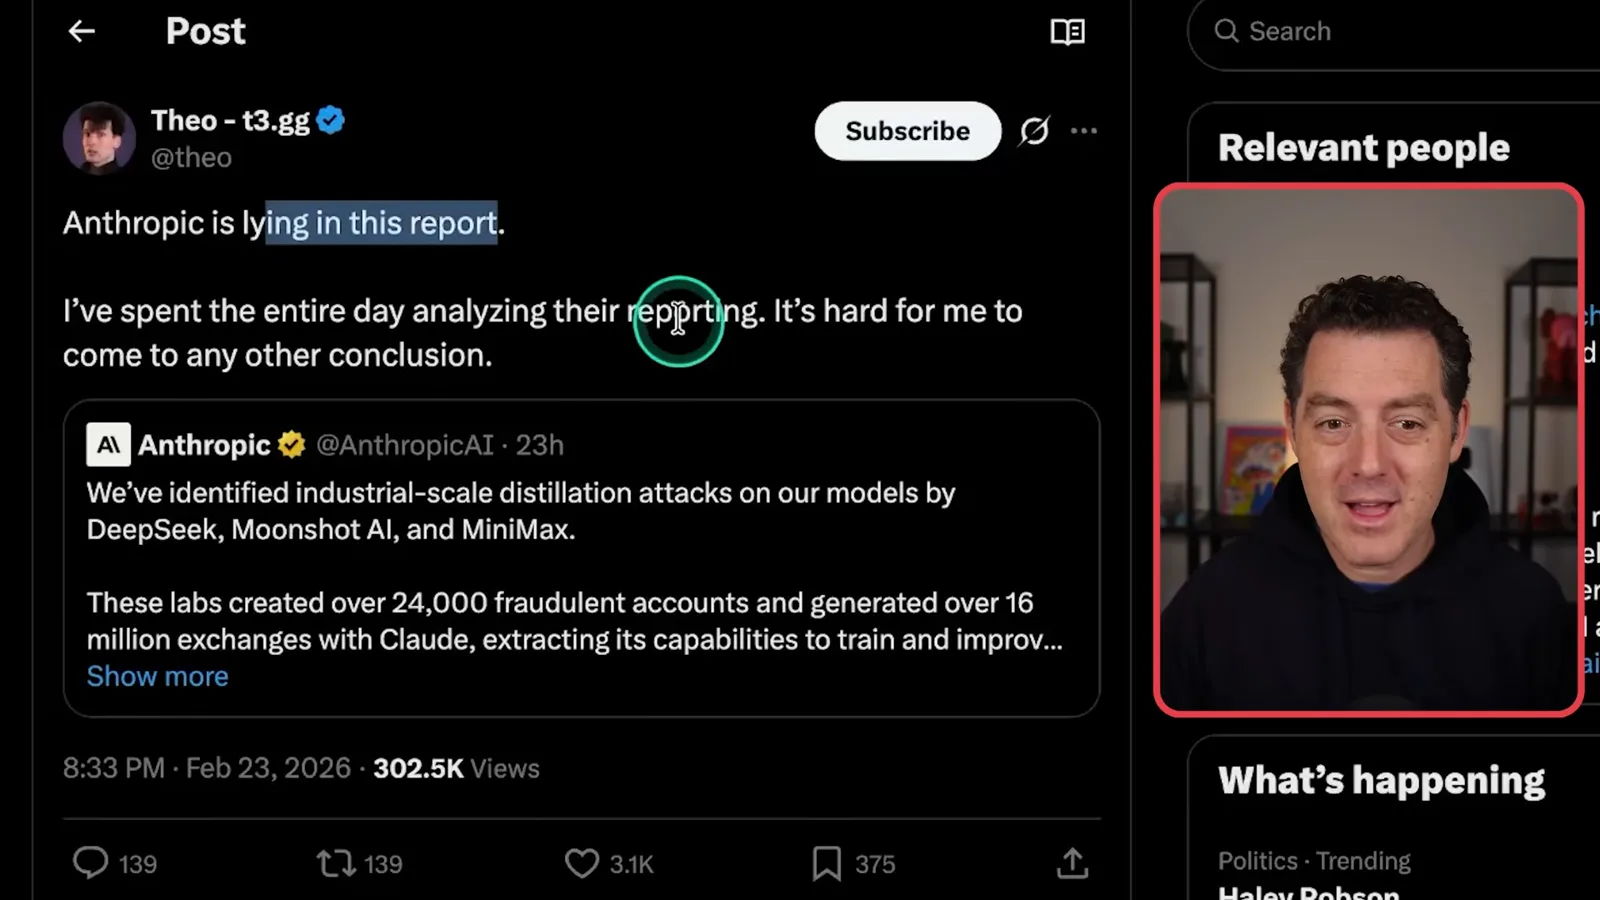
开发者 Theo 质疑 Anthropic 的报告,认为所报告的 DeepSeek 15 万次交互可能符合普通基准测试的情况;他将这一数量与自己 T3 Chat 服务的每日用量进行了比较。他指控 Anthropic 撒谎,并邀请公司在他有所遗漏时私下提供更多信息。他的指控是一种说法,并非刻意欺骗的证明;单凭交互数量也不能确定是基准测试还是蒸馏。
我指出 Theo 没有底层请求数据,并认为对推理过程的详细请求可能难以用普通基准测试解释。即便如此,视频中可获得的公开证据并不能确定每项请求的确切目的。争议既涉及观察到的模式,也涉及能从中合理得出什么结论。
地缘政治说法与待解问题
Berman 发表对竞争的看法,并讨论另一项关于受限制芯片的指控。他最后质疑人们认为训练数据处理方式存在的不一致。
我说这项指控不会让我感到意外,并对中国的商业竞争作了宽泛概括,同时承认美国公司也面临过涉及知识产权的指控。这些关于国家和文化的概括是我的观点,不能证明任何特定公司做过什么。
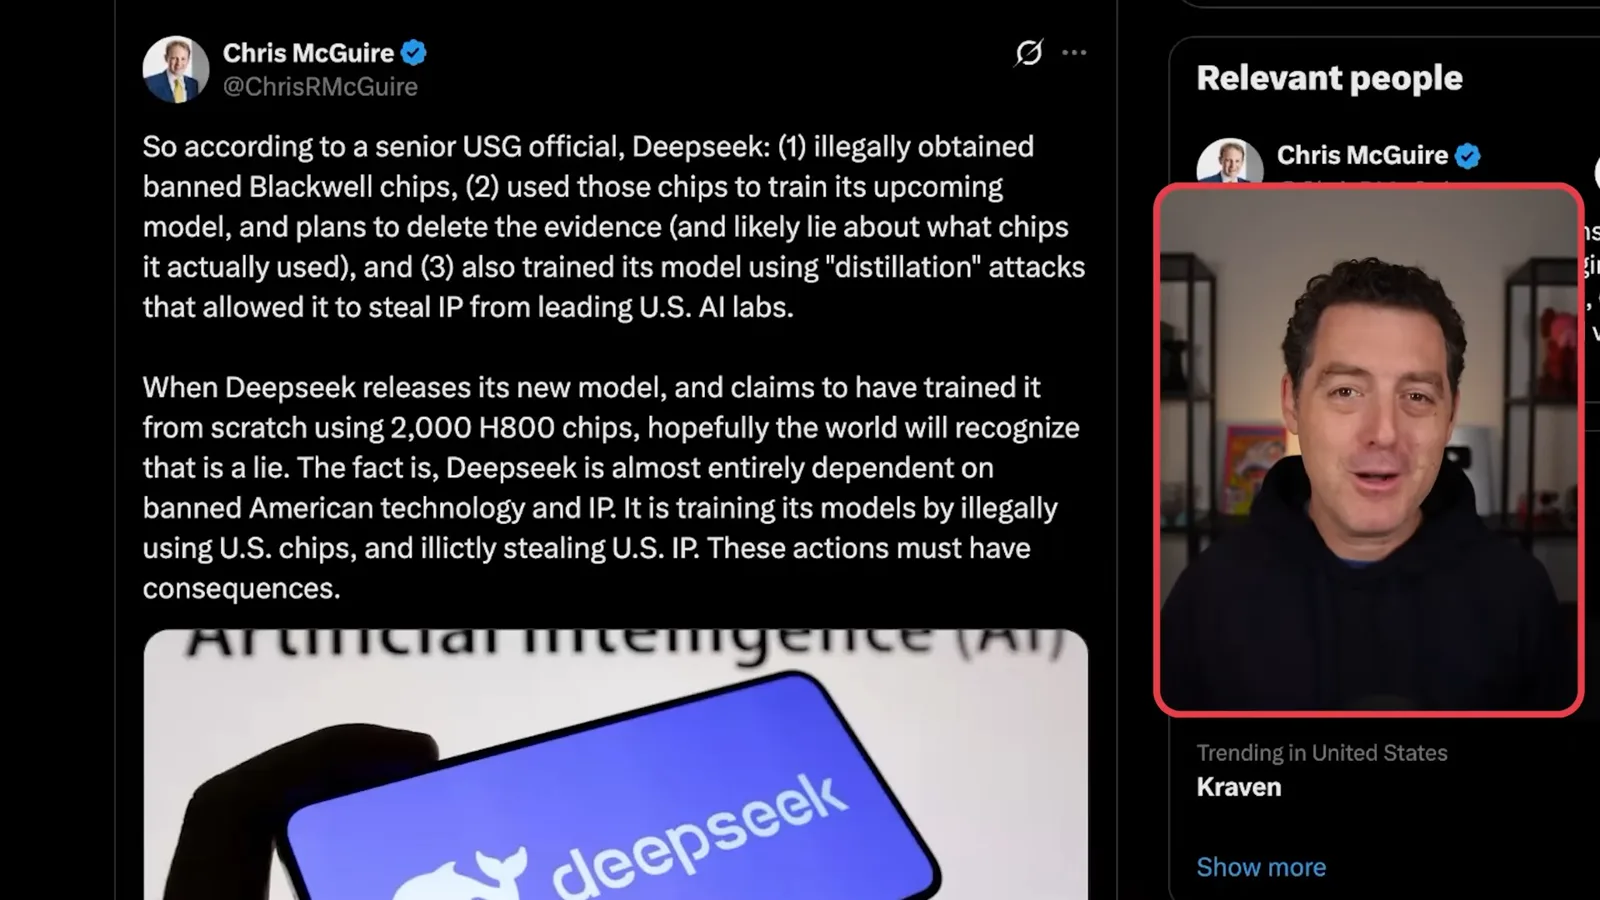
接着我讨论了一篇帖子,它援引一名美国政府高级官员,指控 DeepSeek 获取受限制的 Nvidia Blackwell 芯片,用它们训练未来模型,并打算掩盖证据。这是一项单独且有明确来源的指控;帖子和本视频都不能证明违规行为发生过,也不能证明所声称的计划。
我推测这些指控可能意味着美国实验室的领先优势比我想象的更大,并认为中国开放权重模型公司高度依赖美国模型和硬件。这一推论超出了所展示的证据:公司的指控和芯片说法不能证明中国实验室缺乏自己的研究,也不能确定 AI 能力的整体格局。
剩下的问题是:当一家 AI 公司因训练自身模型所用的材料受到批评时,该如何看待它反对另一家实验室使用其输出?我认为人们是在回应他们所认为的虚伪。两种情况的事实和法律问题各不相同,尽管两者都值得审视。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。