30 秒看懂
Theo Browne 回应 ThePrimeagen 对 AI 订阅经济变化的担忧。他认为,算力容量和智能体工作负载的差异,与财务可持续性同样值得关注,并将历史例子和个人假设与经过验证的供应商成本区分开。
- 1为什么请求的成本不同短回答和长时间运行的智能体会话,即使都按一条消息计费,也可能消耗截然不同的资源。
- 2单个模型与整家公司Amodei 的假设例子区分了一款模型的经济性和整个企业不断增长的投资。
- 3训练阶段Theo 区分预训练和后训练,同时指出专有模型的具体成本与方案并未公开。
- 4个人与商业套餐条款与数据处理方式不同;视频中的 AI 法律解读并非权威法律结论。
- 5每个有用结果的成本Theo 比较历史基准中综合分数相近的运行成本,并提醒基准不能代表所有工作负载。
要点建议
- 单条消息的计费单位可能掩盖不同智能体运行之间巨大的算力差异。
- 容量约束和收入动机都可能影响订阅政策。
- 模型收入、服务成本、研究支出和公司现金流是不同的概念。
- 预训练和后训练成本因模型而异,而且常常没有公开。
- 一项基准的运行成本无法证明每项任务质量相同或都能节省费用。
- 应根据当前资料核对个人和商业条款、隐私选择及数据保留要求。
按章节阅读整理后的全文
关于订阅经济的分歧
Theo 回应 ThePrimeagen,认为应更加重视算力约束。两人都认为产品正在变化。
我在开发中越来越多地使用 AI,而我的朋友 ThePrimeagen 对它更持怀疑态度。他在关于 AI 经济的视频中认为,目前订阅服务的慷慨程度正在变化。我同意他的许多核心观点,但我认为算力容量和模型训练的经济问题还需要更细致地讨论。
Prime 从一项据报道涉及 Claude Code 和 20 美元套餐的定价页面测试谈起。所谓“假门测试”,可以展示拟议价格并衡量兴趣,而不一定真正实施。我认为可能的变化是在管理高成本需求和有限算力;但这里并没有证实公司全部动机或测试结果。
使用额度与容量
消息数量、重度使用和高峰时段让固定订阅变得复杂。具体动机和内部成本仍不确定。
这个问题比那次测试更早出现。Cursor 过去部分按消息数量收费,但不同请求的成本可能相差极大:一条消息可能只需要简短回答,另一条却可能启动很长的智能体运行。Cursor 需要向模型供应商支付推理费用,因此固定消息数可能带来非常不均衡的成本。
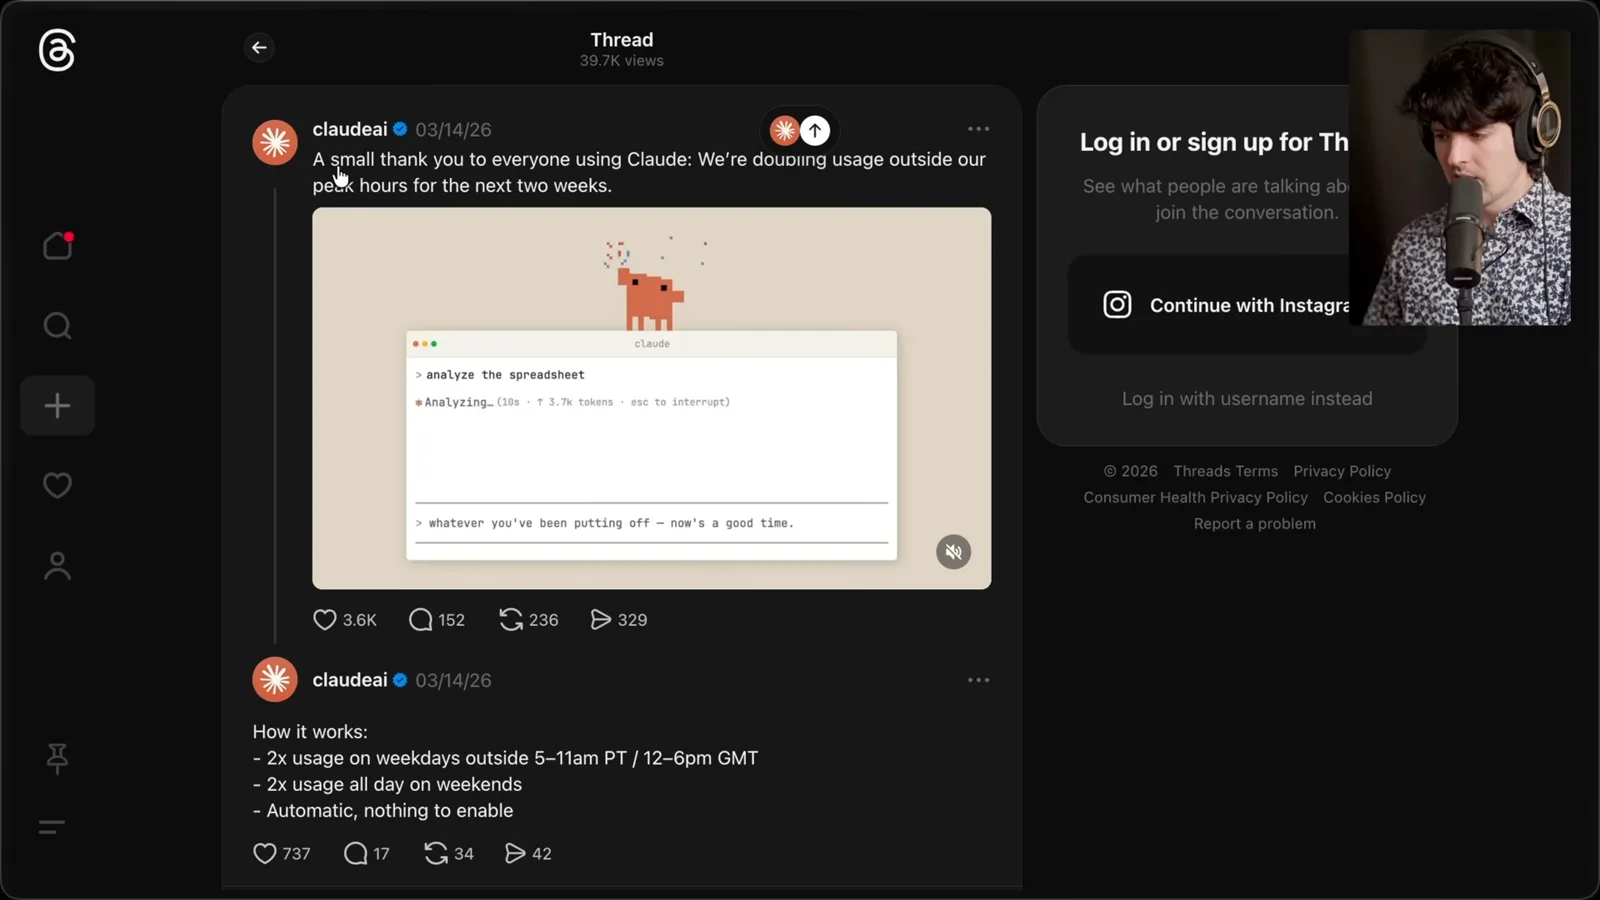
Anthropic 曾试行提高非高峰时段的使用额度,随后调整高峰时段的五小时限制,而当时每周限制保持不变。我认为这是为了把需求引向硬件较空闲的时段。这种解释有一定道理,但实验的内部结果并没有公开证据。
我听说过一些估计:重度用户通过 200 美元订阅获得的推理,如果按 API 标价计算,价值可能达到数千美元。但这种比较不等于供应商的真实内部成本,也不能证明每个订阅者都获得了同样额度的补贴。请求组合、合同价格和供应商自身成本结构都不公开。
我的假设是,企业需求和稀缺容量对 Anthropic 决策的影响,可能大于单纯促使个人订阅者升级。但收入和容量都可能重要,这段讨论中的公开证据无法确定各个动机的具体权重。
服务成本与训练投资
Prime 对被忽略成本的担忧引出一个假设例子,区分模型经济性与公司整体现金流。
Prime 认为,如果忽略模型研发成本,单次请求看起来的利润率可能具有误导性。一次请求的收入可能高于即时服务成本,但企业仍需要承担硬件、训练、员工、研究及其他费用。收入本身并不等于利润。
我同意重度订阅会让情况更复杂,但我提到的电费和推理成本数字只是估计,不是经过审计的供应商账目。电价因地区而异,总服务成本也不能等同于电费。要有意义地分析盈利能力,需要实际用量、容量成本和固定成本分摊数据。
Dario Amodei 举了一个刻意简化的例子:花 1 亿美元训练模型,随后从该模型获得 2 亿美元收入,同时为下一个模型投入 10 亿美元。从公司整体时间线上看,不断增加的投资可能造成亏损,即使某个模型的收入超过了分配给它的训练和服务成本。
这个例子帮助区分单个模型的经济性和整体现金流,但它不能证明任何具体模型的实际利润。结论还取决于是否合理分配共享基础设施、研究和服务费用。即使前一个模型具有商业价值,快速增长的投资也可能超过当前收入。
Prime 担心,一个很快被替代的模型可能无法收回成本。我认为要看新版本是否需要重新预训练,还是在现有基础上迭代。后续版本可能复用大量工作,但专有模型的确切训练历史和成本通常没有公开。
预训练与后训练
Theo 解释一个简化的区别,并提醒专有训练方案及成本并未公开。
粗略地区分,预训练从数据中构建广泛的表征,后训练则通过额外方法塑造和改善行为。这是简化说法:两者都可能影响能力,其边界和成本取决于具体训练过程。
强化学习和其他后训练技术可以改善编码、工具使用等任务的表现。其他组织也可以在开放权重的基础模型上继续适配,视频中讨论的 Cursor Composer 2 就是例子。权重开放并不意味着这项工作简单或免费。
我预计许多迭代的成本会低于从头预训练,但也有重要例外:后训练本身可能消耗大量算力。我对哪些 Opus 版本复用了基础模型、具体花费多少的猜测,并非 Anthropic 的披露。发布节奏和使用体验不足以证明训练方案。
Prime 提到 OpenAI 的一笔巨额投资,并将其换算成估计的每月资金消耗。融资条款、支出周期和现金流需要单独核实,才能把这个计算当作财务事实。他更广泛的担忧是,这些服务最终必须能够承担自己的成本。
Copilot、请求倍率与容量
长时间运行给按请求计费带来挑战。仅凭显示的倍率无法确认 Microsoft 的内部定价原因。
讨论转向 GitHub Copilot 从简单按请求数计费的方式转变。Prime 强调不同模型的成本不同。我认为还有一个问题:即使使用同一个模型,两个请求消耗的算力也可能截然不同,尤其是其中一个运行工具长达数小时的时候。
按请求数收费,就像只按购物车中的商品数量收费,而不考虑具体是什么商品。模型倍率可以部分区分模型,但未必能反映短回答和长时间智能体会话之间的差别。我自己长时间运行的例子说明,这种计量单位可能不够贴合成本。
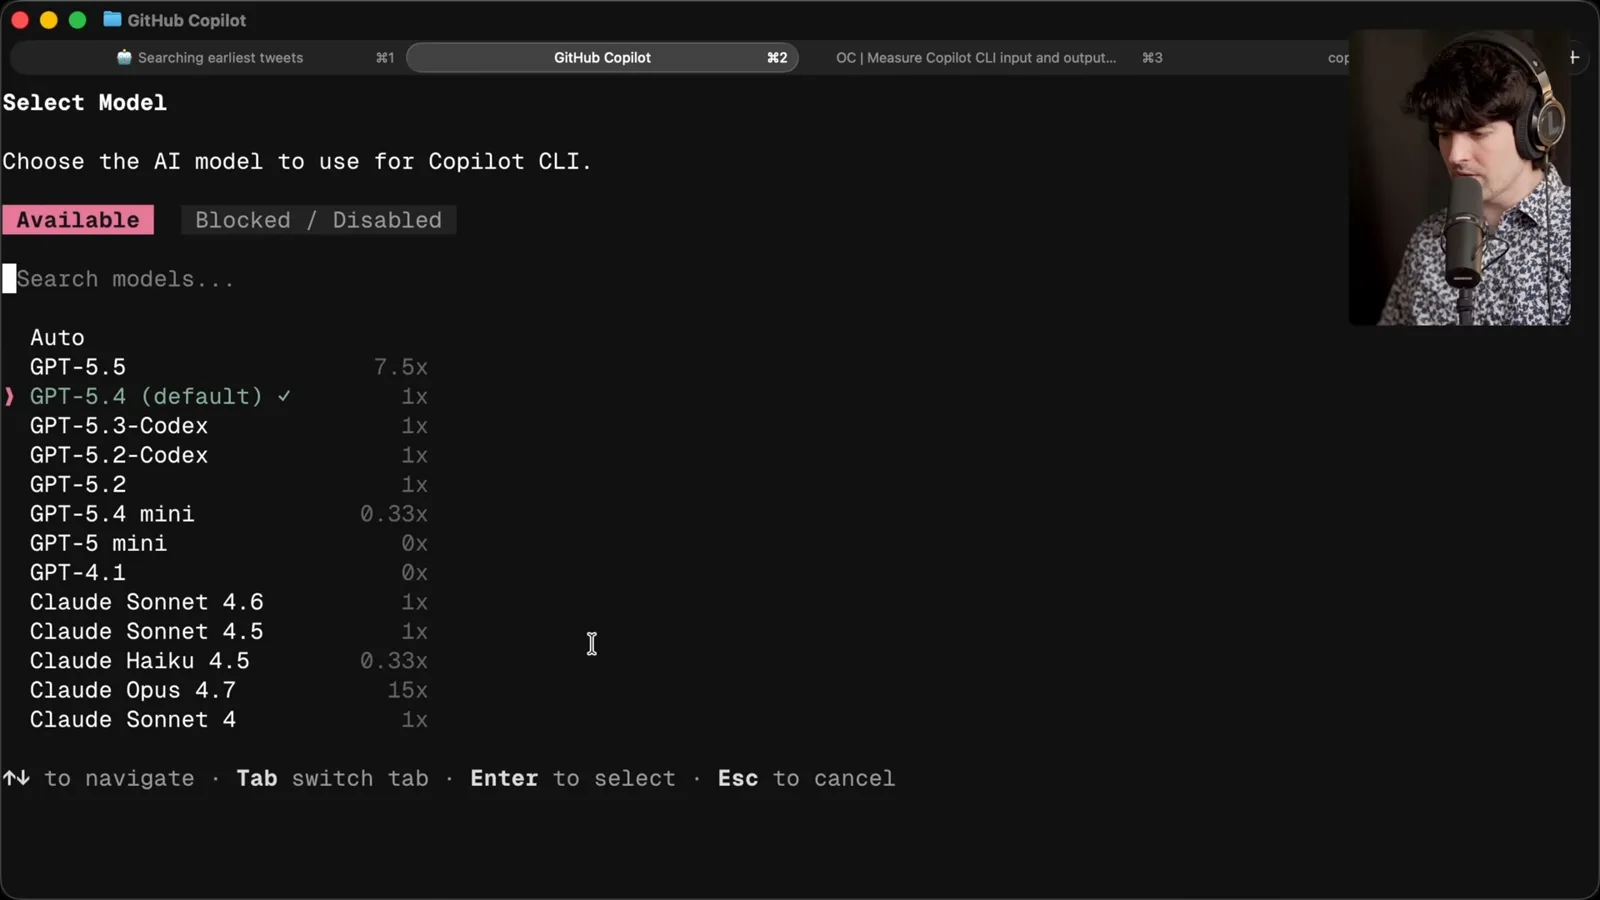
我展示的界面中,GPT-5.4 的请求倍率为 1×,GPT-5.5 为 7.5×,Claude Opus 4.7 为 15×。这些是当时显示的设置,不是当前价格。我估计自己的长时间运行按 API 价格计算可能很昂贵,但这并不是对 Microsoft 内部成本的测量。
我认为,供应商容量和机会成本可能影响定价与访问:服务一个工作负载的 GPU,不能同时以相同方式服务另一个工作负载。财务利润率也可能重要。仅凭公开倍率,无法确定 Microsoft 如何权衡容量、API 成本、产品策略和收入。
我把一项据报道的暂停注册视为容量可能限制增长的迹象。暂停可能有多种运营和商业原因,因此不能单凭它证明唯一动机。Prime 和我都同意订阅经济正在变化,但对各个驱动因素的重要程度看法不同。
Google 与企业支出
现金不能立刻创造算力。Theo 还比较了个人订阅与商业服务安排。
Prime 将拥有其他盈利业务的 Microsoft 与为研究融资的模型实验室作对比。我认为,有现金并不会立刻创造更多芯片或数据中心容量。即使是富有的公司,也可能受到硬件供应和交付周期限制,但这并不意味着它不需要管理成本。
需求超过容量时,服务限制新订阅是有先例的。我引用了此前 ChatGPT Plus 暂停注册的例子。它说明运营限制可能影响访问,但不能证明其他公司后来所有订阅变化都有相同原因。
Prime 认为 Google 的财务实力是一项优势。我同意 Google 拥有大量资源,但也指出它向用户提供了无需单独付费的 AI 功能,包括搜索体验。用户免费使用的功能仍会在某处消耗资源,但无法仅凭搜索结果看出其准确增量成本。
我还讨论了有关 Google 开发工具限制和模型访问补贴的报告。我对这些产品的评价属于主观判断,而所举例子无法证明 Google 的支出超过所有竞争对手,也无法揭示其内部容量分配。
不断增长的需求也可能影响直接购买推理服务的企业。Prime 提到一则关于 Uber AI 预算的报道;我认为企业 API 支出和个人订阅价格属于不同的经济安排。对某家公司支出或合同的说法需要独立证据,也不应推广到所有企业。
我比较了个人订阅与商业服务在条款、隐私和保留期限方面的区别。Anthropic 区分个人 Free、Pro、Max 条款与商业 API 和团队产品;具体工作用途是否获准,取决于适用条款和实际情况。视频展示的 AI 法律解读并非权威法律结论。
数据使用选择和例外情况也很重要。Anthropic 为个人用户数据用于改进模型提供选择,而商业数据处理遵循不同条款。组织应核对当前政策、合同和自身安全要求,不能假定所有个人套餐都会用所有数据训练,也不能认为一个设置就能解决所有问题。
基准效率和变化的价格
历史图表展示了每次基准运行的成本。Theo 最后同意 AI 经济正在变化。
Prime 并不预测世界会放弃 AI;他预计公司会找到可行模式,同时用户会看到限制和经济条件变化。我同意产品正在改变,但我怀疑有用工作所需的有效成本是否一定会随着订阅限制收紧而同样快速上涨。
模型的单 token 价格可以更高,但完成任务所需的 token 更少。当时展示的 Artificial Analysis 图表中,GPT-5.5 medium 和 GPT-5.4 xhigh 的综合分数相近,而运行测试套件的显示成本分别约为 1,199 美元和 2,851 美元。这是历史基准比较,不保证所有任务的质量相同或成本更低。
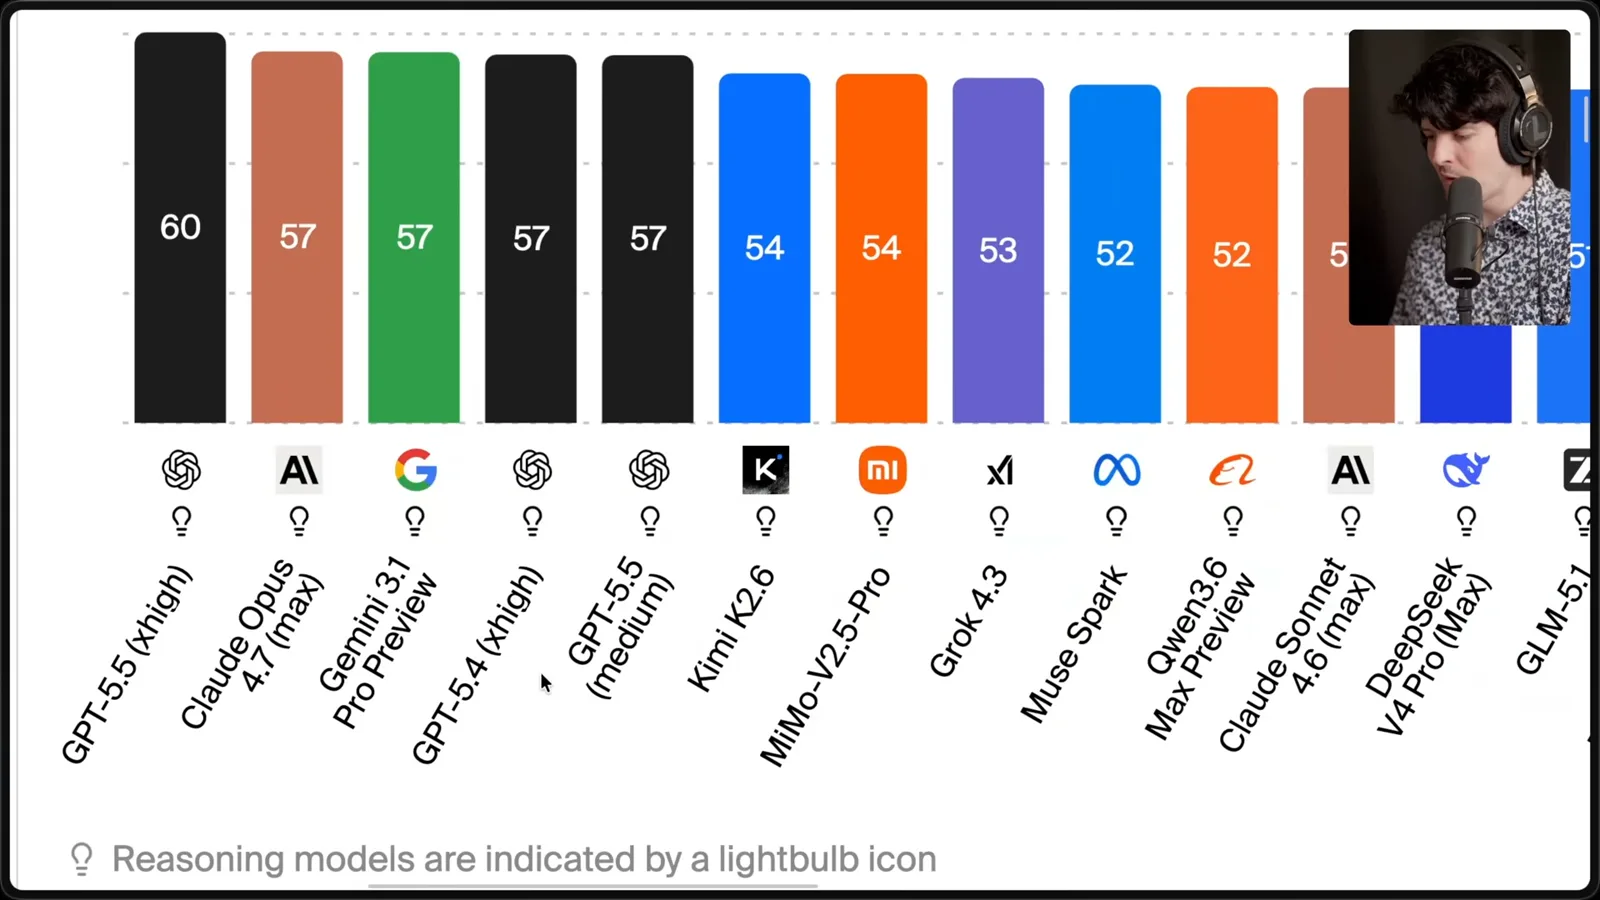
图表显示,GPT-5.5 xhigh 的基准成本约为 3,357 美元,GPT-5.4 xhigh 约为 2,851 美元,尽管单 token 的价差更大。总成本取决于基准、模型配置、token 数量和所用价格。重点是比较获得结果的成本,而不只是单个 token 的价格。
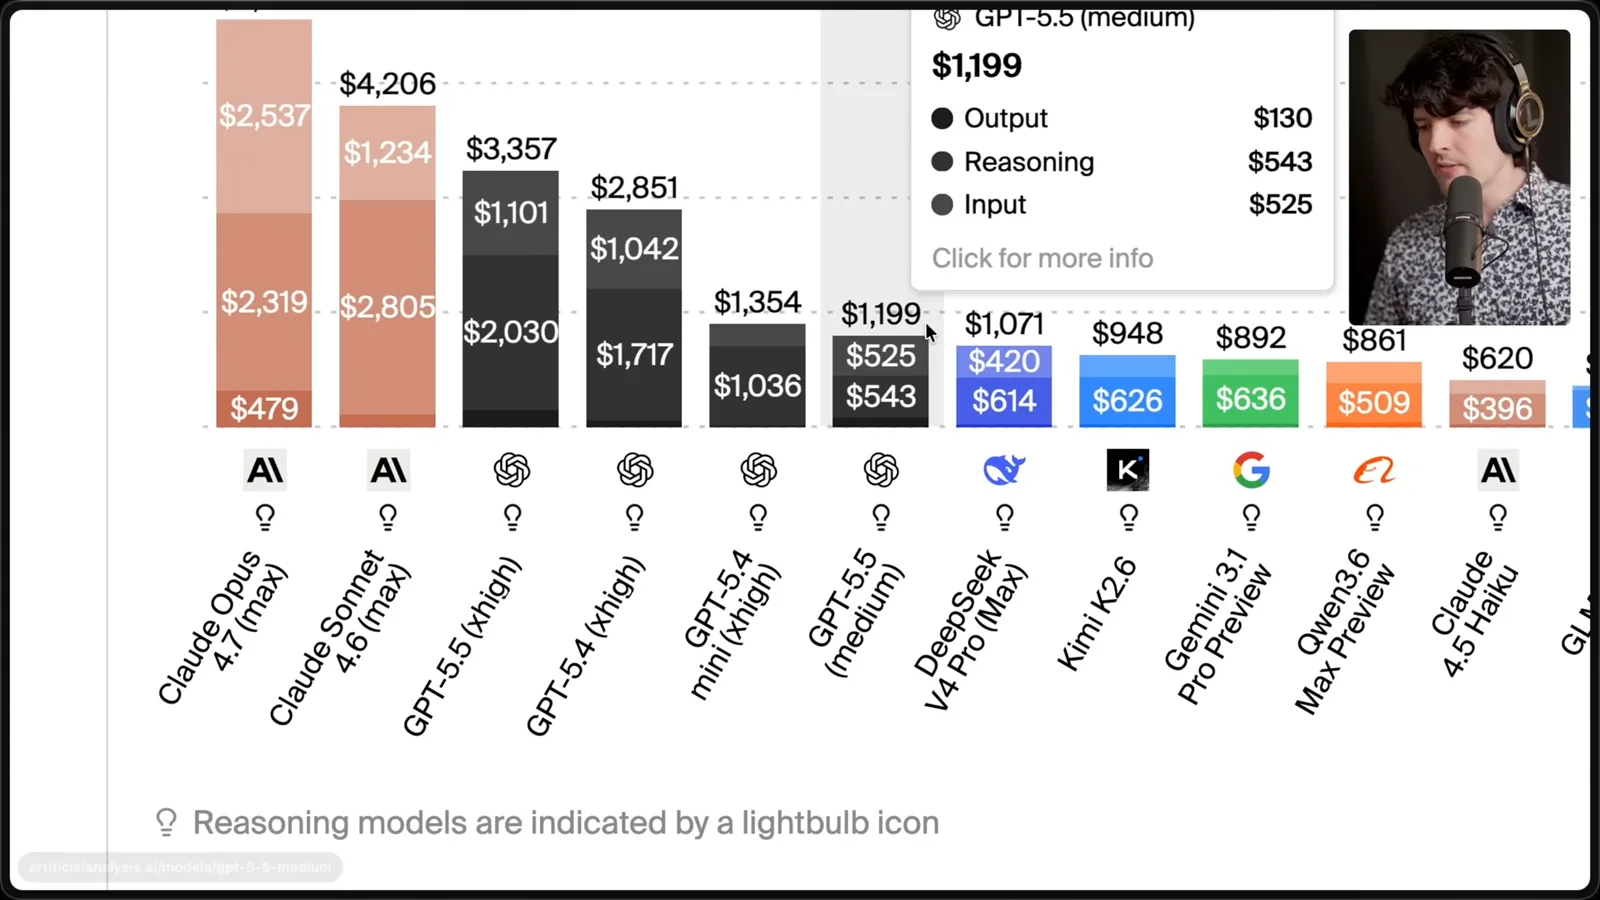
图中的 low 设置运行成本约为 500 美元,得分低于更高设置。对某些工作来说,这可能是有用的权衡,但单一综合分数无法涵盖每种任务、可靠性要求或偏好。团队应测试自己的工作负载。
图表还显示不同模型设置的 token 数量差异很大。即使最强设置仍然昂贵,效率提升也可能降低完成有用工作的成本。这不意味着每家供应商的成本都在下降;如果团队更多地使用 AI 或运行更长的智能体任务,总账单仍可能上涨。
我再次谈到 Copilot 的模型倍率,并推测稀缺容量和企业需求可能解释这一差距。这仍然只是我的假设:基准测试套件成本和供应商请求倍率衡量的是不同事物,两者都无法单独揭示供应商的内部经济情况。
Prime 和我在重要一点上是一致的:经济条件正在变化,用户不应假定如今慷慨的条款会一直不变。我对模型效率的改善更乐观,也更倾向于强调算力约束。我以前也修改过自己的预测,随着证据变化,我预计还会继续学习。
同频道的其他文章
 41:49EN → 简体中文
 Theo - t3․gg· 2026年10月29日Theo 演示如何用 T3 Code 协调编码智能体Theo · t3.ggT3 Code 的创建者介绍多个智能体提供方、远程机器、会话组织方式,以及开源编码界面的取舍。
 38:47EN → 简体中文Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。