30 秒看懂
2026 年 9 月,Matthew Berman 评测 DeepSeek V4.1 Flash。这是一款拥有 5520 亿参数的混合专家模型,采用非对称架构,KV 缓存更小。他讨论了 DeepSeek 公布的基准测试、发布时的 API 价格和可能的部署优势。 他的非正式测试显示,生成速度很快,但质量参差不齐:两个魔方程序的模拟行为存在问题,一幅肖像风格化但缺乏细节,水体冲击应用具有可调控件但模拟并不完善。这些演示并非全面的基准测试。
- 1公布的基准测试比较DeepSeek 的图表显示,模型在 DeepSWE v1.1 中得分 74.2,在 CyberGym 中得分 88.1。这些是厂商在特定测试条件下公布的结果,并不能证明模型在所有方面都更强。
- 2非对称混合专家架构据 DeepSeek 称,模型共有 5520 亿参数,输入时激活 80 亿,输出时激活 160 亿。
- 3更小的 KV 缓存DeepSeek 表示,缓存所需的 HBM 和 SSD 存储分别是上一代的四分之一和八分之一;这一比较针对的是缓存,而非整个模型。
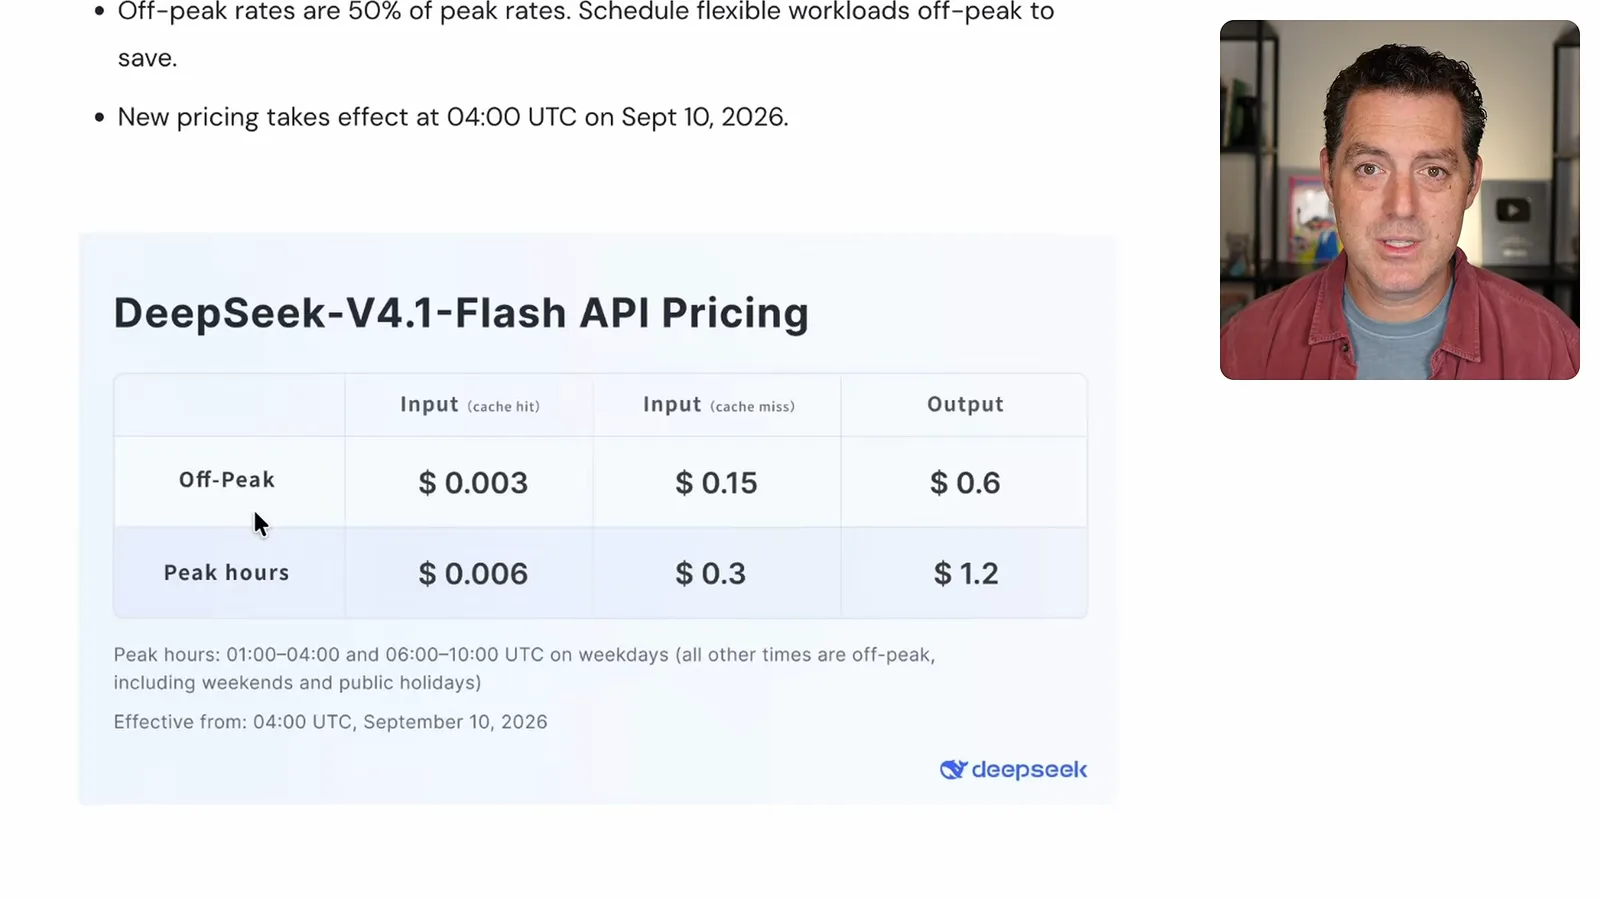
- 4发布时的 API 价格Berman 介绍了高峰和非高峰价格,其中每百万个未命中缓存的输入 token 分别为 0.30 和 0.15 美元,每百万个输出 token 分别为 1.20 和 0.60 美元。
- 5实际测试结果不一模型生成速度很快,但魔方模拟存在明显缺陷。其他测试生成了一幅风格化肖像和一个参数可调的水体冲击应用,但模拟逼真度有限。
要点建议
- DeepSeek 表示,模型共有 5520 亿参数,输入时激活 80 亿,输出时激活 160 亿。
- DeepSeek 称,新模型的 KV 缓存所需的高带宽内存和 SSD 存储分别是上一代缓存的四分之一和八分之一。
- 发布时的 API 价格根据高峰或非高峰时段以及缓存命中输入、未命中输入和输出而有所不同。
- Berman 的快速测试显示生成速度似乎很高,但魔方运行有缺陷,视觉结果也参差不齐。
- 开放权重和技术报告为部署和研究提供了选择,但本地运行仍取决于是否有足够的硬件和软件支持。
按章节阅读整理后的全文
基准测试声明与模型架构
Berman 介绍 V4.1 Flash 并查看 DeepSeek 的基准测试图表。他解释了公布的混合专家架构和非对称输入、输出架构。
DeepSeek V4.1 Flash 推出了,它兼具低价、速度和公布的基准测试成绩,引起了我的关注。我看到一个反复出现的趋势:前沿模型继续进步,开放权重模型随后接近先前一代的水平,未来部署可能也会变得更容易。但我自己做的少量测试并不总能达到基准图表所暗示的水平。
DeepSeek 将 V4.1 Flash 与 Kimi K3、GLM 5.3、Claude Opus 5 和 GPT 5.6 Sol 进行比较。图表显示,它在 Terminal-Bench 3.0 中得分 30.0,在 DeepSWE v1.1 中得分 74.2,在 CyberGym 中得分 88.1。图中 Opus 5 和 GPT 5.6 Sol 的 Terminal-Bench 得分都更高;表现取决于具体基准和测试条件。
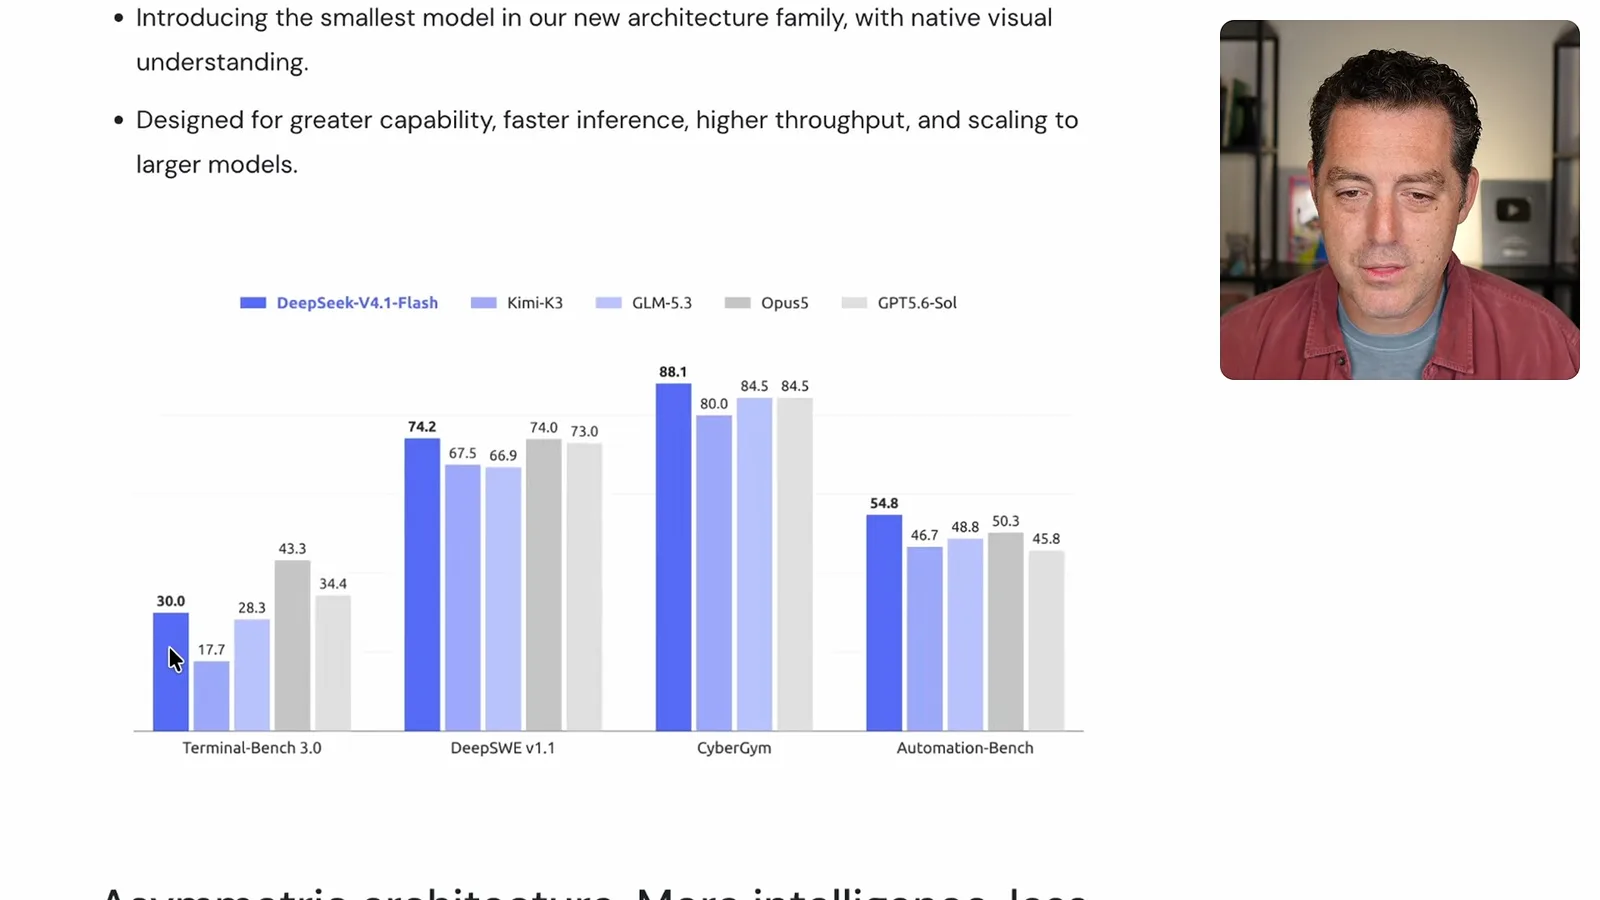
该模型共有 5520 亿参数。相比总规模,我对它的效率更感兴趣:混合专家模型会将工作路由到部分选定权重,而不是为每个 token 激活全部权重。这可以减少推理所需的计算量,但不意味着部署时不再需要考虑未激活的权重。
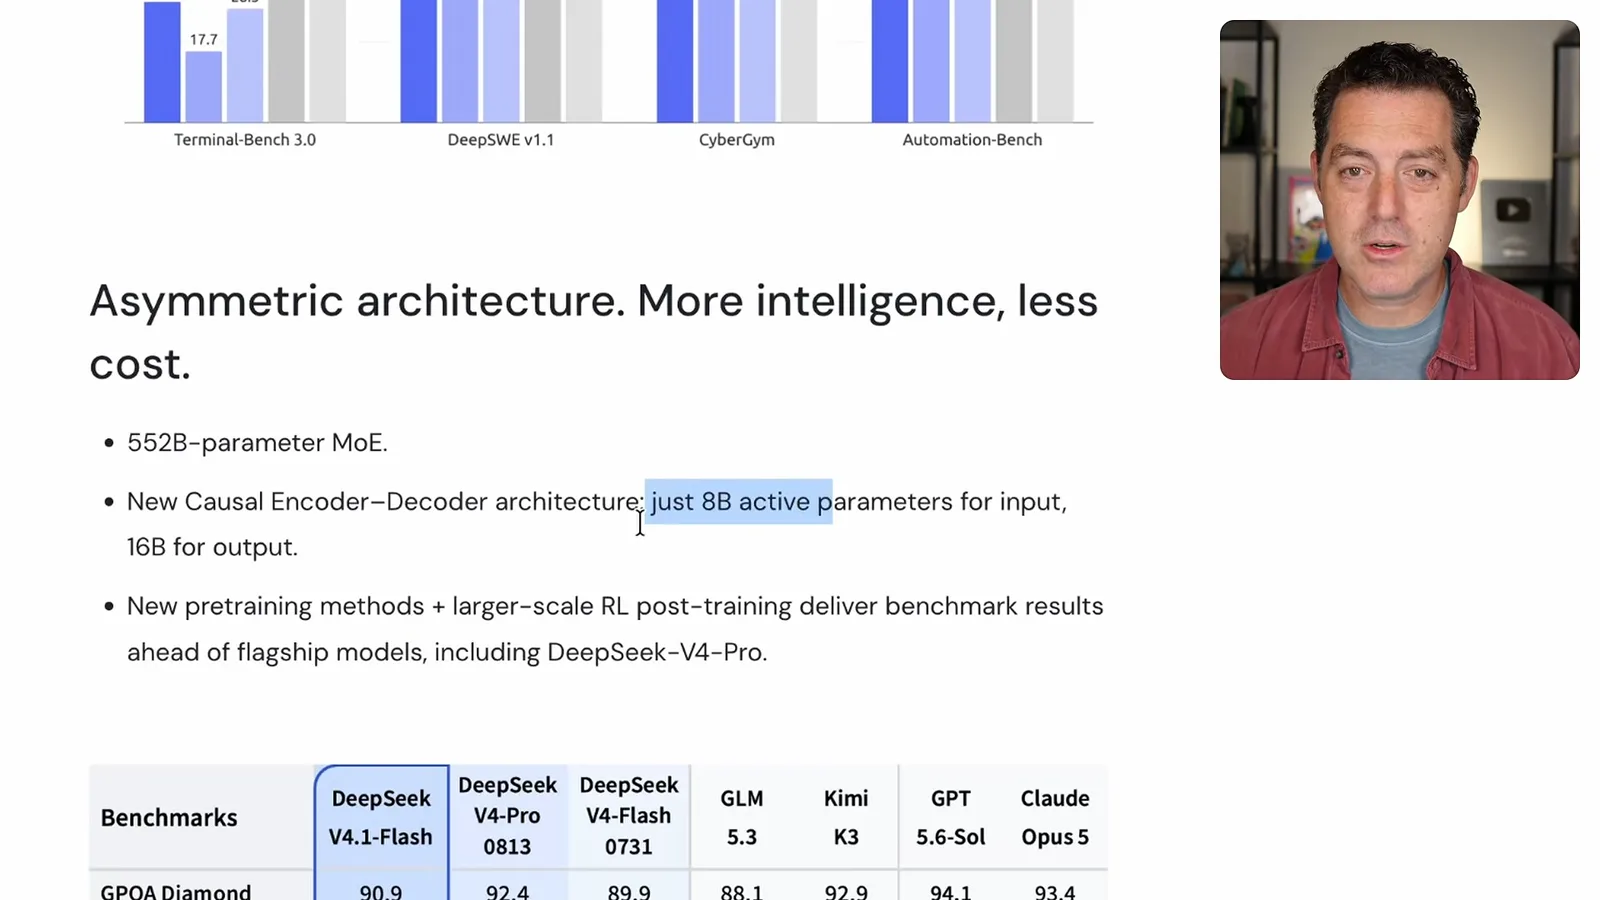
DeepSeek 介绍了一种因果编码器—解码器架构,输入时激活 80 亿参数,输出时激活 160 亿。公司将公布的性能归因于这种架构、新的预训练方法和更大规模的强化学习后训练。我的使用感受是,这个模型非常快,稍后我会演示。
模型在不同类别的基准测试中表现并不一致。DeepSeek 的 CyberGym 得分在展示的比较中领先,但 ExploitGym 得分低于表中几个竞争模型。这些是特定的公布测试结果,并不能证明某个模型在所有任务上都更好。
内存效率与价格
讨论转向 KV 缓存压缩、上涨的内存成本和模型发布时的 API 价格。Berman 思考了这些因素对开放权重部署及低成本工作负载的影响。
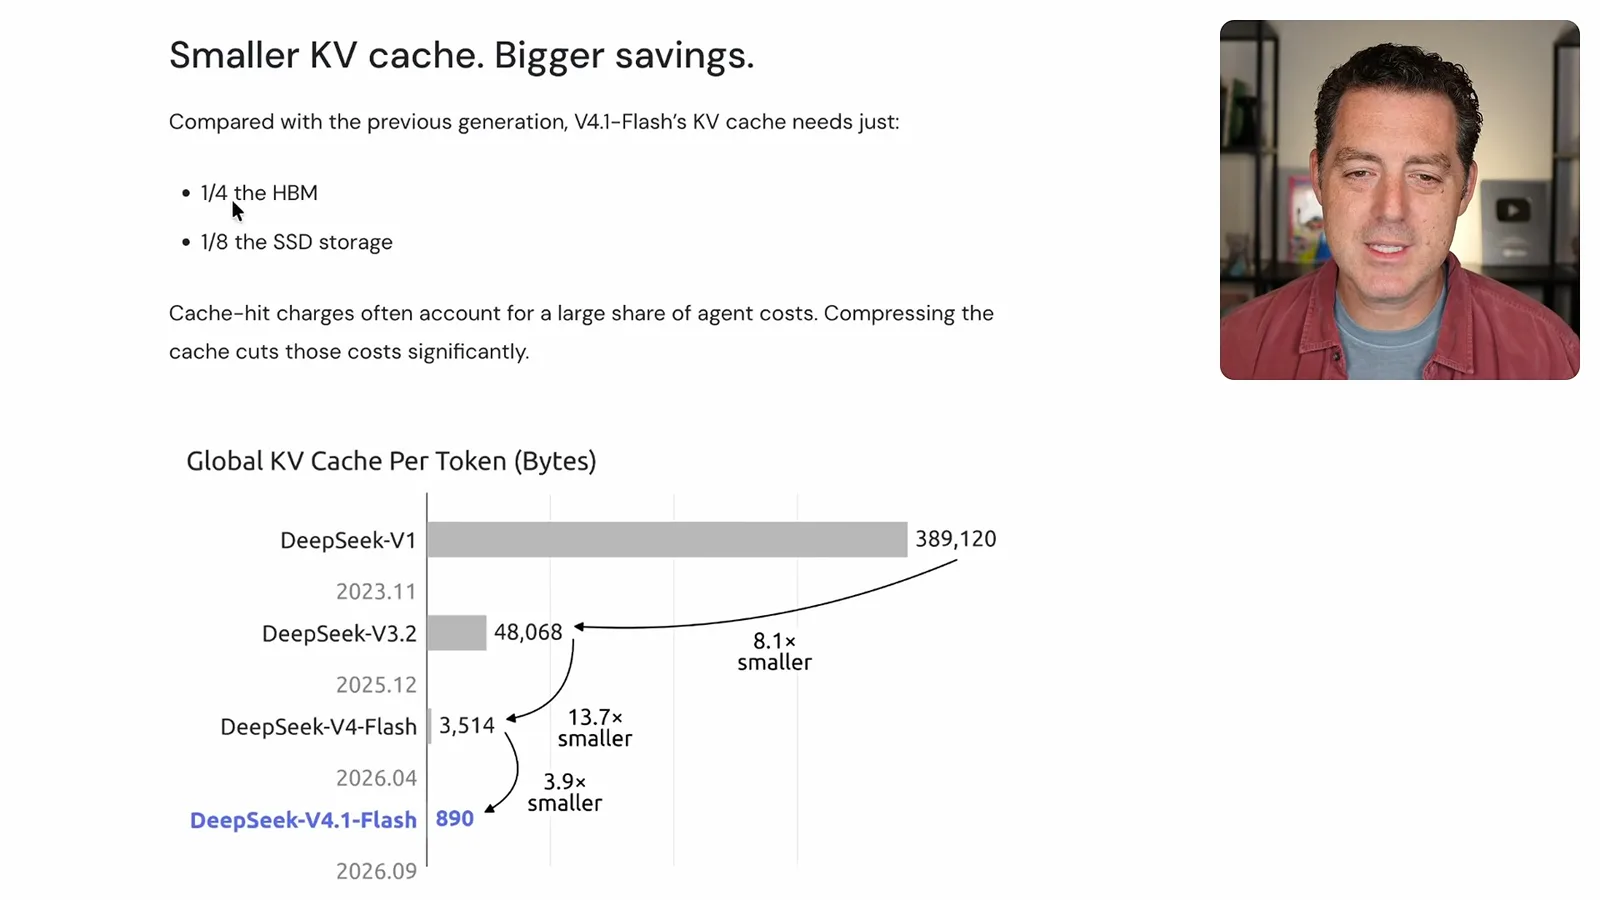
接下来是关于 KV 缓存的声明。KV 缓存存储生成过程中使用的注意力中间信息。DeepSeek 表示,V4.1 Flash 的缓存所需高带宽内存和 SSD 存储分别是上一代缓存的四分之一和八分之一。这是缓存之间的比较,并不是说整个模型的内存需求降到了四分之一。
我查看了显示内存价格上涨的图表,并将这种压力与 AI 需求增长和供应受限联系起来。高带宽内存是模型服务的重要成本,因此降低缓存需求可能很有意义。这些图表只是说明情况,具体产品的价格和涨价原因各不相同。
DeepSeek 的图表显示,从 V1 到 V3.2,再到 V4 Flash 和 V4.1 Flash,历代模型每个 token 的全局 KV 缓存字节数大幅下降。最新一代相对于 V4 Flash 又减少了约四倍。缓存占用更少,可能带来更高的吞吐量和更低的服务成本,具体取决于工作负载。
发布时的 API 价格区分高峰和非高峰时段。每百万个未命中缓存的输入 token,DeepSeek 标出的价格分别是非高峰 0.15 美元、高峰 0.30 美元;输出分别为 0.60 美元和 1.20 美元。每百万个命中缓存的输入 token 分别为 0.003 美元和 0.006 美元。这些是 2026 年 9 月展示的价格,并不代表当前价格。
模型权重可以下载,因此部署方式不局限于把数据发送给 DeepSeek 的托管服务。第三方云或本地环境也可能是选择,具体取决于硬件、实现和可用的量化方案。开放权重本身并不能保证普通电脑装得下一个拥有 5520 亿参数的模型。
DeepSeek 已因效率而闻名。我认为市场越来越明显地分成两类:最昂贵的前沿模型,以及速度更快、价格更低、足以完成许多任务的模型。我推测,制作网站或 PDF 之类的日常工作往往不需要最昂贵的模型,不过正确选择仍取决于质量要求和具体任务。
DeepSeek 还发布了介绍架构和技术的报告。这让其他研究者和开发者更容易研究其方法,并在现有资料基础上继续构建。不过,在考虑权重和报告的可用性时,仍需关注适用许可和实际部署限制。
速度与魔方测试
Berman 先演示生成速度,再测试两个魔方程序。他发现打乱和求解行为存在错误。
为了演示速度,我要求模型写一篇关于 DeepSeek 的千词文章。回答出现得很快;我估计速度约为每秒 200 个 token,总共用了约 6 秒,但这只是目测估计,并非受控测量。生成速度令人印象深刻,但速度本身不能证明结果正确。
我的第一个魔方模拟大约 12 秒就完成了,初看似乎还不错。但打乱时,行为出了问题:方块移动不正确,点击求解后魔方直接跳回原始状态。我也无法像预期那样操作单独的面,因此这个测试结果令人失望。
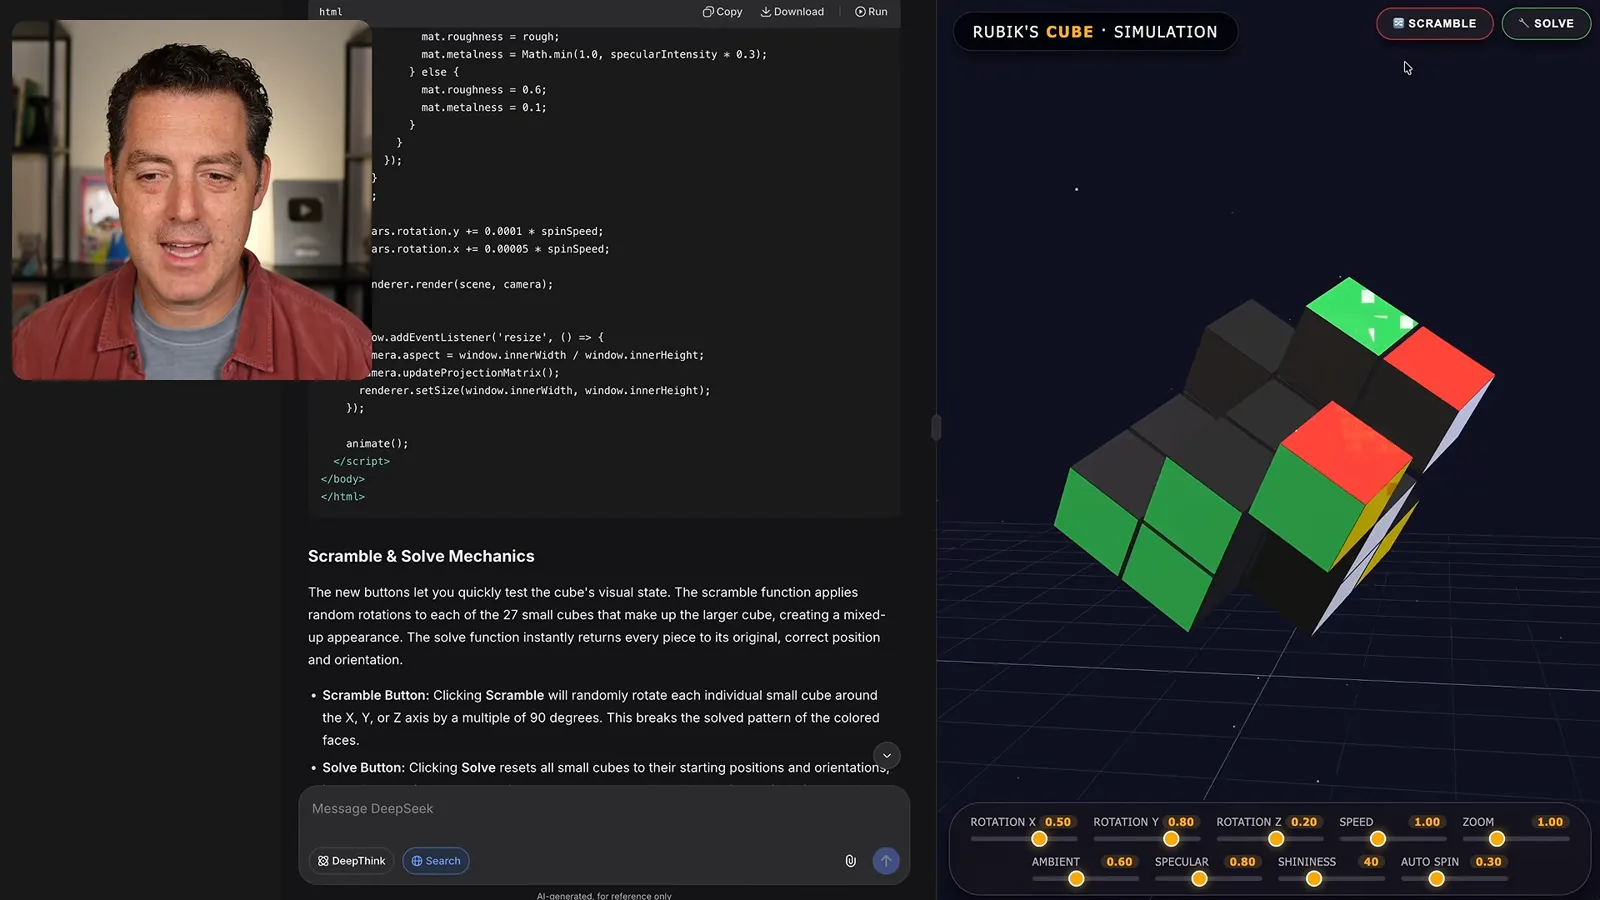
我通过 Codex 运行框架,使用 DeepSeek V4.1 Flash 输入相同的提示。第二个界面看起来不同,控件也更多,但方块似乎互不相连,打乱和求解时颜色会错误变化。运行框架和执行环境与第一次测试不同,因此不能把这些例子当作受控比较。
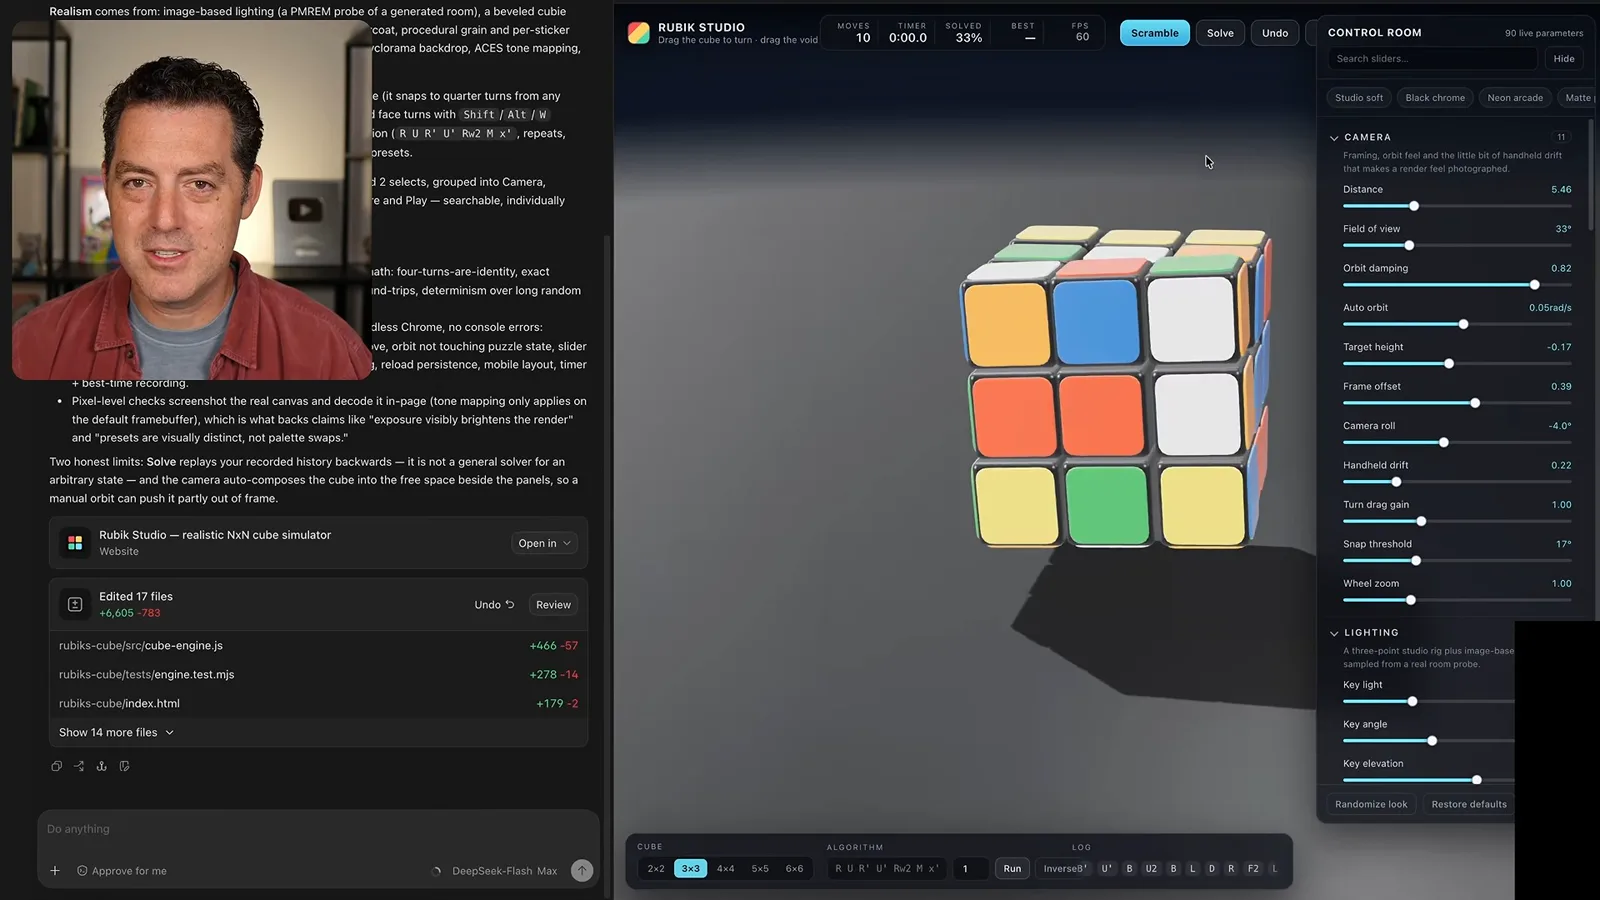
第二个应用的求解功能会反向重放记录的操作。这可以撤销已知的打乱过程,但并不是针对任意魔方状态的通用求解器;展示的应用也说明了这一局限。多次打乱后,我看到求解失败,因此认为这个具体实现没有达到我的预期。
肖像与水体冲击演示
绘画比较和光线追踪水体模拟展示了更多优点和局限。Berman 认为该模型便宜、快速,适合承担日常工作,但没有确定它与 GLM 5.3 的整体高下。
为了提供另一个比较,我的同事 Alex 一直让模型在 Microsoft Paint 中根据参考照片绘制肖像。我展示了一个使用层叠笔触的 Astra 示例,然后通过 Codex 让 DeepSeek 使用浏览器中的类 Paint 应用。两次测试环境并不相同:我的测试使用了不同的肖像和网页仿制程序。
DeepSeek 的结果风格化,可以看出是在尝试画肖像,但缺乏我在另一个示例中欣赏的细节。它没有重现同样的层叠笔触技术。这只是对一次尝试的非正式视觉判断,而非标准化的正面比较。
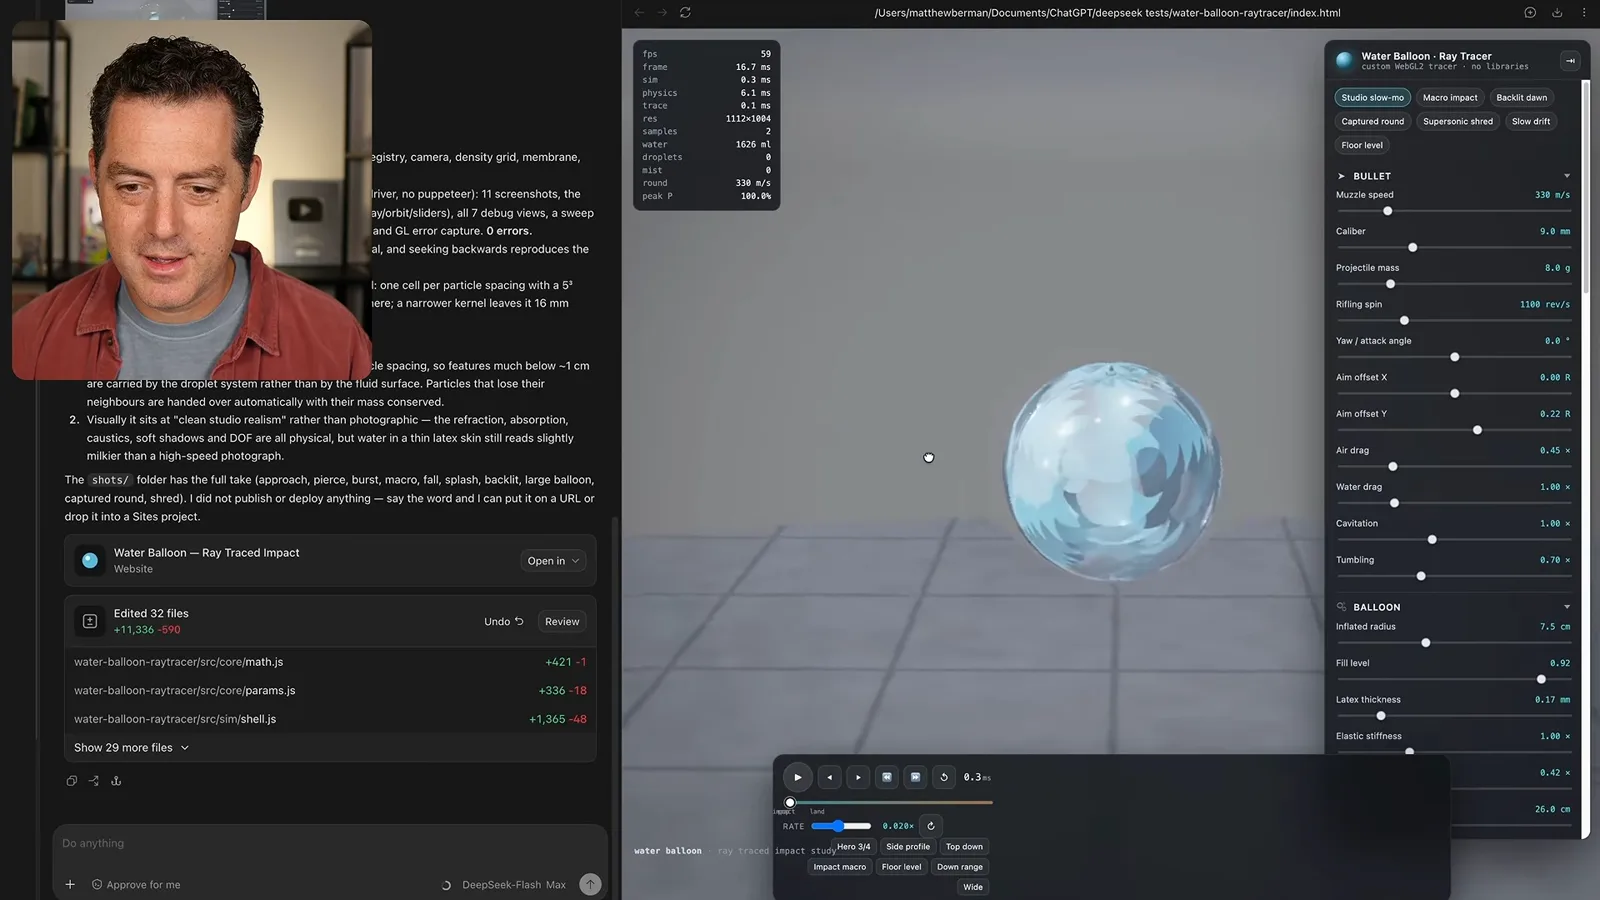
最后,我要求模型生成一个光线追踪的 3D 模拟,展示弹体穿过水的过程。生成的应用可以调整枪口速度、口径、质量、自旋等参数,但在我看来,实际模拟仍有不足。我的结论是,这是一个快速、便宜、适合承担日常工作的模型,但它与 GLM 5.3 的整体比较仍不确定。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。