30 秒看懂
2024 年 6 月,Matthew Berman 讨论《警示权》公开信、Leopold Aschenbrenner 的《态势认知》文章,以及 Daniel Kokotajlo 离开 OpenAI 的经历。他支持员工提出安全担忧的权利,质疑部分提议的可执行性,并讨论有关 AGI、安全和对齐的争议性预测。这些预测与指控均归属于提出者,并非已经确立的结果。
- 1警示的权利公开信呼吁 AI 公司在尊重商业秘密的同时,保护报告安全担忧的员工。
- 2四项建议原则签署者寻求防止报复、匿名报告和开放批评文化等保护。
- 3Aschenbrenner 的预测这名前 OpenAI 员工认为快速扩大规模可能带来 AGI,并提出安全和对齐方面的担忧。
- 4Kokotajlo 的离职Kokotajlo 称自己因安全担忧辞职,并在可能失去已归属股权的情况下拒绝签署禁止贬损协议。
- 5理解未来系统Berman 讨论对 AGI 与超级智能的推测性比较,并主张进行验证。
要点建议
- 2024 年 6 月的《警示权》公开信呼吁 AI 公司保护与风险相关的批评,并提供保密报告渠道。
- 公开信主张保护商业秘密,同时在充分的报告流程失效或不存在时允许公开警示。
- Berman 支持表达权,但怀疑笼统承诺建立开放文化是否容易执行。
- Aschenbrenner 在 2024 年对 2027 年实现 AGI、算力支出和超级智能的预测具有推测性。
- Kokotajlo 称自己因对 OpenAI 的安全做法失去信心而辞职,并拒绝签署含禁止贬损条款的离职文件。
- Berman 强调必须理解并验证 AI 行为,同时质疑极短的时间表。
按章节阅读整理后的全文
警示 AI 风险的权利
Berman 介绍 2024 年 6 月的公开信,并讨论其中对风险、信息披露和公司激励的担忧。
许多人近期都在关注 AI 安全。在这段 2024 年 6 月的视频中,我将讨论前沿 AI 公司现任和前任员工的一封公开信,以及 OpenAI 前研究人员的看法。这场讨论发生时,OpenAI 离职协议中的禁止贬损条款正引发争议。
6 月 4 日发表的《警示先进人工智能风险的权利》公开信称,AI 可能带来巨大好处,也存在从不平等、错误信息到自主系统可能失控等风险。我尤其担心操纵和错误信息;我个人不认为人类会因此灭绝,但这是一种信念,并非已证明的结论。
签署者希望科学界、公众和政策制定者的参与有助于降低风险,但认为 AI 公司有经济动机抵制有效监督。他们表示,公司掌握系统能力、局限和安全措施的非公开信息,而对外披露义务有限。
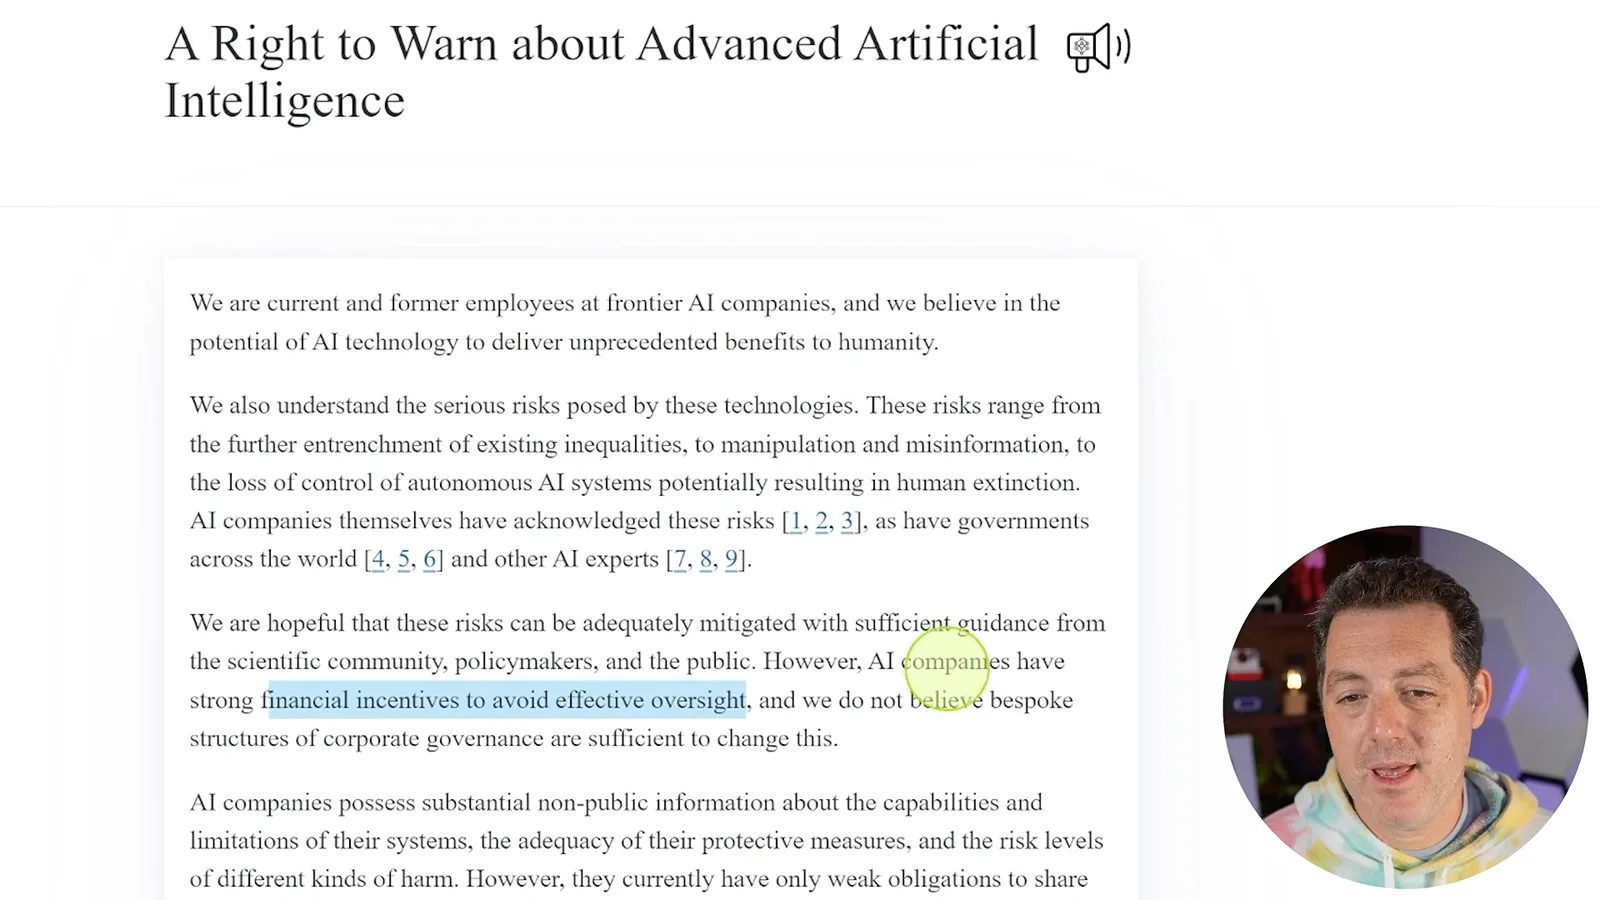
Berman 提及 OpenAI 安全团队人员离职,将其作为有关产品开发是否获得优先待遇的讨论背景。他支持开源 AI,让外部研究人员能检查系统,同时承认公开信关注的是整个行业的问责。
我担心,如果政策制定者过度依赖现有 AI 公司的专业知识,政府监督也可能导致监管俘获。这些公司可能有动机提高竞争门槛。这是对制度激励的担忧,并不能证明某项具体政策已被俘获。
公开信认为,宽泛的保密协议可能阻止员工提出担忧,而传统举报人保护可能不涵盖与非违法行为有关的风险。信中称一些员工担心遭到报复,要求公司承诺遵守四项原则。
建议保护员工的措施
公开信呼吁防止报复、匿名报告和开放批评。Berman 支持这些原则,但质疑如何执行。
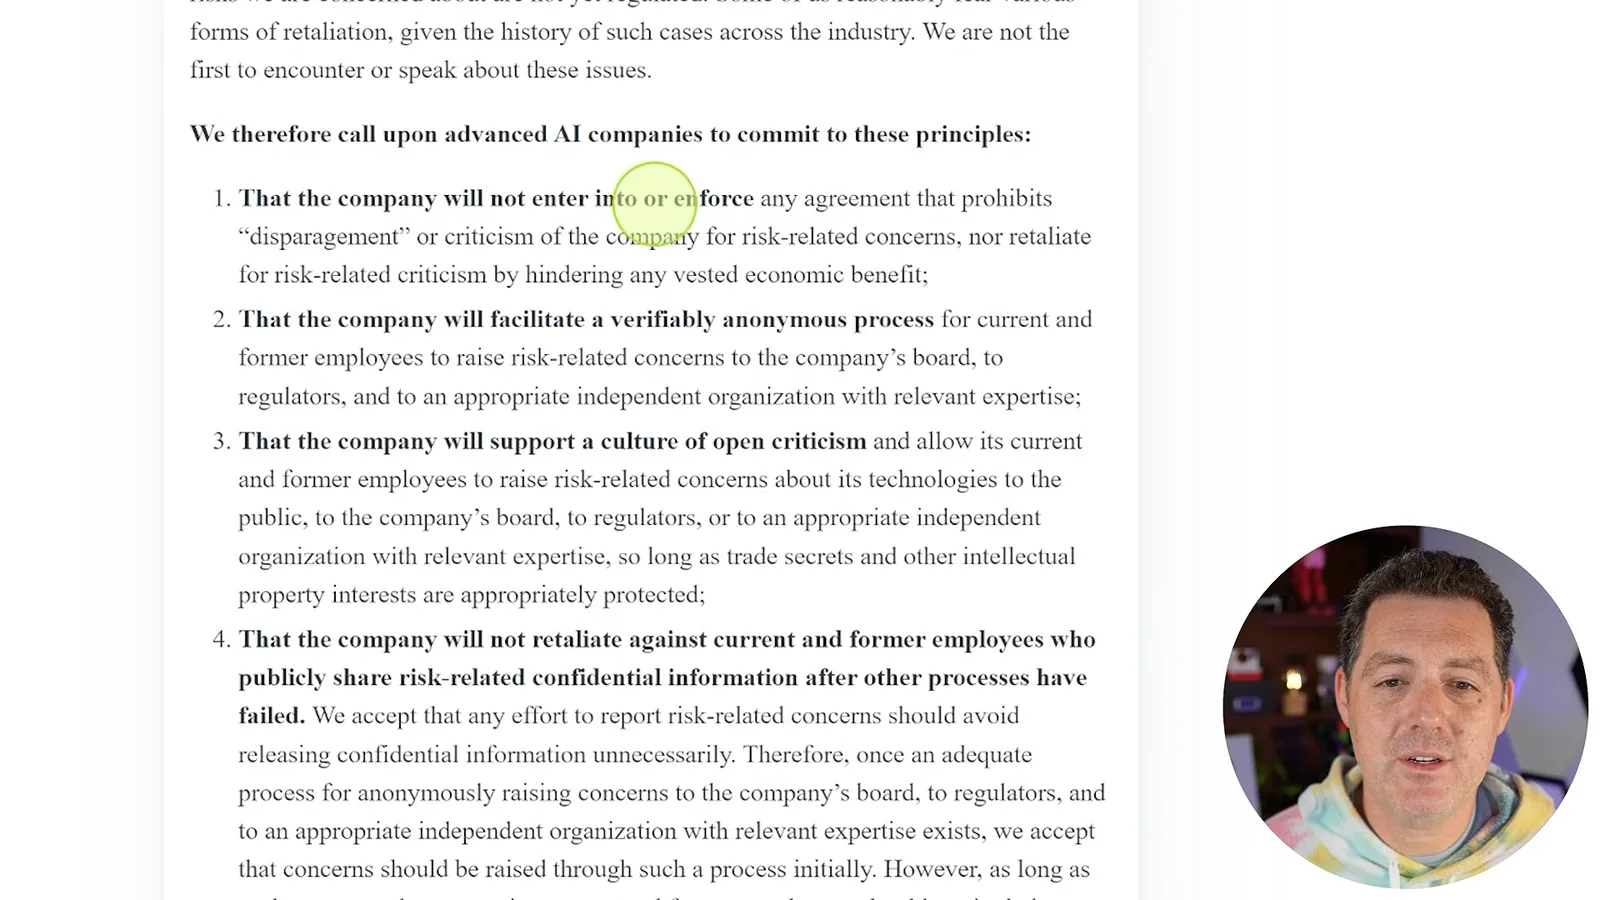
第一,公开信呼吁公司不要执行禁止风险相关批评的协议,也不要通过扣留已归属的经济利益惩罚此类批评。Berman 支持这一请求,并指出 OpenAI 最近表示会放弃执行某些禁止贬损条款。公开信要求整个行业采取保护措施;它本身并不意味着政策已经改变。
Berman 同意商业秘密应受保护,但认为员工应该能够批评安全做法。第二项原则要求公司建立可验证匿名的渠道,让现任和前任员工向董事会、监管机构和合适的独立组织提出担忧。
第三项原则要求建立开放批评的文化,并在保护商业秘密和知识产权的同时提供提出担忧的途径。Berman 支持这一目标,但怀疑仅靠文化承诺能否衡量或执行,因为员工仍可能担心管理者对批评持负面看法。
第四项原则要求公司不要报复在其他流程失败后公开与风险有关的保密信息的人。公开信表示应避免不必要的披露;若有充分的匿名渠道,应先通过该渠道报告,而没有此类渠道时,员工应保有公开警示的自由。
Berman 认为几项提议存在重叠,也不确定公司是否会全部接受。他认为最明确的一步是不对安全相关批评施加禁止贬损限制。他提到实名签署者 Jacob Hilton 和 William Saunders、匿名员工,以及 Yoshua Bengio、Geoffrey Hinton 和 Stuart Russell 等知名研究者的支持。
Aschenbrenner 的预测与担忧
Berman 回顾关于 AGI、超级智能、基础设施和国家安全的推测性预测。他区分了自己对开放的看法与 Aschenbrenner 的安全担忧。
Berman 转而讨论 OpenAI 前员工 Leopold Aschenbrenner 及其 2024 年文章《态势认知》。他介绍 Aschenbrenner 对算力集群、AGI、国家安全和安全问题的讨论。接下来的时间表与投资金额是作者的预测,而非已确立的事实。
Aschenbrenner 预测 AI 基础设施支出和电力需求会大幅增长,并设想系统超越许多大学毕业生,最终达到超级智能。Berman 将其理解为较短的 AGI 时间表。视频录制于 2024 年;这些预测存在争议,其中日期不应被当作已证实的结果。
Aschenbrenner 还警告中美战略竞争以及针对美国 AI 实验室的间谍活动风险。Berman 认为安全担忧有其合理性,但文章所设想的竞争升级或冲突仍属推测。
Aschenbrenner 在文章中根据算力增长、算法效率和让模型作为智能体更有用的改进,推断 2027 年实现 AGI 是可能的。Berman 指出部分测试取得快速进展,但基准测试趋势本身不能确定 AGI 何时或是否会出现。
Aschenbrenner 假设 AI 系统最终能自动开展 AI 研究并加速自身改进,从而迅速过渡到超级智能。Berman 将其概括为研究进步的复合增长,但这是一种未来设想,而非已经观察到的过程。
文章预期芯片、数据中心和电力领域会有大量投资,并认为 AI 实验室应保护敏感模型权重和研究成果,防范国家级窃取。Berman 将其理解为倾向限制权重访问,这与他支持开放的侧重点不同。
Aschenbrenner 将可靠控制比人类更聪明的系统描述为尚未解决的问题,认为快速过渡期间的失败可能是灾难性的。Berman 认为他既担忧又希望问题可以解决,同时指出作者认为当前努力不足。
Kokotajlo 的辞职与 AI 监督
Berman 回顾 Kokotajlo 对离开 OpenAI 和批评限制的描述,讨论由此引出的安全研究、可解释性与监督问题。
Berman 接着讨论 Daniel Kokotajlo 在 2024 年 6 月的声明。Kokotajlo 称自己在 4 月辞去 OpenAI 的工作,因为他对公司是否会负责任地追求 AGI 失去信心,并认为公司没有把足够资源转向安全研究。这些是 Kokotajlo 的叙述和判断。
Kokotajlo 称公司要求他签署含禁止贬损条款的离职文件,他理解拒签可能使自己失去已归属股权。他说自己选择保留表达自由,而不是签字。Berman 讨论 OpenAI 随后承诺修改政策,但视频没有确立 Kokotajlo 股权最终如何处理。
Kokotajlo 认为先进系统可能带来巨大好处,但处理不当也可能造成社会不稳定或灾难性风险。他表示可解释性、对齐和控制研究仍处于早期,公司快速发展的动机使独立审查变得重要。
Berman 将可解释性解释为理解模型为何从某个输入产生某个输出,以及哪些内部特征发挥作用的努力。他以 Anthropic 的研究为进展实例,同时强调研究人员仍未完全理解模型内部机制。
Kokotajlo 认为能力更强的系统是否仍符合人类利益存在不确定性,并称监督过于依赖公司自我治理。Berman 将快速发布的心态与医疗等行业作对比,后者的错误可能使人面临风险。
Kokotajlo 批评此前的限制,并表示即使理性人士对 AGI 时间表存在分歧,公众仍值得获得更充分的准备。Berman 同意研究人员应能警示风险而不必担心报复,并指出这与《警示权》公开信有关。
对齐与理解的界限
Berman 考察 Aschenbrenner 对 AGI 和超级智能的假设性比较,质疑其时间表并强调验证。
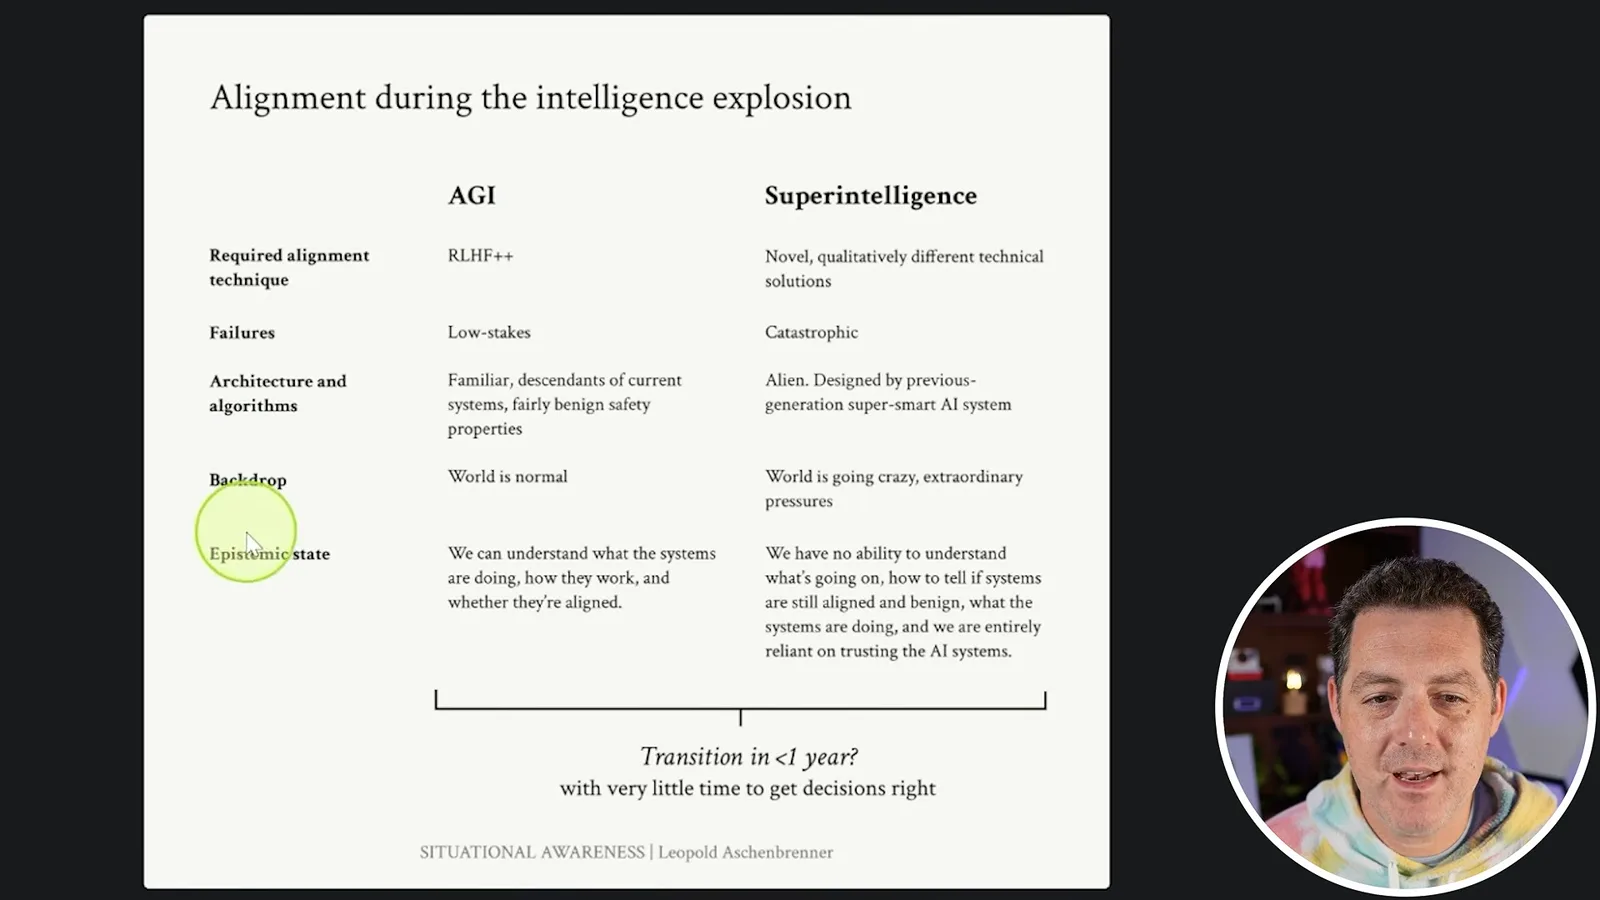
回到 Aschenbrenner 的图表,Berman 描述其中对 AGI 和超级智能的假设性区分:前者可能使用熟悉的方法,失败的后果相对较小;后者可能需要新的对齐方法,失败则可能造成灾难。这些是作者情景中的假设,并非未来系统已证明具有的性质。
图表设想 AI 设计的系统会越来越难以让人理解。Berman 将此与自己的预测联系起来:如果 AI 以人们更难理解的形式编写代码,软件开发可能发生重大变化。就业预测和设想中的架构都具有推测性。
Aschenbrenner 的图表提出过渡可能在不到一年内完成,从而几乎没有时间作出决定。Berman 认为这一时间表非常短,但同样担心人们可能难以理解或验证未来系统。他的结论是,信任必须伴随验证。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。