30 秒看懂
2023 年 5 月,Matthew Berman 演示了早期 ChatGPT 插件、网页浏览功能以及 Code Interpreter 的 alpha 版本。他使用 Expedia 规划旅行、生成 Instacart 购物清单、总结研究论文,并分析乐高数据集和 Python 文件。 视频记录的是 2023 年的产品名称、访问条件、价格和界面限制。演示中的回归斜率与一次正确回答都不应推广到所示数据和测试之外。
- 1插件连接外部服务Berman 浏览当时的插件商店,选择旅行和食品采购服务。
- 2旅行结果与重试Expedia 提供酒店选项和预订链接;航班请求先出现错误,重试后才显示结果。
- 3浏览研究论文支持浏览的模型在多次读取失败后,仍总结了论文并回答追问。
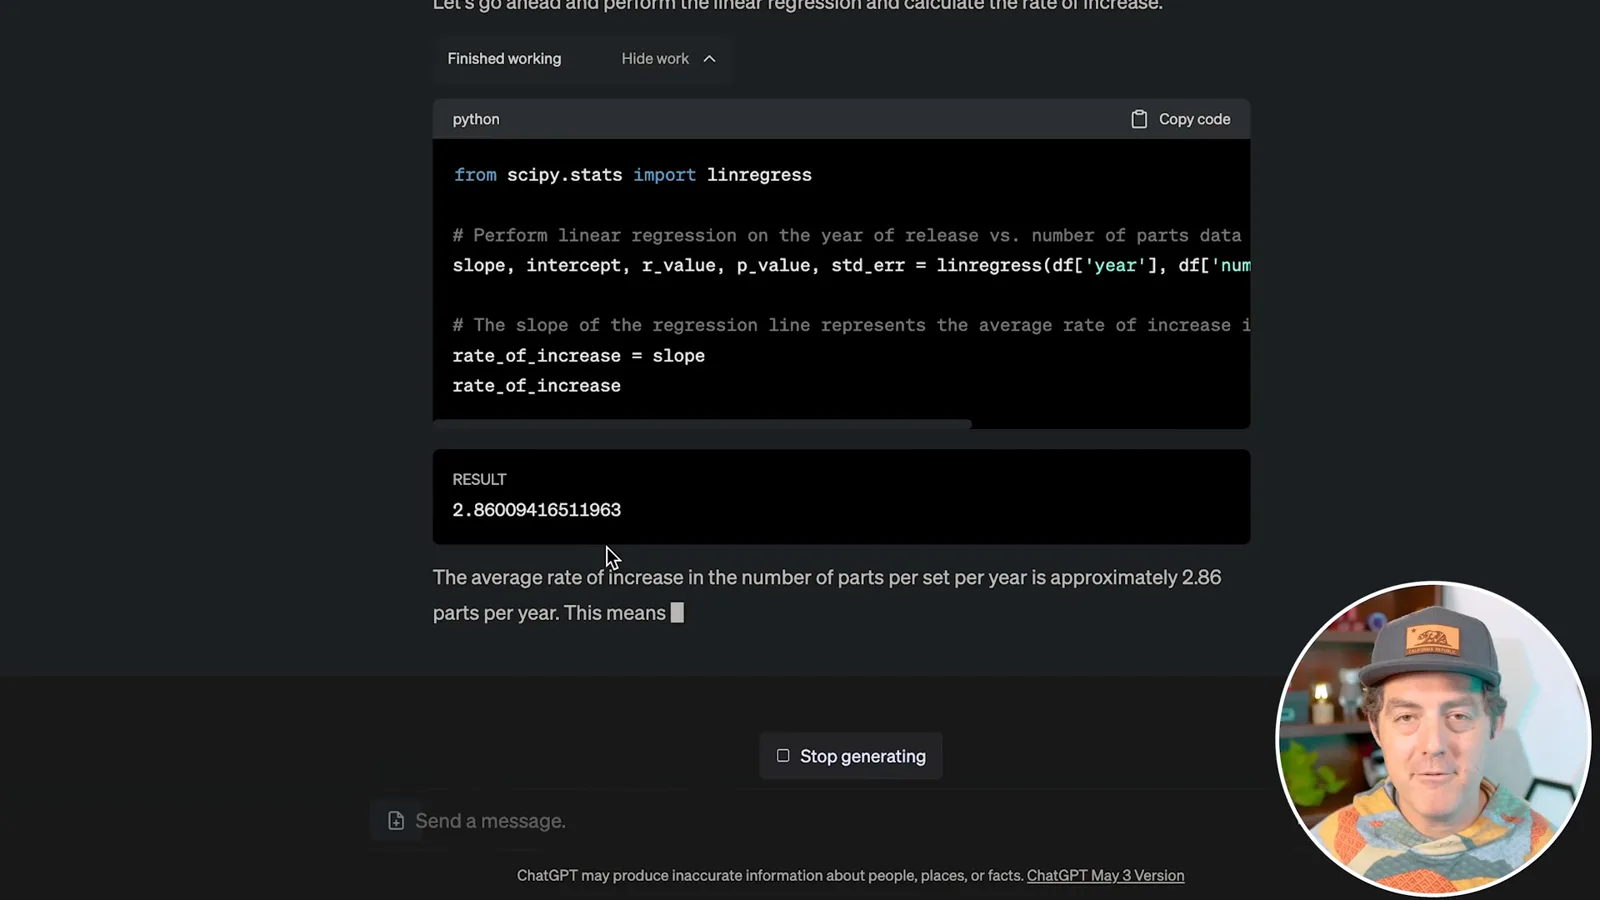
- 4分析上传的数据集Code Interpreter 加载乐高数据,绘制每套零件数并拟合线性趋势。
- 5检查代码工具描述上传的 Python 模块,并提取其中的方法名称。
要点建议
- 在 2023 年的界面中,插件能将 ChatGPT 对话连接到 Expedia 和 Instacart 等服务,一次最多选择三个插件。
- Expedia 演示展示了酒店预订链接和航班建议,但也出现了错误和重试。
- 尽管浏览过程中多次读取失败,模型仍正确回答所引用论文中的智能体数量为 25 个。
- Code Interpreter 使用 Python 探索上传的乐高数据集并绘图;报告的每年 2.86 个零件是针对该数据集拟合出的斜率。
- 视频中的可用性、价格和功能名称属于历史信息,不能作为当前产品指南。
按章节阅读整理后的全文
早期 ChatGPT 插件
Berman 介绍三项早期功能和 2023 年的插件商店。旅行演示使用 Expedia,过程中遇到了错误。
2023 年 5 月,Matthew Berman 介绍了抢先体验的 ChatGPT 插件、支持浏览的 GPT-3.5 和 GPT-4,以及 Code Interpreter 的 alpha 版本。他想了解这些工具如何将对话连接到外部服务、网页内容和文件分析。这里展示的名称、价格、可用性和界面都属于历史信息,并非当前操作指南。
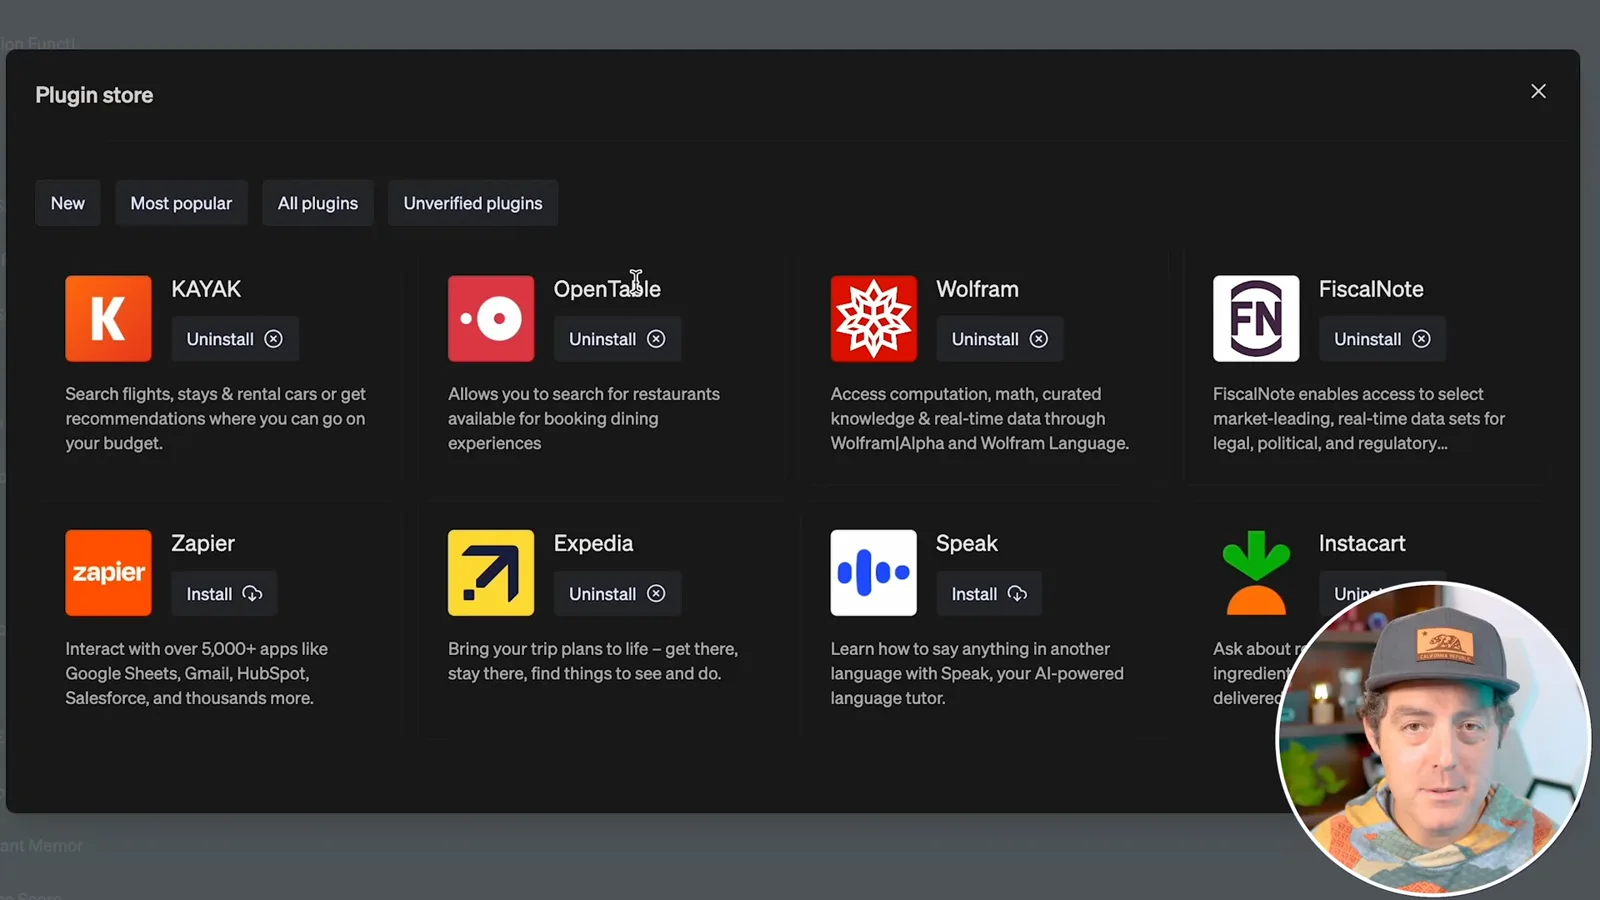
Berman 将插件商店比作应用商店,并展示 Kayak、OpenTable、Wolfram、Instacart、Expedia 和 Zapier 等集成。在他演示的界面中,一次最多可启用三个插件。他为这次演示选择 OpenTable、Expedia 和 Instacart,但展示的例子主要使用后两者。
在旅行示例中,Berman 首先询问 7 月可以去欧洲哪里。ChatGPT 建议了几个目的地,他选择阿姆斯特丹。提供三天住宿时间后,界面显示对 Expedia 的调用,并返回带有评分和每晚价格的住宿选项。随后对话将搜索范围缩小到豪华酒店。
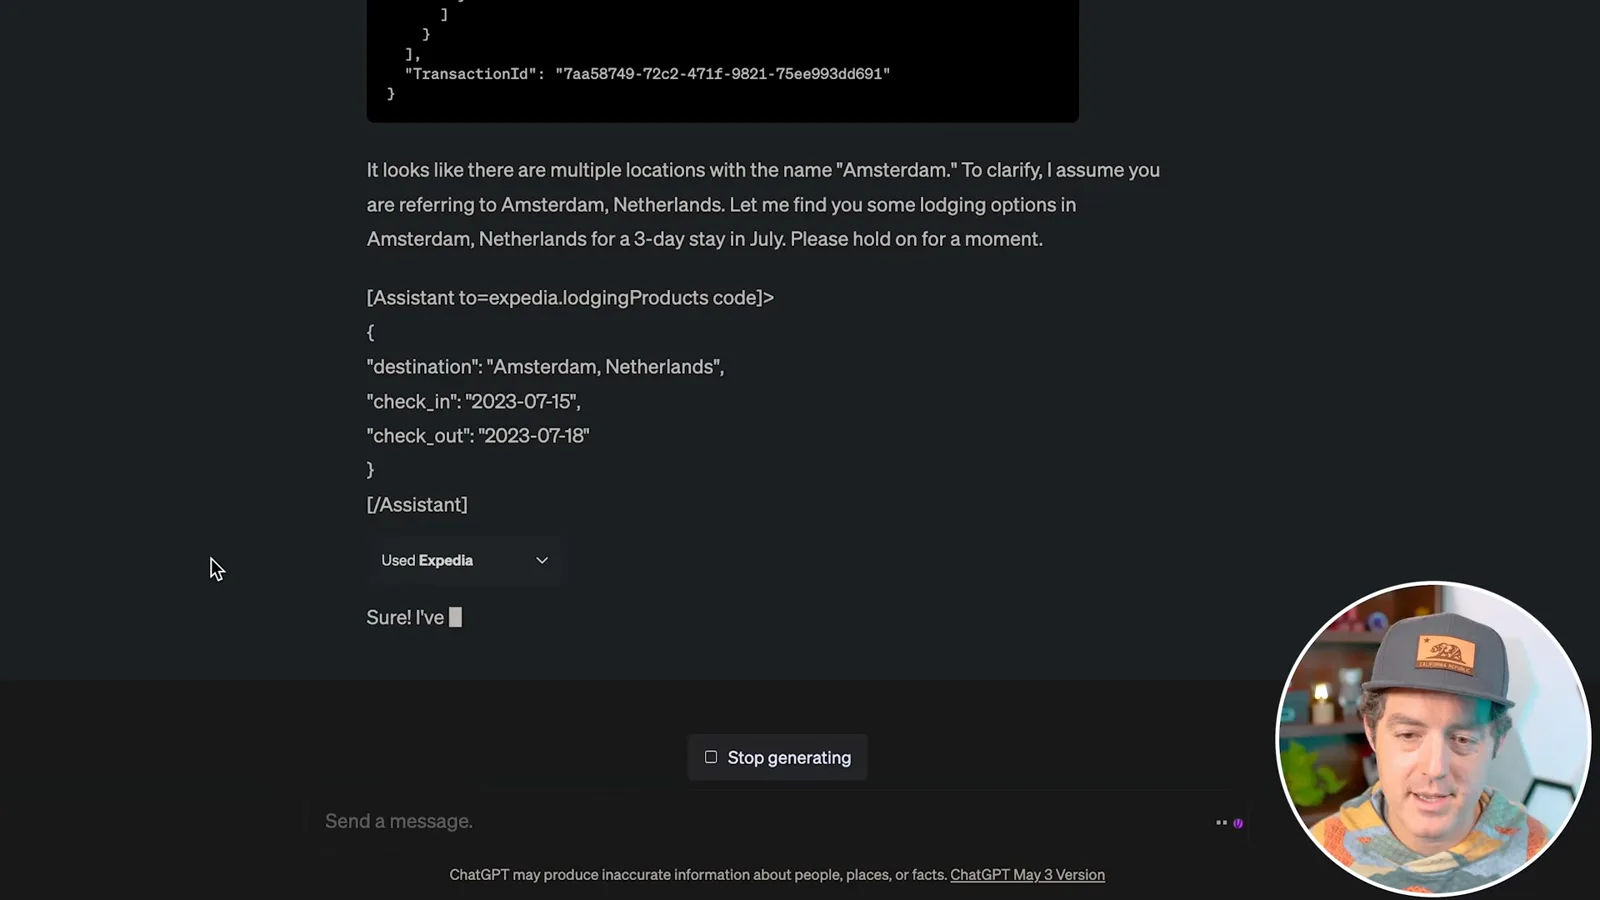
Berman 选择一家推荐酒店,点击链接进入其 Expedia 页面,用户可在那里选择房间。视频展示的是预订页面,并没有完成预订。他接着询问从旧金山出发的头等舱直飞航班,插件遇到错误;他重试后终于看到航班建议,其中一张票约为 1300 美元。这是当时的输出,并非经核实的当前票价。
食品采购与网页浏览
Instacart 集成创建购物清单。随后 Berman 使用一篇生成式智能体论文测试浏览功能。
接着,他要求制定两天的健康饮食计划和购物清单。助手提出酸奶、鸡肉和三文鱼等餐食,然后询问是否创建 Instacart 清单。Berman 同意后,插件构造包含食材的请求,并返回购物页面链接。演示停留在购物清单阶段,没有展示完成购买。
Berman 切换到支持浏览的 GPT-4。他解释模型内置知识有截止时间,并测试向模型提供网址能否引入更新的上下文。浏览功能可以获取可访问的材料,但不能让模型完整或必然地访问互联网上的所有信息。
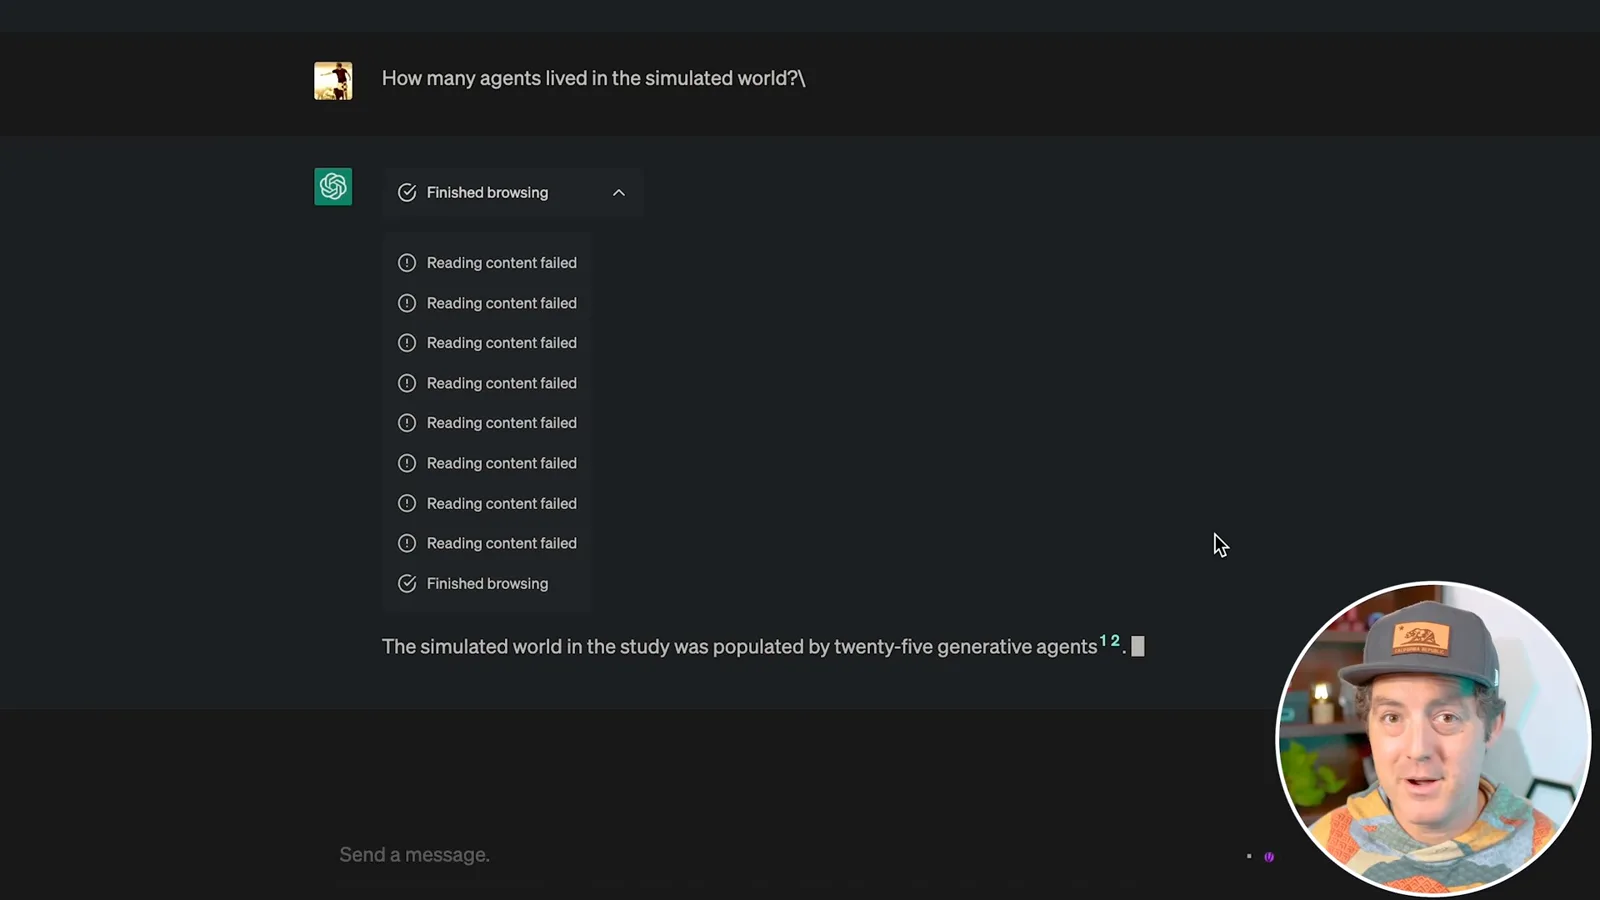
他提供论文 [Generative Agents: Interactive Simulacra of Human Behavior](https://arxiv.org/abs/2304.03442) 的网址并要求总结。界面显示读取、滚动、跟随链接等步骤,也显示了多次内容读取失败。最终工具提供了带引用的摘要;仅凭可见状态信息,无法确定它读过论文的每个部分。
Berman 问模拟中有多少个智能体。界面又出现读取失败,但最终回答是 25 个,与论文摘要一致。他认为这一结果说明浏览功能在总结、翻译和获取网页信息方面有潜力,但此次测试只有一个问题,并非广泛的可靠性基准。
Code Interpreter 与乐高数据集
工具使用 Python、散点图和线性回归探索上传的 CSV。得出的数字只描述该数据集和模型。
介绍 Code Interpreter 时,Berman 解释用户可以上传文件,让助手编写并运行 Python,完成分析、绘图或其他任务。他使用的例子是从 Kaggle 下载的乐高套装 CSV。助手通过 pandas 加载文件,并识别出套装编号、名称、年份、主题 ID 和零件数等字段。
他要求绘制每套零件数随时间变化的图表。Code Interpreter 编写 Python 并返回散点图,横轴为发布年份,纵轴为零件数。Berman 观察到,展示的数据中较大的套装在后期似乎更常见,但图上仍有很大差异。
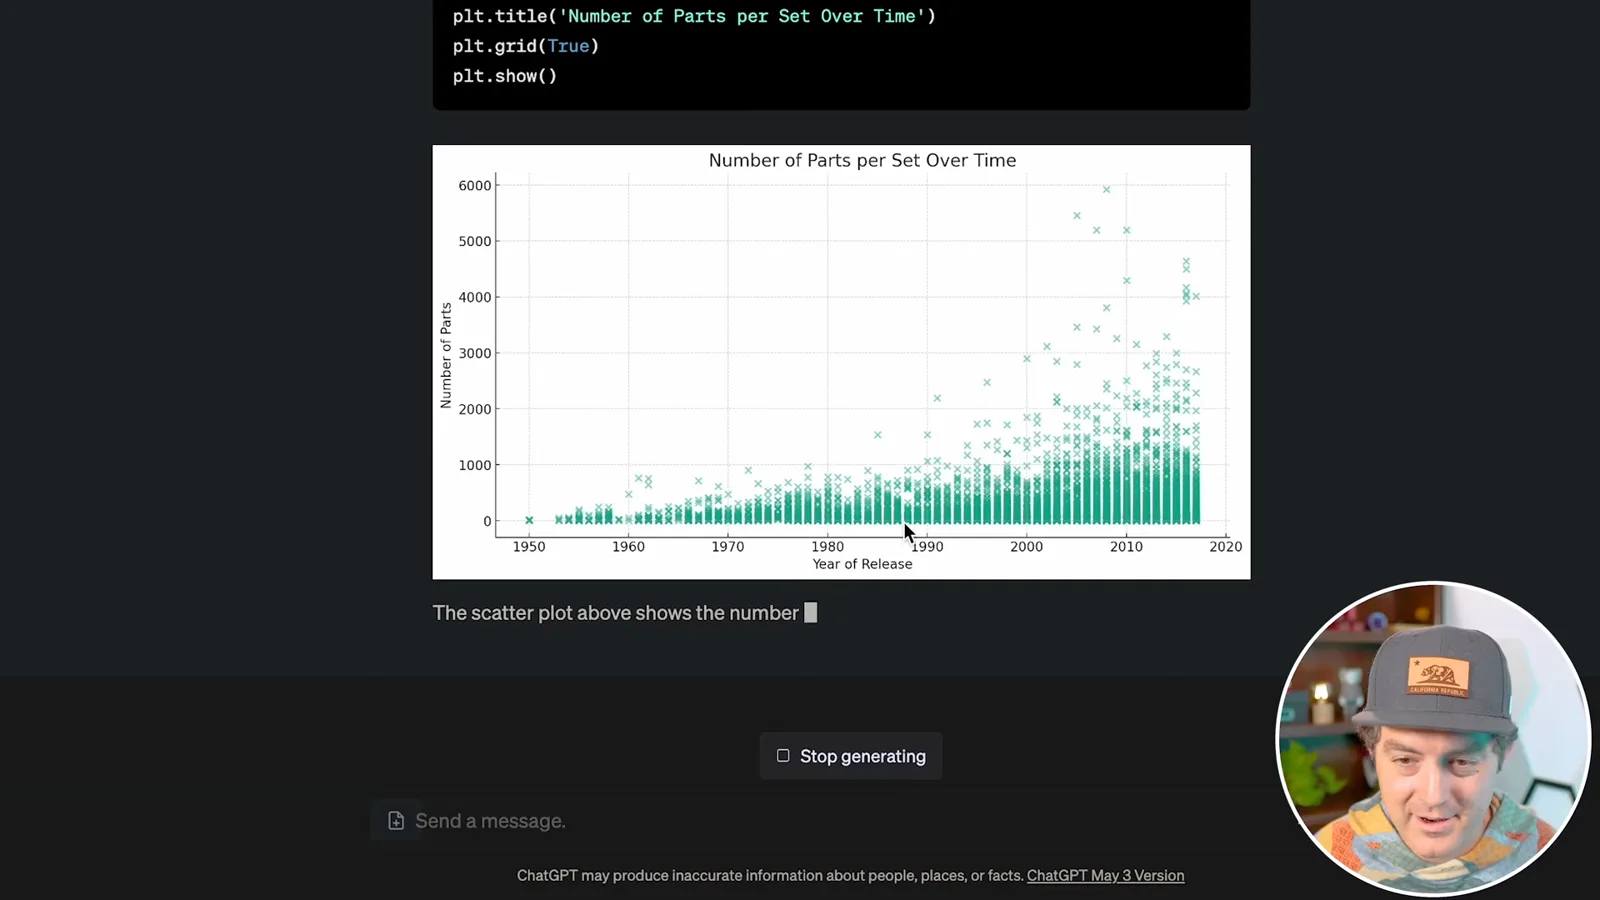
当他询问增长速率时,助手拟合线性回归,报告斜率约为每套每年增加 2.86 个零件。这是在该模型下对上传数据集拟合出的平均趋势,不能证明每套每年都恰好增加 2.86 个零件,也不能证明采样时期之外仍保持线性关系。
Berman 接着要求绘制每年发布套装数量的折线图。生成图表显示,所展示的数据大致覆盖 1950 年至 2020 年前,数量呈上升趋势。他认为通过对话生成图表可能对数据科学家和其他人有用,但结果仍取决于数据和生成的分析。
分析 Python 文件
Berman 上传一个模块并要求提取方法名称。他最后评价了 2023 年的 alpha 版本。
最后,Berman 上传了一个较大项目中的 Python 文件 memory.py。助手描述了涉及内存管理和分数归一化的代码,并指出缺少项目其他部分的上下文。当他询问方法名称时,助手编写 Python 提取名称。Berman 最后称赞这个 alpha 版本,并提到他当时理解的每月 20 美元订阅费;这是历史价格,并非对当前访问条件的说明。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 21:11EN → 简体中文Matthew Berman· 2026年10月28日Matthew Berman 实测 DeepSeek V4.1 Flash:编程、视觉与本地应用Matthew Berman · Forward Future从视觉编程、图像推理到本地应用和服务商价格,实测既展示了模型的能力,也暴露出明显缺陷。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。