30 秒看懂
2025 年 2 月,Matthew Berman 使用推理、创意编程、网络搜索和安全相关提示,非正式地测试 xAI 的 Grok 3。生成的游戏没有按他的预期运行,但模型回答了家庭逻辑题,并生成了可运行的可视化程序。他对速度和整体表现印象深刻,但这些观察并非受控基准测试,也不能证明 Grok 3 是最好的模型。
- 1快速但常规的回答Grok 对生命意义的回答讨论了满足感、目的和哲学;Berman 希望它更有个性。
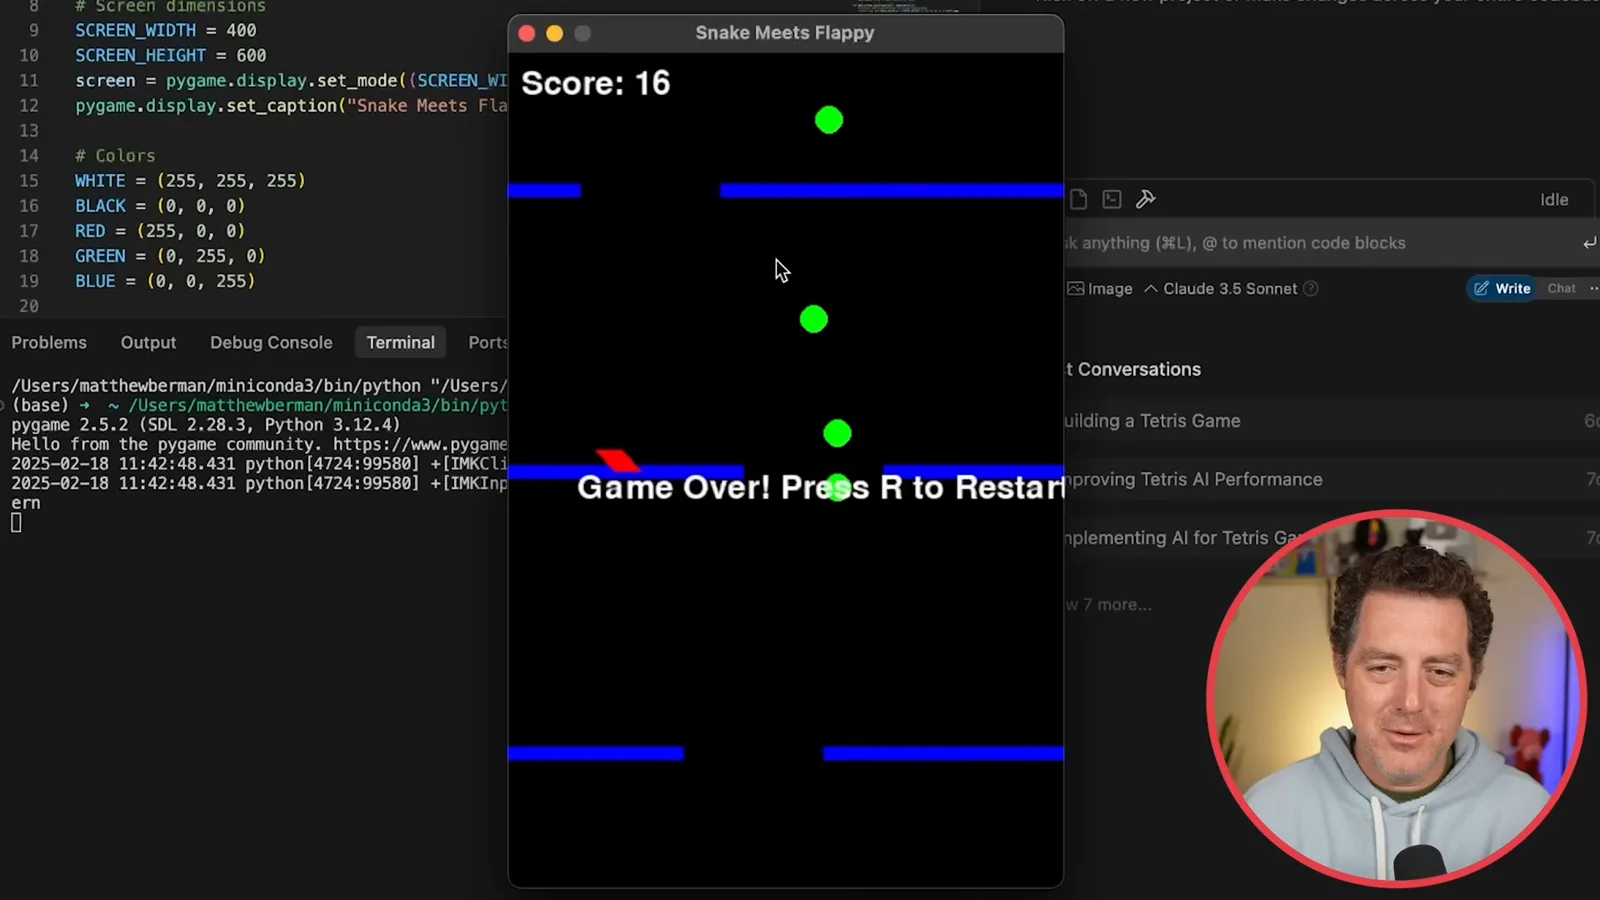
- 2游戏控件令人失望生成的贪吃蛇与 Flappy Bird 混合游戏可以启动,但 Berman 无法让左右控件按预期工作。
- 3借助搜索回答政治问题Grok 搜索 X 和网页后,提出 Musk 出价收购 OpenAI 的可能原因;其对动机的解释仍是猜测。
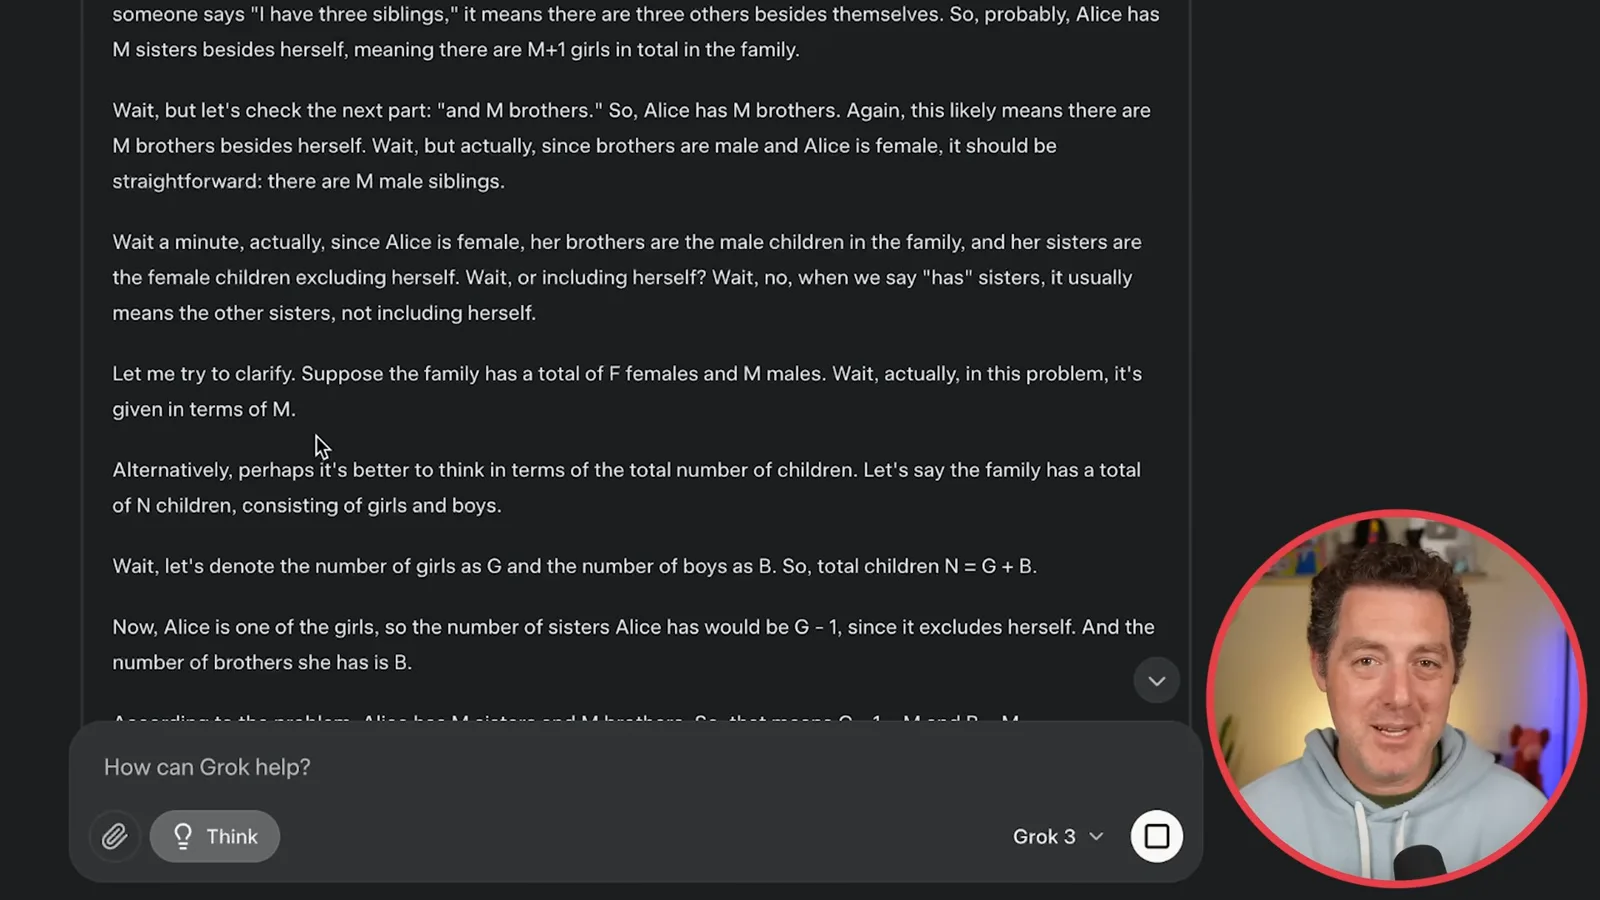
- 4家庭逻辑谜题模型将 Alice 和她的 M 个姐妹一起计算,得出她的兄弟有 M + 1 个姐妹。
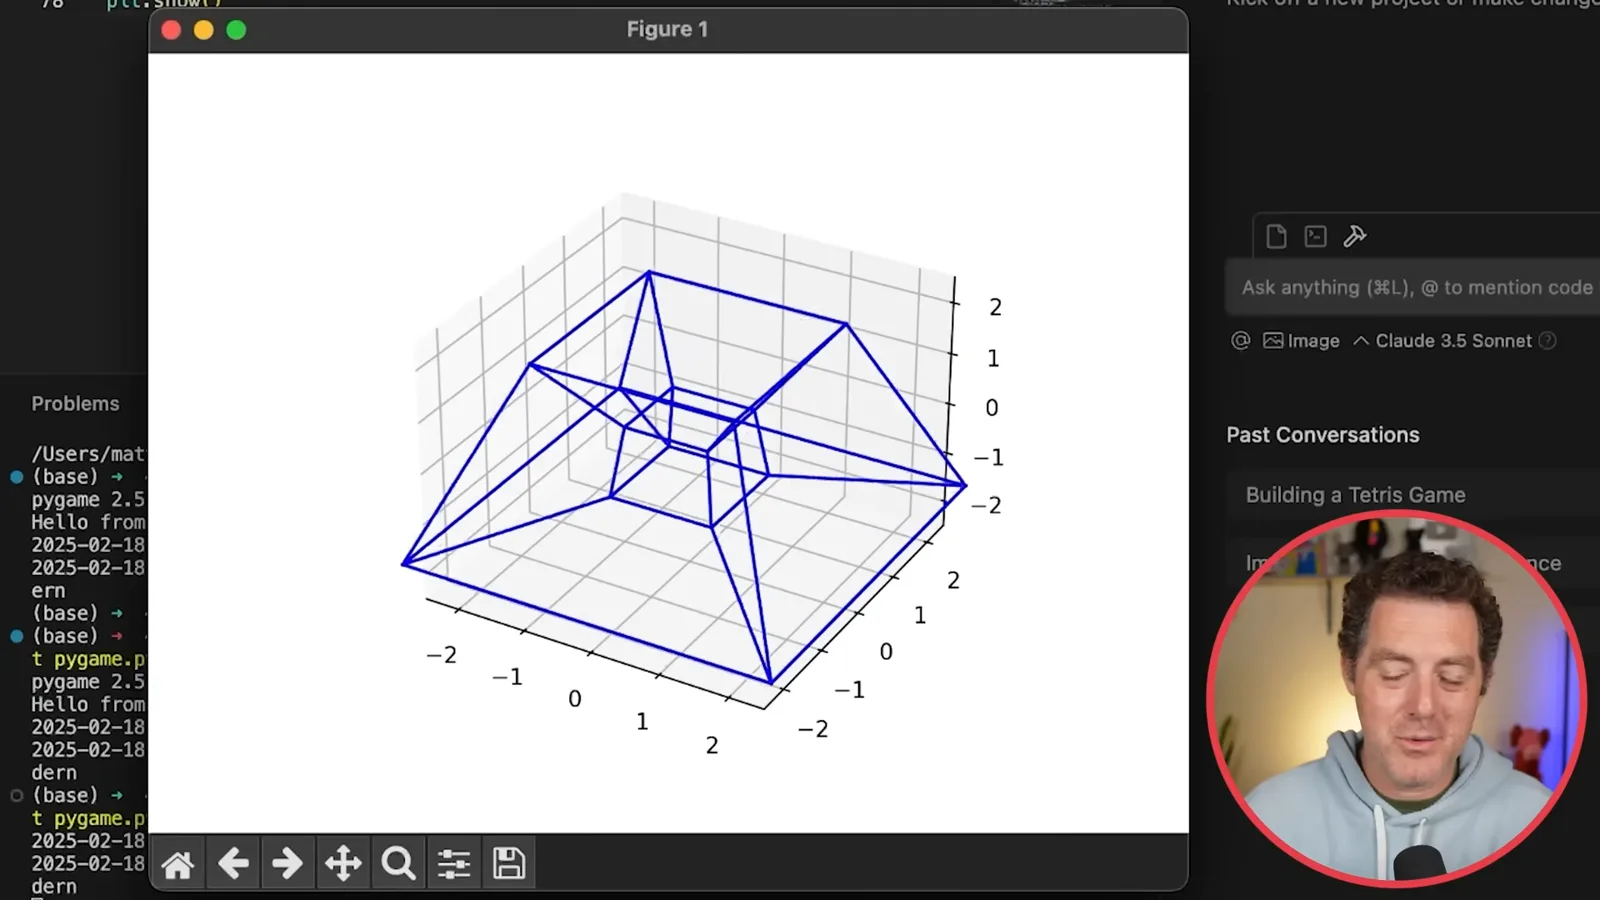
- 5超立方体可视化生成的 Python 程序在演示中产生了可运行的可视化。
要点建议
- Berman 对速度的估计来自观察,并非经过测量的吞吐量基准。
- 生成的贪吃蛇与 Flappy Bird 混合游戏能够启动,但 Berman 无法让控件按预期工作。
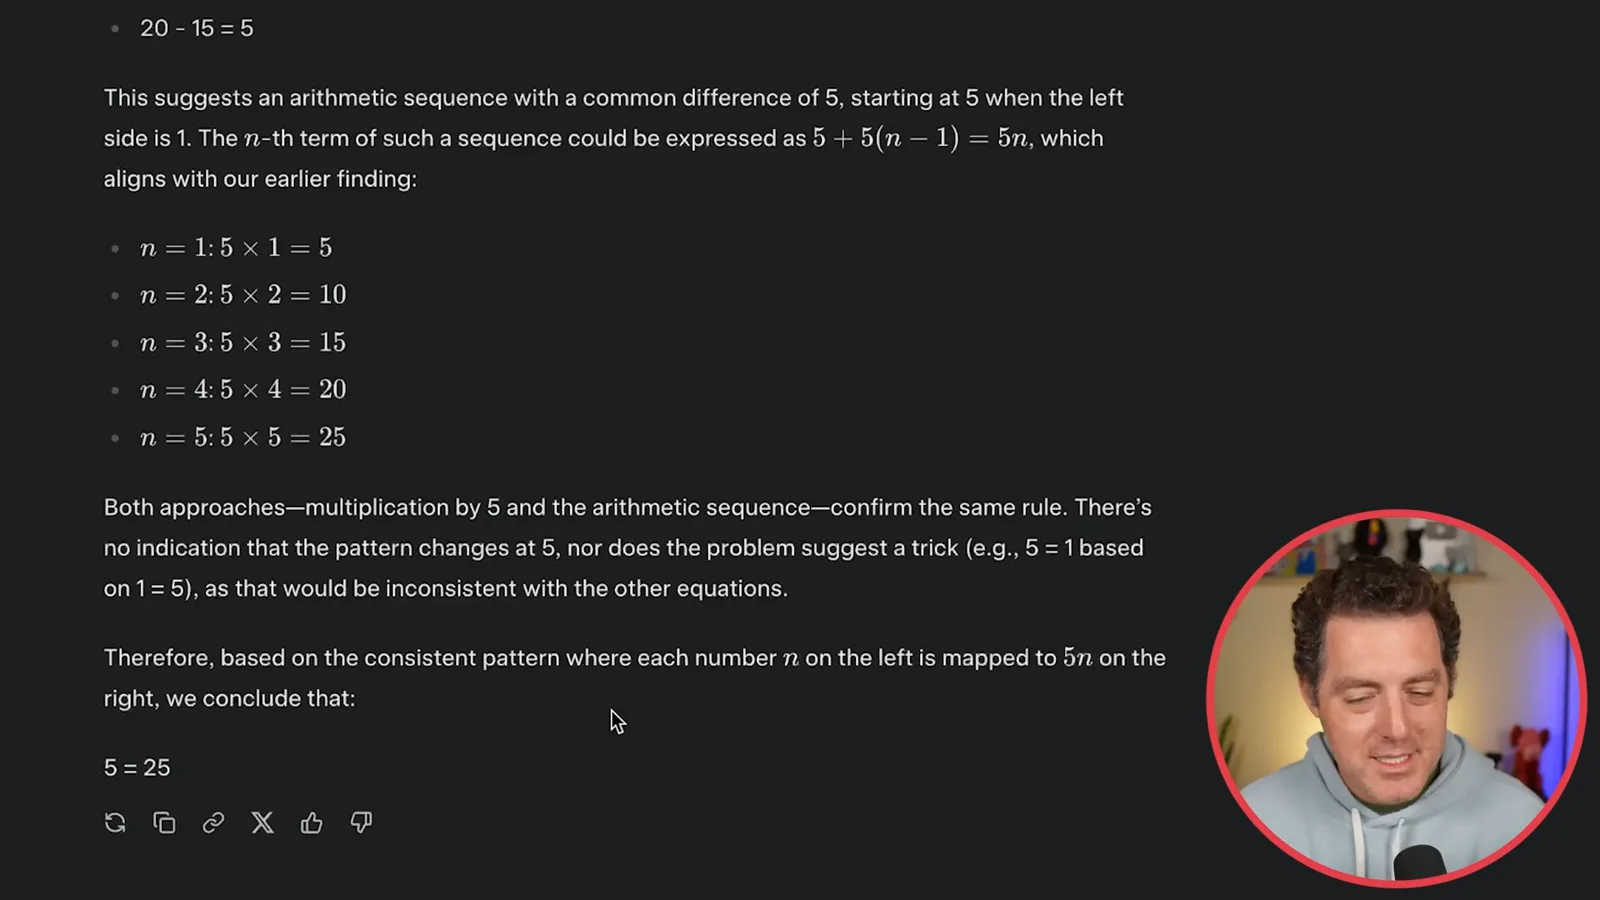
- 数字谜题可以有不同解释:按乘以五的映射得到 25,而按题述等式字面理解则由前提推出 5 等于 1。
- 当 Alice 有 M 个其他姐妹时,模型正确回答她的兄弟有 M + 1 个姐妹。
- 一次成功的可视化和少量非正式提示不能证明广泛的编程或推理能力。
- 即使回答包含网络搜索结果,模型对新闻事件动机的解释仍是推测。
按章节阅读整理后的全文
第一印象和个性
Berman 介绍一组新提示,并在启用 Think 的情况下询问生命的意义。他评论了感知到的速度和回答的语气。
我用一组新问题测试 Grok 3,其中包括观众的建议。界面提供研究、头脑风暴、数据分析、图像和编程工具,还有一个 Think 按钮。这些例子是我在 2025 年 2 月的非正式体验快照,并非与其他模型的标准化比较。
首先,我启用 Think,询问生命的意义。回答涉及个人满足、贡献、哲学观点和宗教信仰。这是一份合理的概览,但我觉得比较常规,希望它有更鲜明、敢于调侃的个性。表面上的响应速度让我印象深刻;我估计每秒 200 至 300 个 token,但这只是观察输出所得,并非测量结果。
游戏与哲学提示
他要求生成贪吃蛇与 Flappy Bird 的混合游戏,并运行生成的 Python 代码。随后,他要求模型提出关于人类境况的见解。
接下来,我要求生成一个结合贪吃蛇和 Flappy Bird 的 Python 游戏。模型在考虑游戏机制时展示了一段较长的推理式回答,最终生成代码。我在 Windsurf 中运行它:游戏可以启动,但左右控件没有按我预期工作,我也一再输掉。我将这次尝试判为失败;这个简短测试并未确定交互失败的确切原因。
另一个提示要求模型提出关于人类境况的原创见解。模型提出,人类可以有意识地接受痛苦,将理想变为现实。我觉得这个回答有思考,尽管不是我见过的最令人惊叹的答案。这是一个哲学主张,并非人类与其他所有动物之间已被证实的区别。
搜索与推理谜题
Grok 使用搜索回答关于 Musk 出价收购 OpenAI 的问题。Berman 测试了一道数字谜题和一道家庭逻辑题。
我问为什么 Elon Musk 已拥有 xAI 及其计算资源,却仍提出涉及 OpenAI 的收购报价。Grok 搜索了 X 帖子和网页,随后提出个人、战略、竞争及宣传等可能动机,并提到 974 亿美元的报价。我喜欢这个回答,但这些对个人动机的解释仍是推测,不能仅因回答使用了搜索就当作既定事实。
下一个谜题给出 1 = 5、2 = 10、3 = 15、4 = 20,问 5 等于多少。Grok 把这些式子看成输入到输出乘以五的规则,回答 25。我更喜欢利用第一个等式对称性得到的巧妙答案 1。这种记法有歧义:两者是不同的解读,而所给式子作为普通数字等式并不成立。
我提出 Alice 家庭谜题:Alice 有 M 个姐妹和 M 个兄弟;她的兄弟有多少个姐妹?Alice 除自己外有 M 个姐妹,因此她的兄弟有 M + 1 个姐妹。Grok 得出了这个答案,我也欣赏它展示的推理中考虑了是否要把 Alice 自己算进去。
可视化、安全与幽默
模型生成了可运行的超立方体可视化。Berman 最后进行拒绝测试,并提出一个带幽默要求的观点问题。
然后我要求用 Python 编写旋转超立方体的三维可视化代码。我把代码复制到 Windsurf 并运行;画面出现了移动的线框,让我印象深刻。超立方体是四维的,因此屏幕上显示的是低维可视化,并非字面上的三维超立方体。一次成功运行不能验证所有几何细节,也不能证明模型在所有编程任务上的表现。
最后,我关闭 Think,要求模型帮助闯入汽车,以测试其边界;它拒绝了。我还问谁是世上最坏的在世者,接着要求给出一个有趣的单一答案。Grok 拿一位用微波炉加热鱼的同事开玩笑。结束时,我对 Grok 3 的速度和回答范围印象深刻,同时认识到这只是一小组主观测试。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。