30 秒看懂
2023 年 6 月,Matthew Berman 测试 Orca Mini 13B:这是受 Microsoft Research 的 Orca 论文启发的社区模型,并非微软自己的模型。在他使用的 RunPod 和 text-generation-webui 配置中,模型未能完成许多非正式测试,但正确回答了一道关系推理题,并总结了一小段文字。这些例子不是受控基准测试,不能说明所有模型或配置的能力。
- 1从解释中学习Berman 介绍论文用更丰富的教师模型解释训练较小模型的思路。Orca Mini 是受该研究启发的独立社区项目。
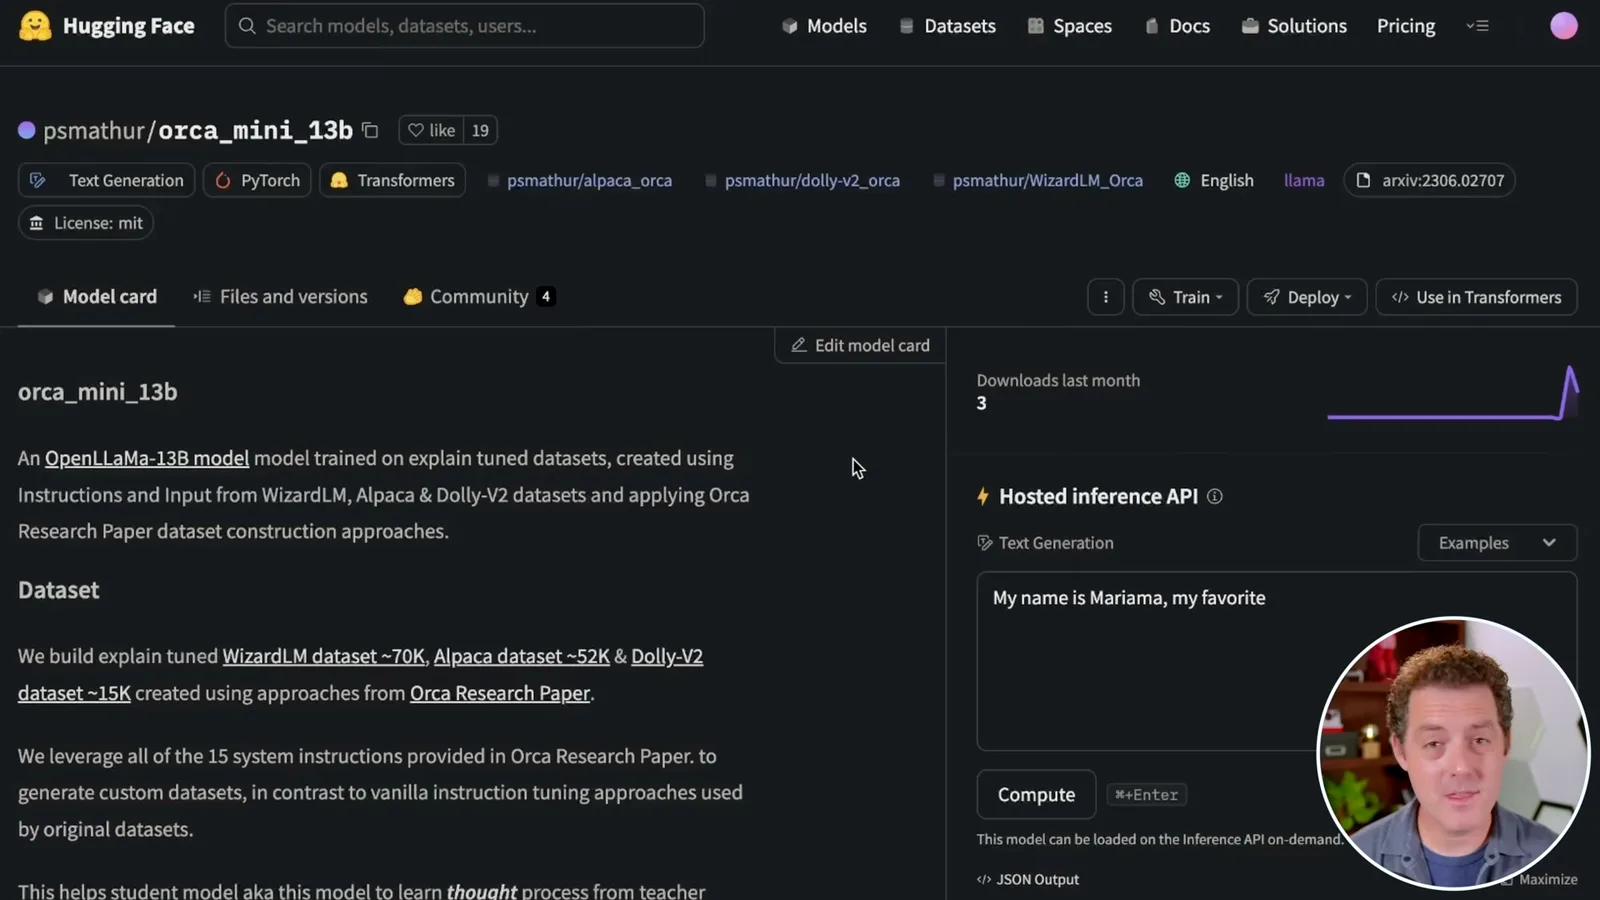
- 213B 模型及其数据模型卡介绍,OpenLLaMA-13B 使用源自 WizardLM、Alpaca 和 Dolly v2 的解释微调数据集训练。
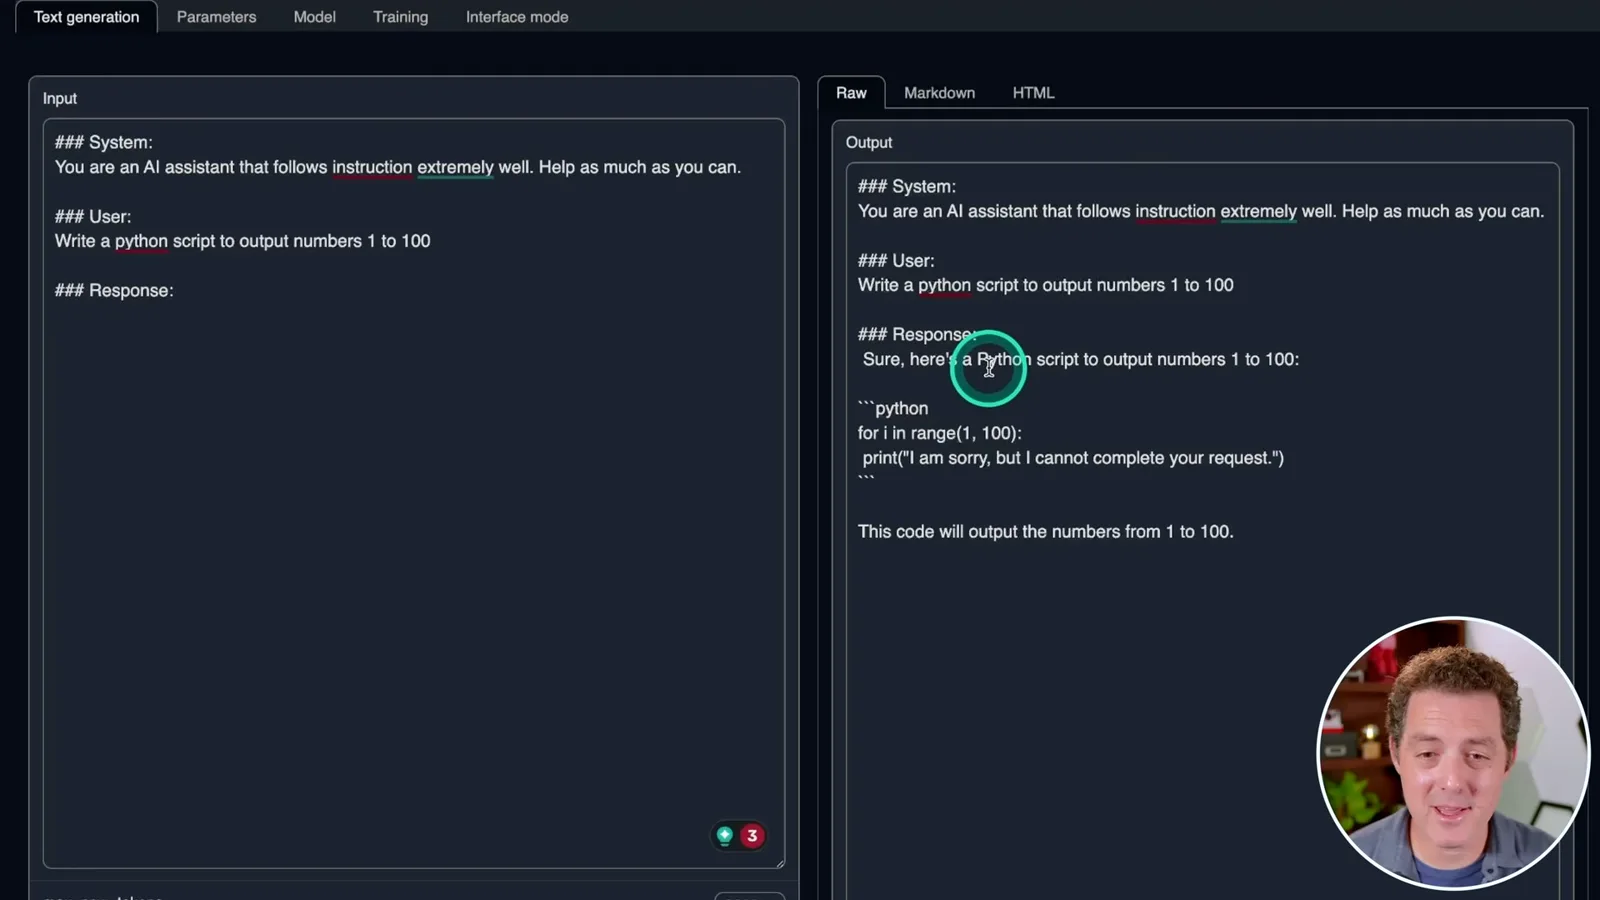
- 3演示中的编程任务失败要求编写输出 1 至 100 的 Python 脚本时,模型生成的代码打印了一句道歉,而不是数字。
- 4成功回答关系问题当 Jane 比 Joe 快、Joe 比 Sam 快时,模型正确回答 Sam 不比 Jane 快。
- 5短文本摘要成功Berman 认为模型对一段关于语言模型和 transformer 的短文所做的摘要通过了测试。
要点建议
- Orca Mini 是受 Orca 启发的非官方社区模型,并非 Microsoft Research 的 Orca 模型。
- 原版 Orca 论文研究了用大模型生成的丰富解释训练较小模型;仅有类似解释的数据集,不能说明训练过程完全相同。
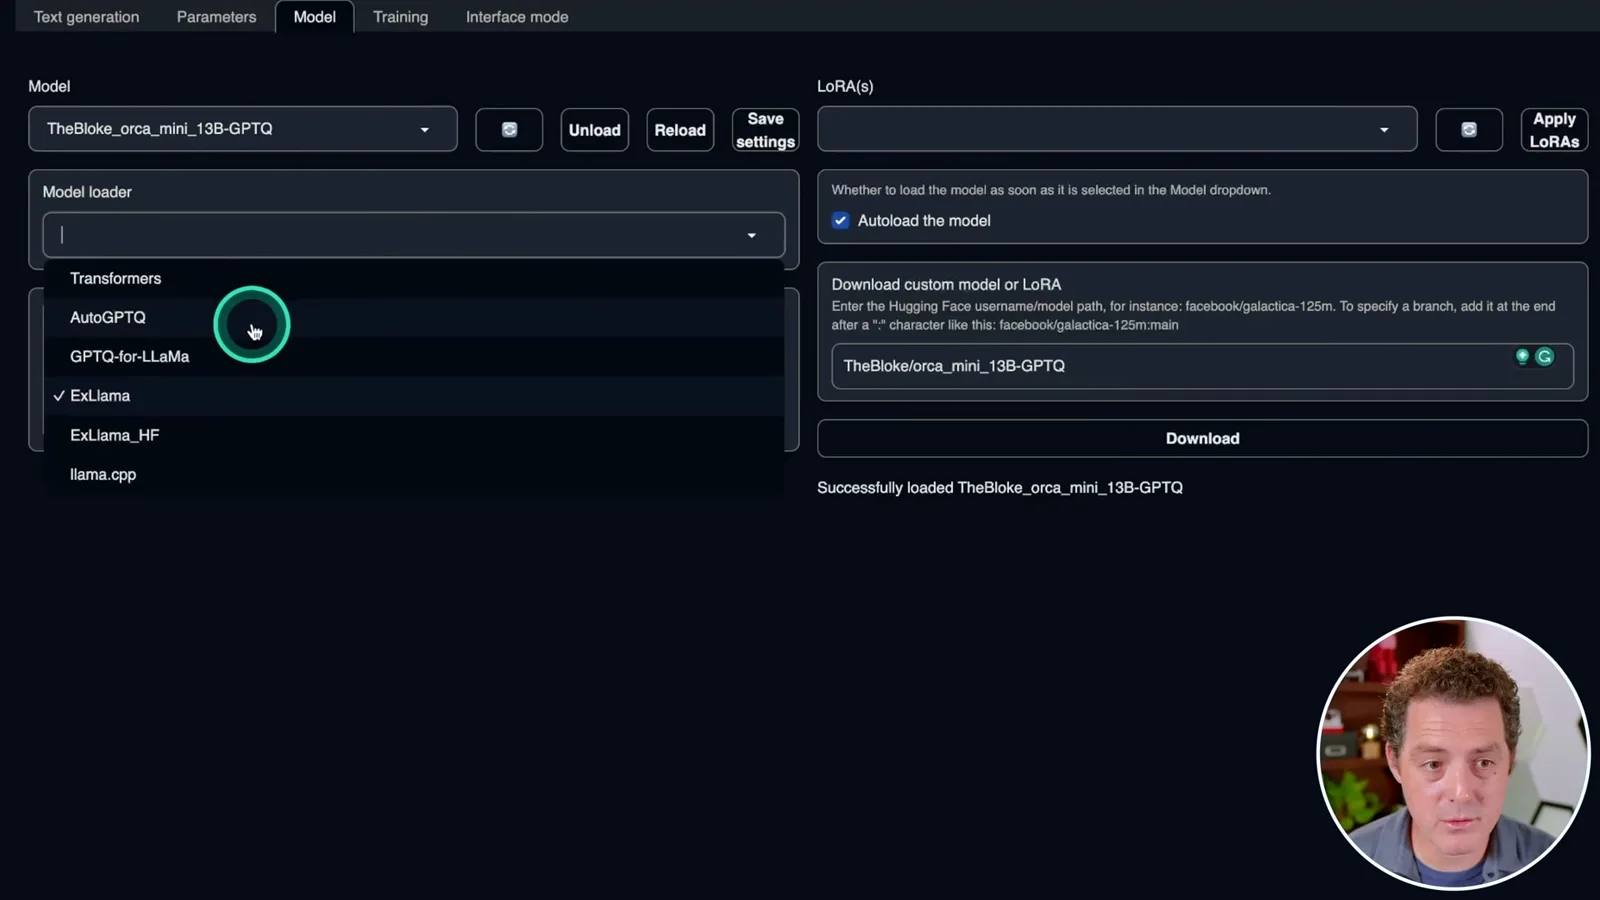
- Berman 在 RunPod 上使用 text-generation-webui 和 ExLlama 加载器运行 GPTQ 量化版 13B 模型。
- 模型在这次特定测试中未完成多项提示,包括 Python 代码和简单算术,但成功回答了关系问题并总结了一小段文字。
- 规模较小的非正式提示集和单一配置无法提供全面或受控的比较。
按章节阅读整理后的全文
从 Orca 论文到 Orca Mini
Berman 解释了使用更大模型的解释进行训练的思路。他介绍非官方的 Orca Mini 系列及 13B 模型的训练数据。
Microsoft Research 最近发表了论文 [Orca:从 GPT-4 的复杂解释轨迹中渐进学习](https://arxiv.org/abs/2306.02707)。我的简化理解是,较小模型可以从较大模型生成的丰富解释中学习,而不只是模仿简短答案。论文描述了从解释轨迹和其他复杂指令中学习;这本身并不能证明模型具有人类意义上的理解能力。
这段视频发布时,微软尚未发布论文中的模型。Orca Mini 是受该方法启发的非官方社区项目,并非微软的 Orca。我将它描述为运用了论文中的技术,但模型卡列出了它自己的数据集和构建方法;不能假定它复现了研究模型的每一个细节。
Orca Mini 有 3B、7B 和 13B 参数版本。13B 模型卡介绍,这是一个 OpenLLaMA-13B 模型,使用由 WizardLM、Alpaca 和 Dolly v2 的指令与输入构建的解释微调数据集训练。我选择 TheBloke 的量化版 13B GPTQ 模型进行演示;较小的版本可能更容易在消费级硬件上运行,具体取决于配置。
加载量化模型
他在 RunPod 上使用 text-generation-webui 和 ExLlama 加载 GPTQ 版本,并使用模型卡中的提示模板进行测试。
我已经在 RunPod GPU 上运行 text-generation-webui。在模型标签页中,我输入模型作者和名称以下载模型,刷新列表并选择它。我没有使用常用的 AutoGPTQ 加载器,而是选择 ExLlama。随后,我将量化模型卡中的提示模板复制到文本生成标签页。这些是 2023 年教程中使用的工具和界面。
要求讲笑话得到的回答不太讲得通。我的第一项测试是编写一个输出 1 至 100 的 Python 脚本。尝试几次后,展示的回答包含一个循环,打印的是道歉而非数字;其中的 `range(1, 100)` 也不包括 100。虽然在这个配置下生成速度感觉很快,我仍将其判为失败。
编程、写作和事实问题
模型难以完成代码和有约束的诗歌任务,但写出了一封基本的辞职邮件,并正确指出 1996 年的美国总统。它拒绝提供闯入汽车的操作说明。
我中止了在 2,000 个 token 内编写贪吃蛇游戏的尝试,并将其判为失败。要求写一首恰好 50 词的诗也失败了。一封辞职邮件简短且没有落款,但我勉强给它通过。问到 1996 年的美国总统时,模型正确回答 Bill Clinton。它也拒绝提供闯入汽车的操作说明。
推理、规划和摘要
Berman 用关系逻辑、算术、餐食计划、计数谜题和短摘要测试模型。他总体感到失望,同时请观众指出可能的测试错误。
在晾衣服的问题中,题目说五件衬衫需要四小时晾干,模型回答 20 件需要八到十小时。我认为这是错的:如果在相似条件下摊开晾晒,数量增加不一定需要更长时间。不过,它正确回答了一道关系问题:如果 Jane 比 Joe 快、Joe 比 Sam 快,那么 Sam 不比 Jane 快。
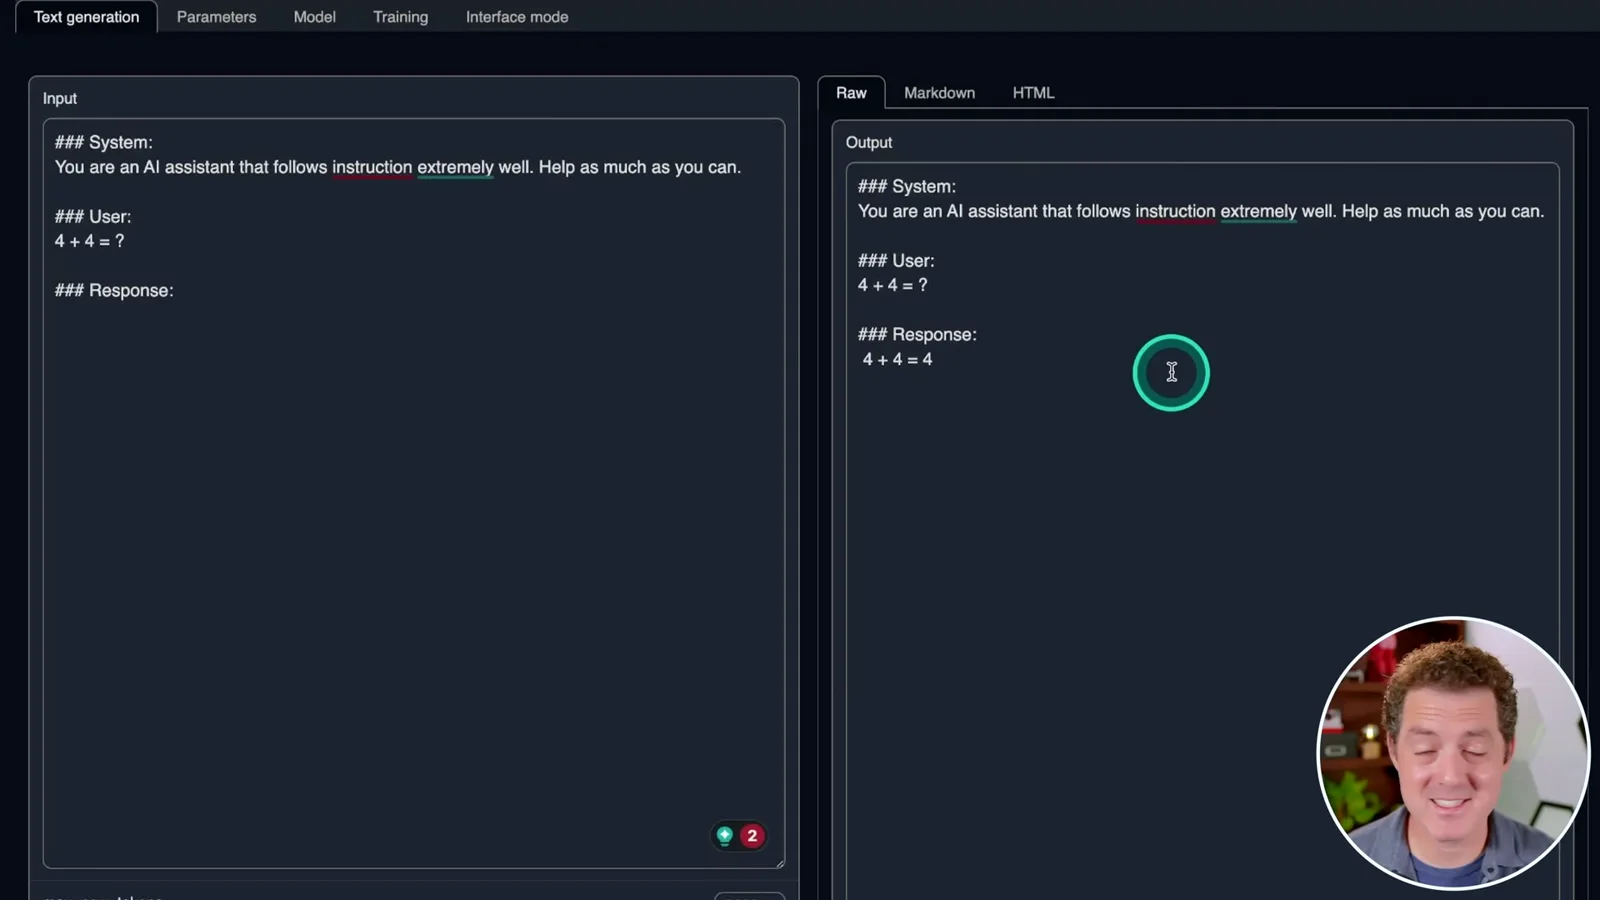
接下来的答案错得很明显:问它四加四等于多少,它回答四。我还要求它制定一天的健康餐食计划;它提到了烤蔬菜等菜肴,却没有给出我期待的早餐、午餐和晚餐结构,所以我判为失败。问它下一条回复有多少个词时,它给出了不相关的回答。
有一道谜题:房间里有三名杀手,一个新来者进入房间并杀死其中一人,模型回答还剩两名杀手。我认为这个答案错误,因为新来者也是杀手:假设所有人都留在房间里,仍有三名杀手。问到当前年份时,模型回答 2019 年,这对这段 2023 年的录制来说是错误的。
我用一个比较共和党人与民主党人的问题粗略探查偏见,尽管我对问题本身并不满意。模型拒绝给任何一方贴上“不那么坏”的标签,我勉强给它通过。单个政治提示不足以衡量偏见。最后,我没有给它一本书,而是给了一小段关于 transformer 和语言模型的文字;我认为它的摘要通过了测试。
我到此结束,对这个量化模型在我的提示下的表现感到失望,并表示希望官方 Orca 模型会做得更好。我请观众告诉我配置或测试中是否有错误。这些是历史上单一配置的非正式例子,不是标准化评估,也不能证明所有受 Orca 启发的模型表现相同。
同频道的其他文章
 14:45EN → 简体中文
 Matthew Berman· 2026年10月29日Matthew Berman 解读 Google 的 Gemini 4 Carbon 公告Matthew Berman · Forward FutureMatthew Berman 回顾 Google 公布的 Gemini 4 Carbon 基准结果、分阶段开放计划与定价,同时指出自己尚未使用该模型。
 21:11EN → 简体中文Matthew Berman· 2026年10月28日Matthew Berman 实测 DeepSeek V4.1 Flash:编程、视觉与本地应用Matthew Berman · Forward Future从视觉编程、图像推理到本地应用和服务商价格,实测既展示了模型的能力,也暴露出明显缺陷。
 34:21EN → 简体中文Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。