30 秒看懂
Matthew Berman 回顾 2024 年 11 月的 AI 动态,包括 Mistral 的 Le Chat 和 Pixtral Large、Gemini 在 Chatbot Arena 的排名、智能体工具以及 Perplexity 购物功能。他还讨论有关核安全、GPU 基础设施的报道和一项医疗诊断推理研究。文章区分了历史发布信息、有限评测与更广泛的主张。
- 1Le Chat 功能扩展Mistral 展示了网页搜索、图像生成、自定义智能体和画布编辑。
- 2Gemini 在 Chatbot Arena 的排名2024 年 11 月的排行榜快照反映用户偏好投票,并非普遍适用的排名。
- 3AG2 更正AG2 是 AutoGen 的分支,并非 Microsoft 将其项目更名。
- 4医疗研究的局限一项涉及 50 名医生的随机试验使用临床案例摘要;使用聊天机器人并未显著改善主要结果。
要点建议
- Mistral 于 2024 年为 Le Chat 添加了搜索、图像生成、智能体配置和画布功能。
- Pixtral Large 以研究许可开放权重,商业使用需要单独授权。
- Chatbot Arena 排名反映特定时间和提示词样本上的用户偏好。
- 一项涉及 50 名医生的试验发现,提供 GPT-4 使用权并未带来显著提升;模型单独表现的比较属于探索性分析。
- 核安全测试和有关人类控制的声明并不能证明技术安全措施万无一失。
按章节阅读整理后的全文
Mistral 的助手和视觉模型
Berman 演示 Le Chat 功能并讨论 Pixtral Large。文章将其发布与许可置于 2024 年的背景中。
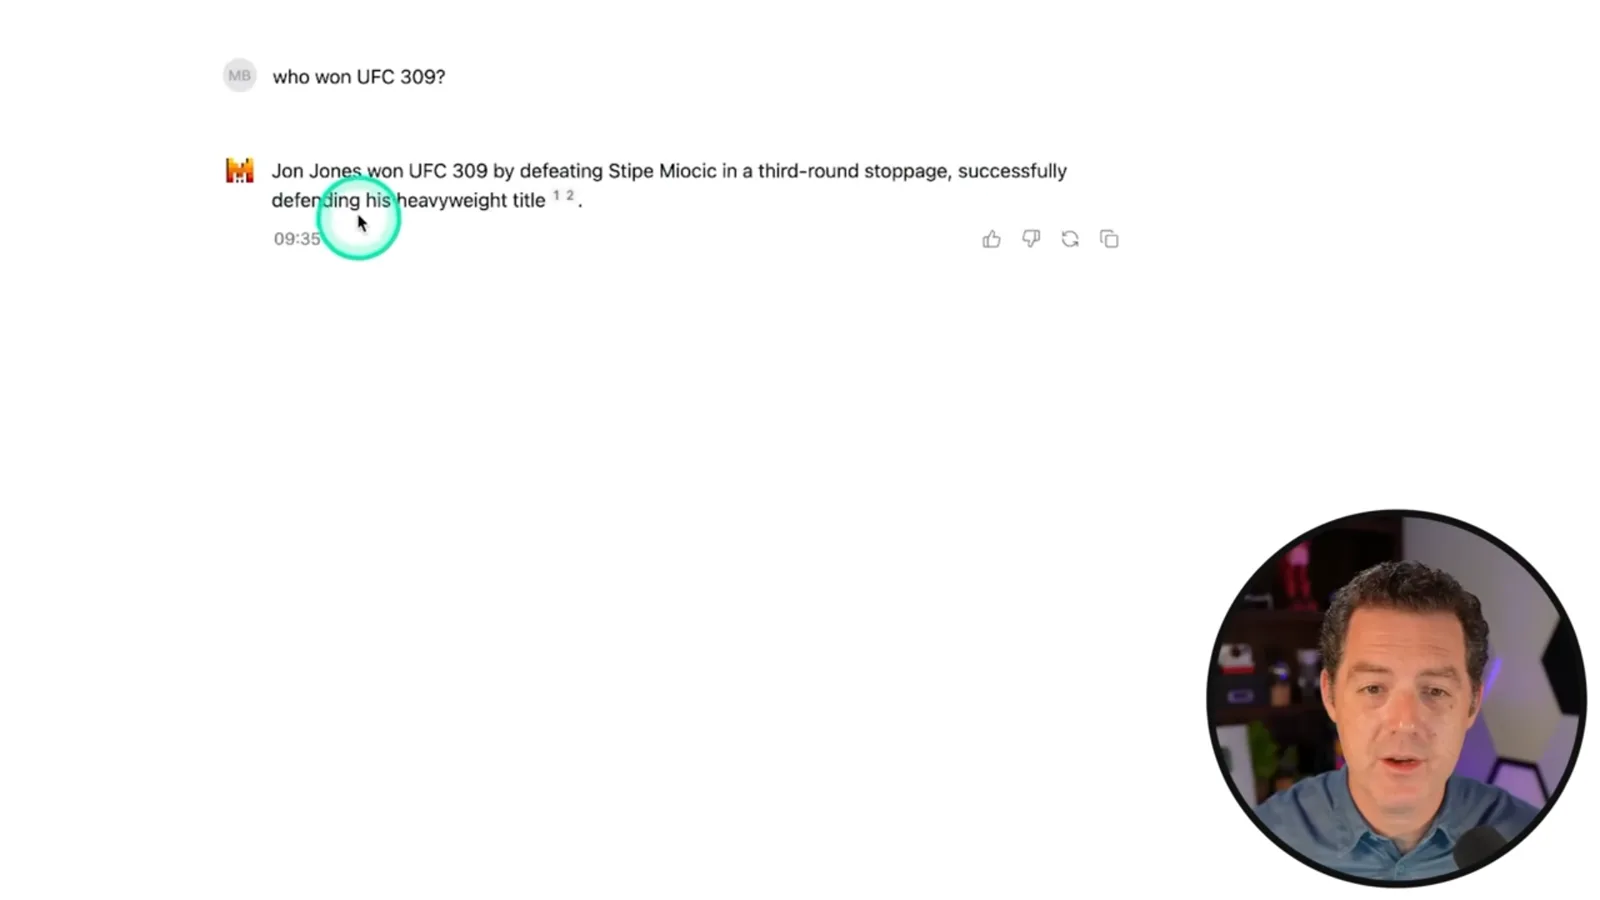
Mistral 为其对话助手 Le Chat 添加了多项功能。我用一个关于 UFC 309 的问题展示带引用的网页搜索,然后演示由 Black Forest Labs 的 Flux Pro 支持的图像生成。在 2024 年 11 月的视频中,我说这些功能免费;可用范围和价格可能变化。
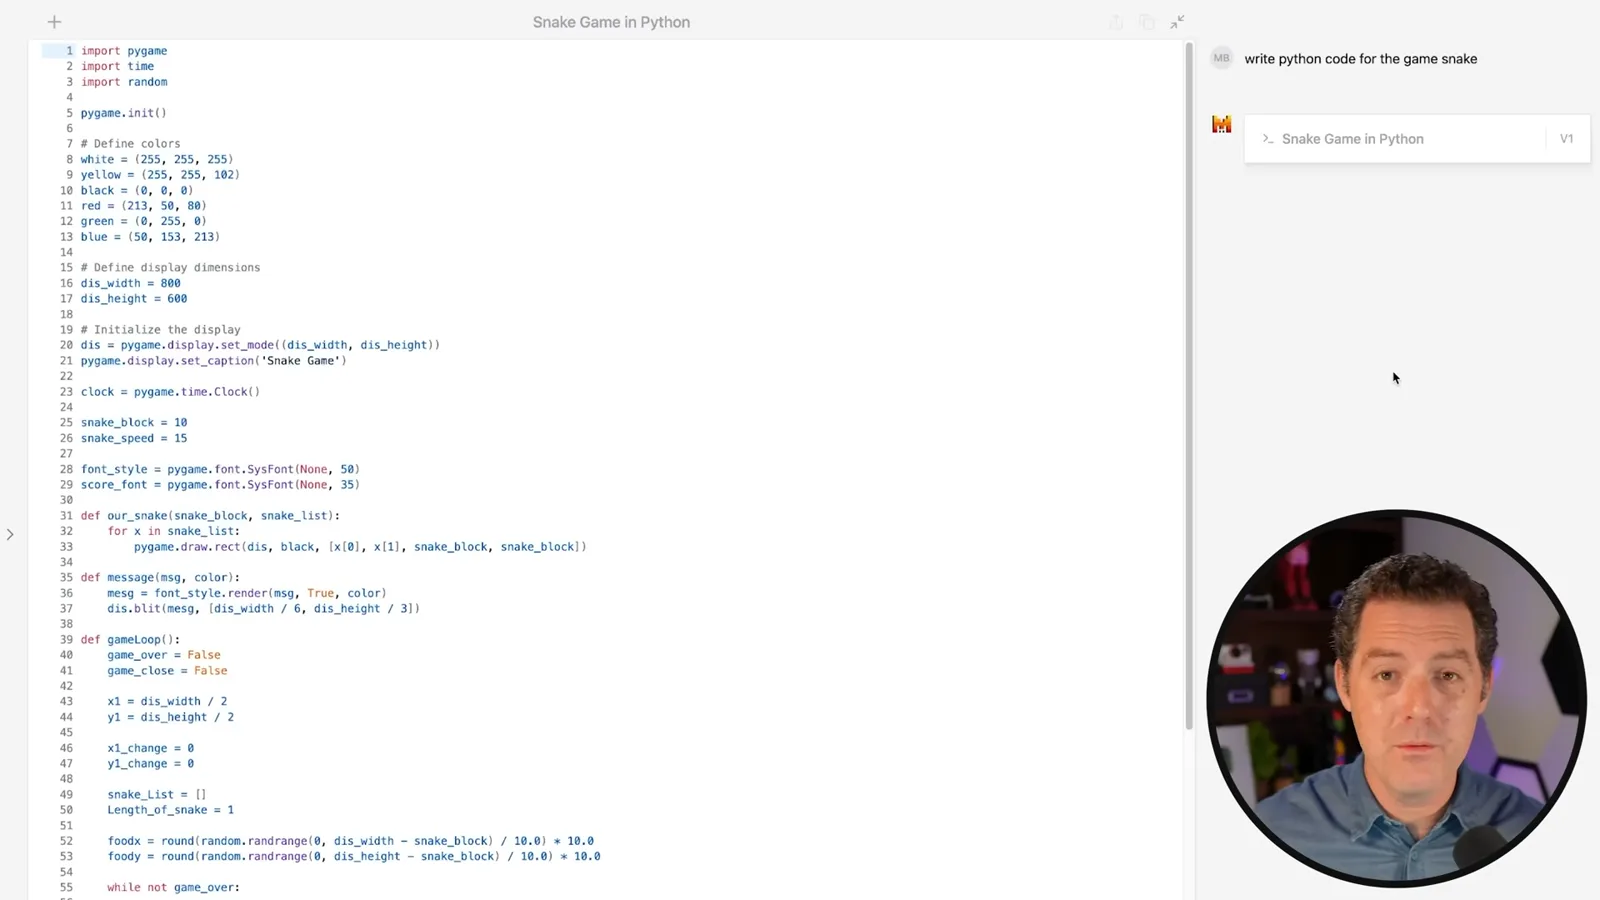
Le Chat 还允许用户创建并提及自定义智能体。在我展示的界面中,可以选择模型、添加指令和示例、调整温度,并在对话中调用前进行测试。Canvas 在聊天旁边打开代码或文字;我要求它生成一个 Python 贪吃蛇游戏,直接修改颜色,并查看版本之间的差异。
Mistral 还发布了 Pixtral Large,一款可以处理图像和 PDF 的视觉模型。我展示它描述羊驼图片的过程,并提到自己对较小 Pixtral 模型的良好使用体验。Mistral 将 Pixtral Large 描述为拥有 1,240 亿参数的开放权重模型;其 2024 年 11 月发布的版本以研究许可供自行部署,商业使用需要单独授权。开放权重本身并不意味着可以不受限制地使用。
排名、扩展与桌面工具
他讨论 Gemini 的偏好排名,并探讨 AI 进步是否放缓。他还回顾 ChatGPT 的桌面集成和 AG2。
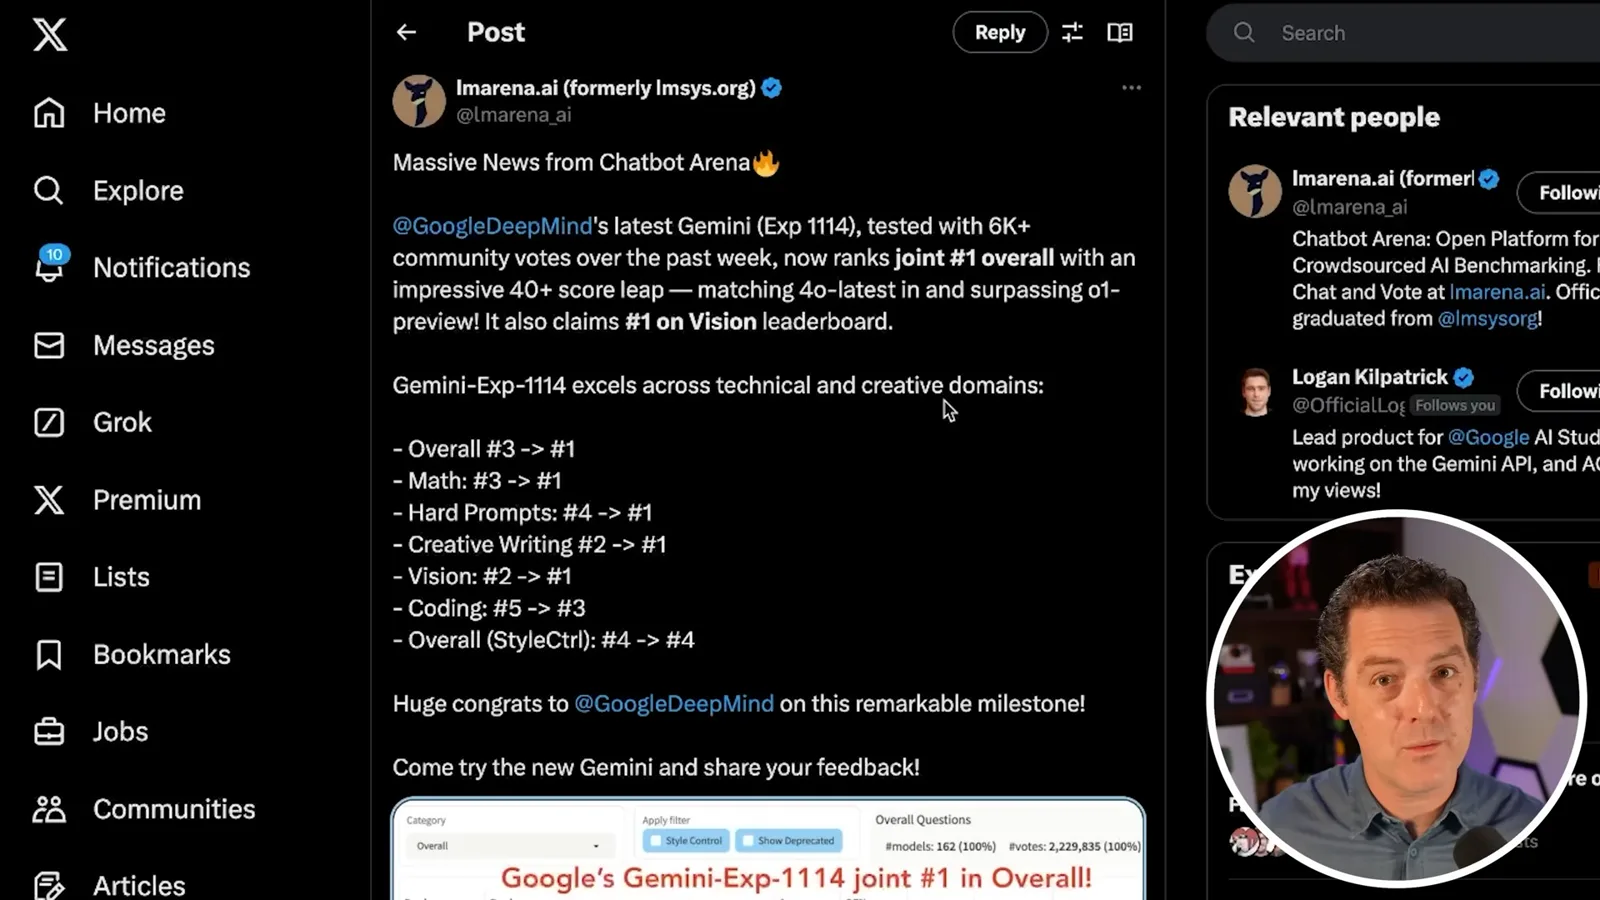
当时,Chatbot Arena 排行榜根据社区偏好投票,将 Gemini Experimental 1114 与 GPT-4o 一同列在接近榜首的位置。该快照还显示了数学、困难提示词、创意写作和视觉类别的排名变化。我将它与传统基准分数作对比,但 Arena 本身也是一种评测:投票反映参与用户、提示词和方法,排名上的微小差异不应被视为全面领先的证明。
有报道称,领先的 AI 公司在提升模型方面可能遇到了瓶颈。Sam Altman 不同意,我也怀疑存在一个硬性上限:算法进步、测试时训练以及推理时投入更多计算,都提供了改进系统的其他途径。这是我对趋势的判断,并不能证明扩展会无限持续。
OpenAI 当时正在为 ChatGPT 桌面应用加入与 VS Code、Xcode、Terminal 和 iTerm2 集成的测试功能,让它能够读取相关应用内容,减少反复复制粘贴。我认为这可能是迈向更广泛桌面控制的一步,并推测带有智能体的原生 AI 浏览器可能先出现。这些都是预测,并非此次公告已经实现的功能。
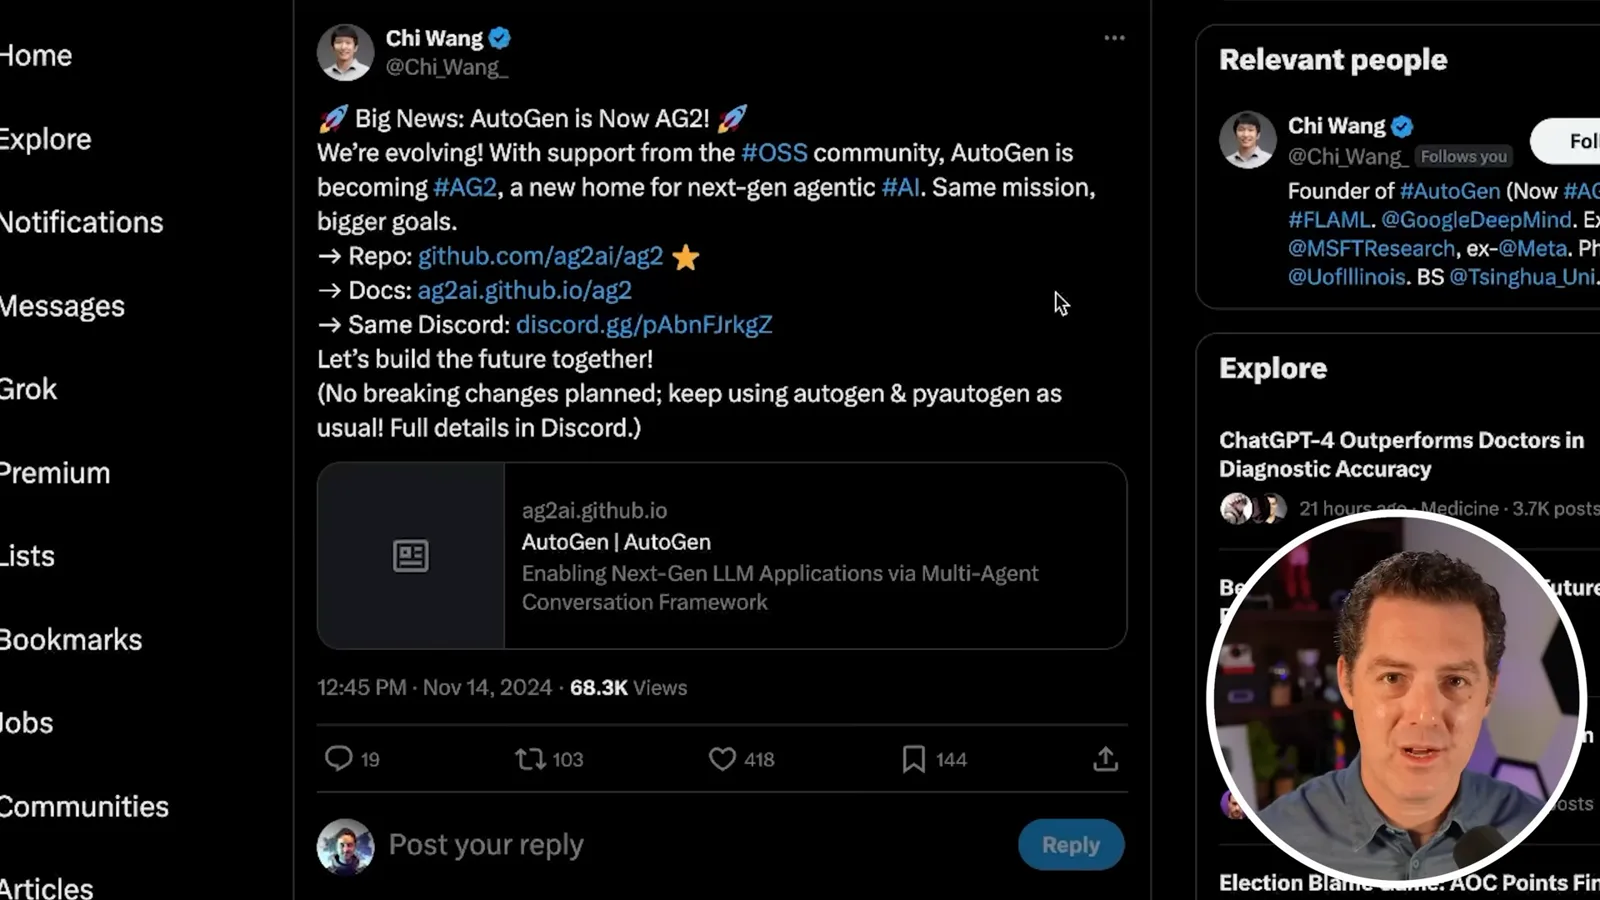
Chi Wang 宣布 AG2 成为基于 AutoGen 的智能体 AI 新项目。视频简介中的更正说明,AG2 是 AutoGen 的一个分支,并不是 Microsoft 的 AutoGen 项目。它仍然开源;不应把这一公告理解为 Microsoft 只是给自己的项目改名。
核安全与算力
相关报道涉及 Anthropic 的核安全红队测试和 xAI 融资。Berman 思考核决策中的人类控制。
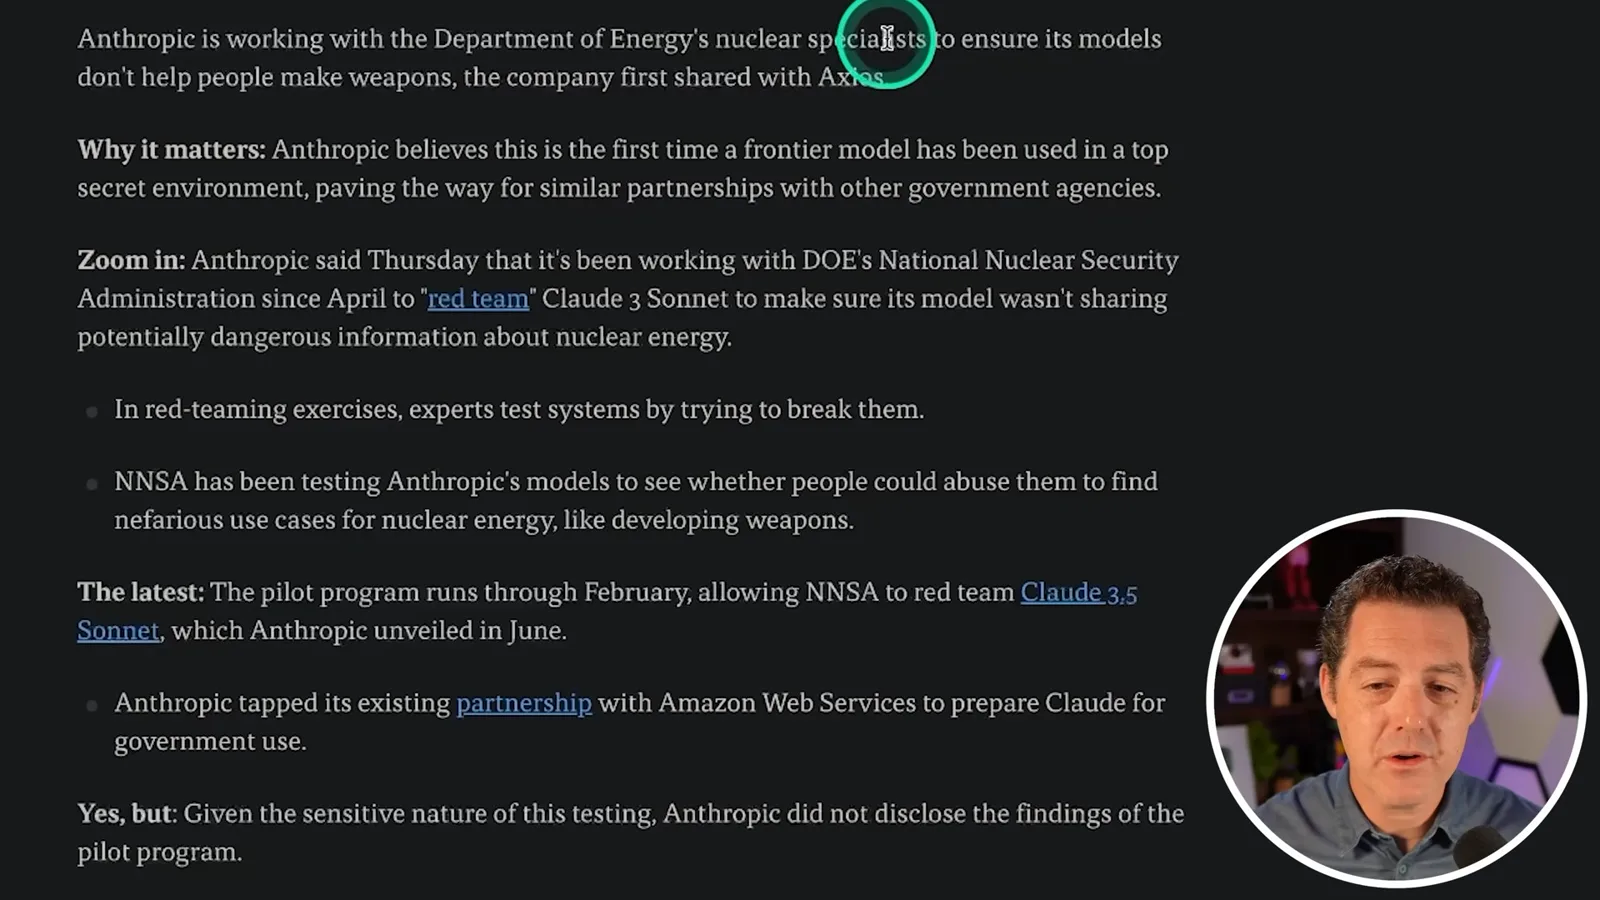
Anthropic 表示,它正与美国能源部的核专家及国家核安全管理局合作,对模型开展红队测试,评估可能提供危险核信息的风险。据报道,试点测试了模型是否可能被滥用于协助武器研发;所引报道没有披露测试结果。这类测试用于评估风险,并不能证明模型泄露了机密,也不能证明它完全安全。
一篇报道称,xAI 正寻求最多 60 亿美元融资,计划与购买更多 Nvidia GPU 有关,报道所称估值为 500 亿美元。这些数字是当时的融资报道,并不能证明所有计划中的采购已经完成。我很期待看到额外算力是否会带来更强的 Grok 模型。
有关拜登总统和习近平主席 2024 年会晤的一篇报道说,两国领导人确认了在核武器使用决策中保持人类控制的必要性。我欢迎这一原则,也担心依赖可能产生幻觉或遭到操纵的系统。这一声明是政治意愿的表达,并不能证明存在经过验证的技术执行机制或全面军控条约。
医疗 AI、硬件与购物
Berman 讨论一项诊断推理试验和报道中的 Blackwell 服务器问题,最后介绍 Perplexity 购物功能的发布。
我讨论了一项小型研究:研究人员使用临床案例摘要,比较有无 GPT-4 辅助的医生与单独使用 GPT-4 的诊断推理表现。原始随机试验涉及 50 名医生;有模型使用权一组的推理中位分数为 76%,仅使用传统资源一组为 74%,差异在统计上不显著。模型单独作答的比较属于探索性分析,其评分更高。视频称聊天机器人得分约为 90%,但这不能证明它在实际患者诊疗中持续优于医生。
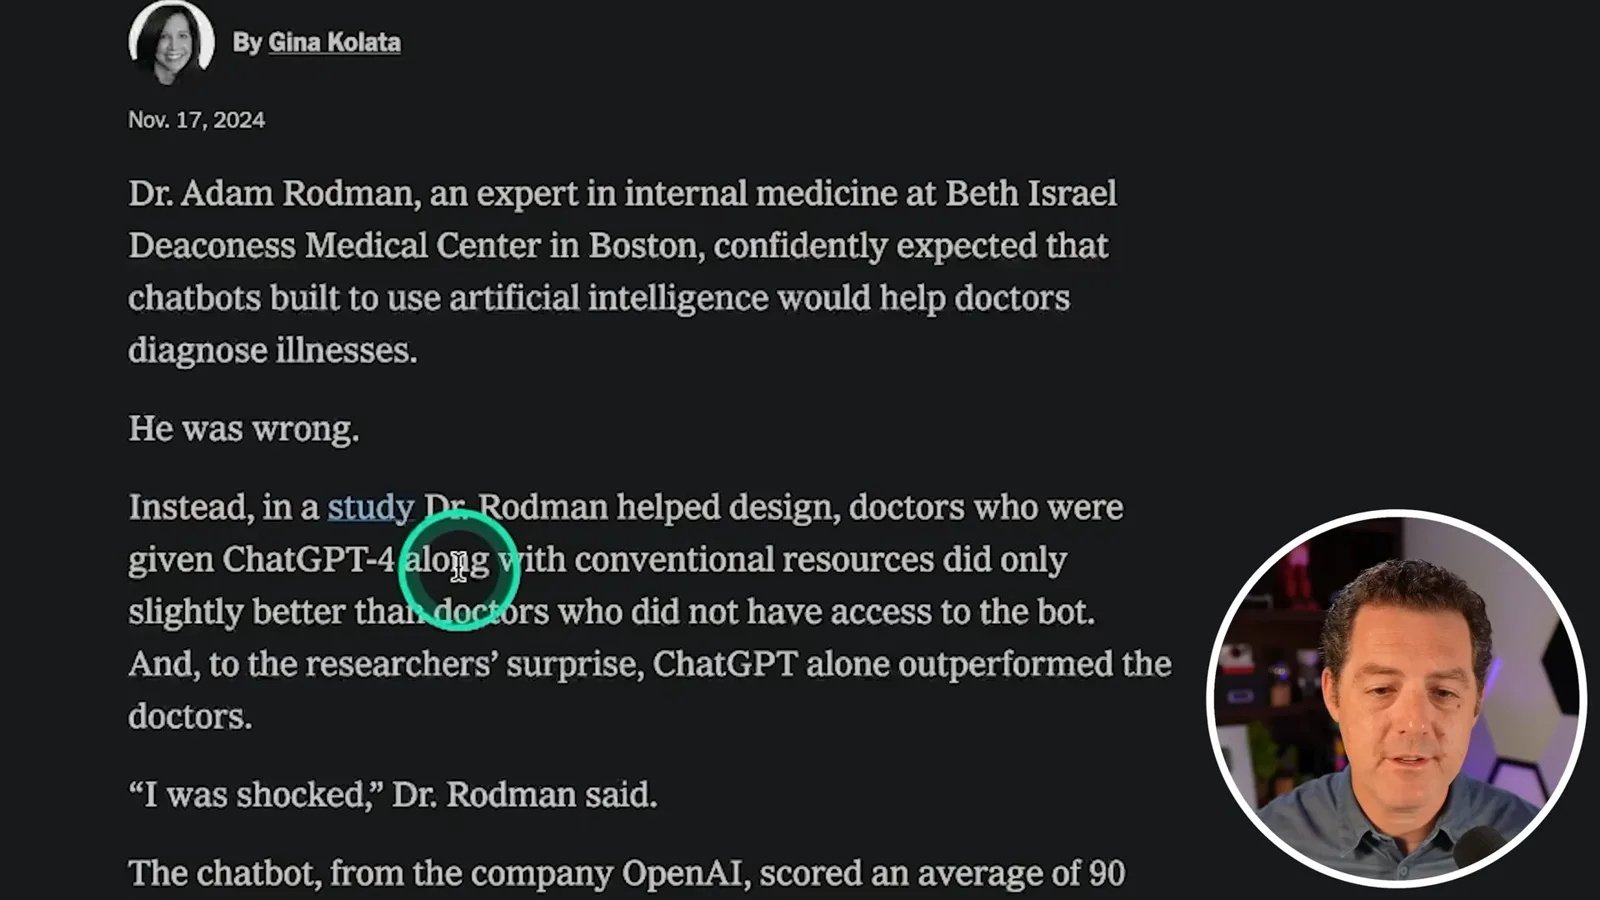
我对 AI 帮助临床医生分析病例持乐观态度,例如由医生审核最终决策。但案例摘要和小型研究不能涵盖完整的临床工作流程,模型错误仍然重要。我对进一步改进的期待是一种预测,不能保证未来每个模型在所有医疗场景下都会更好。
路透社援引 The Information 报道称,当 Nvidia Blackwell 的 GPU 连接在高密度机架中时,系统面临过热方面的担忧,导致设计调整,并让客户担心部署进度。这是 2024 年 11 月报道的工程问题,并非所有 Blackwell 安装都失败的结论,也不是对当前硬件状况的描述。
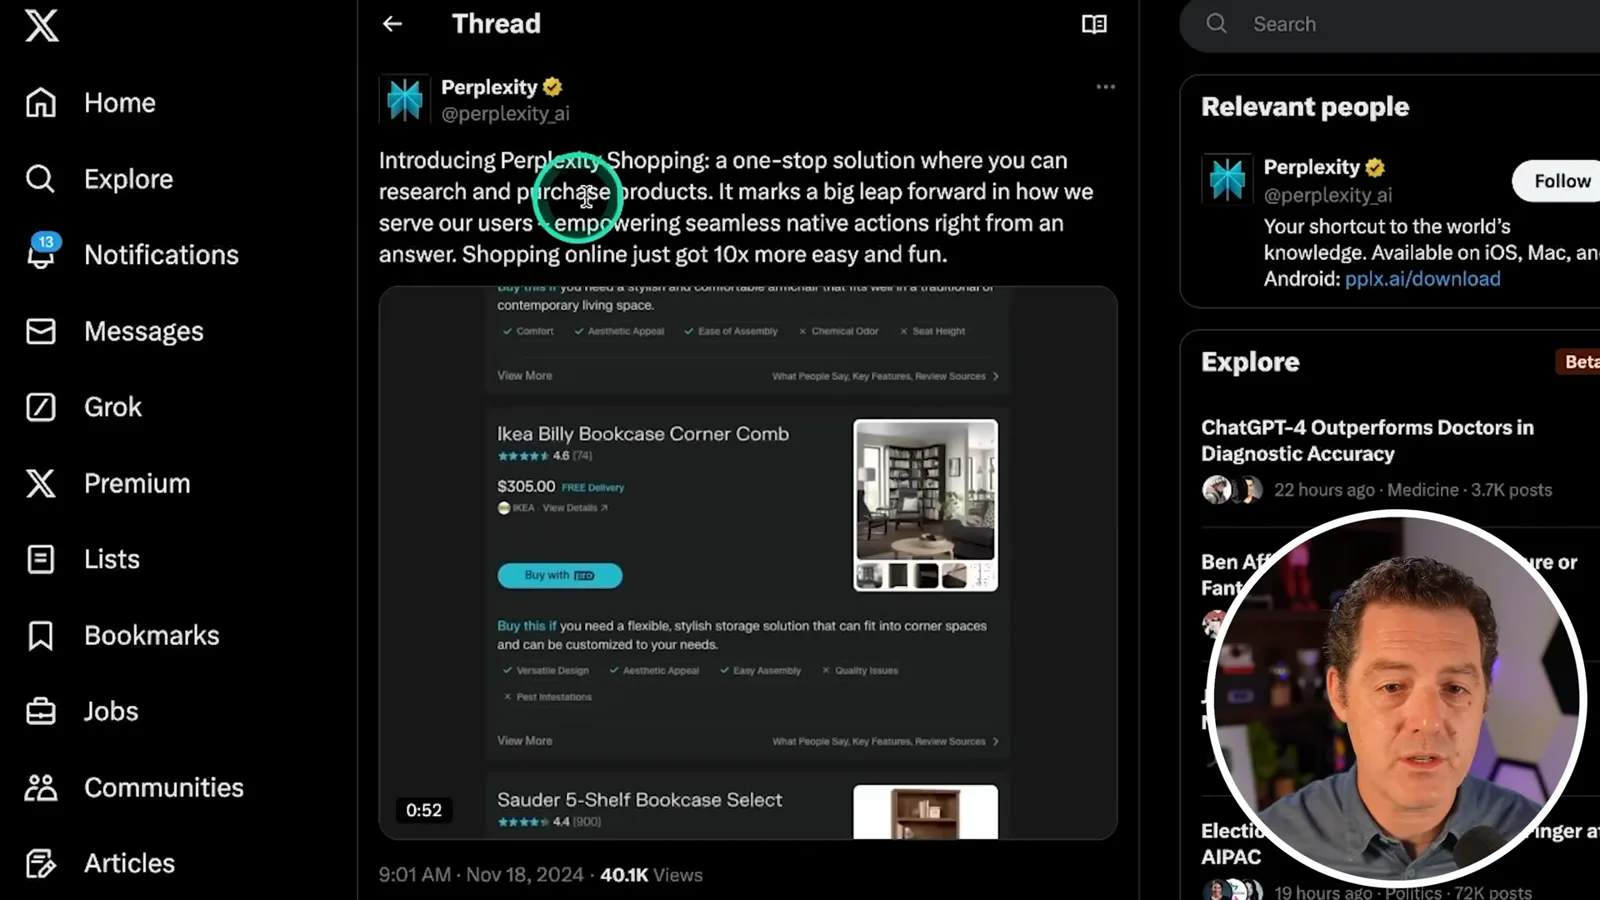
Perplexity 宣布了用于研究和购买商品的购物功能,包括一键结账和商家计划。我认为原生交易可能减少操作阻力,也能成为订阅以外的变现方式,打算亲自试用。我还提到,自己搜索时主要依赖 Perplexity 和 ChatGPT 而非 Google;这是我的个人使用情况,并非整个市场的统计。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。