30 秒看懂
Matthew Berman 分享对 Claude Opus 4.6 的初步印象,介绍 Anthropic 发布时的基准测试和 Claude Code 的智能体团队。他讨论并行智能体的成本、长上下文检索的局限,以及视频赞助商 Box 的企业评测。 视频反映发布当天的信息和观点;其中对任务时间跨度及售货机基准的描述需要下文所作的更正。
- 1时间跨度衡量什么图中的小时数是预测成功率为 50% 时,专家完成任务所需的时间,而不是智能体的运行时间。
- 2赞助商的企业评测Box 报告了自有文档任务的成绩提升,并赞助了本期视频。
- 3智能体团队与成本多个独立的 Claude Code 实例可以协调和通信,但会消耗更多 token 并增加开销。
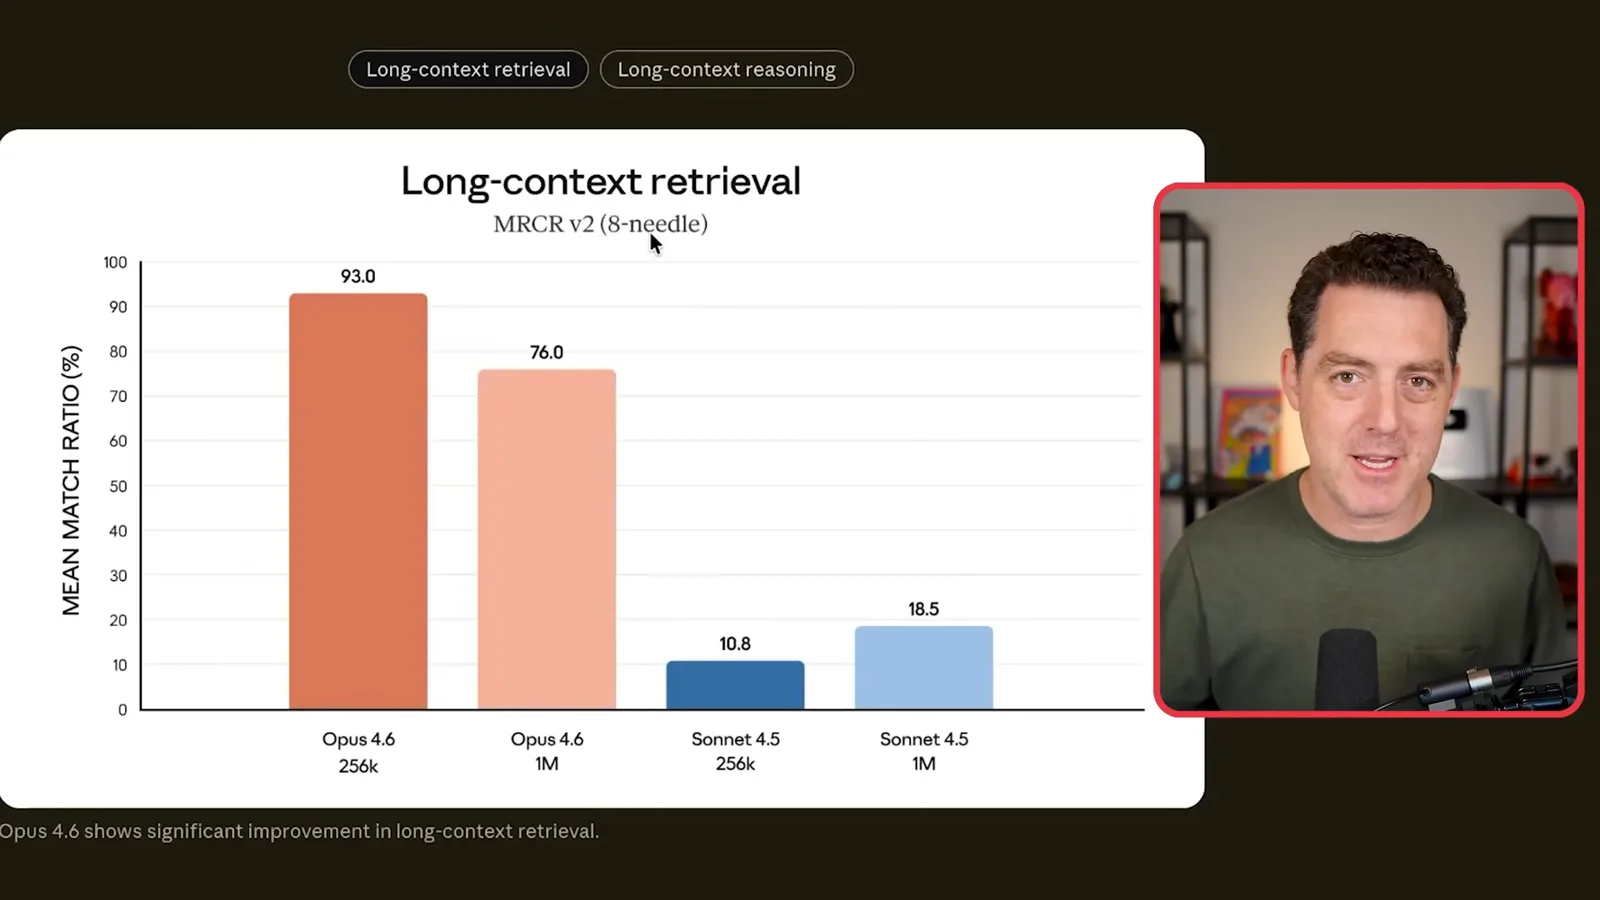
- 4长上下文检索Anthropic 报告,MRCR v2 平均匹配率在 25.6 万 token 时为 93%,在 100 万 token 时为 76%。
要点建议
- Opus 4.6 发布时提供测试版的 100 万 token 上下文窗口,但检索质量仍随上下文长度变化。
- 智能体团队可以让彼此通信的 Claude Code 会话分担并行工作,但需要消耗更多 token 并增加协调成本。
- METR 的时间跨度衡量在给定预测成功率下,人类完成任务所需的时间,而不是智能体的运行时间。
- Anthropic 和赞助商 Box 分别在各自的评测条件下报告了基准成绩提升。
- 发布定价和比较反映的是 2026 年 2 月的情况,不应视为当前信息。
按章节阅读整理后的全文
为更长任务打造的模型
Berman 分享对 Opus 4.6 的初步印象,并讨论软件任务的时间跨度。文章澄清了图表中的时间指标。
我提前体验了 Claude Opus 4.6,初步感觉它比 Opus 4.5 有了显著进步。Anthropic 表示,新模型规划更周密,在大型代码库中工作更可靠,也更擅长审查和调试自己的工作。在我看来,关键主题是更长时间的智能体任务:人们越来越希望编程智能体能分派工作,并持续处理更复杂的任务。
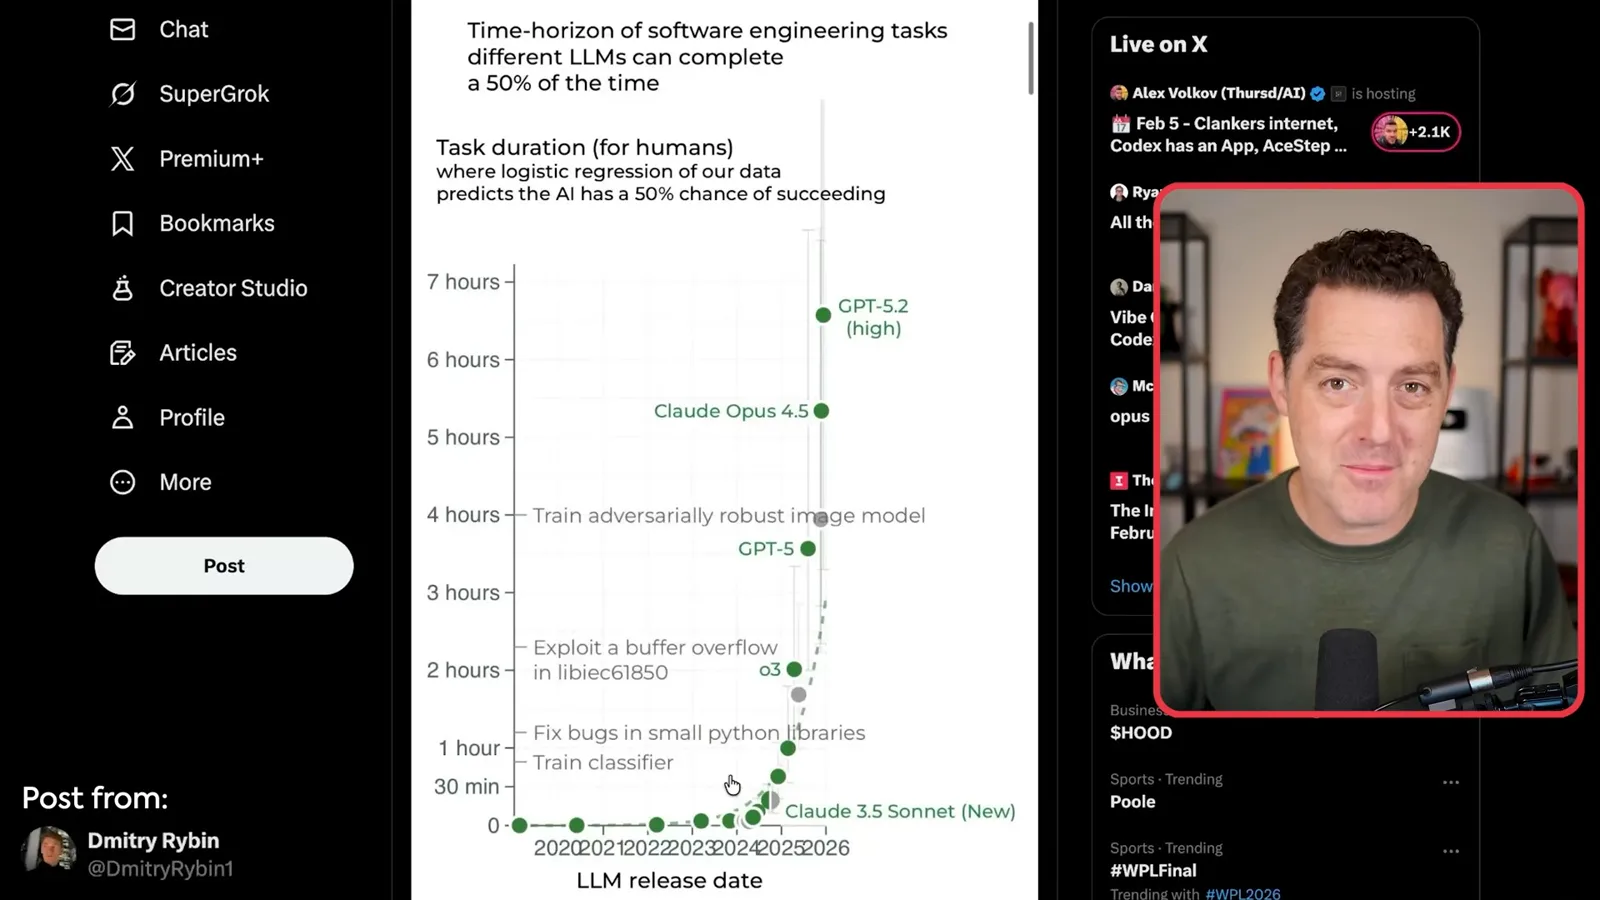
我展示的一张图说明软件工程任务的时间跨度增长很快。我把 GPT-5.2 约 6.5 小时的结果说成自主运行时间,但这一解释需要更正:METR 的 50% 时间跨度指智能体预测成功率为 50% 时,专家完成相应任务预计需要多长时间,而不是智能体实际运行的时长。图表早于这些新模型,因此不能说明 Opus 4.6 的结果。
百万 token 与企业工作
他探讨更大的上下文窗口及其对软件企业可能产生的影响。随后介绍 Box 赞助的企业基准测试。
Opus 4.6 发布时还提供了测试版的 100 万 token 上下文窗口,与我所了解的早期 Claude 模型约 20 万 token 相比大幅增加。大型代码库和文档集合可能因此受益,但容量本身还不够:随着上下文变长,模型还需要保持质量,检索并使用相关信息。这个问题常被称为上下文退化。
我认为这些智能体可能与市场上所谓的“SaaS 末日”焦虑有关。一些观察者将软件公司估值据称出现的下跌,与 Anthropic 的工作工具插件以及智能体通过聊天界面处理更多任务的前景联系起来。这只是对市场走势的解释,并不能证明这些公司将失去客户。Claude Cowork 及其集成也是我认为值得关注这个问题的原因。
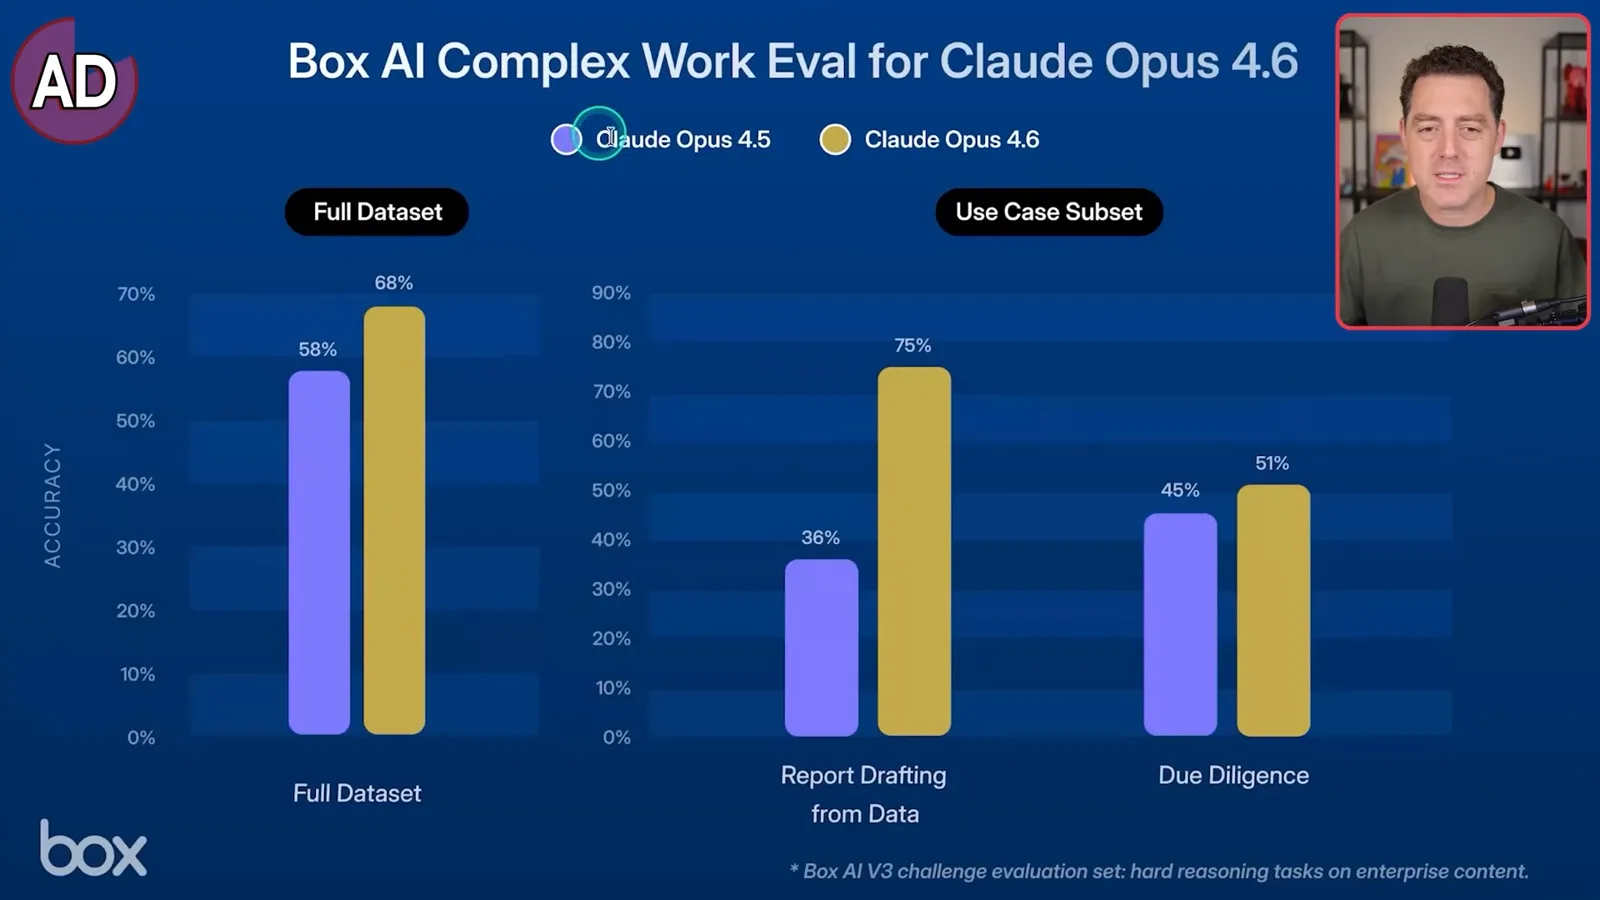
赞助本期视频并提前获得模型使用权的 Box 发布了自己的企业内容评测。其图表显示,Opus 4.5 到 4.6 在完整数据集上的得分从 58% 升至 68%;报告撰写从 36% 升至 75%,尽职调查从 45% 升至 51%。Box 还报告了多个行业子集的提升。这些是 Box 自选评测的结果,不能作为所有工作场景表现的通用衡量标准。
基准测试与智能体团队
Anthropic 发布时的图表比较了知识工作、搜索、编程和推理表现。Berman 解释团队如何协调以及成本为何更高。
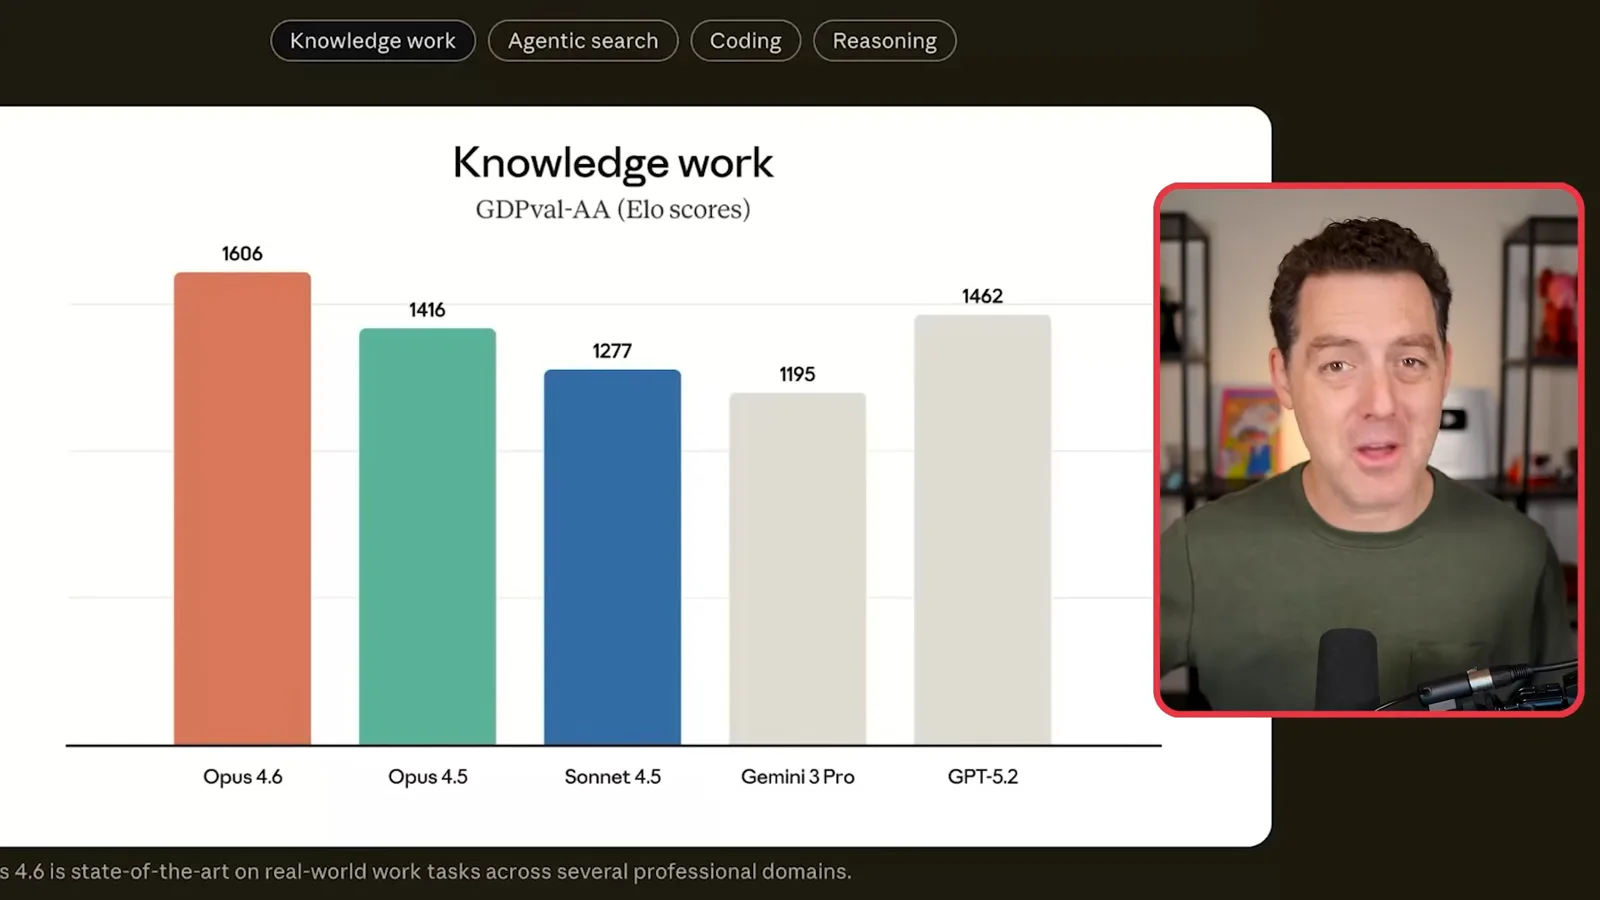
Anthropic 发布时的图表显示,Opus 4.6 在 GDPval-AA 上的 Elo 分数为 1,606,Opus 4.5 为 1,416,GPT-5.2 为 1,462。该公司还报告了 BrowseComp 的 84 分和 Terminal-Bench 的 65.4%;GPT-5.2 Codex 在后者上成绩接近。Humanity’s Last Exam 的结果则取决于是否提供工具。我对这些结果很兴奋,但每项比较都受其基准、设置和发布时可用模型的限制。
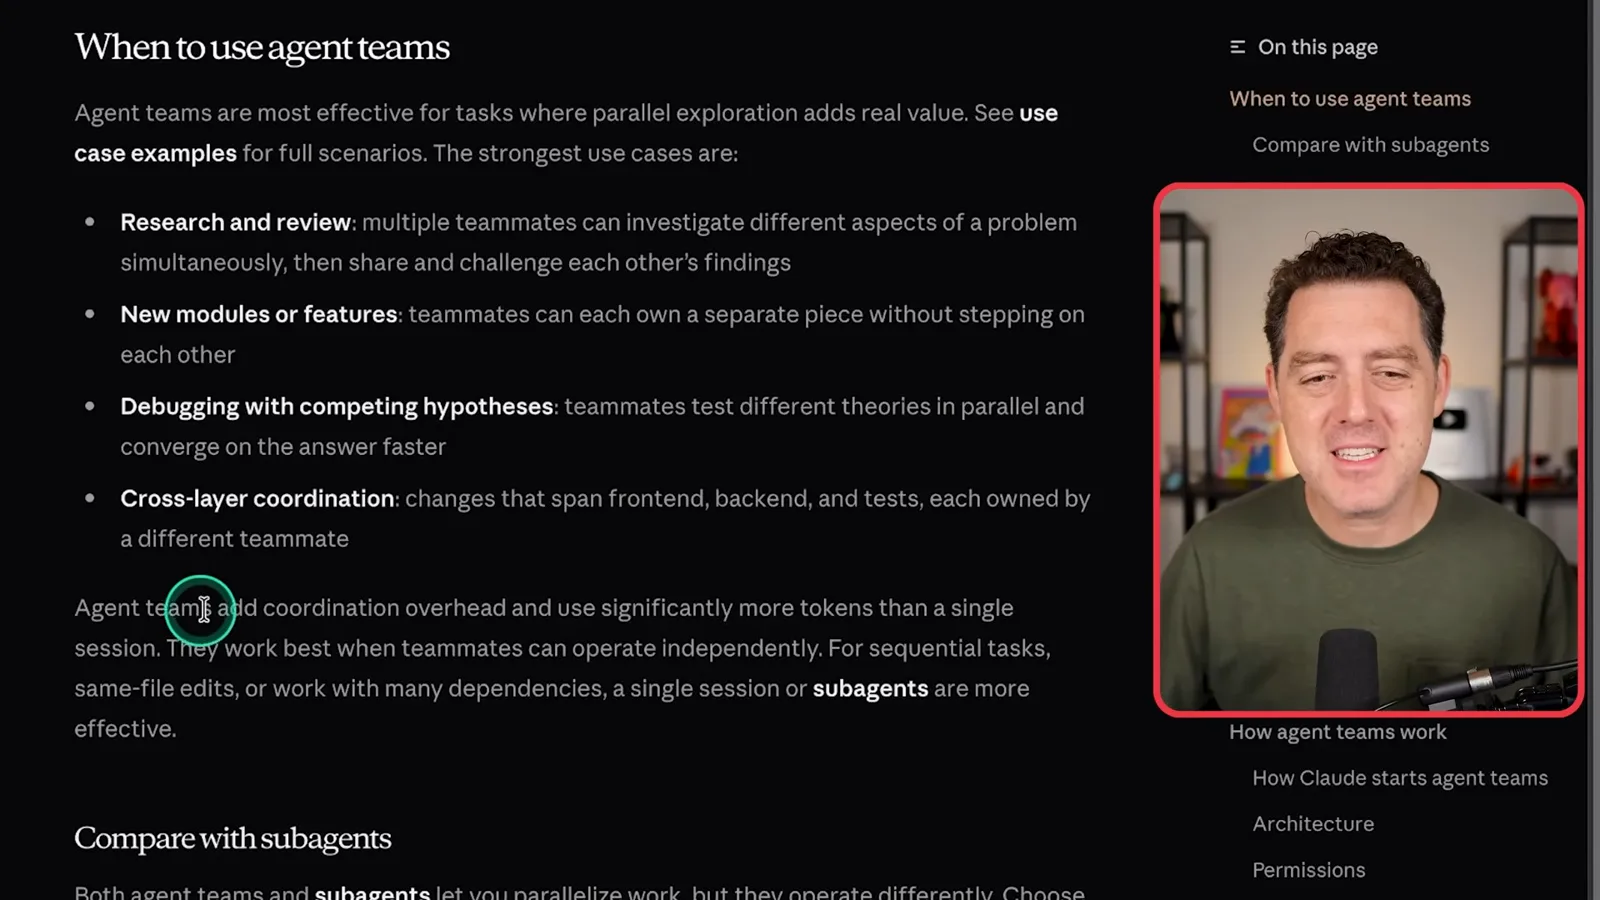
Claude Code 的智能体团队协调多个实例:团队负责人分派并整合工作,队友各自拥有独立的上下文窗口,还能相互直接通信。与文档描述的子智能体模式不同,用户也可以直接与各个队友互动。这适合并行研究、独立功能开发、验证不同的调试假设,以及跨项目层级的协调。
并行也有代价。每个实例都会消耗 token,团队还会增加协调开销;Anthropic 文档指出,顺序任务、同一文件的编辑以及依赖较多的工作,可能更适合单个会话或子智能体。我认为,在决定额外协作是否值得时,运行多个 Opus 实例的成本很重要。
控制方式、集成与发布定价
上下文压缩、自适应思考和 effort 控制提供了管理长任务的方式。Berman 回顾发布时列出的价格。
API 还引入了上下文压缩,通过总结已有上下文为更长的任务腾出空间。压缩可能丢失重要细节,尽管更大的上下文窗口能推迟压缩的必要性。自适应思考让模型调整推理投入,effort 控制则提供了在智能水平、速度和成本之间权衡的方式。Anthropic 还宣布改进 Excel 功能,并推出 Claude in PowerPoint 的研究预览版。
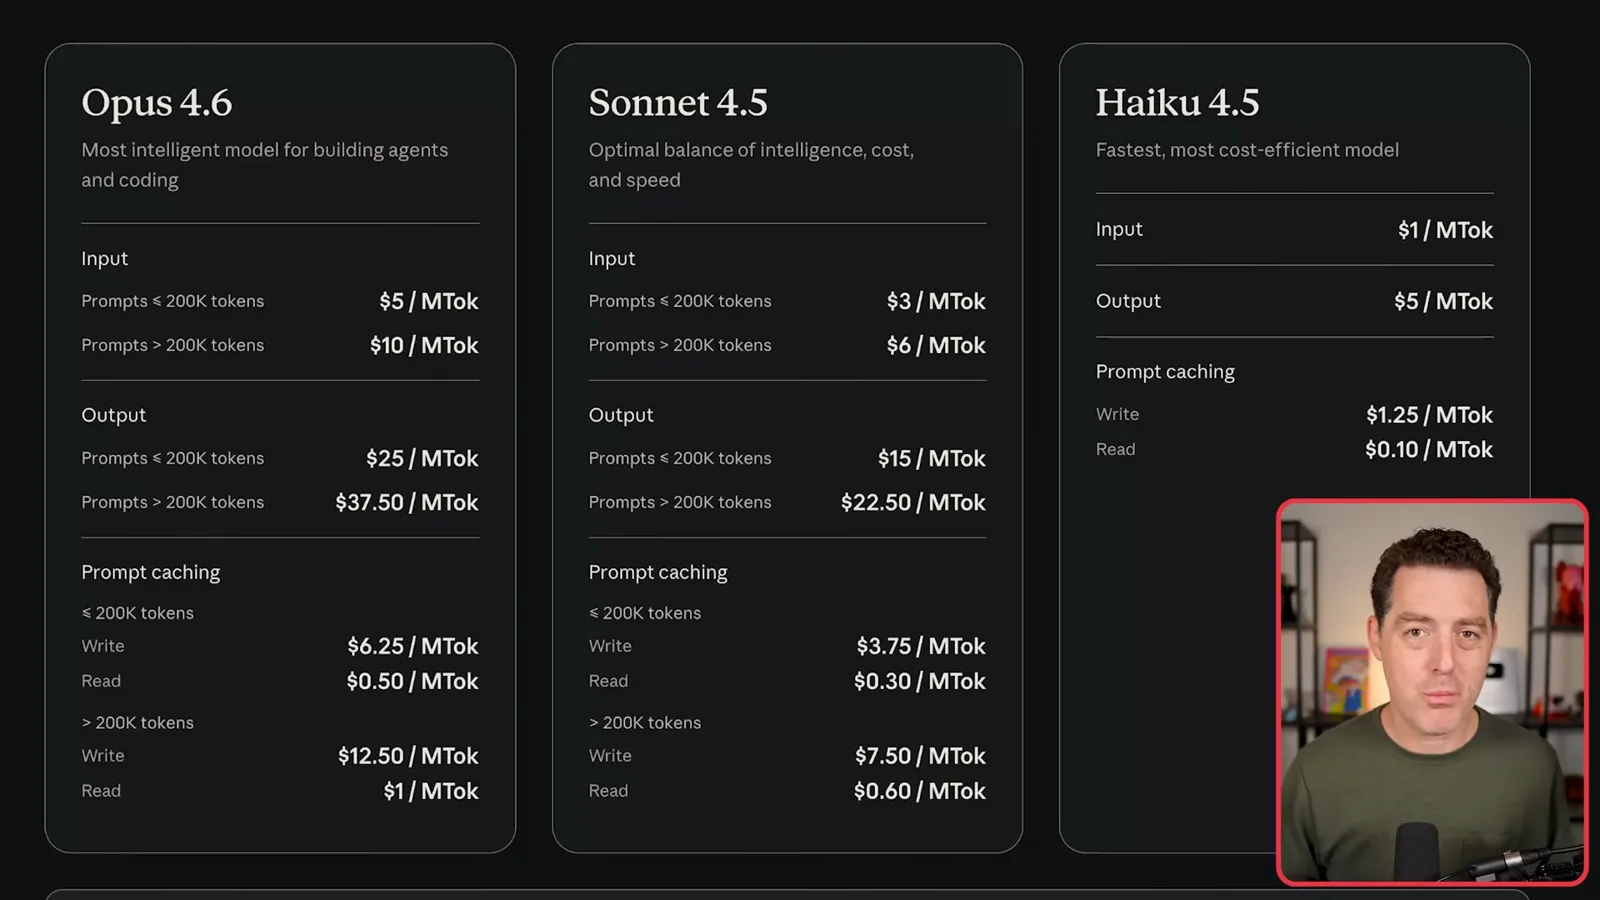
在 2026 年 2 月发布时,Anthropic 列出的 Opus 4.6 价格为:提示词不超过 20 万 token 时,每百万输入 token 5 美元、每百万输出 token 25 美元;超过这一门槛时分别为 10 美元和 37.50 美元。提示词缓存有单独费率。这些是历史发布价格,可能已经变化。更充分的思考能改善困难任务的结果,也可能增加延迟和成本。
长上下文、模拟经营与安全
Berman 考察检索、推理和 Vending-Bench 的结果,最后介绍 Anthropic 的行为审计及进一步测试计划。
长上下文的问题不仅是模型能否接收 100 万 token,还包括它能否找到细节并综合推理。Anthropic 的 MRCR v2 八针测试图表显示,Opus 4.6 在 25.6 万 token 时的平均匹配率为 93%,在 100 万 token 时为 76%。随着上下文变长,成绩有所下降,不过图中与 Sonnet 4.5 的差距仍然很大。此项检索测试的表现不能保证模型可靠理解每一份长文档。
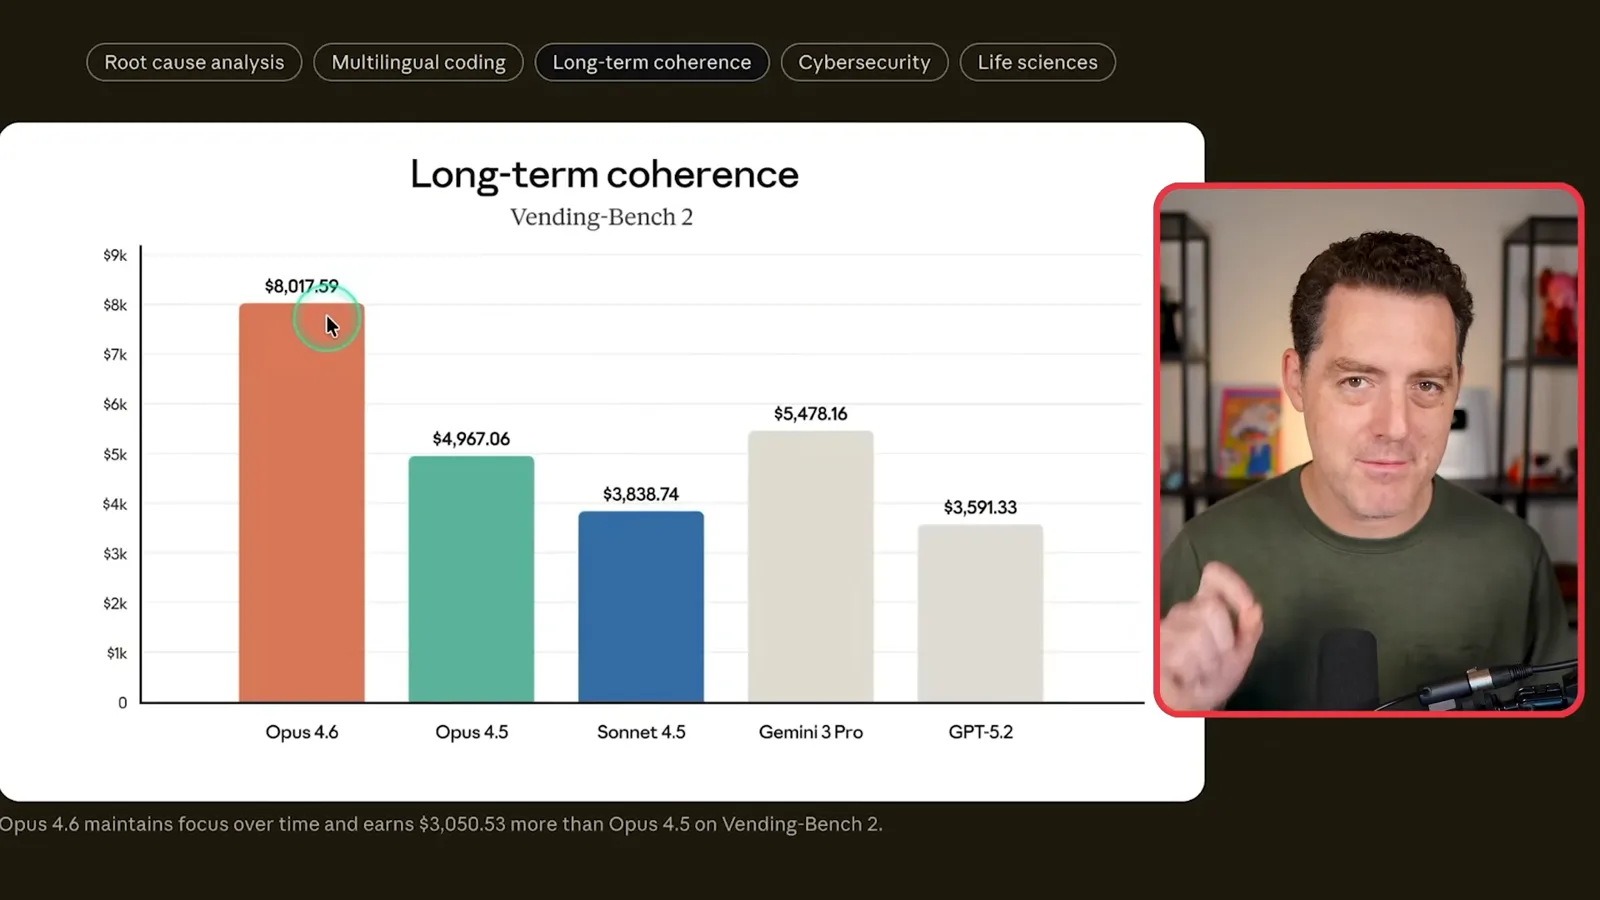
Anthropic 还展示了长上下文推理、根因分析、多语言编程、网络安全和生命科学评测。其 Vending-Bench 2 图表显示,Opus 4.6 的结果约为 8,018 美元,Opus 4.5 约为 4,967 美元。我在视频中把它说成真正的自动售货机,但该基准模拟的是售货业务,因此这些数字是模拟结果,并非真实机器的收入。
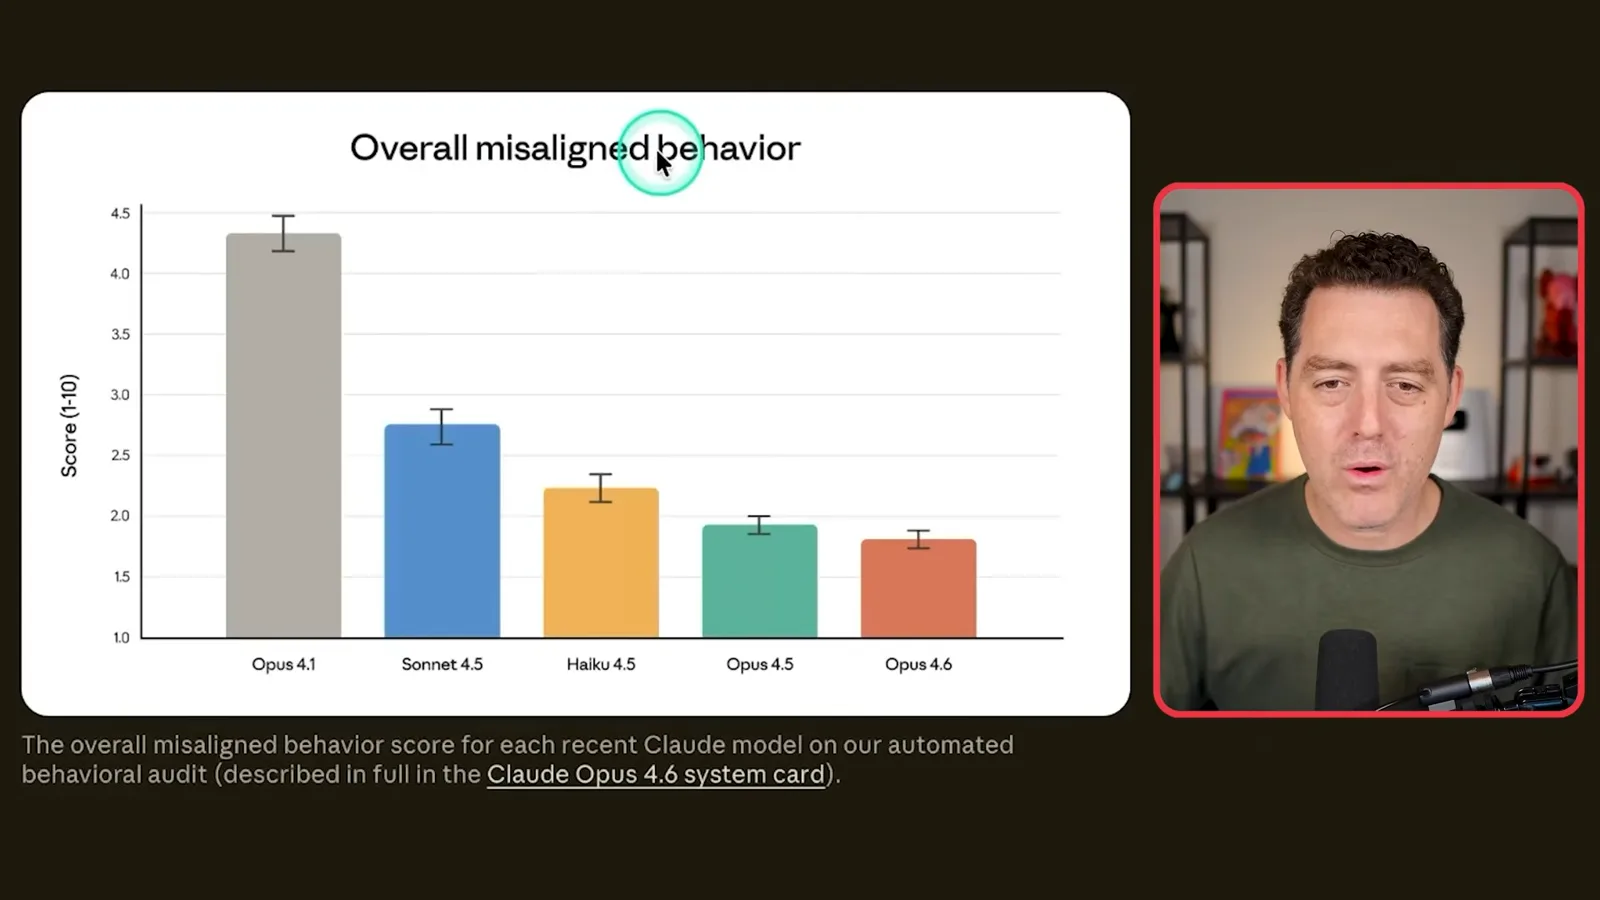
最后,Anthropic 的自动化行为审计图表显示,在该项评测中,Opus 4.6 的总体失调行为分数低于 Opus 4.5。单次审计的分数不能证明模型在所有部署场景中都安全。我的初步评价是积极的,接下来计划进一步测试,包括将它用于我的智能体配置。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。