30 秒看懂
Nathan Lambert 回顾后训练课程中反复出现的语言模型与机器学习概念,将 PyTorch 张量操作和解码与概率、奖励建模及强化学习联系起来。
- 1语言模型头模型头把隐藏状态转换为词表分数,再转换为 token 概率。
- 2序列概率移动标签,提取 token 对数概率,再对补全部分求和。
- 3三种掩码因果、填充和补全掩码控制计算的不同部分。
- 4中间训练这一中间阶段为后续后训练准备预训练模型。
- 5KL 与熵KL 是有方向的散度,与熵和交叉熵有关。
要点建议
- 序列概率可以分解为逐个预测 token 的概率,其对数则可以相加。
- 因果掩码、填充掩码和补全掩码各有用途。
- 预训练、中间训练和监督微调是模型开发中相互关联的阶段。
- KL 散度有方向性,不是数学意义上的距离。
- 后训练结合采样、目标函数和奖励来塑造模型行为。
按章节阅读整理后的全文
语言模型预备知识
Lambert 回顾 token 分布、模型头、softmax 和对数概率,并解释机器学习与 PyTorch 基础为何有帮助。
阅读 RLHF book 之前需要了解什么?课程主要面向硕士和博士学生,但有动力的读者也可以学习。本讲回顾语言模型后训练中反复出现的机器学习和概率概念。
熟悉一些机器学习和 PyTorch 知识,包括损失、反向传播和梯度,会很有帮助。我们将从语言建模、优化、KL 散度和强化学习入手。
语言模型表示 token 序列上的概率分布。每一步都预测下一个 token 的概率分布。序列概率是各条件 token 概率的乘积,训练则鼓励模型为观察到的下一 token 分配更高概率。
现代语言模型通常是基于自注意力的 decoder-only Transformer。我建议了解 Transformer 的历史和重要性,虽然架构史不属于这门课程的范围。
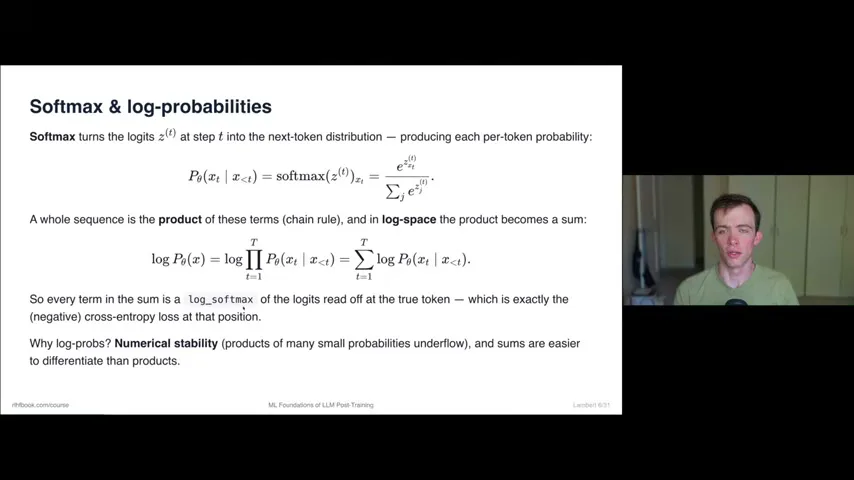
语言模型头将隐藏状态向量映射为 logits,即词表中每个 token 的分数。Softmax 将这些分数转换为概率分布,供模型选择 token。其他后训练架构可以添加不同的头,例如用于估计奖励或价值的标量头。
Softmax 对分数取指数并归一化,使概率之和为一。序列概率是乘积,但序列的对数概率是各 token 对数概率之和。这既方便求导,也能避免许多很小的概率相乘导致数值下溢。
训练样本与解码
PyTorch 示例展示如何对齐下一 token 标签并应用掩码。解码方法从模型分布中选取 token。
一个典型的 PyTorch 示例从输入 token ID 开始,批次大小为 B、序列长度为 L。前向计算输出的 logits 包含批次、序列位置和词表三个维度。代码随后将每个位置与真正的下一 token 对齐。
构造下一 token 标签时,去掉最后一个位置的 logit,并将输入标签移动一位。应用 log-softmax,提取每个真实下一 token 的对数概率,再对相关项求和,就得到序列对数概率。
许多后训练示例使用补全掩码,让损失只选择模型回答,而不训练提示词。理解张量形状、位置移动和掩码,能够让后训练代码不那么难以阅读。
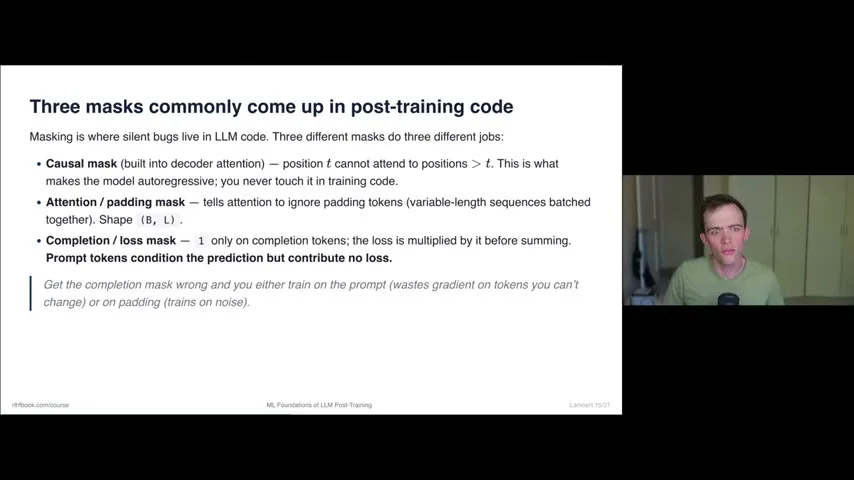
三种掩码各司其职:因果掩码阻止注意力看到未来 token;填充或注意力掩码标识批量序列中的填充部分;补全或损失掩码选择对训练目标有贡献的回答 token。
解码时,贪心选择在每一步取概率最高的 token。温度采样先缩放 logits 再进行采样:较高温度通常使选择更多样,较低温度则让概率更集中于高分 token。束搜索和截断采样是其他选择。
优化与模型阶段
交叉熵与梯度下降用于训练语言模型。预训练、中间训练和监督微调发挥不同作用。
交叉熵比较预测分布与目标。对单个正确的下一 token 标签,最小化负对数似然会提高模型分配给该 token 的概率。Lambert 指出,这个目标与前面展示的对数概率计算有关。
基于梯度的优化会更新模型参数,学习率控制更新幅度。Lambert 说 Adam 仍广泛用于后训练,也存在其他优化器。本课程重点讨论训练方案,而非优化器细节。
预训练从大量文本和代码中学习下一 token 预测。中间训练是一个公开资料较少的过渡阶段,可以更重视高质量数据,并为推理或智能体行为做准备。监督微调随后使用指令与回答样本进行训练。
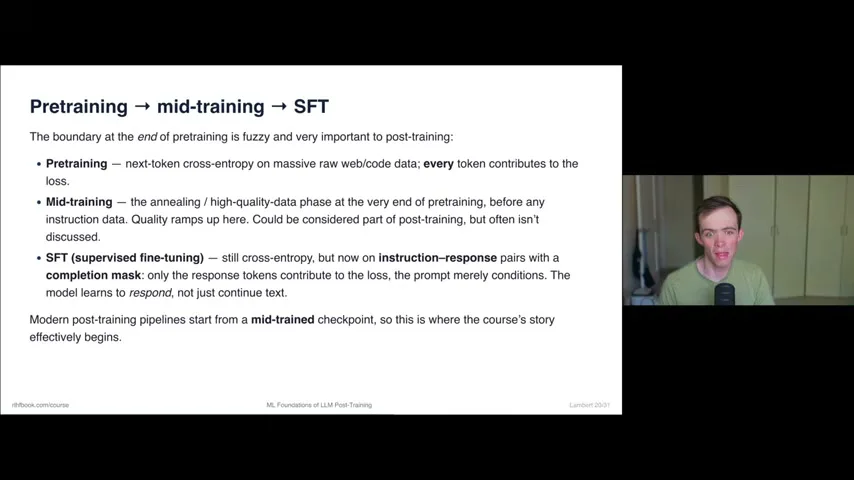
这些阶段相互影响:后训练方案依赖前面步骤产生的模型和数据。Lambert 强调,中间训练虽然在书中讨论较少,但很重要,部分原因是其细节通常没有公开记录。
概率与强化学习
KL、熵、蒙特卡洛估计和 sigmoid 贯穿后训练。Lambert 最后介绍强化学习框架与延伸阅读。
KL 散度衡量概率分布之间有方向的差异,并且非负。后训练中经常使用它,例如衡量或约束策略变化。Lambert 有时称它为距离,但他在之后更正:KL 不对称,因此不是数学意义上的距离。
熵、交叉熵和 KL 密切相关。熵描述一个分布下的平均惊讶程度;交叉熵衡量用另一个分布表示目标分布样本的代价。交叉熵等于目标分布的熵加上从目标到近似分布的 KL 散度。
蒙特卡洛估计利用采样样本近似期望。例如,可以从策略中采样 token,再对当前策略概率与参考策略概率之比的对数求平均。采样分布以及 KL 的方向都很重要。
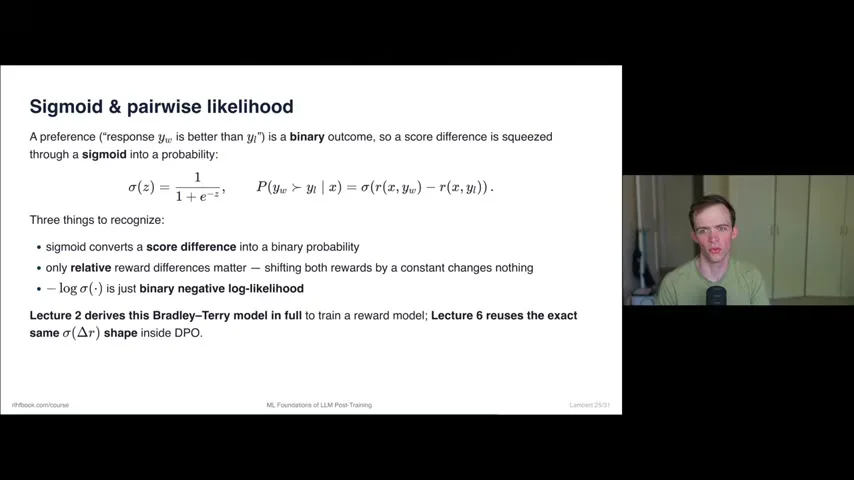
Sigmoid 将实数分数映射到零与一之间。奖励建模使用它把选中回答和被拒回答的分数差转换为成对偏好概率。它是偏好损失中反复出现的构件。
马尔可夫决策过程用状态、动作、转移概率、策略、奖励和折扣因子描述智能体与环境的互动。通过试错,智能体可以逐渐改善行为。
语言模型场景可能让这一框架看起来有些特殊,但执行长期复杂任务并使用工具的智能体,可能更接近传统强化学习环境。奖励可能稀疏或延迟,环境动力学也可能事先未知。
后训练结合采样、损失、约束、正则化和奖励等工具,改变预训练语言模型的分布,使其实现更具体的目标。Lambert 推荐 Sutton 和 Barto 的强化学习教材、Sebastian Raschka 的《Build a Language Model from Scratch》,以及课程网站上的资源。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。