30 秒看懂
Matthew Berman 解释 DeepSeek-OCR 的编码器、解码器和报告的重建结果,并讨论以图像作为语言模型输入的设想。论文只测试了有限的 OCR 基准;有关扩展其他模型上下文窗口的说法属于推论。视频包含 Dell Technologies 的赞助内容。
- 1以视觉形式表示文本所提出的压缩比比较了分词后的参考文本和编码器产生的视觉 token。
- 2编码器与解码器DeepEncoder 压缩图像特征,随后混合专家解码器重建文本。
- 3精度与压缩的权衡在作者的 Fox 基准实验中,随着测得的压缩比提高,OCR 精度下降。
- 4更广泛的研究问题Karpathy 推测语言模型可使用图像输入;论文并未证实这些更广泛的益处。
- 5训练数据作者报告收集了 3,000 万页 PDF,其中大部分为中文和英文。
要点建议
- DeepSeek-OCR 使用压缩后的视觉表示,从文档图像中重建文本。
- 论文报告,在一个特定的 100 页英文测试集上,压缩比低于 10 倍时 OCR 精度约为 97%。
- 实验中更高的压缩比带来更低的精度:接近 20 倍压缩时约为 60%。
- Token 比例不能证明可用上下文扩大十倍,也不能证明延迟和总计算量有所节省。
- 视频包含 Dell Technologies 赞助的硬件环节。
按章节阅读整理后的全文
Berman 为什么关注视觉压缩
Berman 介绍 DeepSeek-OCR,以及用更少视觉 token 表示文档文本的概念。这是概念验证,并未证明它能扩展每个模型的上下文。
DeepSeek-OCR 是一款用于光学字符识别的视觉语言模型,也就是从图像中提取文本。让我感兴趣的不只是读取文档,还有研究人员提出的用更少输入 token 以视觉形式表示文本的方式。他们在 2025 年 10 月的论文中将其视为初步概念验证,而非已经证明现有聊天模型的可用上下文能扩大十倍。
其直观想法是,一页图像可以承载文本,而这些文本按传统方式分词后,长度会超过该图像的视觉 token 表示。研究人员报告,在实验中压缩比低于 10∶1 时,OCR 解码精度约为 97%。这一比例比较的是真实参考文本的 token 数与编码器的视觉 token 数;它并不保证无损压缩。
上下文窗口限制了语言模型一次能够考虑多少输入。更长的序列可能带来更高成本;传统稠密注意力的某一计算部分随序列长度呈平方增长,不过总成本还取决于架构和推理方法。我认为更紧凑地表示文档可能有益,但 OCR 实验本身并不能证明任何特定模型都能有效使用十倍的上下文。
DeepSeek-OCR 如何工作
系统编码图像块,再将压缩后的表示解码成文本。内部特征压缩与测得的文本和视觉 token 比例是不同的概念。
[论文](https://arxiv.org/abs/2510.18234)将 OCR 作为以视觉形式编码文本并重建文本的测试。文字渲染得太小,图像缩放后可能无法辨认,因此一张图片能够容纳多少文本存在限制。该测试评估的是文档重建,而非长上下文问答或其他下游任务的表现。
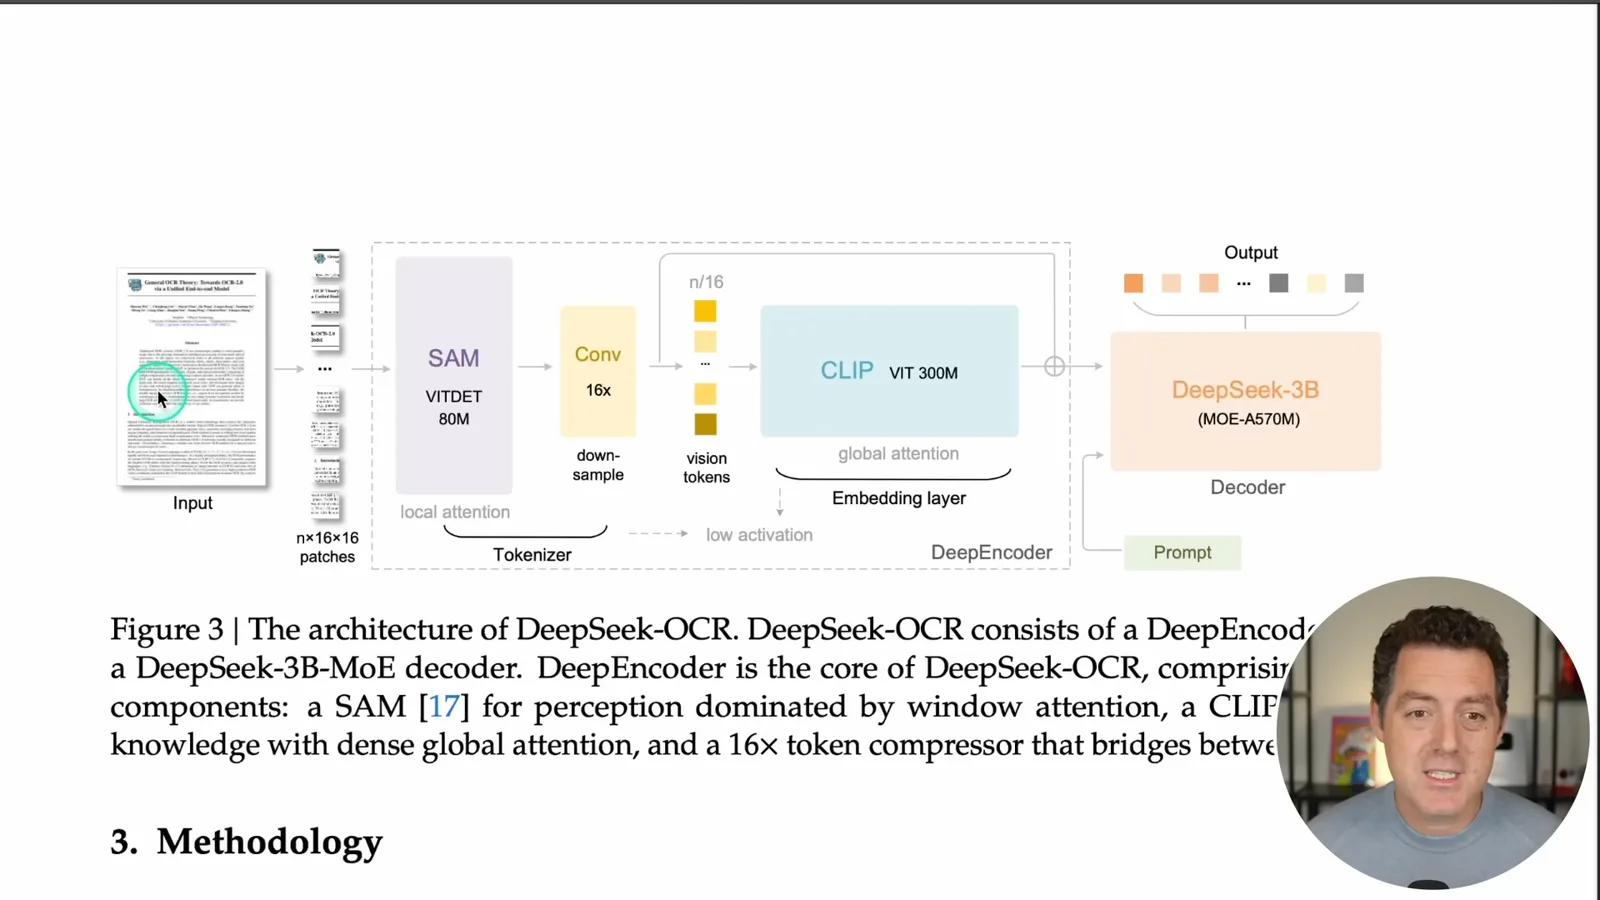
架构将输入图像划分为图像块,再交给 DeepEncoder。它结合基于 SAM 的局部注意力编码器、一个将 token 数压缩 16 倍的卷积压缩器,以及基于 CLIP 的全局注意力编码器。压缩后的表示进入 DeepSeek 3B 混合专家解码器,后者约有 5.7 亿个活跃参数,用于生成文本。内部对视觉 token 的 16 倍压缩不同于测得的文本与视觉 token 比例。
重建结果与局限
Berman 将结果推演到更长的上下文窗口,并回顾作者报告的 OCR 数据。实验使用了有限的英文文档集,没有测量所设想的端到端集成。
我设想未来的系统可以利用这种思路,在相同 token 预算内容纳更多信息。视频中我提出,一个拥有 100 万或 200 万 token 上下文的模型,或许可以在只增加少量延迟的情况下,有效处理 1,000 万或 2,000 万 token。这是推论:论文没有展示这种集成,也没有证明这些模型的端到端精度、延迟或总计算成本。
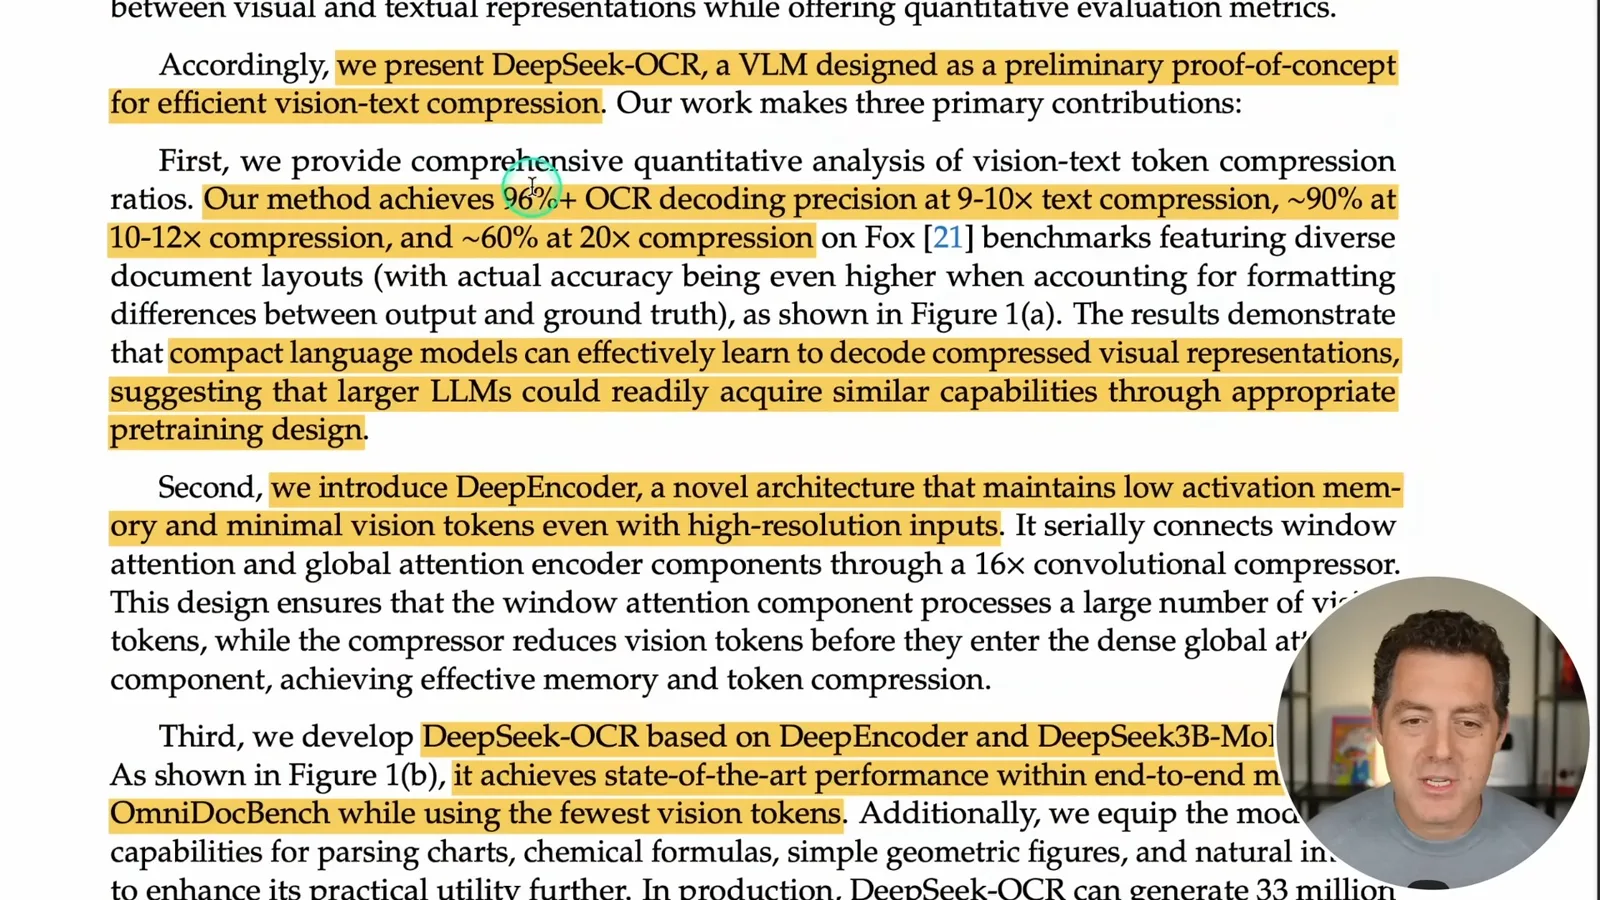
作者报告,约 9 至 10 倍压缩时 OCR 解码精度超过 96%,10 至 12 倍时约为 90%,接近 20 倍时约为 60%。压缩实验使用了 Fox 基准中的 100 页英文文档,每页包含 600 至 1,300 个文本 token,图像被缩放至 512 或 640 像素。这些数字只适用于该数据集、分词器、模型和指标,也表明更高压缩可能丢失信息。
视频包含 Dell Technologies 赞助的环节,介绍配备 NVIDIA RTX Pro Blackwell 硬件、用于本地 AI 工作负载的 Dell Pro Max 笔记本。论文的压缩结果不依赖这一赞助,视频描述的设备规格和产品可用性也属于历史信息。
外界反应与训练数据
Berman 讨论 Karpathy 的图像输入设想和另一个推测性的压缩例子,最后介绍作者对训练数据的描述。
Andrej Karpathy 对这款 OCR 模型作出了积极回应,并提出一个更广泛的问题:把文本渲染为图像,能否为语言模型提供更好的输入?他提出的潜在优点包括更紧凑的表示、在同一信息流中包含格式和图像、双向输入处理,以及输入端更少依赖文本分词器。这些是研究设想和可能的权衡,并非 OCR 实验证实的结果。
分词器将文本转换成模型可以处理的单位;每个词对应的 token 数会随文本和分词器变化。Karpathy 还提到,他想尝试制作使用图像输入的 NanoChat 版本。我认为这种可能性令人兴奋,但视觉处理也有自身的计算成本和压缩错误,因此仅凭 token 序列更短,不能证明端到端速度更快。
我还提到 Brian Roemmele 将一整部百科全书压缩进单张高分辨率图像的设想。这只是一个说明性的说法,论文没有通过实验展示对整部百科全书的忠实重建或检索。分辨率、布局以及压缩时丢失的信息都会产生影响。
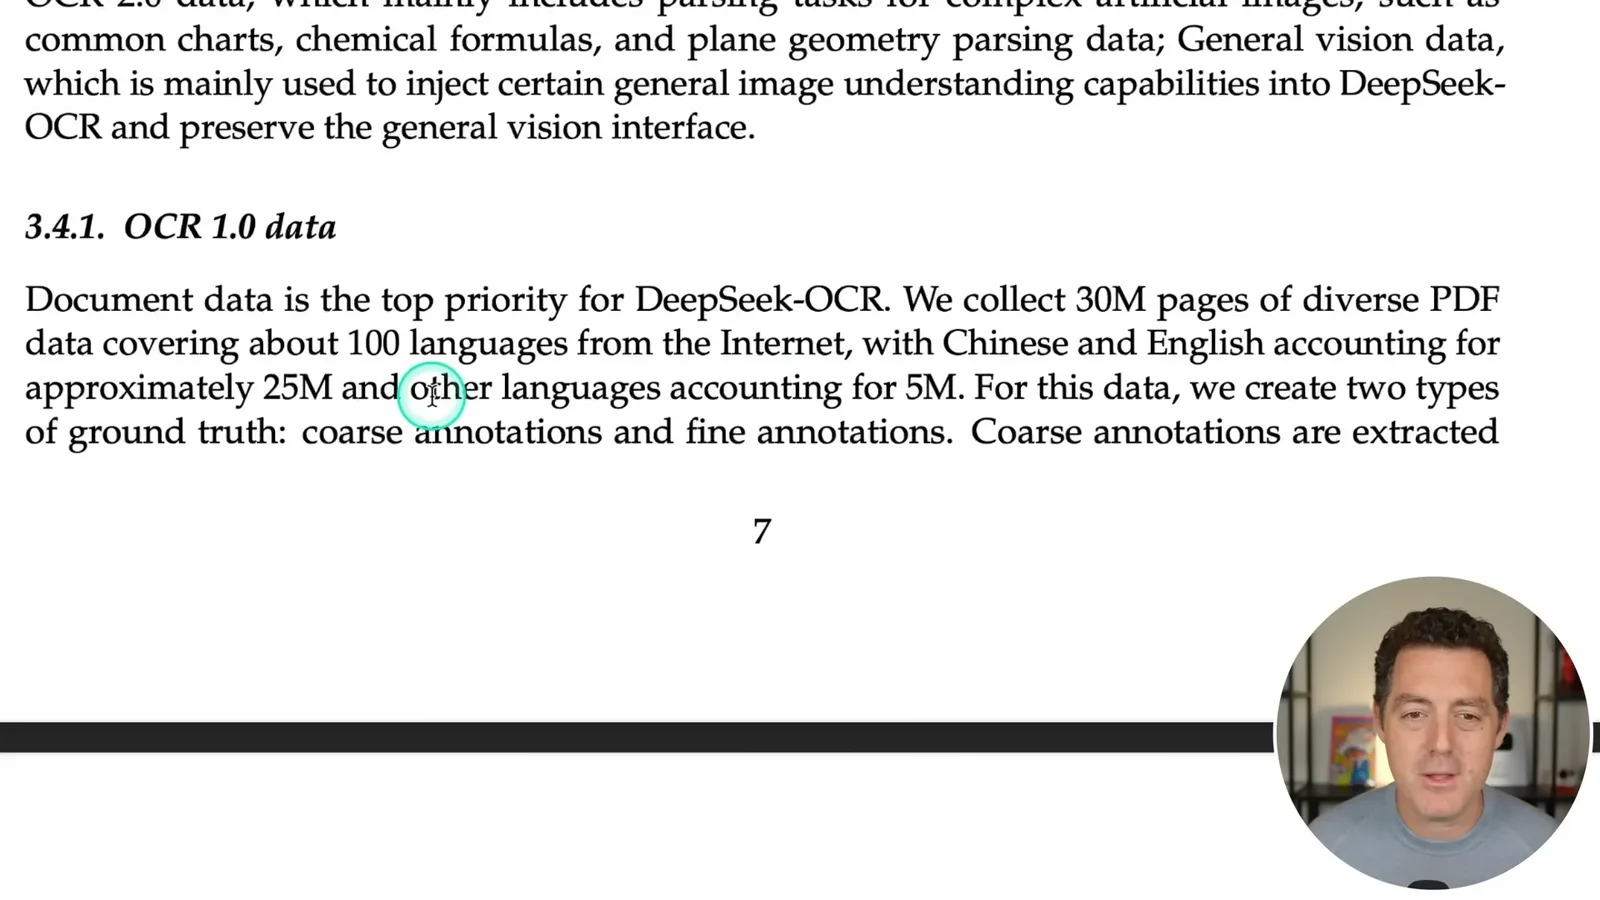
关于训练数据,作者表示他们收集了覆盖约 100 种语言的 3,000 万页 PDF:其中约 2,500 万页为中文和英文,500 万页为其他语言。论文展示了文档图像及其布局标注。我很期待更高效的文档处理,但长上下文的实际应用仍需要直接测试。
同频道的其他文章
 34:21EN → 简体中文
 Matthew Berman· 2026年10月27日Matthew Berman 解读 Anthropic 的上市文件、AI 增长与治理Matthew Berman, Sam Altman · Forward Future主持人审视 S-1 中的财务指标、算力战略和投票结构,并质疑 AI 快速发展与安全之间的张力。
 0:26EN → 简体中文Matthew Berman· 2026年10月25日Sam Altman 谈 AI 世界中的人类价值与问题解决Sam Altman · OpenAI在一段简短的访谈摘录中,Altman 思考解决难题的乐趣,以及人在解读结果时的作用。
 0:36EN → 简体中文Matthew Berman· 2026年10月25日Kimi K3.1 与魔方求解演示Matthew Berman · Forward FutureMatthew Berman 展示一个被打乱的虚拟魔方如何复原,并对 Kimi K3.1 的测试给予积极评价。
 0:21EN → 简体中文Matthew Berman· 2026年10月24日AI 生成的 Kimi 基准图表使用了虚构分数Matthew Berman · Forward FutureMatthew Berman 要求生成一张 Kimi K3.1 Pro 基准图表,随后发现图中的数字只是示意性占位值。
 25:50EN → 简体中文Matthew Berman· 2026年10月24日Kimi K3.1 Pro 实测:3D 演示出色,表现不一,价格有竞争力Matthew Berman · Forward FutureMatthew Berman 测试这款开放权重模型的编程、3D 渲染和视觉讲解能力,并比较基准成绩与价格。
 32:20EN → 简体中文Matthew Berman· 2026年10月23日本地 AI 究竟适合谁?成本、取舍与混合模式的未来Matthew Berman · Forward FutureMatthew Berman 权衡数据控制和自主权,与硬件成本、设置复杂度及推理速度之间的关系。