30 秒看懂
Nathan Lambert 推导策略梯度估计,并将强化学习概念映射到语言模型。他比较 REINFORCE、PPO 和 GRPO,解释基线、裁剪、价值函数以及面向稳定性的新变体。
- 1语言模型作为策略下一 token 是动作,提示词和先前 token 构成状态。
- 2对数导数恒等式它让期望回报的梯度可以从采样轨迹中估计。
- 3基线依赖状态但不依赖动作的基线可以降低方差。
- 4PPO 裁剪保守的代理目标限制概率比值变化过大时继续改善目标。
- 5组相对优势GRPO 比较同一提示的多个回答,而不是训练价值模型。
要点建议
- 策略梯度用动作质量指标对动作对数概率的梯度加权。
- 与动作无关的基线可以降低方差,而不改变期望梯度。
- PPO 使用裁剪并通常借助学习得到的价值函数,使样本复用更可行。
- GRPO 从一组回答中估计优势,无需单独的 critic。
- 旧策略与参考策略承担不同作用。
按章节阅读整理后的全文
语言模型的强化学习
Lambert 介绍策略、参考模型和奖励模型,并将语言生成映射到强化学习回合。
本讲介绍语言模型强化学习中的策略梯度算法,从基础定理讲到 REINFORCE、PPO 和新变体。下一讲将关注实现。Lambert 将强化学习放在包括指令微调和奖励建模的更大后训练流水线中。
简化的 RLHF 设置包括可训练策略、冻结的参考模型和奖励模型。策略生成回答,奖励模型评分;基于 KL 的惩罚阻止策略过度偏离参考模型。组合信号驱动策略更新。
Lambert 观察到,原本为智能体开发的策略梯度方法在预训练语言模型上表现出乎意料地好。根据他的经验,在狭窄领域进行强化学习可以改善行为,而不一定破坏广泛能力;原因和边界仍是研究问题。
相同的强化学习核心数学既适用于人类反馈训练,也适用于可验证奖励训练。它们的奖励不同,实际权衡也可能不同,但两种设置都可以使用 PPO 或 GRPO 系列方法。
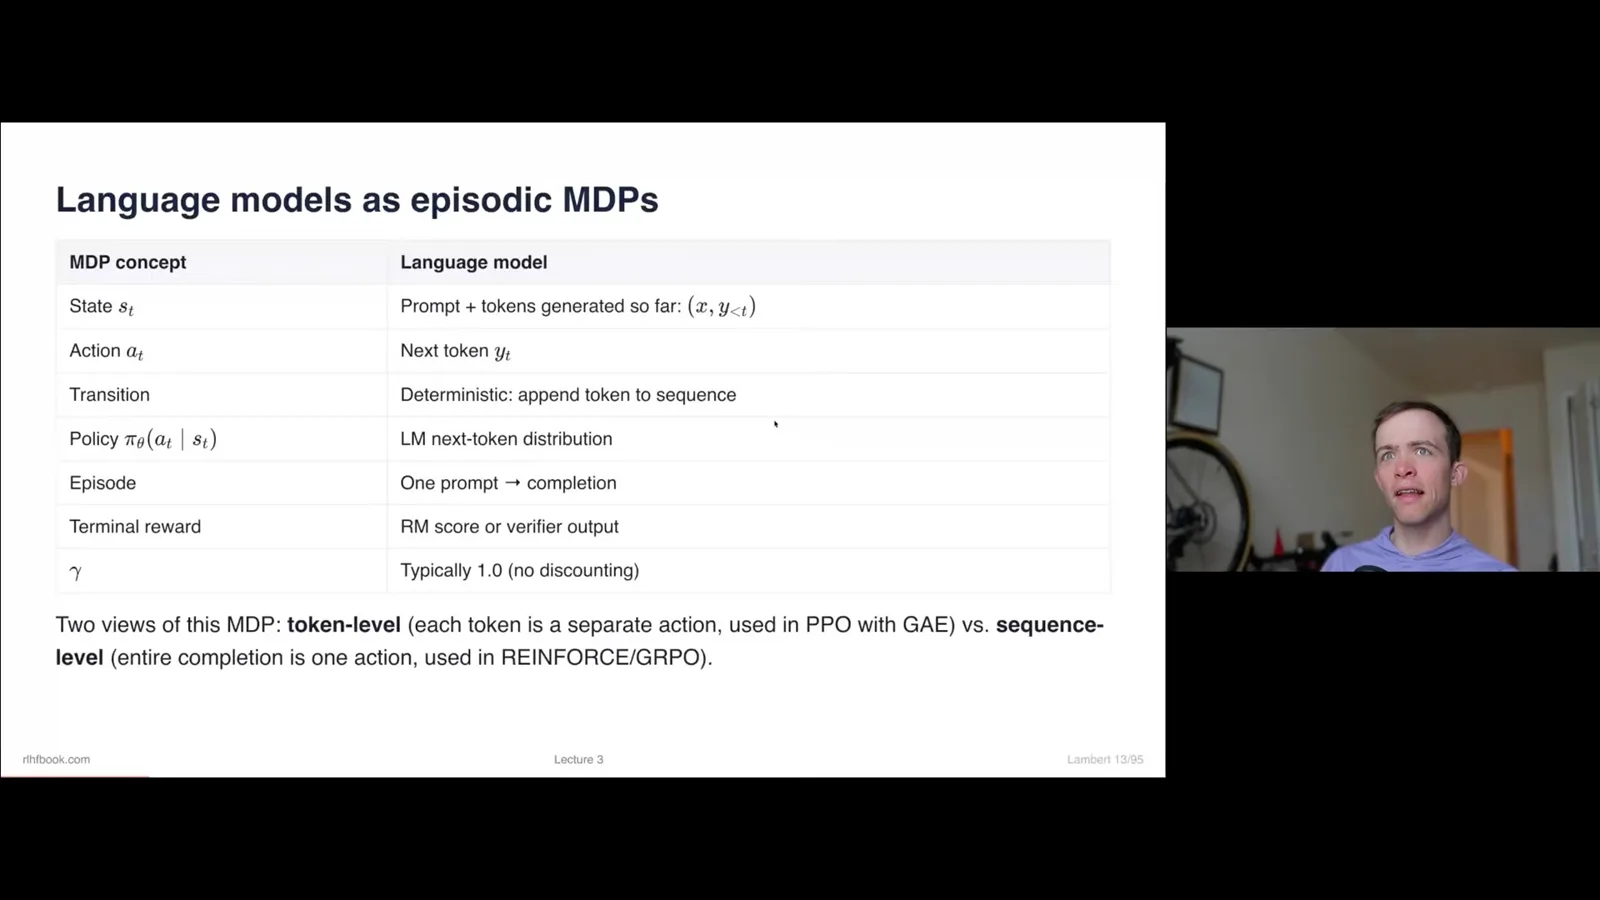
经典强化学习中,智能体在环境中行动。在简单的语言模型回合中,状态是提示词及已生成 token,动作是下一个 token,策略是模型的下一 token 分布。一个回答可以视为具有终止分数的回合。
讲座使用状态和动作记号,语言模型论文则常用提示词 x 和回答 y。轨迹汇集状态与动作序列;单个回答中折扣因子通常设为一,但更复杂的智能体环境可能不同。
策略梯度直觉与推导
价值和优势为采样动作加权。对数导数恒等式将期望奖励转化为基于样本的梯度估计。
目标是在策略下最大化期望累计奖励。我们无法列举所有轨迹,因此采样有限数量的轨迹,估计如何改变模型参数以提高期望回报的梯度。
策略梯度更新将动作对数概率的梯度与表示动作质量的标量结合。直观地说,正优势鼓励一个动作,负优势则抑制它。采样会使估计产生噪声。
价值函数估计从某个状态出发的期望未来回报。动作价值函数同时以状态和动作为条件。优势将某个动作的价值与该状态的基线价值比较。这些相关量提供了为策略更新加权的不同方式。
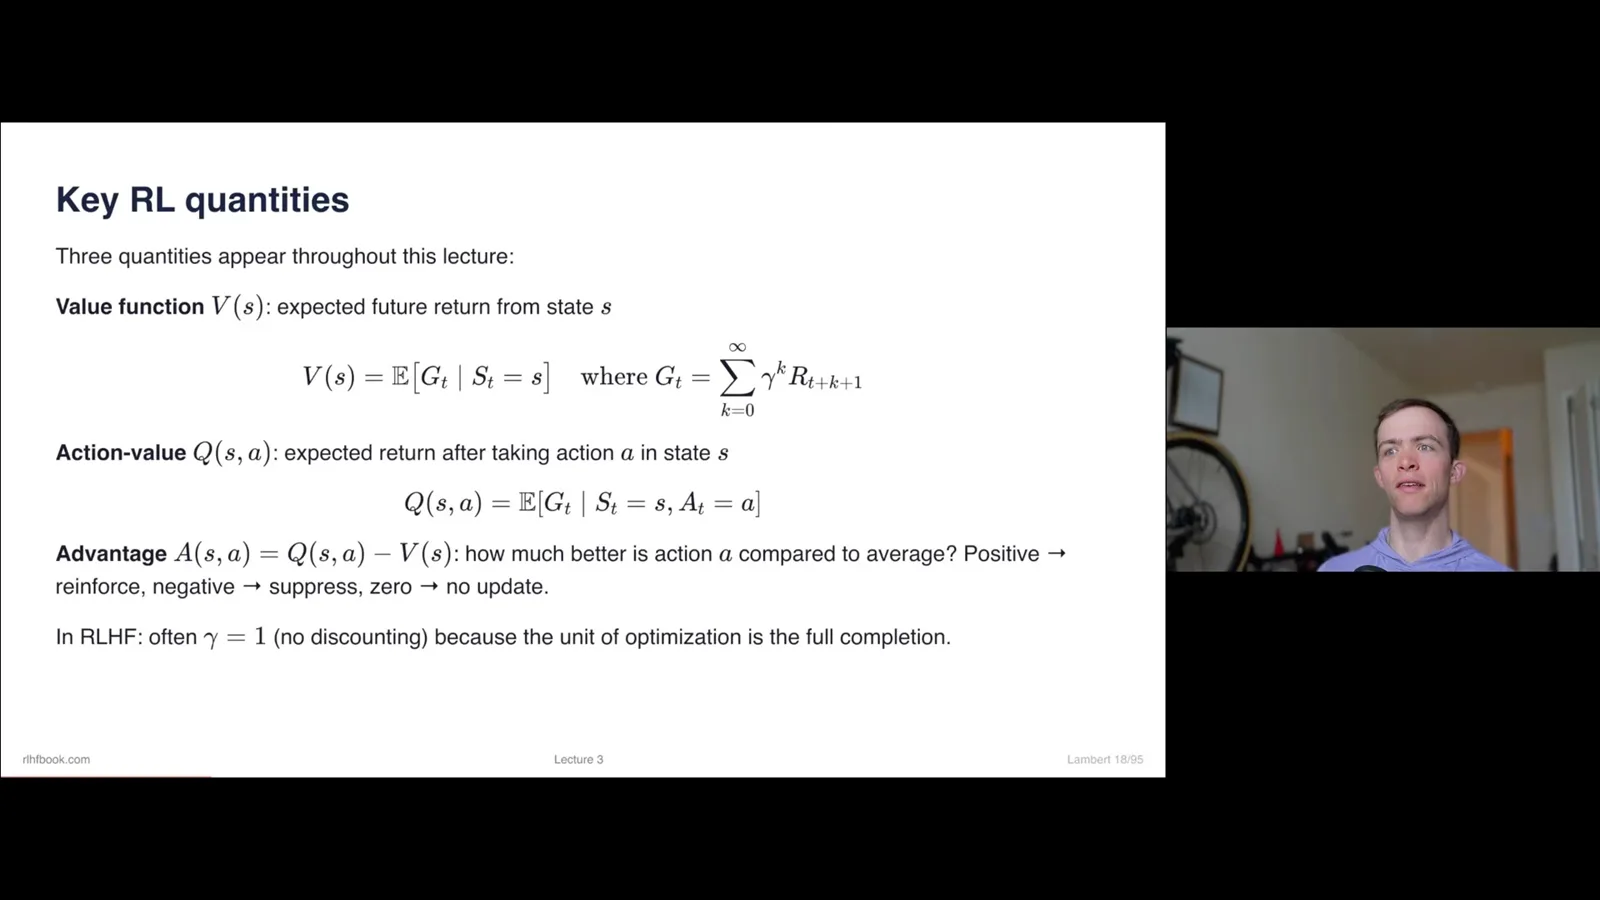
可选的加权信号包括整条轨迹回报、未来回报、基线调整后的回报、动作价值和时序差分估计。它们的偏差、方差和计算成本各不相同,具体取决于估计器和实现。
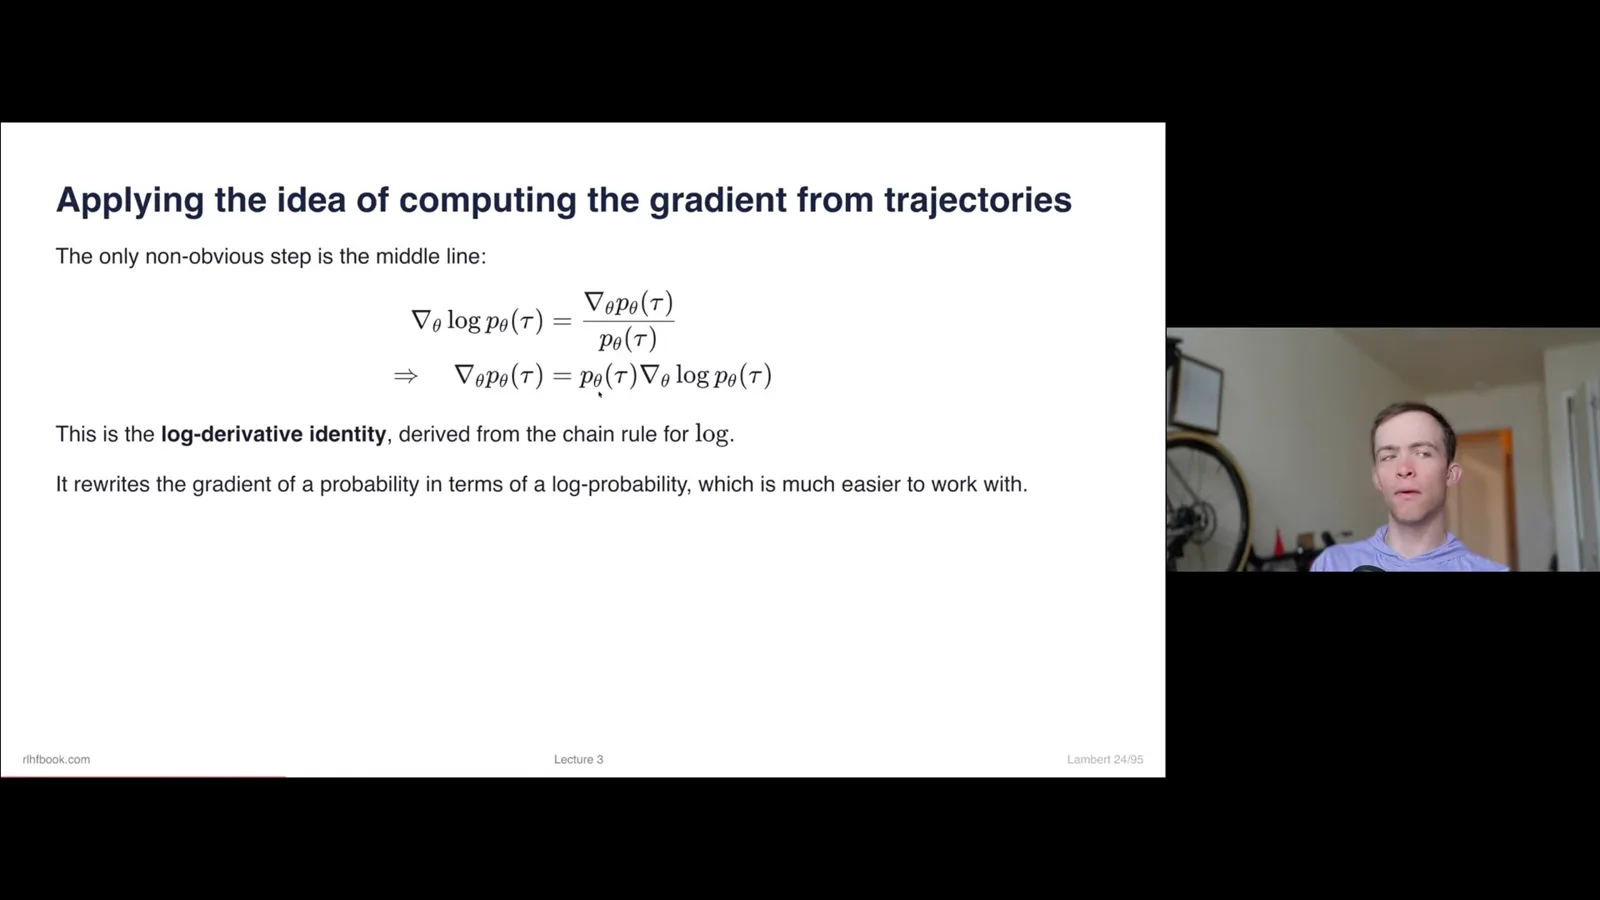
要推导策略梯度,可以把期望奖励写成对轨迹的积分,再对策略参数求导。直接处理轨迹分布的梯度较为困难,因此推导使用对数导数恒等式。
该恒等式将概率的梯度改写为概率乘以其对数的梯度。这样表达式就变成可以用采样轨迹估计的期望。
轨迹概率可以分解为初始状态分布、策略动作概率和环境转移概率。取对数并求导后,不依赖策略参数的项消失,剩下的是各步骤策略对数概率梯度的和。
代码中,对数概率被求和并用类似优势的信号加权;自动微分计算参数梯度。即使代码没有逐项写出定理,梯度仍然存在于反向传播中。
与把整条轨迹回报分配给每个动作不同,后续回报只使用与当前步骤相关的未来奖励。基线可以通过相对于状态相关估计值对回报进行中心化,进一步降低方差。
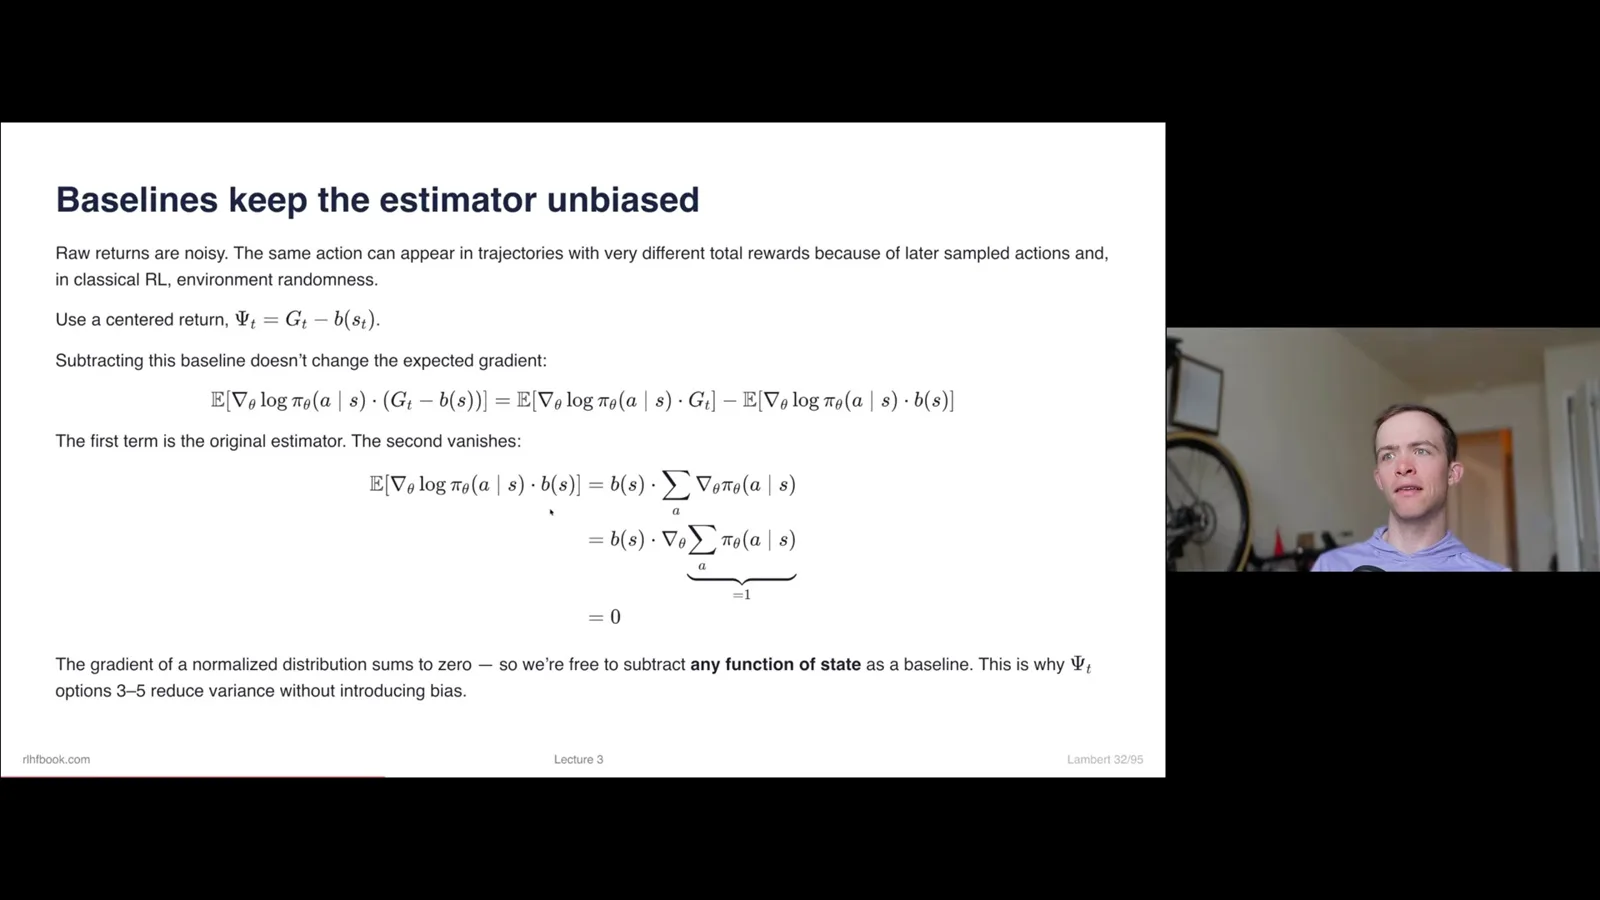
与动作无关的基线不会改变期望策略梯度:在策略下,它的贡献平均为零。因此,在所述假设下,这是一种降低方差而不改变期望的工具。
RLHF 与 REINFORCE
参考策略正则化和留一法基线支持实际策略更新。
在 RLHF 中,冻结的参考模型提供针对初始策略的 KL 正则化信号。PPO 中的旧策略不同:它是生成当前批次数据的策略。混淆批次级旧策略和运行级参考策略会导致实现错误。
REINFORCE 是蒙特卡洛策略梯度算法:采样轨迹、计算回报并更新策略。原始回报可能噪声很大,尤其是批次中不同状态的期望价值差异较大时,因此需要基线。
REINFORCE 留一法针对同一个提示词采样多个回答。对每个回答,其他回答的平均奖励作为基线。这样可以在不训练单独价值模型的情况下获得相对信号。
PPO 与价值估计
裁剪允许复用样本,价值模型和 GAE 用于估计优势。KL 正则化承担独立作用。
PPO 旨在对样本进行多次优化,同时避免策略变化过大。它使用重要性比值,比较当前策略与生成数据的旧策略给同一动作分配的概率。
PPO 代理目标将比值乘以优势,再与裁剪后的版本比较。裁剪范围通常用 epsilon 表示:当更新沿有利方向让比值偏离过远时,目标不再继续改善。
对于正优势,提高动作概率有帮助,直到达到上方裁剪边界。对于负优势,降低动作概率有帮助,直到达到下方边界。优势为零时,该项贡献为零。
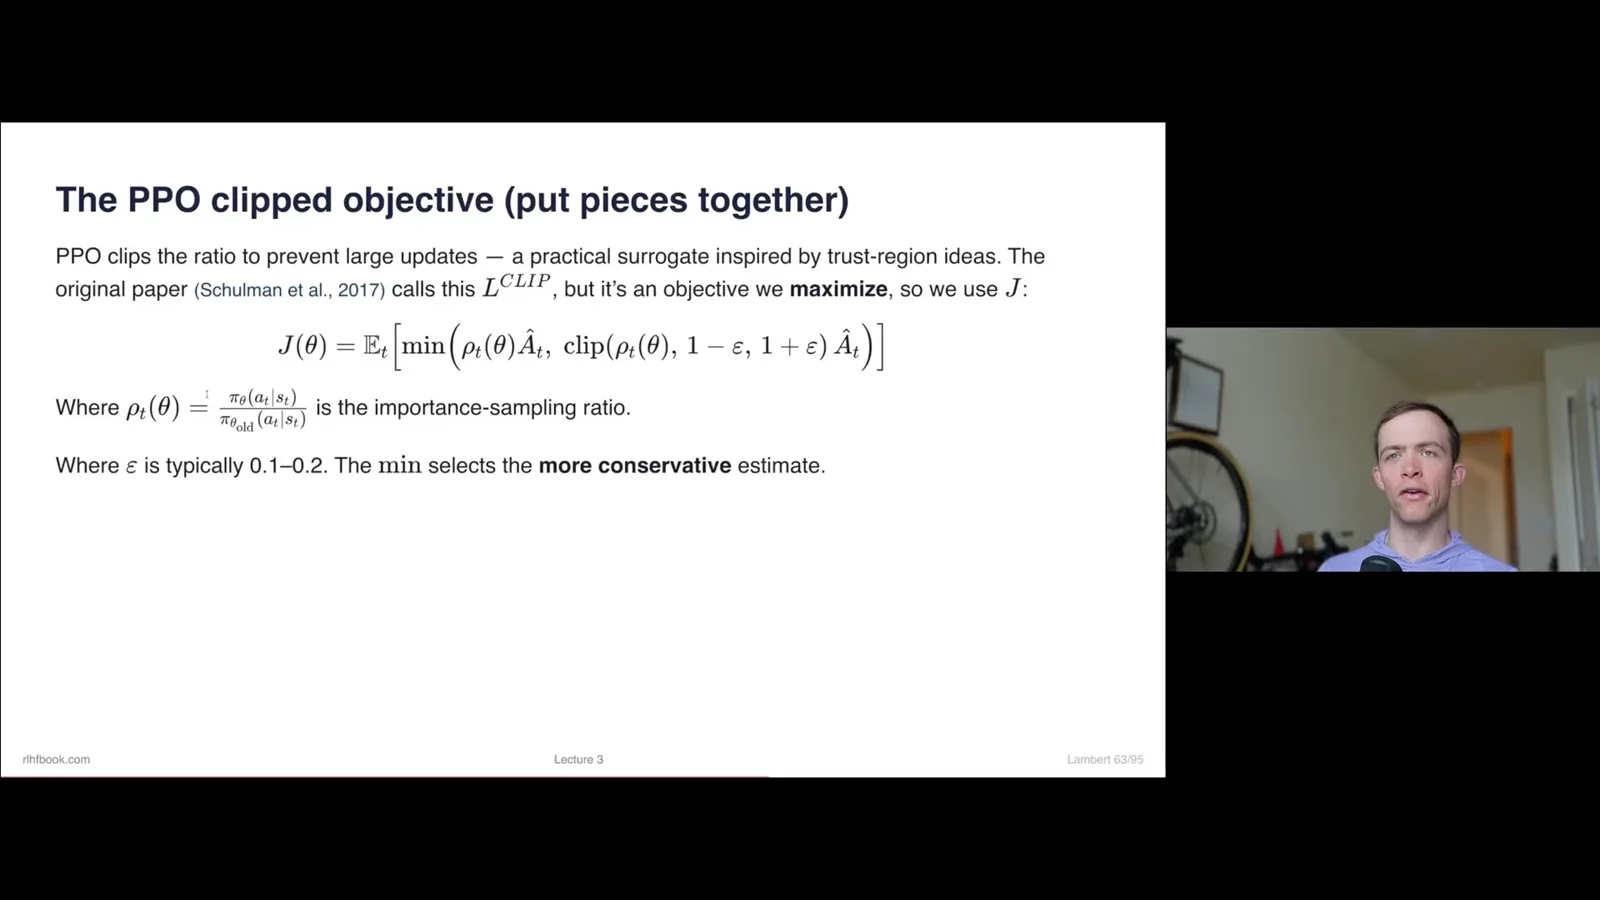
PPO 通常在策略之外训练价值模型。价值估计提供学习得到的基线,也可以进行逐 token 贡献分配,但需要额外计算并增加实现复杂度。
典型 RLHF 实现将奖励模型分数关联到回答末尾,并让 KL 项在各 token 位置产生作用。广义优势估计使用价值模型向前回溯,传播贡献。
时序差分残差结合观察到的奖励、预测的下一状态价值和当前状态价值。一步估计的方差可能低于完整采样回报,但如果价值模型不准确,就可能产生偏差。
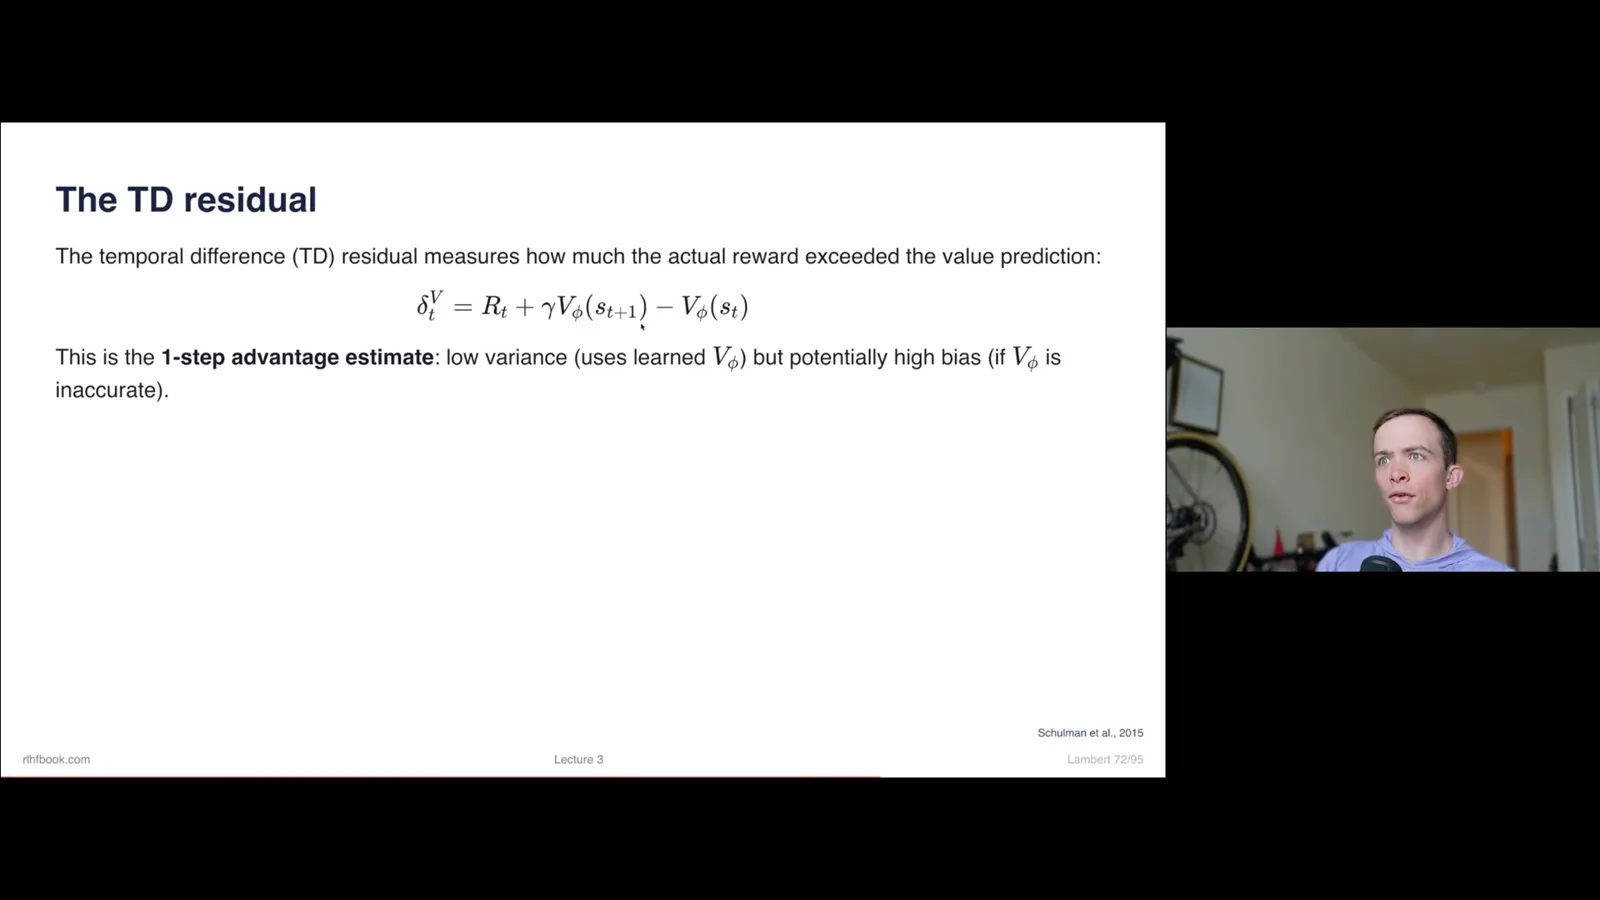
GAE 使用 lambda 组合多步估计,权衡偏差与方差。折扣因子和 lambda 的作用不同:语言模型示例常使用接近一的折扣,而 lambda 可以降低较远残差的权重。
PPO 式 RLHF 可以包含两种不同控制:策略更新内部的裁剪,以及相对于参考模型的 KL 惩罚。概念循环依次生成和评分回答、估计优势、更新策略与价值模型,然后重复。
完整的 PPO RLHF 实现可能在内存中保存策略、参考、奖励和价值四个模型;其中策略与价值模型更新,其他模型固定。共享骨干等工程选择可以改变这一成本。
GRPO 与新变体
组相对优势省去单独的 critic。GSPO 和 CISPO 调整重要性比值或裁剪方式。
GRPO 保留类似 PPO 的裁剪目标,但根据同一提示的一组回答计算优势,而不是使用单独的价值模型。组内均值和标准差提供相对比较。
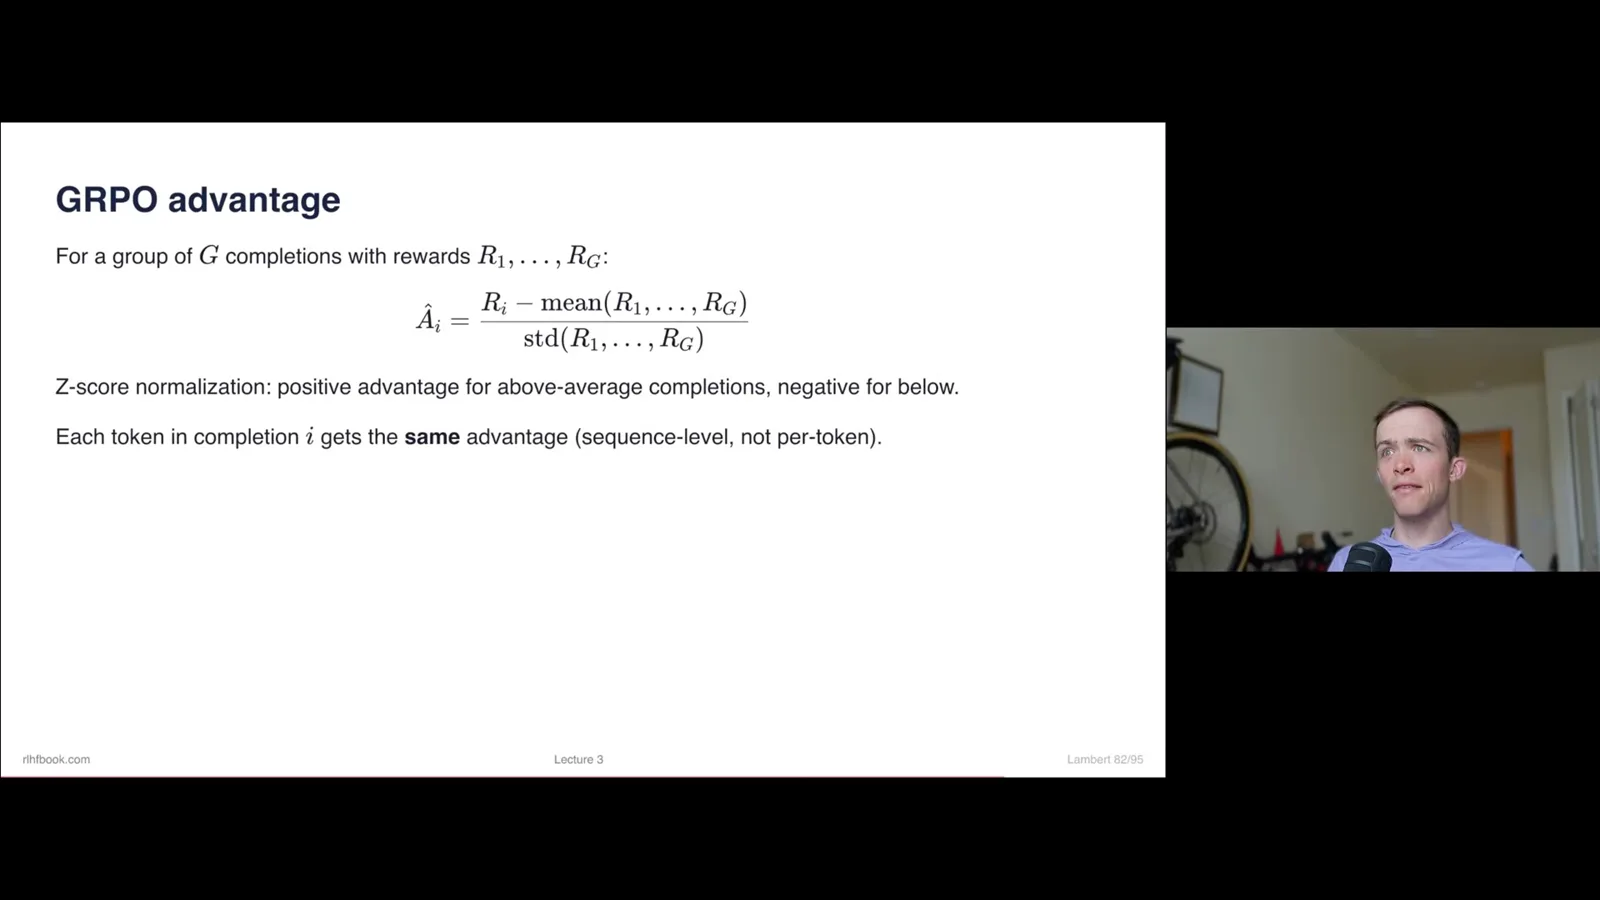
如果一组中的每个回答得到相同奖励,其相对优势为零,不会提供组相对学习信号。当奖励存在差异时,这组样本可以提供比学习 critic 更便宜的替代方式。
GRPO 和 REINFORCE 留一法都使用多个样本,因此密切相关,但基线和损失细节不同。默认 GRPO 形式常在损失中加入逐 token KL 项,而常见 PPO RLHF 实现则用 KL 塑造奖励。
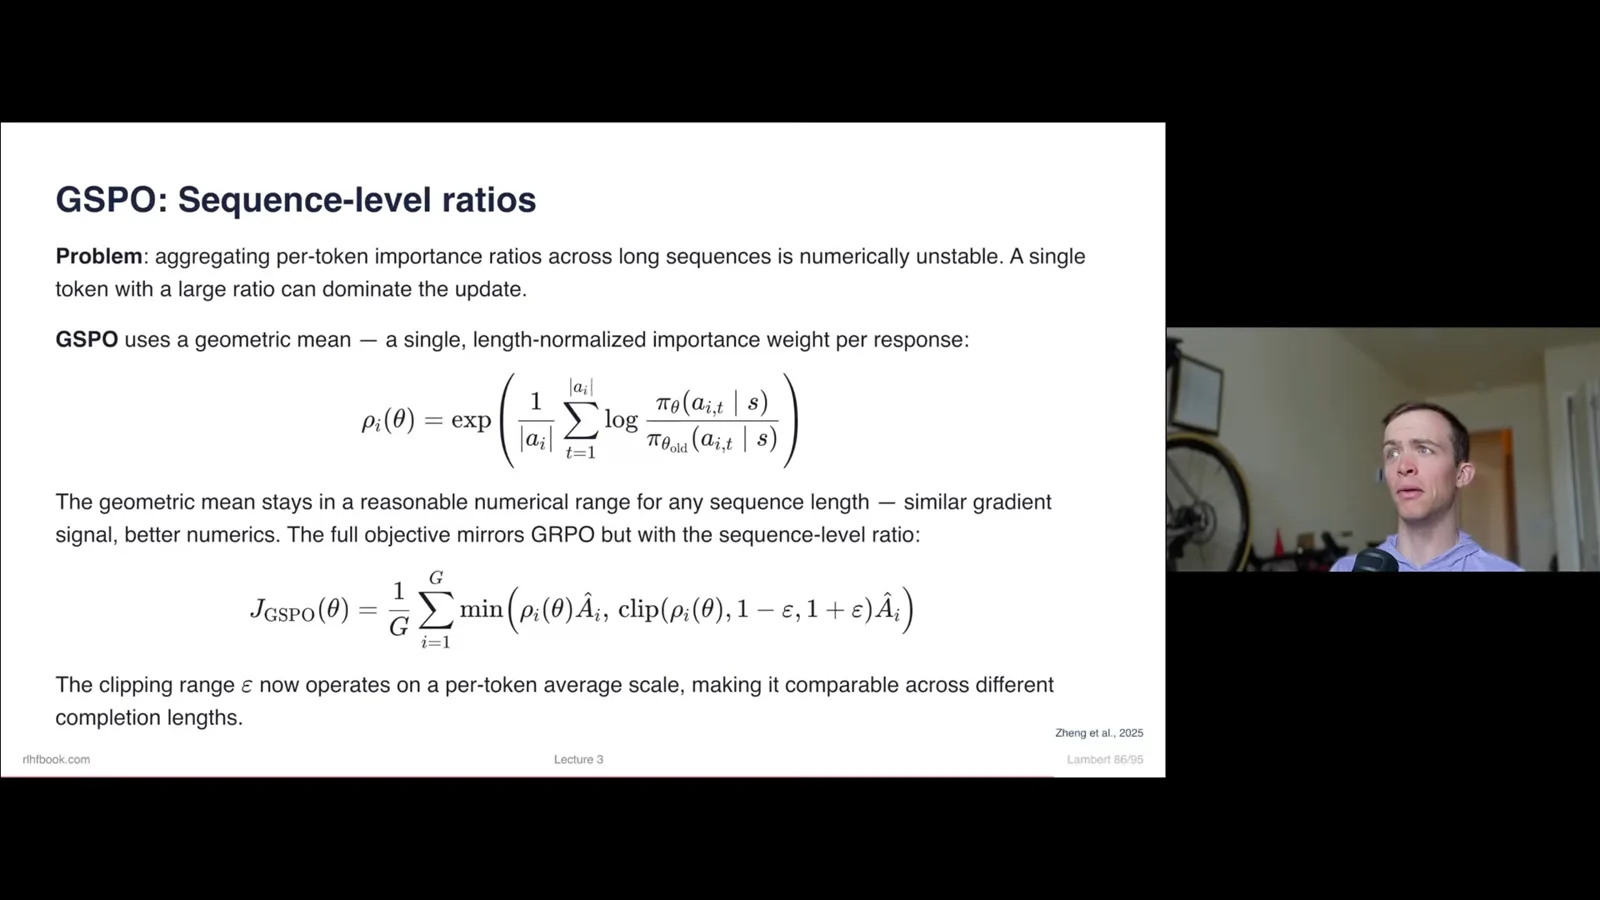
GSPO 将重要性比值改为序列级量,旨在提高稳定性,包括在单个 token 比值可能波动的混合专家模型中。CISPO 改变重要性权重的裁剪方式,同时保留类似 REINFORCE 的梯度项。
核心结论是:不同算法建立在相同的策略梯度思想上,再改变优势估计、更新控制或样本利用方式。Lambert 推荐阅读他的强化学习速查表和代码仓库;下一讲将介绍实现。
同频道的其他文章
 16:48EN → 简体中文
 Nathan Lambert· 2026年11月2日Nathan Lambert:开放模型如何与前沿实验室竞争Nathan Lambert · Allen Institute for AI开放模型的用量正在增长,能力差距也在缩小,但开发者需要可持续的经济模式和价格之外的优势。
 48:04EN → 简体中文Nathan Lambert· 2026年10月26日Nathan Lambert:开放语言模型的历史、竞争与风险Nathan Lambert · Allen Institute for AI从开放权重、研究基础设施和蒸馏,到采用情况与模型开发者面临的选择。
 46:42EN → 简体中文Nathan Lambert· 2026年10月25日Nathan Lambert 与 Florian Brand 谈 Kimi K3.1、网络风险和 AI 智能体Nathan Lambert, Florian Brand · Allen Institute for AIInterconnects 主持人讨论模型评估的分歧、安全漏洞披露潮,以及个人智能体在日常生活中的作用。
 5:42EN → 简体中文Nathan Lambert· 2026年8月12日修格斯为何成了 AI 后训练的吉祥物Nathan Lambert · Allen Institute for AINathan Lambert 追溯了这种怪物从洛夫克拉夫特小说走向语言模型、微调与 RLHF 视觉隐喻的历程。
 32:56EN → 简体中文Nathan Lambert· 2026年8月6日Nathan Lambert:AI 角色训练入门Nathan Lambert · Allen Institute for AI从 constitution、model spec 到人格实验和激活引导,理解后训练如何塑造模型行为。
 32:11EN → 简体中文Nathan Lambert· 2026年8月5日Nathan Lambert:语言模型评估如何演变Nathan Lambert · Allen Institute for AI从少样本提示与 pass@k,到智能体沙箱、分数噪声和基准污染。