30 秒看懂
Theo 讨论 DataCurve 的 DeepSWE 基准及其对 SWE-bench Pro 的批评,同时披露自己对 DataCurve 的投资。他比较任务设计、模型成绩、运行框架和成本,也承认覆盖范围与泛化能力的局限。
- 1已披露的投资关系Theo 是 DeepSWE 背后公司的投资者。
- 2一次基准快照展示的排行榜反映录制时特定模型和配置的结果。
- 3新任务与行为检查DataCurve 介绍了现有仓库中重新编写的任务及手写验证器。
- 4建立任务样本集记录与自己工作相关的失败案例,包括提示词、模型、工具和版本。
- 5阅读局限运行框架、仓库选择和任务覆盖范围都会影响分数的含义。
要点建议
- Theo 是 DeepSWE 背后公司 DataCurve 的投资者。
- 基准结果适用于实际测试的任务、模型和运行框架。
- 新编写的任务与行为验证器旨在减少现有基于 issue 的基准中的一些问题。
- 模型分数、token 用量和成本会随运行框架及工作负载变化。
- 使用自己工作的代表性任务进行评估,并阅读每个基准的局限。
按章节阅读整理后的全文
Theo 为什么质疑编程基准
Theo 批评任务质量和污染问题,并介绍 DeepSWE。他披露了自己对 DataCurve 的投资。
判断哪些模型适合实际开发工作越来越难。我对一些现有编程排行榜持怀疑态度,因为它们的排序与我的经验不符;我也担心任务质量、评分方式和答案泄露。基准分数只能证明模型在特定任务和配置下的表现,不能自动代表所有工作流程的排名。
DataCurve 的 DeepSWE 尝试使用新任务和行为验证,评估模型在现有仓库中完成更长期、更贴近实际工作的能力。我对此很兴奋,也必须披露:我是 DataCurve 的投资者。评价我的赞赏和对结果的解读时,应考虑这一经济关系。
排行榜与审计说法
后录制的补充说明展示初步结果,原始排行榜则提供一份快照。Theo 讨论 DataCurve 对 SWE-bench Pro 的审计。
在一天后录制的补充说明中,我讨论了 Claude Opus 4.8 的初步运行结果。DataCurve 先使用 Claude Code,再使用 mini-swe-agent;据报道,后者约达到 63%。这些结果是初步的,且使用了不同运行框架,不能当作最终结果或差异原因的受控证明。
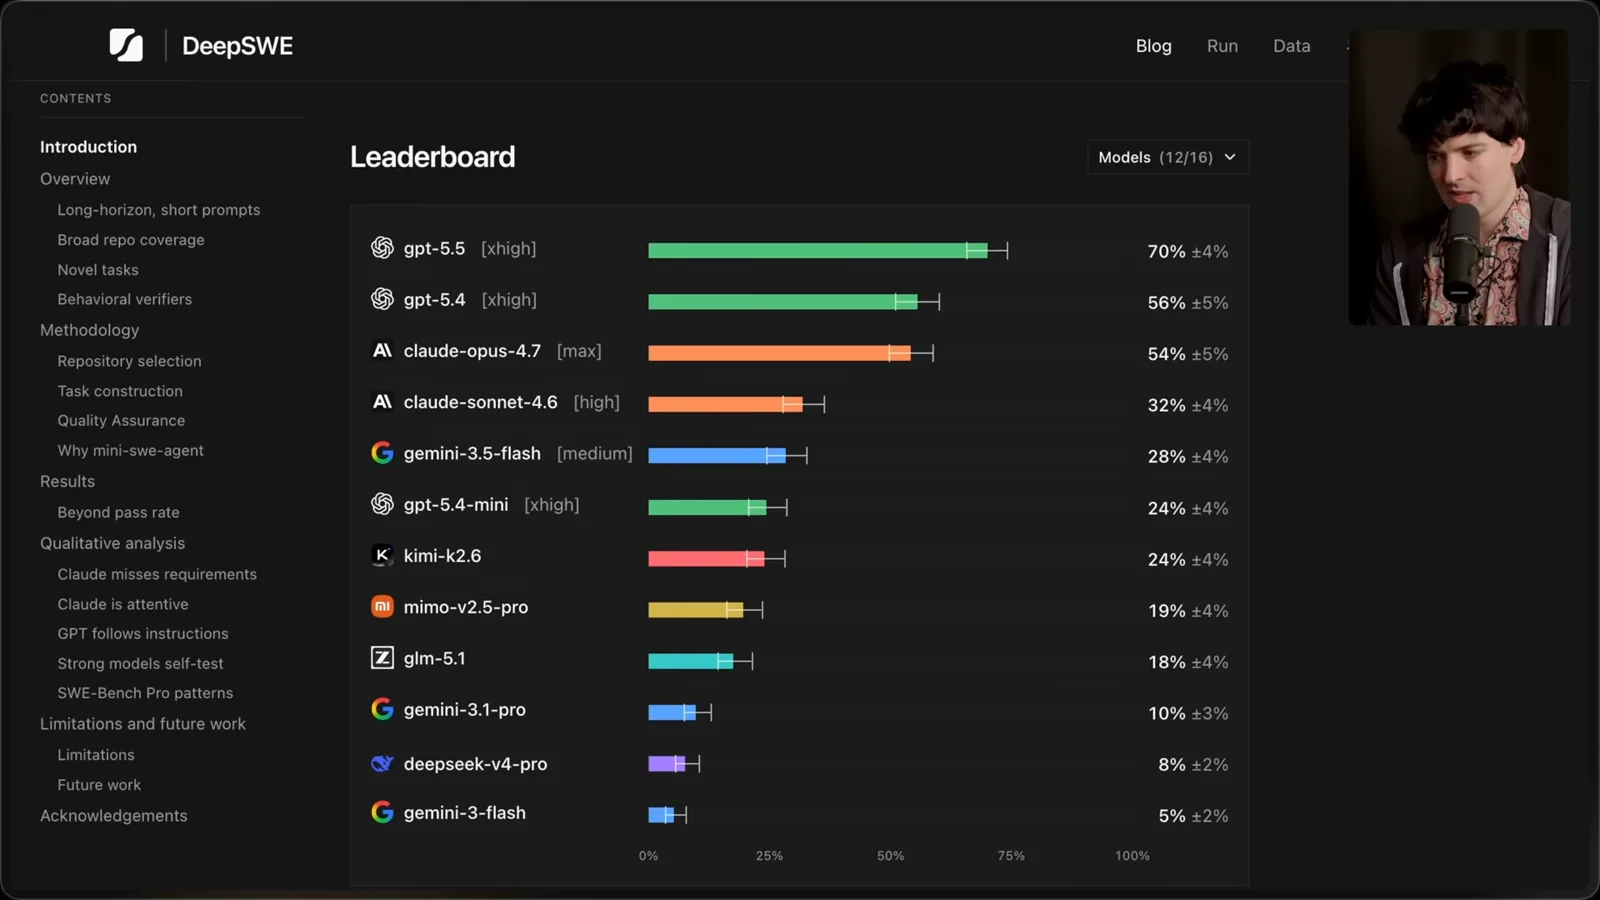
原始录制中展示的排行榜给出 GPT-5.5 70%、GPT-5.4 56%、Claude Opus 4.7 54%、Claude Sonnet 4.6 32%,并标有不确定性范围。这些是当时所示基准和配置下的结果,不能证明所有任务或后续模型版本的通用排名。
DataCurve 向 AI 实验室销售编程数据。我说过是自己向 OpenAI 介绍了这个基准,并否认 OpenAI 为此付费。无论结果是否符合我的经验,公司的商业激励和我的投资关系都使方法透明与独立复现尤其重要。
DataCurve 报告称,在对 SWE-bench Pro 的审计中,其分析器与原有验证器有时存在分歧。公司给出了估计的假阳性、假阴性,以及访问仓库历史的案例。这些是 DataCurve 的审计结论,取决于其标注和审查方法;仅有分歧不能证明哪一个评估器正确。
我觉得新排名更接近自己使用模型的体验,尤其是在仓库导航和实现任务上体现出的差距。但这种一致性也可能带来确认偏差。分数差距更大本身并不能证明某个基准更准确。
任务与验证设计
DeepSWE 使用新编写的任务和行为检查。Theo 讨论提示措辞与智能体自测。
DeepSWE 表示,其任务是从头编写的,而不是取自已有提交或拉取请求。该基准报告覆盖 91 个活跃仓库和五种语言,许多任务使用 TypeScript、Go 和 Python。新任务可以减少直接暴露于现有答案的机会,但不能假定任何基准永远不会受到未来污染。
团队称,提示词比 SWE-bench Pro 更短,而参考解决方案涉及的代码多得多。手写验证器旨在测试可观察行为,而不是要求某一种实现。这种设计有前景,但能否成功仍取决于测试对合理解法和边界情况的覆盖程度。
我强调的一个差异是智能体能否编写和运行自己的测试。在我检查的 SWE-bench 提示词中,任务称测试文件改动已处理,并要求对非测试文件作最小修改,同时建议编写复现脚本。我认为这样的措辞可能抑制添加项目测试,但不能简单概括为完全禁止所有验证。
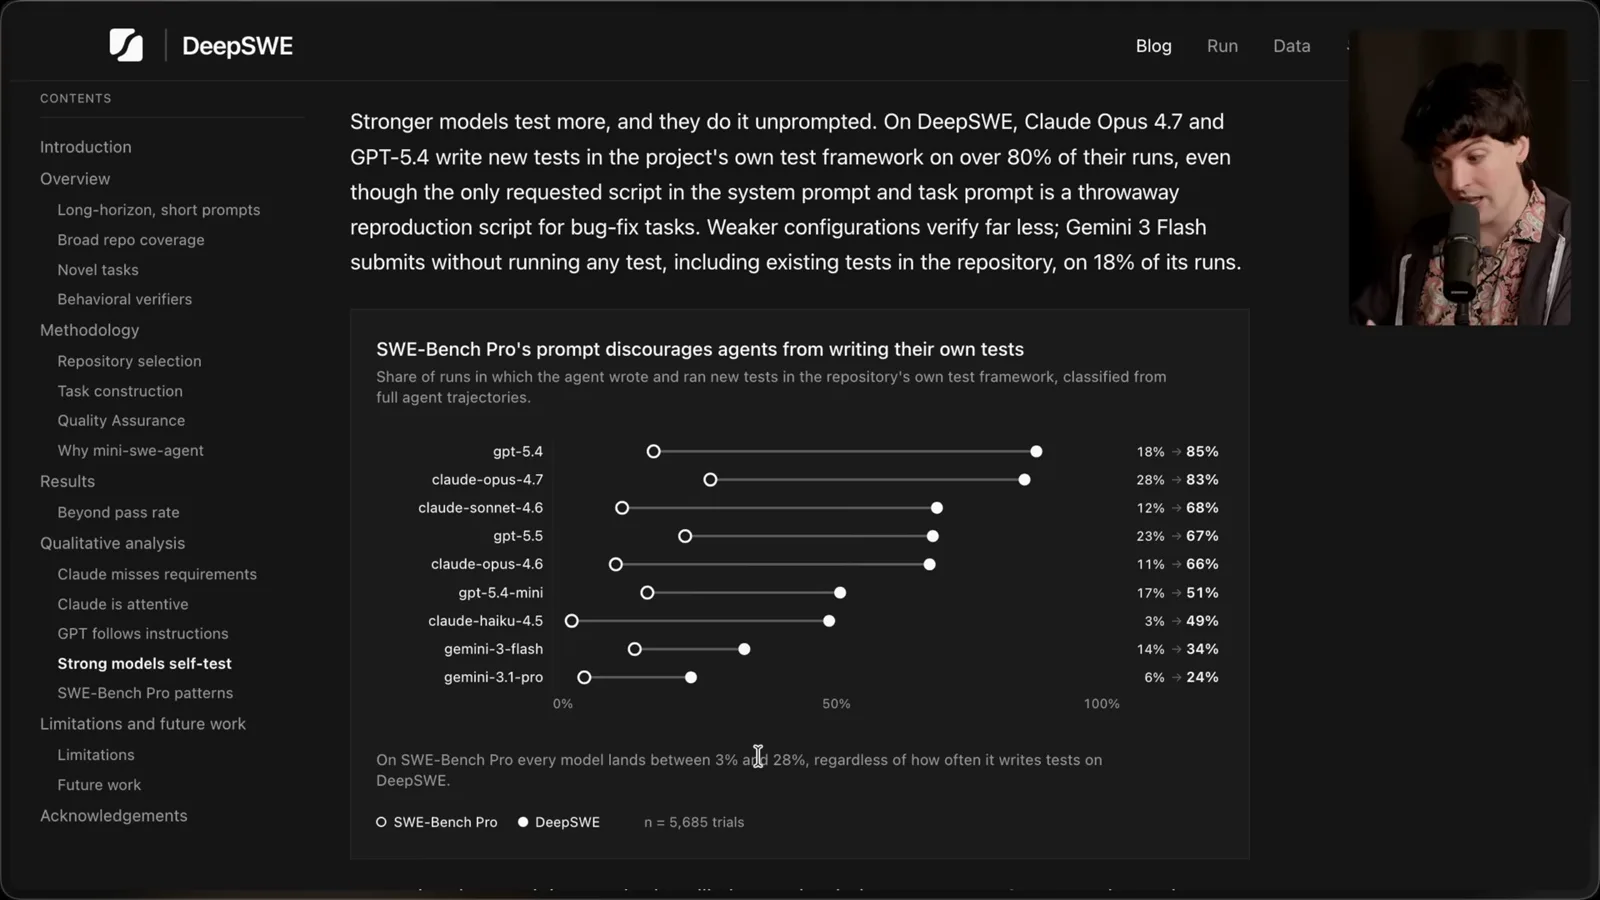
展示的分析称,Claude Opus 4.7 在 SWE-bench Pro 的 28% 运行中编写并运行了新的项目测试,在 DeepSWE 上为 83%;GPT-5.4 则从 18% 到 85%。这些是在不同基准条件下观察到的比例,并非对某一句话单独影响的受控估计。
DeepSWE 的示例聚焦预期行为,并要求智能体寻找相关实现。该基准把它们与更具指导性的 issue 任务作比较,后者可能包含复现步骤或接口细节。我更喜欢前一种方式来评估探索能力,但清晰的任务仍需要足够细节才能公平评分。
示例与个人基准
他介绍仓库任务示例,并建议收集自己工作中的失败案例。
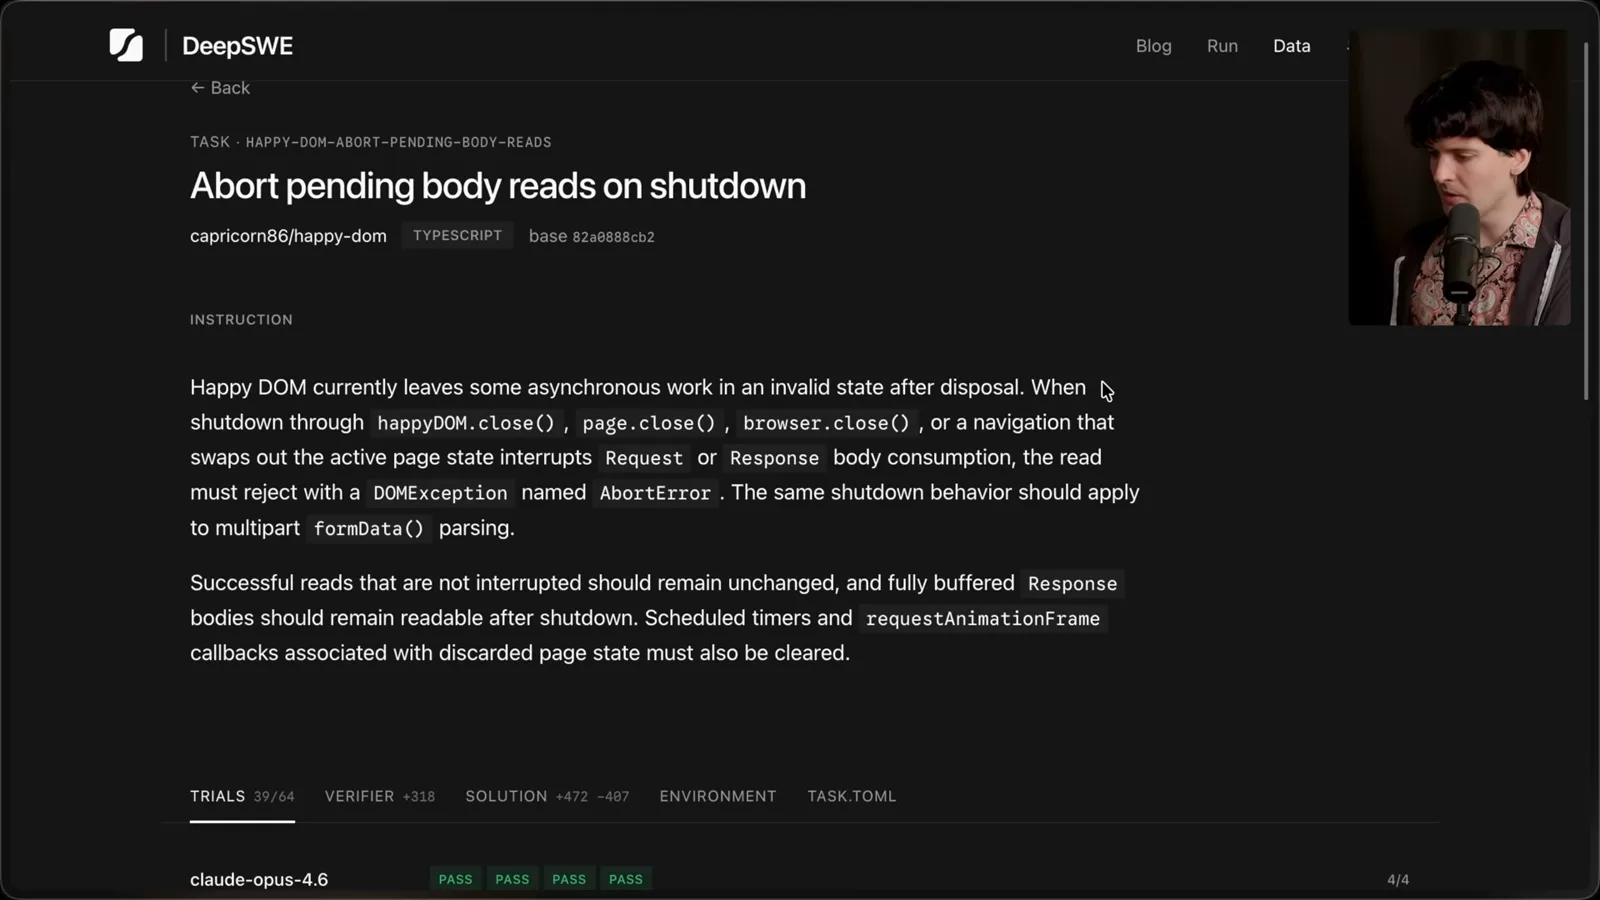
一个示例涉及 Happy DOM:关闭页面或浏览器时,被中断的异步请求或响应读取应正确失败;已完成的读取仍应可用,相关回调也需要清理。我喜欢它指定可观察结果、却不规定每一处代码改动的方式。这个任务只是一个例子,不能全面衡量软件工程能力。
我建议记录智能体失败的任务,包括提示词、模型、工具、仓库和提交哈希。工具变化后,可以在沙箱中重新运行具有代表性的例子,按照自己的需求比较结果。有用的内部基准也需要明确的检查方法,并妥善处理项目数据。
我检查了一个关于 NodeBB 邮箱验证的 SWE-bench Pro 示例,其中包含标题、描述、复现步骤和预期行为。我不喜欢它的格式以及更长的运行框架提示词;这种批评反映的是我对智能体提示方式的偏好,不能证明基于 issue 的任务在其他测量中没有价值。
运行框架提示词描述了一个流程:查找相关代码、复现问题、编辑源文件、重新运行复现并考虑边界情况。我认为这些指令除了衡量解决任务的能力,也可能衡量模型遵循指定流程的能力。它究竟会改变多少结果,需要单独实验。
另一个 DeepSWE 示例要求在 Go 项目中对带类型和无类型的标签进行排序,并明确列出顺序与数字解析要求。它仍然是一份详细规格,但我认为它描述的是期望行为,而不是规定具体实现。不同任务设计会突出不同技能。
运行框架、token 与成本比较
分数既取决于模型,也取决于智能体运行框架。视频比较所展示配置的 token 使用量和成本。
DataCurve 还在部分任务上比较了只暴露 bash 工具的精简 mini-swe-agent 与一些模型官方运行框架。某些配置的观察分数发生了变化。这种比较很有用,但较小的子集和不同框架设计不能证明每个模型受到的帮助或限制完全相同。
视频还比较每次试验的输出 token、时间和成本。展示的图表使用输出 token 中位数和成本中位数,因此不应称为平均值。在当时的特定配置下,GPT-5.5 显示约 4.7 万个输出 token、每次 5.8 美元;Opus 4.7 约为 9.7 万个、16 美元。
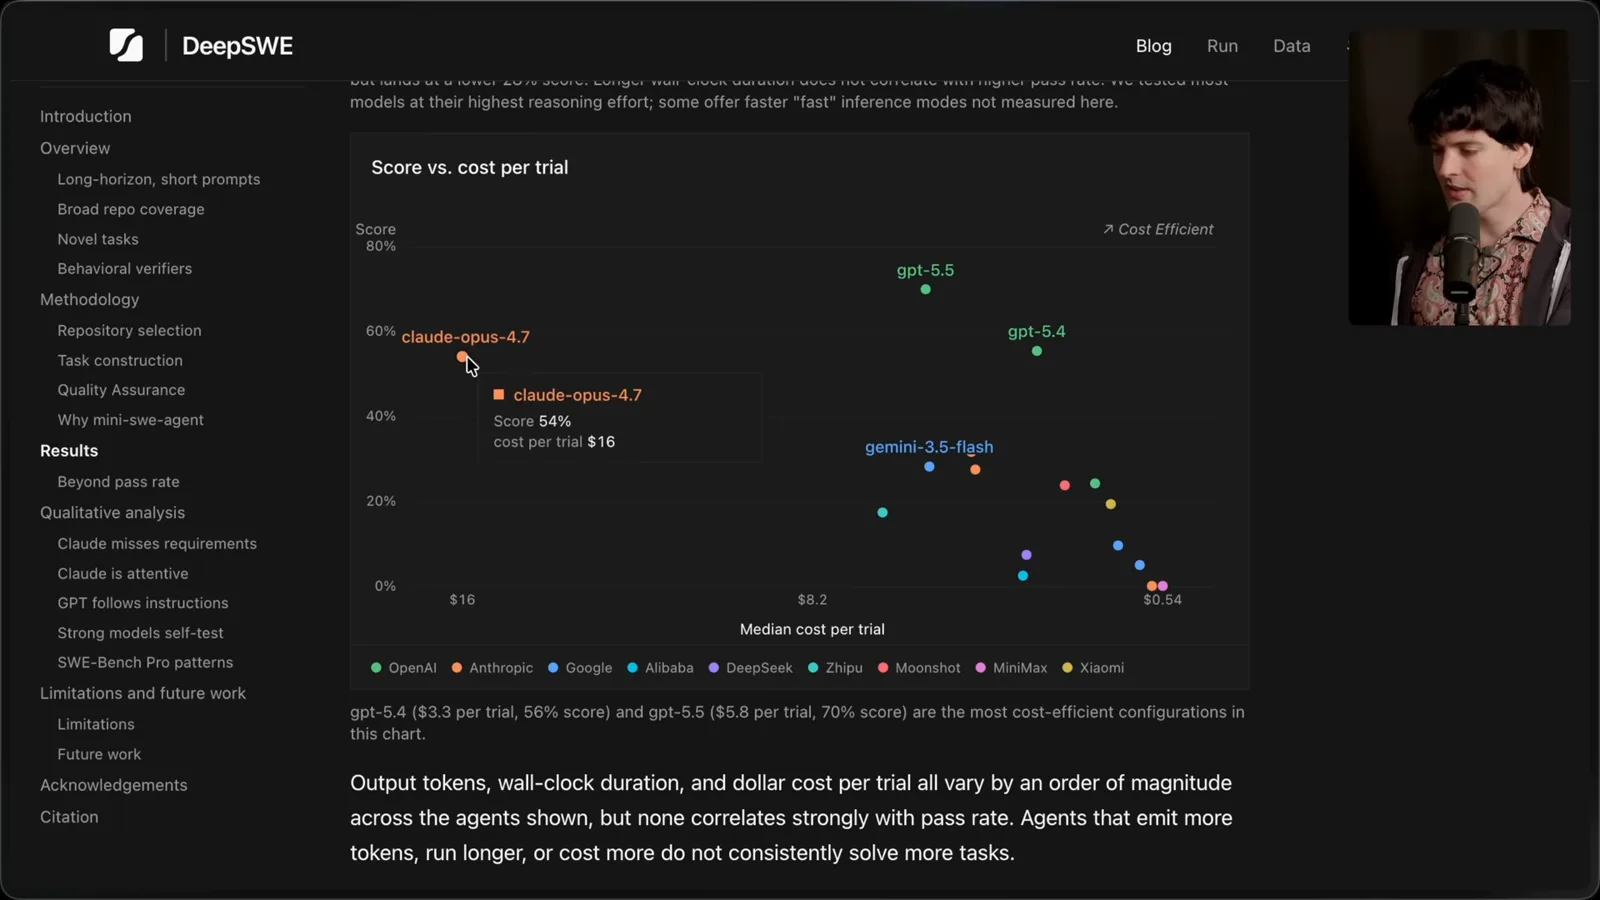
我认为,标称 token 单价并不是完成任务的全部成本:使用更多 token 或失败更频繁的模型会改变经济性。这些图表比较的是特定设置和任务;实际价格、延迟、重试和成功率会因供应商、工作负载和时间而变化。
我查看其他模型,并表示在这个基准中,领先配置与开放权重模型的差距比某些其他排行榜更大。这是所选任务和运行框架下的结果,也符合我的经验,但不能据此断定每个开放权重模型在所有编程工作中的表现。
我提到 SWE-rebench 是另一个评估较新编程任务的尝试,并认为它的整体趋势与这里相似。但不同基准使用不同任务集和方法;少数排名一致,并不能抹去各自测量内容的差异。
局限与后续工作
Theo 审视覆盖范围、运行框架和污染方面的局限,并希望看到更多测试和更难的私有任务。
DeepSWE 也有局限。我希望看到更广泛的官方运行框架测试、更多模型和更难的私有任务集。公开示例有助于透明,也可能使未来训练污染更容易发生。初始分数较高可能最终降低区分度,但何时饱和并不确定。
作者承认,共用的纯 bash 运行框架能隔离部分模型差异,但会牺牲真实工作流的代表性。模型可能习惯不同的编辑工具,开发者也常用 Codex CLI、Claude Code 等界面,而不是 mini-swe-agent。因此主排行榜不能直接描述每种原生工作流程。
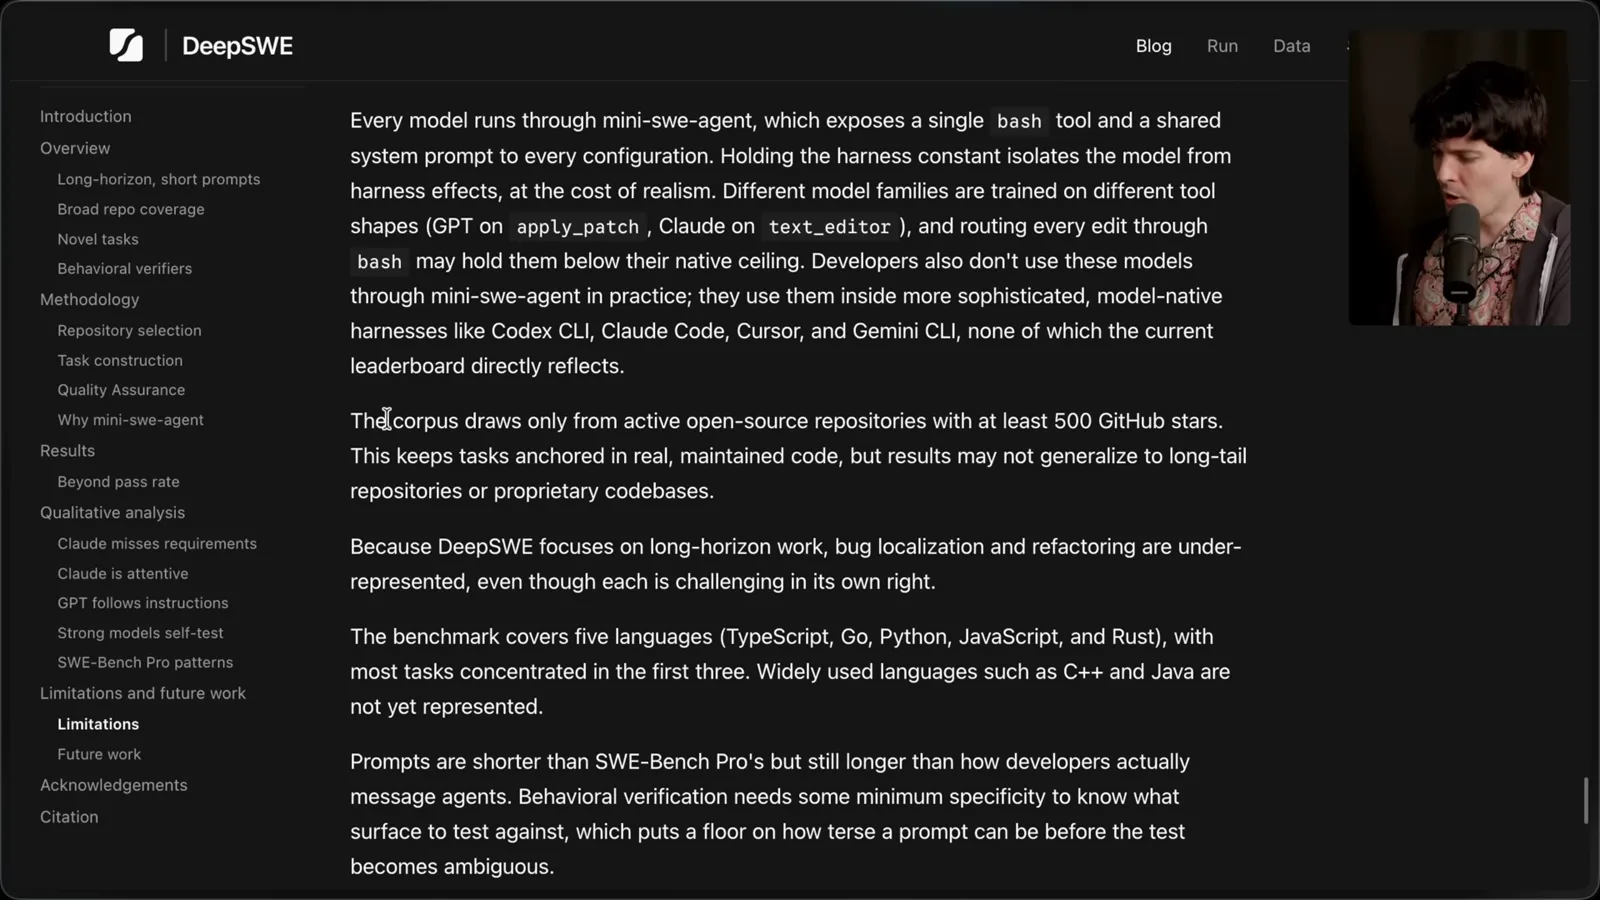
语料来自至少有 500 个 GitHub 星标的活跃开源仓库,因此结果可能无法推广到小型或私有代码库。错误定位和重构的占比较低,五种语言也没有包含 C++ 和 Java。作者还表示,提示词虽然更短,仍需要足够细节才能进行行为验证。
我认可构建任务和检查结果所需的努力,也很高兴多了一个可以研究的基准。我的热情受到投资关系和个人经历的影响。实际启示是检查任务设计、验证方式和运行框架,再用接近自己工作的任务测试模型。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。