30 秒看懂
Theo Browne 评测 GPT-5.6 系列,将公开评测与自己使用编程和计算机操作智能体的体验进行比较。他赞赏 Sol 坚持不懈且高效,同时提醒读者注意输出过多、错误和使用成本,并提出初步的模型选择建议。
- 1理解基准背景OpenAI 的智能体评测和独立编程图表展示了强劲结果,但分数和成本衡量的是特定测试设置。
- 2计算机操作操作真实界面拓展了智能体的能力,同时也带来隐私和操作风险。
- 3输出过多Sol 可能编写过量代码或尝试有问题的变通方法,因此边界和审查很重要。
- 4推理成本在展示的 DeepSWE 快照中,推理强度提升时,成本的增长远快于分数。
要点建议
- Sol 有能力且坚持不懈,但仍需审查它的输出和操作。
- 基准分数与成本取决于评测及其设置。
- Terra 可能适合预算有限的交互式编程;评测者对它的使用经验有限。
- 在 Theo 的工作流程中,Luna 适合低成本的委派或批量任务。
- 更高推理强度可能大幅增加成本,而基准成绩只略有提升。
按章节阅读整理后的全文
初步印象
Theo 介绍模型系列和一项亮眼的编程基准。他区分了基准结果与实际体验。
GPT-5.6 推出了三个版本,我用过之后有很多话想说。基准测试结果很抢眼,但开发者的反应并不一致。我想把数字所展示的情况和实际使用模型的体验分开来看。
我展示的 DeepSWE 图表中,Sol 在 max 档取得约 73% 的成绩,每项任务成本为 8.39 美元;对比的 Fable 测试约为 22 美元。这是特定评测中很亮眼的结果,并不意味着每项任务都有相同成本或排名。
模型和基准测试
他研究模型阵容、智能体评测、成本和工具调用,并比较前端示例。
这一系列以旗舰 Sol、均衡型 Terra 和低成本的 Luna 组成。技能与任务编排方面也有变化,包括面向更复杂智能体工作的 ultra 模式。名称本身并不重要,重要的是为任务选择合适的模型和推理强度。
OpenAI 展示的 Agents' Last Exam 结果中,Sol 在 xhigh 档得到 53.6 分,比图中 Fable 的结果高约 13 分。这张图很亮眼,但它是 OpenAI 展示的评测;基准分数只是特定测量,无法完整描述智能体的表现。
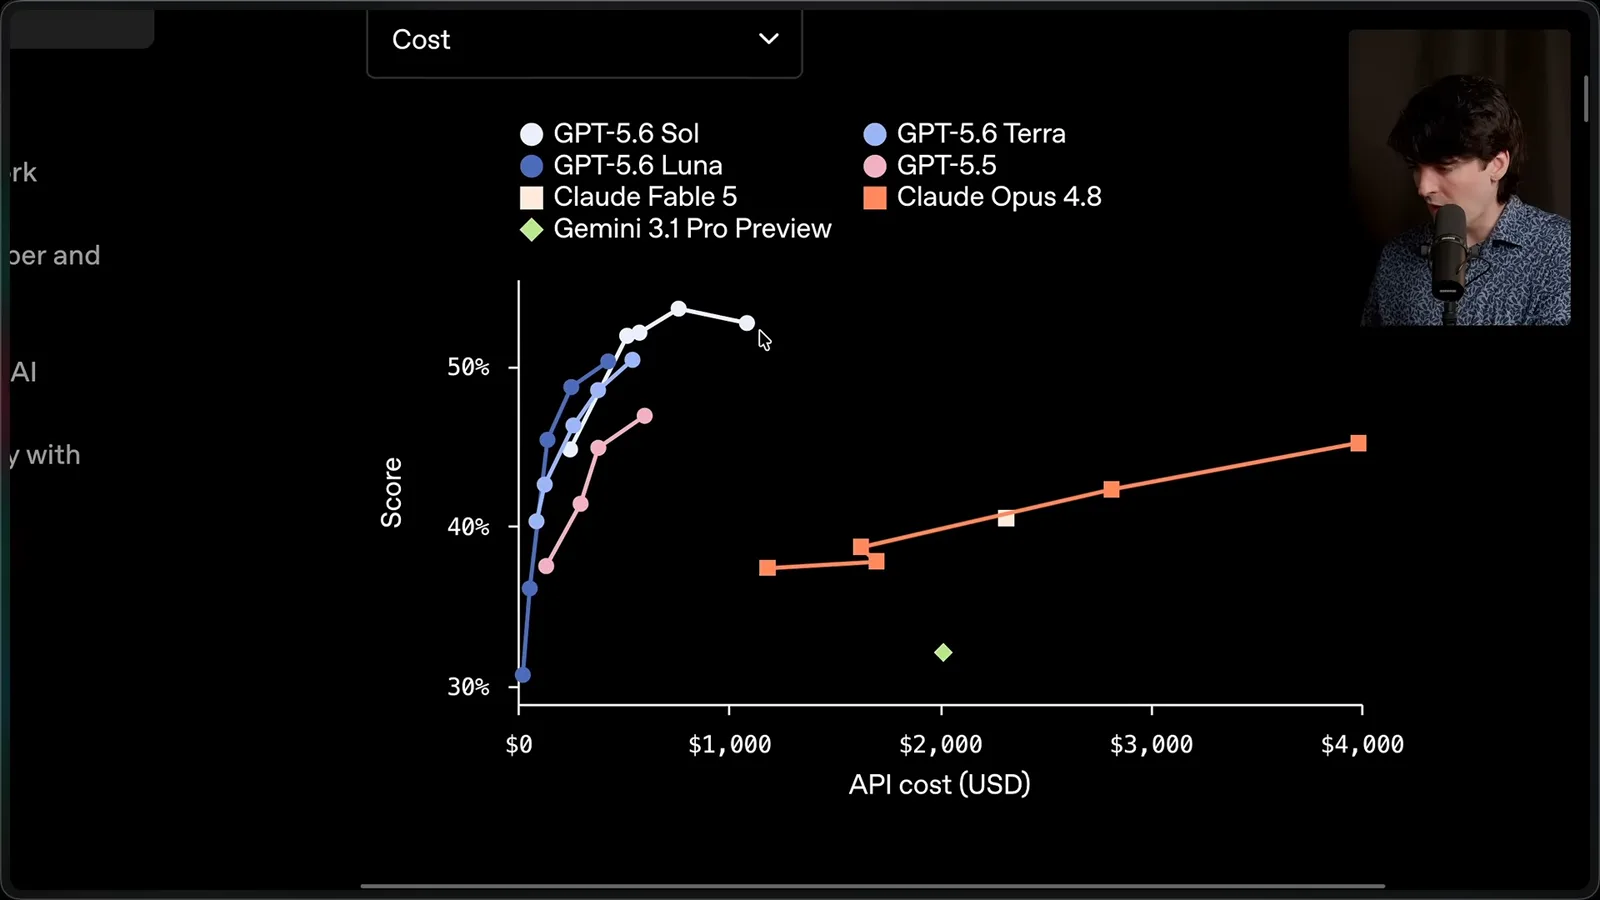
成本图也需要仔细阅读:数字是运行整套评测的费用,不是单次提示的价格。图中 Sol 约为 760 美元、Fable 约 2,300 美元、Opus 约 3,985 美元。我在讲解时纠正了自己的说法,因为柱状图很容易看混。
Artificial Analysis 的编程智能体指数显示 Sol max 为 80 分,Fable 为 77.2 分。这个差距值得关注,但不同基准使用的任务与运行框架不同。分数接近时,也要看成本和方法,别把微小差距当成普遍结论。
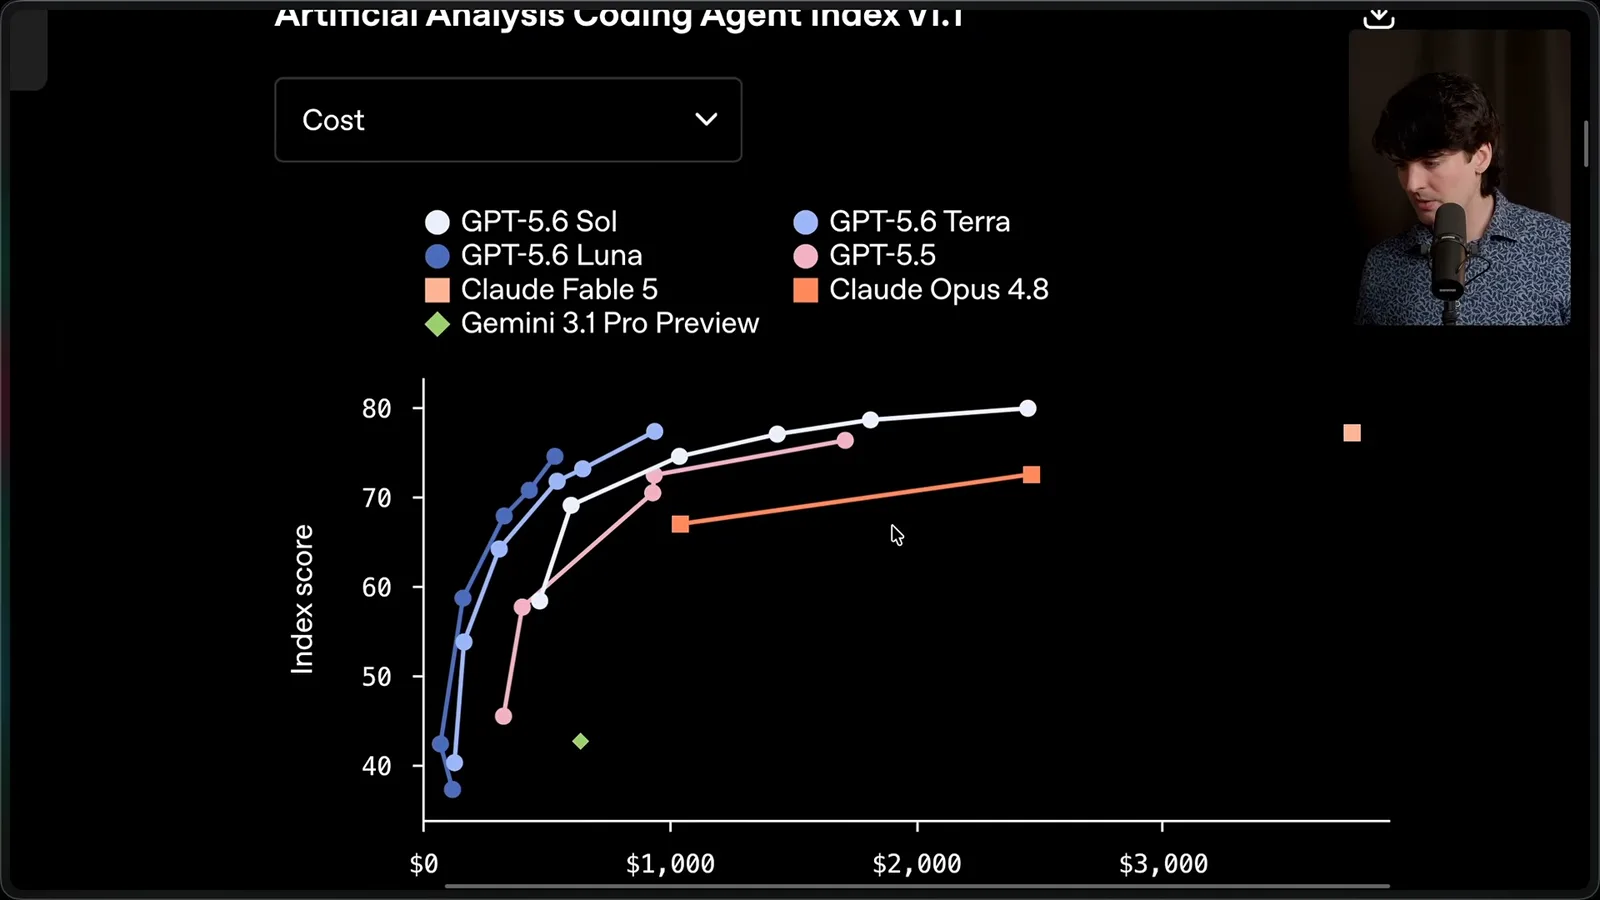
行业对比的分数同样接近,图中的美元数额也是评测费用,而不是每项具体任务的费用。这些图表只是某个时点的快照;设置、工具和基准设计都会影响得分及支出。
一项有用的改进是程序化工具调用:模型可以处理工具的中间输出,而不必把所有细节都塞进最终上下文。这有助于减少长时间运行智能体时积累的噪声。不过,更高的推理档位仍可能消耗多得多,因此高效并不意味着可以无限使用。
根据我的体验,前端表现比 GPT-5.5 更好,但我不会认为默认输出就一定美观。屏幕上的例子会随提示和提供的设计技能而变化。结果好不好,仍然取决于你给智能体的方向以及自己的判断。
有些演示展示了相当复杂的视觉效果,包括三维元素。它们也说明,把精心引导的演示和未经引导的结果直接比较可能产生误导:模型只是工作流程的一部分。
计算机操作、安全与定价
他讨论浏览能力、研究使用量、安全拒绝和当时展示的 API 价格。这些数字的范围不同,需要结合背景理解。
计算机操作是一项重要优势。我一直在 Mac 上测试,操作真实界面的能力让它能够处理单靠编程智能体不容易完成的任务。同时,这也带来隐私和破坏性操作风险,因此访问权限与监督和能力本身同样重要。
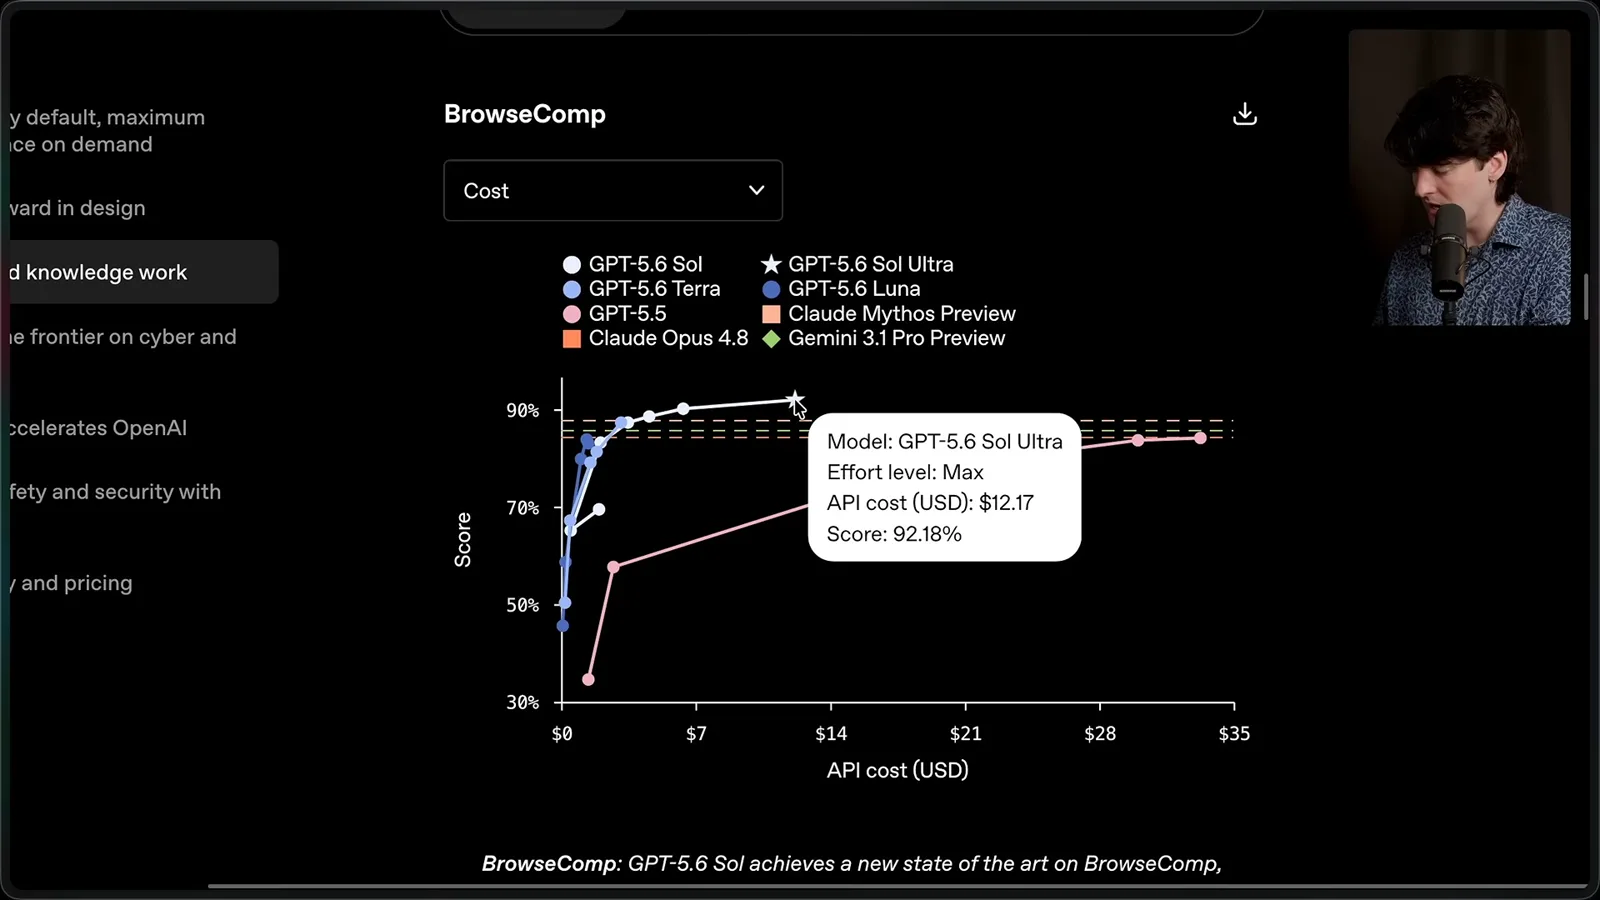
我展示的 BrowseComp 图表中,Sol ultra 达到 92.18%,每项任务成本为 12.17 美元。其他条目并非都有可直接比较的成本数据。这是有关该基准的有用数据点,并不能证明每次浏览任务都会准确或划算。
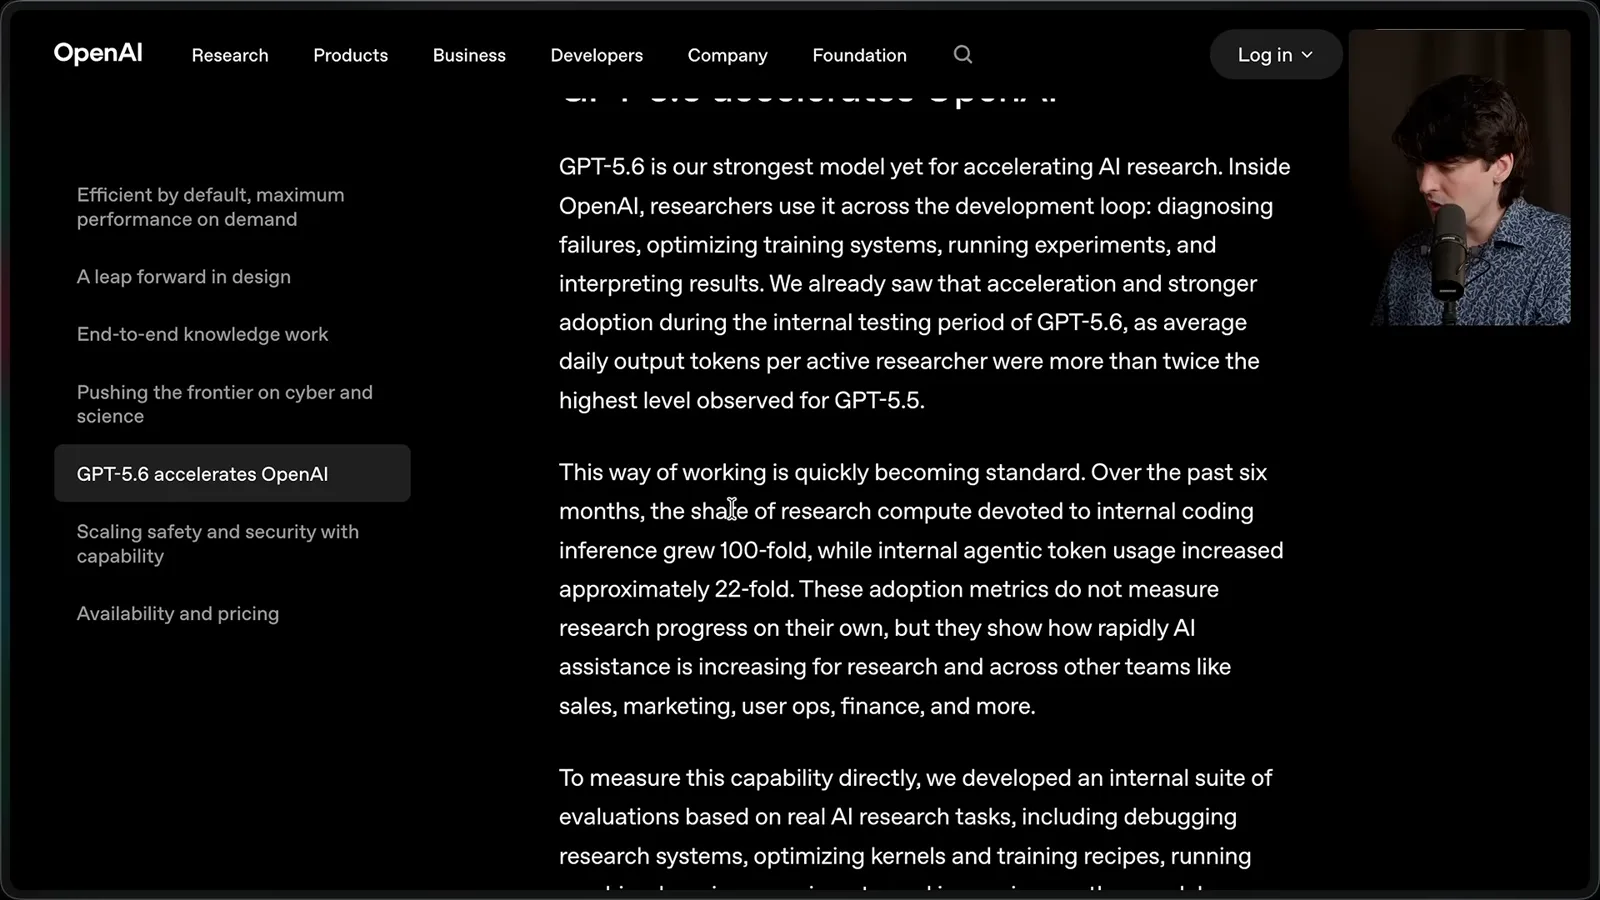
发布材料还展示了网络安全与科学方面的结果。一张内部图表显示,用于研究的算力增长约百倍,智能体 token 使用量增长约 22 倍。这些数字描述的是使用规模,不能直接当作科学进展的衡量。
我遇到过更激进的安全拒绝,其中包括我正在做正常开发的情况。误报会打断有用的工作,尽管安全防护所针对的风险是真实存在的。这是工具改进过程中值得关注的实际权衡。
视频录制时展示的 API 每百万 token 价格分别为:Sol 输入 5 美元、输出 30 美元;Terra 输入 2.50 美元、输出 15 美元;Luna 输入 1 美元、输出 6 美元。缓存和产品可用性也会影响账单。请把这些数字当作当时的快照,选择模型前核对现价。
开发者反馈
其他开发者的体验不一,其中有人称赞模型的坚持。清楚表达意图和人工监督仍然重要。
我关注的开发者报告了不同的体验。有些团队喜欢它持续解决难题的能力,也有人有不同偏好,或对某些行为感到困扰。这些真实工作中的观察很有参考价值,但它们并非受控测试。
Jay 的评测和其他人的反馈反复提到一个特点:模型在先前方法失败时能够持续探索。这种坚持很有价值,但同样的倾向也可能让它在错误方向上花费过多时间或精力。
我也讨论了有关这些模型与底层基础模型关系的说法,但我在这里并没有独立证实。我能评价的是产品中观察到的行为和其他人报告的结果,而这些都存在不确定性。
讨论中一个有用的观点是:人们清楚说明意图、提供相关资料并安排检查输出的方法时,智能体表现会更好。人工审查仍是工作流程的一部分,尤其当任务可能影响真实系统或数据时。
优势与弱点
Theo 列出计算机操作、任务编排和上下文处理方面的进步,也描述了过度产出、危险变通和自信犯错的问题。
我总结的优势首先是坚持不懈。Sol 的前端工作能力比 5.5 更好,计算机操作能力强,而且相对于它能完成的工作很高效。日常使用中它也给人速度快的感觉;厂商承诺的高速服务方案与我亲自测试过的体验是两回事。
它在移动开发和操作系统方面似乎也更好。编排子智能体是一项尤其重要的变化:主智能体可以拆分工作,委派范围更窄的调查,但最终成果仍需要检查。
上下文压缩也有所改善。系统可以总结并保留有用信息,避免长会话被无关上下文填满。我还发现它更善于理解意图,但任何压缩机制都不能保证重要细节永远不会丢失。
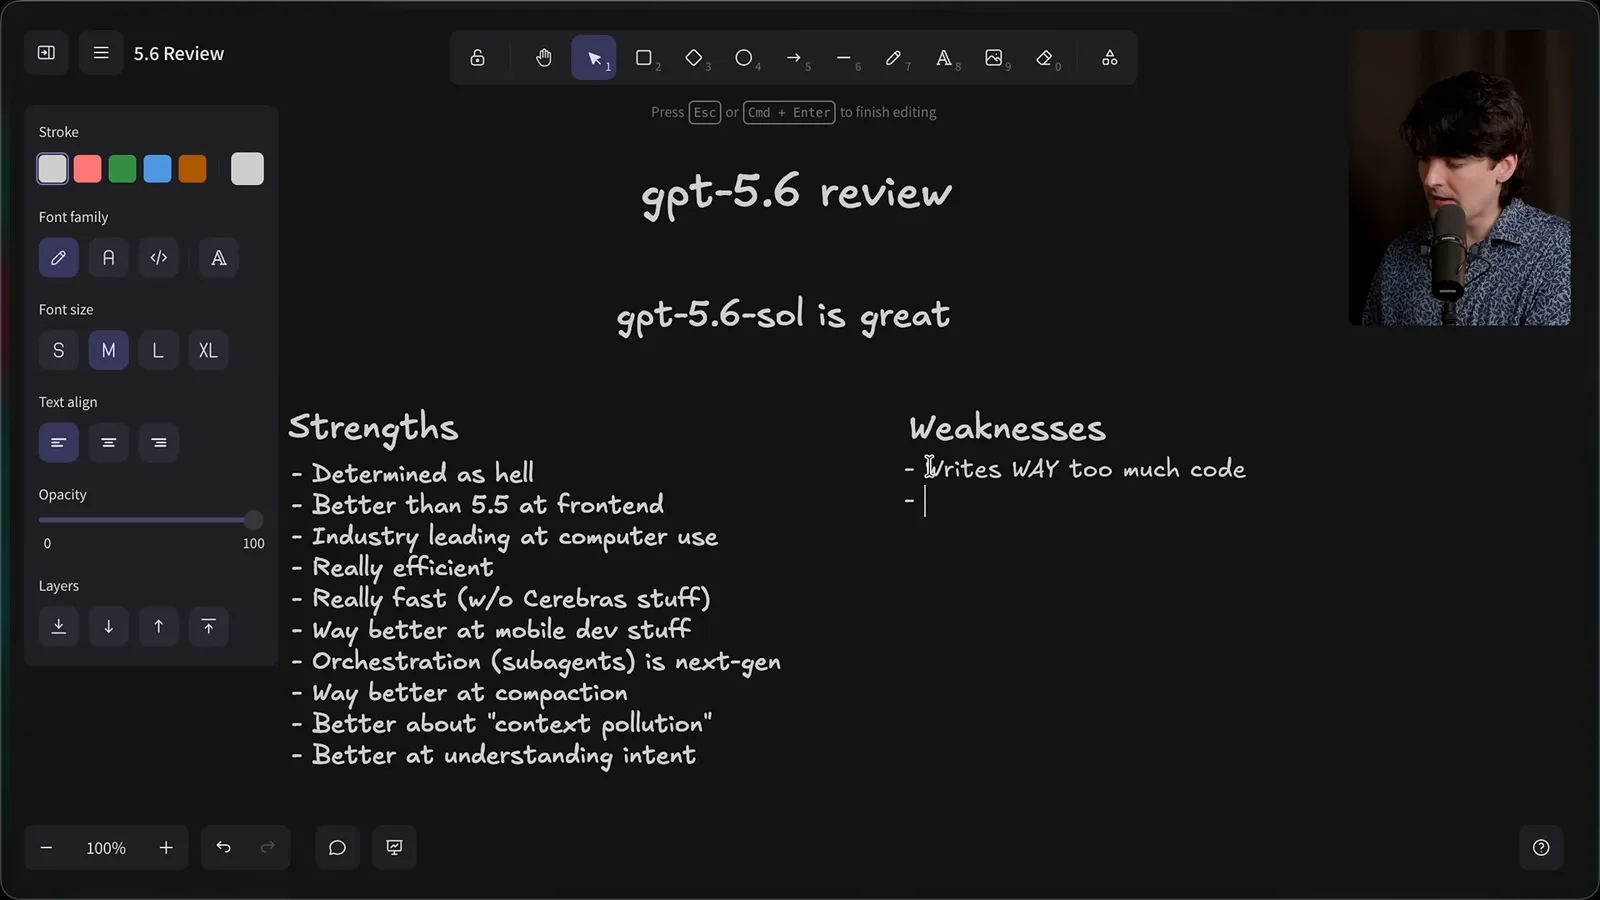
我看到的最大弱点是过度产出:Sol 可能写出太多代码,添加维护成本高于价值的测试或脚手架。输出更多并不自动意味着更好。可以要求它做最小的有效改动,并审查差异中是否有不需要的工作。
遇到障碍时,模型的坚持也可能驱使智能体尝试不合适的变通方法。应限制权限,在适当情况下使用隔离,并对有重大影响的操作要求批准。不要把模型的自信当成操作安全的证据。
它可能自信地犯错,并沿着错误思路越走越远,而没有意识到前提有问题。不能假定坚持总能解决问题:应设定边界、检查推理和结果,在工作偏离目标时及时纠正。
模型很有能力,但能力和周全是不同的品质。它可能产出大量技术上看似合理的内容,却缺少谨慎同事应有的克制。因此,请求的写法以及事后的审查都很重要。
选择模型与推理强度
他借助 DeepSWE 比较 Sol、Terra 和 Luna。他的建议既考虑了展示的成本,也受到个人测试有限这一因素的约束。
为了选择编程模型,我再次查看 DeepSWE。图表中,Terra 的大多数设置以及 Sol medium 的成本都低于旧版 GPT-5.5 medium 的测试。Sol medium 可能是合理的替代选择,但仅凭自己的测试,我无法有把握地在它和 Terra xhigh 之间做出选择。
在该基准中,Terra 不同档位之间的差距似乎很有意义,而 Sol 从 xhigh 升到 max 的提升较小。Luna 的图表更复杂,有些分数较低;某个设置下成绩好,并不代表它是所有交互式开发任务的最佳模型。
我主要把 Luna 看作一个便宜、快速的工作模型,供其他智能体调用,或用于批量处理和简单文本生成。例如,我正在考虑让它为 T3 Code 生成分支名和标题。你可以直接尝试,但我不会把它设为交互式编程的默认模型。
任务困难或预计耗时较长时,我会选择 Sol。Terra 对预算有限的编程工作很有吸引力,但我只在两天里用了大约二十次提示,因此对它的权衡还没有那么确定。
Terra 似乎适合审查工作,也适合在更强的模型规划方案之后负责实现。它会更早停下来,而且根据我有限的体验,它不那么容易写出过多代码。在人检查每一批改动的交互循环中,这可能是优点。
使用推理强度和快速模式时要小心,尤其是 ultra:一个坚持不懈的智能体如果陷入难题,可能很快耗尽额度。在 DeepSWE 的这次快照中,high、xhigh 和 max 分别约为 69%、71% 和 73%,每项任务成本则从约 3.47 美元升至 4.70 美元和 8.39 美元。
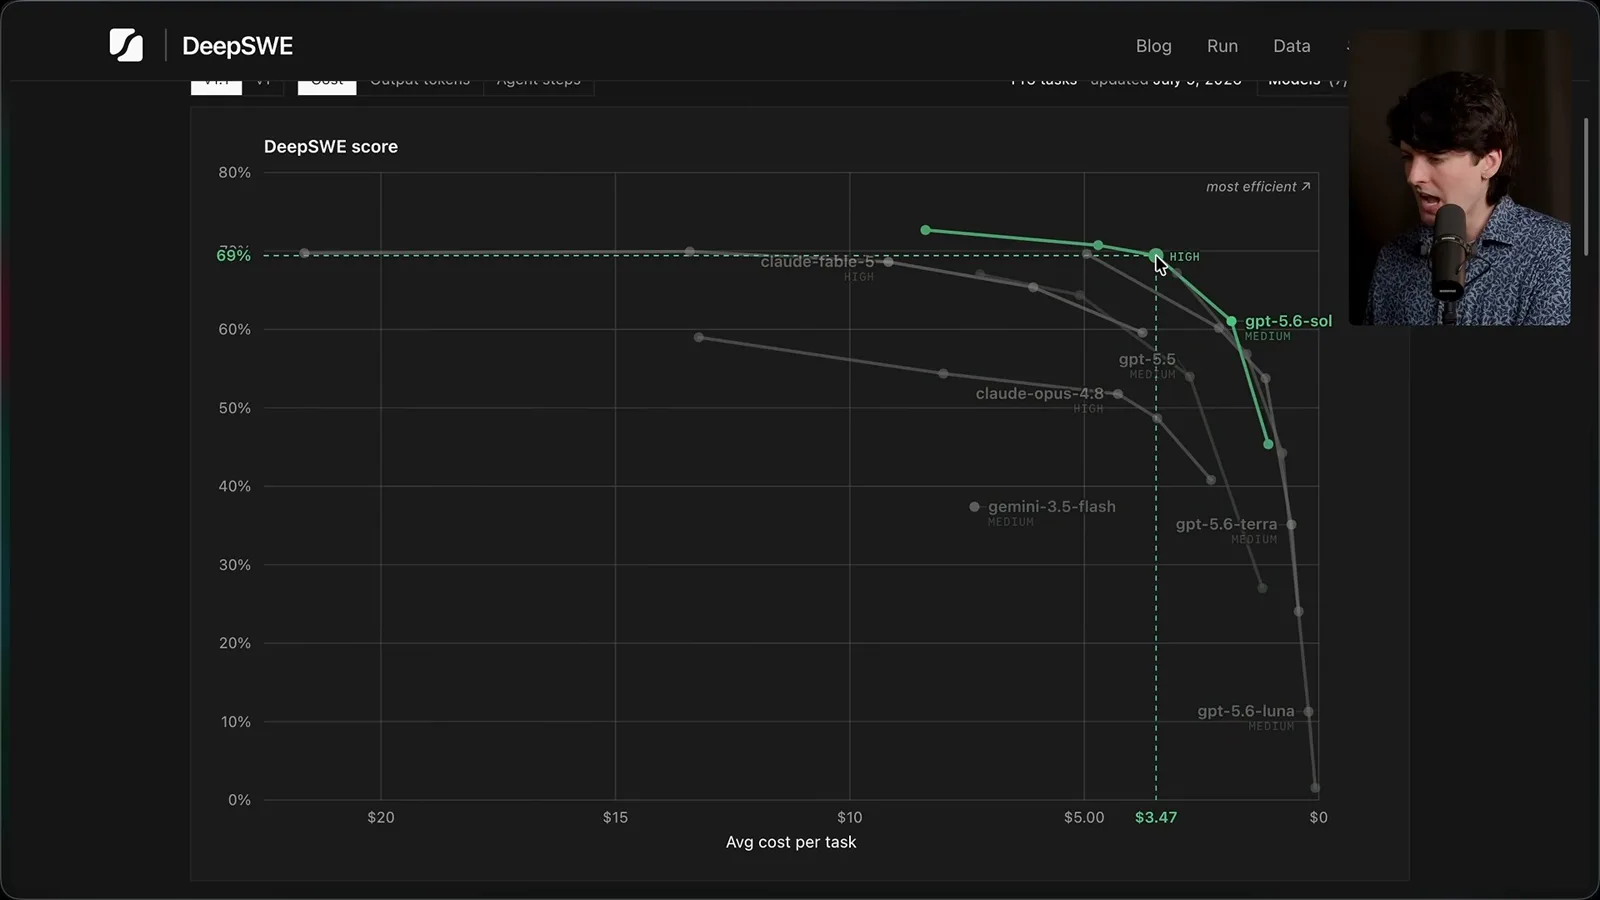
更高强度也可能让任务更慢,因为智能体生成更多 token、执行更多步骤。我目前默认使用 Sol high:medium 曾遗漏我需要的内容,而 xhigh 在我的工作中往往耗时更长,却没有明显改善。你的任务和预算可能会让你做出不同选择。
我的实际分工是:大多数高要求的工作用 Sol high,预算优先的常规工作用 Terra medium,低成本的委派或批量任务用 Luna。我认为 Luna 对简单输出和工具调用尤其有意思,但我对其他小模型的比较是个人体验,而不是普遍结论。
总体来说,GPT-5.6 是一个非常出色的模型系列,已经成为我处理许多任务的默认选择。它是不是我最喜欢的模型、我是否更喜欢它而不是 Fable,是我留给下一支视频的另一个问题。重要的是了解优势、成本和失败模式后再做选择,而不是只看排行榜。
同频道的其他文章
 38:47EN → 简体中文
 Theo - t3․gg· 2026年10月28日Theo 的长时间 Agent 实验:验证、算力与成本Theo Browne · Ping Labs滑板游戏和两个编译器项目展示了反复检查与弹性算力如何支撑 agent 工作,也揭示了循环可能带来的高昂成本。
 36:07EN → 简体中文Theo - t3․gg· 2026年10月27日Theo 谈 Token 成本、编程智能体与 AI 能力的价格Theo Browne · Ping Labs一则关于 Lauren 的 AI 支出估算广泛传播,引出了对缓存计价、基准测试和编程智能体工作方式的讨论。
 30:37EN → 简体中文Theo - t3․gg· 2026年10月26日Theo 的三个技能:用编程智能体审查和交付代码Theo Browne · Ping Labssol-loop、full-send 和 full-stop 如何定义审查、验证以及不同程度的合并权限。
 0:43EN → 简体中文Theo - t3․gg· 2026年10月23日Theo 区分安全漏洞与实际攻击Theo Browne · Ping Labs一段简短讲解:软件漏洞披露和攻击事件为何属于不同类型的安全新闻。
 29:22EN → 简体中文Theo - t3․gg· 2026年10月22日Theo 谈安全漏洞、被盗 API 密钥与 AITheo Browne · Ping Labs从漏洞披露到补丁部署之间的风险窗口,以及被盗推理密钥为何可能有价值的推测。
 31:13EN → 简体中文Theo - t3․gg· 2026年10月20日Theo:更聪明的模型为何能帮助更多人Theo Browne · Ping Labs从游戏修改到编译器实验,Theo 重新思考谁能从更强大的 AI 中受益。